

— това е колонкова система за управление на бази данни за онлайн обработка на аналитични запитвания (OLAP) с отворен код, създадена от Яндекс. Тя се използва от Яндекс, CloudFlare, VK.com, Badoo и други услуги по целия свят за съхранение на наистина огромни обеми данни (вмъкване на хиляди редове в секунда или питабайти данни, съхранявани на диск).
В обикновената, "редова" СУБД, примери за които са MySQL, Postgres, MS SQL Server, данните се съхраняват в такъв ред:
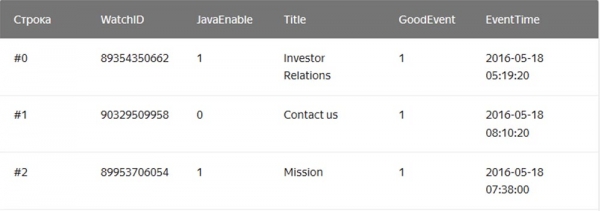
При това стойностите, свързани с един ред, физически се съхраняват близо до себе си. В колонковите СУБД стойностите от различни колони се съхраняват отделно, а данните от една колона – заедно:
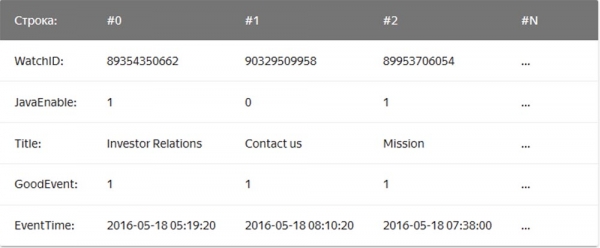
Примери за колонкови СУБД са Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Компания – мейлфорвардер започна да използва Clickhouse през 2018 година за изготвяне на отчети и много се впечатли от простотата, мащабируемостта, поддръжката на SQL и скоростта. Бързината на работа на тази СУБД граничеше с магия.
Лесна употреба
Clickhouse се инсталира в Ubuntu с една единствена команда. Ако познавате SQL, можете веднага да започнете да използвате Clickhouse за вашите нужди. Въпреки това, това не означава, че можете просто да изпълните "show create table" в MySQL и да копирате и поставите SQL в Clickhouse.
В сравнение с MySQL, в тази СУБД съществуват важни разлики в типовете данни в определенията на схемите на таблиците, затова за комфортна работа все още ще ви е нужно известно време, за да промените определенията на схемите на таблиците и да изучите механизмите на таблиците.
Clickhouse отлично работи без каквото и да е допълнително софтуерно осигуряване, но ако решите да използвате репликация, ще ви е необходимо да инсталирате ZooKeeper. Анализът на производителността на запитванията показва отлични резултати — системните таблици съдържат всяка информация, а всички данни могат да бъдат получени с помощта на старият и скучен SQL.
Производителност
- сравнения на Clickhouse с Vertica и MySQL на конфигурация на сървър: два сокета Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 на 8 6TB SATA HDD, ext4.
- сравнения на Clickhouse с облачното хранилище на данни Amazon RedShift.
- Извадки от блога :
Базата данни ClickHouse притежава много прост дизайн - всички възли в клъстера имат еднаква функционалност и за координация използват единствено ZooKeeper. Изградихме малък клъстер от няколко възела и проведохме тестове, по време на които установихме, че системата притежава доста впечатляваща производителност, която отговаря на декларираните предимства в бенчмарковете на аналитични СУБД. Решихме да се запознаем по-подробно с концепцията, която стои зад ClickHouse. Първото препятствие за изследванията беше липсата на инструменти и малкото на брой общество на ClickHouse, затова задълбочихме изучаването на дизайна на тази СУБД, за да разберем как работи.
ClickHouse не поддържа прием на данни директно от Kafka, тъй като това е просто база данни, затова написахме собствен адаптерен сървис на езика Go. Той прочиташе кодираните съобщения Cap’n Proto от Kafka, преобразуваше ги в TSV и ги вкарваше в ClickHouse на пакети през HTTP интерфейс. По-късно пренаписахме този сървис, за да използваме библиотеката Go заедно с нашия собствен интерфейс на ClickHouse за повишаване на производителността. При оценката на производителността на приемането на пакети установихме важна особеност - оказа се, че при ClickHouse тази производителност силно зависи от размера на пакета, тоест от броя на едновременно вмъкваните редове. За да разберем защо това се случва, проучихме как ClickHouse съхранява данните.
Основният механизъм, по-скоро семейството на механизмите за таблици, използван за съхранение на данни в ClickHouse, е MergeTree. Този механизъм концептуално напомня на LSM алгоритъма, приложен в Google BigTable или Apache Cassandra, но избягва изграждането на междинна таблица в паметта и записва данните директно на диска. Това му дава отлична производителност при запис, тъй като всеки вмъкнат пакет се сортира единствено по „първичния ключ“ primary key, компресира се и се записва на диска за формиране на сегмент.
Отсъствието на таблица за памет или на каквото и да е понятие за "свежест" на данните също така означава, че те могат само да се добавят, системата не поддържа промяна или изтриване. В момента единственият начин да се изтриват данни е да се изтриват по календарни месеци, тъй като сегментите никога не пресичат границата на месеца. Екипът на ClickHouse активно работи по това да направи тази функция конфигурируема. От друга страна, това прави записването и сливането на сегменти безконфликтни, следователно пропускната способност на приема линейно се мащабира с броя на паралелните инсерции, докато не настъпи насищане на I/O или ядра.
Въпреки това, тази обстоятелство също така означава, че системата не е подходяща за малки пакети, поради което за буфериране се използват услуги на Kafka и инсертери. Освен това, ClickHouse на фонов режим продължава да извършва постоянно сливане на сегменти, така че много малки части информация да бъдат обединени и записани повече пъти, увеличавайки интензивността на записа. В същото време, прекалено много несвързани части ще причинят агресивно тротлиране на инсерциите, докато сливането продължава. Открихме, че най-добрият компромис между приема на данни в реално време и производителността е приемането в таблица с ограничен брой инсерции в секунда.
Ключът към производителността на четене на таблици е индексирането и разположението на данните на диска. Независимо колко бърза е обработката, когато на двигателя трябва да сканира терабайти данни от диска и да използва само част от тях, това ще отнеме време. ClickHouse е колоночно хранилище, така че всеки сегмент съдържа файл за всяка колона с подредени стойности за всеки ред. По този начин, цели колони, които не присъстват в запитването, първо могат да бъдат пропуснати, а след това няколко клетки могат да бъдат обработени паралелно с векторизирано изпълнение. За да се избегне пълно сканиране, всеки сегмент има малък индексен файл.
Като се има предвид, че всички колони са сортирани по „първичен ключ“, индексният файл съдържа само етикети (забелязани редове) на всяка N-та редица, за да може да ги съхранява в паметта дори за много големи таблици. Например, можете да зададете настройките по подразбиране да „забелязвате всеки 8192-ри ред“, в този случай „оскъдна“ индексация на таблица с 1 трлн. реда, която лесно влиза в паметта, ще изисква само 122 070 знака.
Развитие на системата
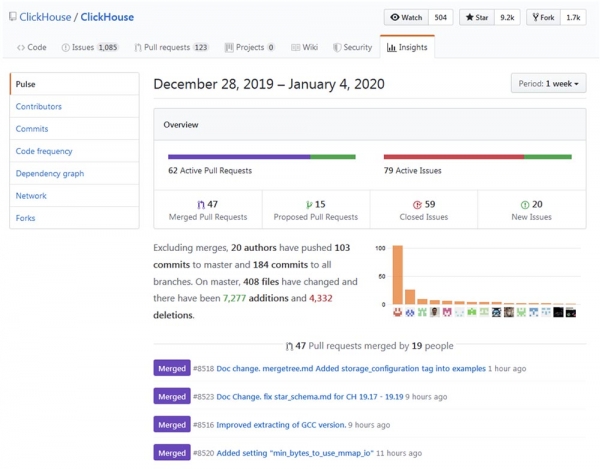
Развитието и усъвършенстването на Clickhouse могат да се проследят на и да се уверите, че процесът на „израстване“ протича с впечатляващи темпове.
Популярност
Изглежда, че популярността на Clickhouse нараства експоненциално, особено в рускоязичната общност. Миналогодишната конференция High load 2018 (Москва, 8-9 ноември 2018 г.) показа, че такива монстри, като vk.com и Badoo, използват Clickhouse, с помощта на която вкарват данни (например логове) от десетки хиляди сървъри едновременно. В 40-минутно видео . Скоро ще публикуваме стенограмата на Хабр за улеснение при работа с материала.
Области на приложение
След като прекарах известно време в изследвания, мисля, че съществуват области, в които ClickHouse може да бъде полезен или да замести напълно други, по-традиционни и популярни решения, като MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot и Druid. По-долу са изложени подробности за използването на ClickHouse за модернизация или пълна замяна на посочените по-горе СУБД.
Разширяване на възможностите на MySQL и PostgreSQL
Съвсем наскоро частично заменихме MySQL с ClickHouse за платформата за информационни бюлетини Проблемата беше, че MySQL поради лошо проектиран дизайн регистрираше всяко изпратено писмо и всяка връзка в това писмо с base64 хеш, създавайки огромна MySQL таблица (email_stats). След изпращането на 10 милиона писма на абонатите на услугата, тази таблица заемаше 150 ГБ дисково пространство и MySQL започваше да „забавя“ при простички запитвания. За да решим проблема с пространството, успешно използвахме компресия на InnoDB таблицата, което намали размера ѝ четири пъти. Въпреки това, пак няма смисъл да се съхраняват повече от 20-30 милиона имейла в MySQL само за да четем историята, тъй като всяко просто запитване, което по някаква причина изисква пълно сканиране, води до свързване и голямо натоварване на I/O, по което редовно получавахме предупреждения от Zabbix.
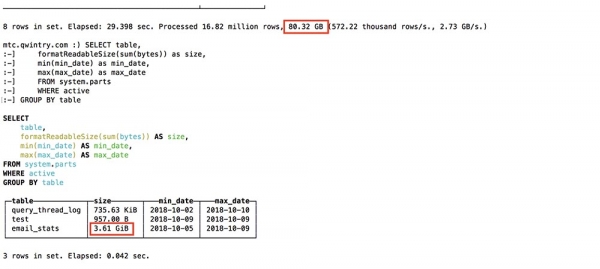
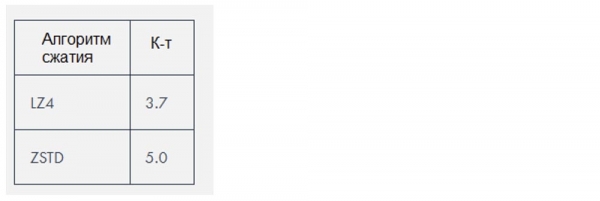
Clickhouse използва два алгоритма за компресия, които намаляват обема на данните с около , но в този конкретен случай данните бяха особено „компресируеми“.
Замяна на ELK
Според личния опит, стекът ELK (ElasticSearch, Logstash и Kibana, в този конкретен случай ElasticSearch) изисква много повече ресурси за работа, отколкото е необходимо за съхранение на логовете. ElasticSearch е отличен двигател, ако имате нужда от добър текстов търсене в логовете (а не мисля, че наистина ви е необходимо), но мен ме интересува защо de facto той стана стандартен двигател за логове. Производителността му в комбинация с Logstash ни създаваше проблеми дори при сравнително малки натоварвания и изискваше добавяне на все повече оперативна памет и дисково пространство. Като база данни, Clickhouse е по-добър от ElasticSearch по следните причини:
- Поддръжка на SQL диалект;
- По-добра степен на компресия на съхраняваните данни;
- Поддръжка на регулярни изрази Regex вместо пълнотекстово търсене;
- Подобрено планиране на запитванията и по-висока обща производителност.
В момента най-голямата проблема при сравнението на ClickHouse с ELK е липсата на решения за изтегляне на логовете, както и недостигът на документация и учебни материали по тази тема. Въпреки това всеки потребител може да конфигурира ELK с помощта на ръководството на Digital Ocean, което е много важно за бързото внедряване на подобни технологии. Тук има СУБД, но все още няма Filebeat за ClickHouse. Да, това е налично. и система за работа с логовете , съществува инструмент за въвеждане на лог файлове в ClickHouse, но всичко това отнема повече време. Въпреки това ClickHouse все пак е лидер заради своята простота, така че дори начинаещите могат да го инсталират лесно и да започнат да го използват напълно буквално след 10 минути.
Предпочитайки минималистични решения, опитах да използвам FluentBit, инструмент за извеждане на журнали с много малък обем памет, заедно с ClickHouse, като се опитвах да избегна използването на Kafka. Въпреки това, трябва да се разрешат малки несъвместимости, като , преди това да може да се направи без прокси слой, който преобразува данните от FluentBit в ClickHouse.
Вместо Kibana може да се използва ClickHouse като бекенд . Dokолкото разбрах, могат да възникнат проблеми с производителността при рендиране на огромно количество данни, особено при по-стари версии на Grafana. В Qwintry все още не сме го опитвали, но оплаквания за това понякога се появяват в канала за поддръжка на ClickHouse в Telegram.
Замяна на Google Big Query и Amazon RedShift (решение за големи компании)
Идеалният вариант за използване на BigQuery е да заредите 1 TB JSON данни и да направите аналитични запитвания върху тях. Big Query е отличен продукт, чиято мащабируемост е трудно да се преувеличи. Това е значително по-сложен софтуер от ClickHouse, работещ на вътрешен кластер, но от гледна точка на клиента има много общо с ClickHouse. BigQuery може бързо да „поскъпне“, щом започнете да плащате за всяко SELECT запитване, така че това е истинско SaaS решение с всичките си предимства и недостатъци.
ClickHouse е най-добрият избор, когато изпълнявате много запитвания, които са скъпи по отношение на калкулация. Колкото повече SELECT запитвания извършвате всеки ден, толкова повече смисъл има да замените Big Query с ClickHouse, защото подобна замяна ще ви спести хиляди долари, ако става въпрос за много терабайти обработвани данни. Това не важи за съхранявани данни, обработката на които в Big Query е сравнително евтина.
В статия на съоснователя на Altinity Александър Зайцев се разказва за предимствата на такава миграция на СУБД.
Замяна на TimescaleDB
TimescaleDB е разширение на PostgreSQL, което оптимизира работата с времеви редове в обикновена база данни., ).
Въпреки че ClickHouse не е сериозен конкурент в нишата на времевите редове, неговата колоночна структура и векторно изпълнение на запитвания го правят значително по-бърз от TimescaleDB в повечето случаи при обработка на аналитични запитвания. В допълнение, производителността на приемането на пакетни данни в ClickHouse е около три пъти по-висока, а той използва 20 пъти по-малко дисково пространство, което е изключително важно за обработка на големи обеми исторически данни..
За разлика от ClickHouse, единственият начин да се спести малко дисково пространство в TimescaleDB е да се използва ZFS или подобни файлови системи.
Предстоящите актуализации на ClickHouse вероятно ще въведат дельта-компресия, което ще го направи още по-подходящ за обработка и съхранение на данни от времеви редове. TimescaleDB може да се окаже по-добър избор от "чистия" ClickHouse в следните случаи:
- малки инсталации с много малко оперативна памет (<3 ГБ);
- голямо количество малки INSERT операции, които не искате да буферирате в големи фрагменти;
- по-добра последователност, еднородност и изисквания AСID;
- поддръжка на PostGIS;
- интегриране с съществуващи таблици PostgreSQL, тъй като по същество TimescaleDB е PostgreSQL.
Конкуренция с системи Hadoop и MapReduce
Hadoop и други продукти MapReduce могат да извършват много сложни изчисления, но обикновено работят с огромни закъснения. ClickHouse решава този проблем, обработвайки терабайти данни и почти незабавно предоставяйки резултат. По този начин ClickHouse е много по-ефективен за бързо, интерактивно аналитично изследване, което би трябвало да заинтересува специалистите в областта на обработката на данни.
Конкуренция с Pinot и Druid
Най-близките конкуренти на ClickHouse са колонковите линейно-масштабируеми open source продукти Pinot и Druid. Отлична работа по сравнението на тези системи е публикувана в статията на от 1 февруари 2018 г.
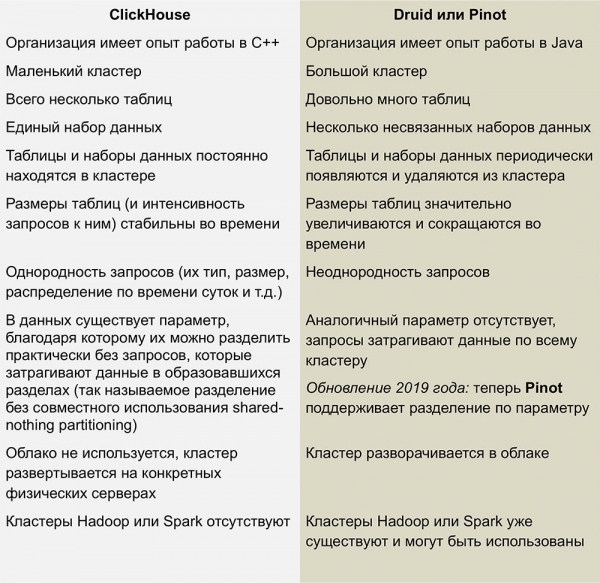
Тази статия изисква обновление – в нея се твърди, че ClickHouse не поддържа операции UPDATE и DELETE, което не е съвсем вярно за последните версии.
Нямаме достатъчен опит с тези СУБД, но не ми харесва сложността на инфраструктурата, необходима за стартиране на Druid и Pinot - това е цял куп „подвижни части“, обградени от Java от всички страни.
Druid и Pinot са проектите в инкубатора на Apache, развитието на които е подробно отразено от Apache на страниците на техните проекти в GitHub. Pinot се появи в инкубатора през октомври 2018, докато Druid се роди 8 месеца по-рано - през февруари.
Липсата на информация за това как работи AFS предизвиква у мен някои, вероятно глупави въпроси. Интересно ми е дали авторите на Pinot са забелязали, че Apache Foundation е по-благосклонна към Druid и дали такова отношение към конкурента не е предизвикало чувство на завист? Ще забави ли развитието на Druid и ще спомогне ли за ускоряване на развитието на Pinot, ако спонсорите, подкрепящи първия, изведнъж се заинтересуват от втория?
Недостатъци на ClickHouse
Незрялост: очевидно, че това все още е нова технология, но все пак, не се наблюдава нещо подобно в други колонкови СУБД.
Малките вставки не работят добре при висока скорост: вставките трябва да бъдат разделени на големи парчета, защото производителността на малките вставки намалява пропорционално на броя на колоните в реда. Точно така данните се съхраняват в ClickHouse — всяка колона означава 1 файл или повече, затова за вставка на 1 ред, съдържащ 100 колони, трябва да се отворят и запишат поне 100 файла. Ето защо за буфериране на вставките е необходим посредник (освен ако самият клиент не предоставя буфериране) — обикновено това е Kafka или някаква система за управление на опашки. Може да се използва и двигателът Buffer table, за да се копират по-големи фрагменти от данни в таблиците MergeTree по-късно.
Съединенията на таблици са ограничени от оперативната памет на сървъра, но поне, в крайна сметка, те съществуват! Например, Druid и Pinot изобщо нямат такива съединения, тъй като те са трудни за реализиране директно в разпределени системи, които не поддържат преместването на големи парчета данни между възлите.
Изводи
В близките години планираме да използваме широко ClickHouse в Qwintry, тъй като тази СУБД предлага отличен баланс между производителност, ниски разходи, мащабируемост и простота. Почти съм убеден, че тя ще започне да се разпространява бързо, след като общността ClickHouse измисли повече начини за нейното използване в малки и средни инсталации.
Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
