

Алгоритмите за обработка на данни, като невронни мрежи, завладяха света. Развитието им е предизвикано от няколко причини, включително евтино и мощно оборудване и огромни обеми данни. Невронните мрежи в момента са на авангарда на всичко, свързано с "когнитивни" задачи, като разпознаване на изображения, разбиране на естествен език и т.н. Но те не бива да се ограничават само до такива задачи. В този материал се описва начин за компресиране на изображения с помощта на невронни мрежи, чрез остатъчно обучение. Представеният в статията подход работи по-бързо и по-добре от стандартните кодеци. Схеми, уравнения и, разбира се, таблица с тестове под кат.
Тази статия се основава на работата. Предполага се, че сте запознати с невронните мрежи и техните понятия свиване и функция на загубите.
Какво е компресия на изображения и какви видове съществуват?
Компресията на изображения е процес на преобразуване на изображение така, че да заема по-малко място. Простото съхранение на изображения би заело много място, затова съществуват кодеци като JPEG и PNG, които целят намаляване на размера на оригиналното изображение.
Както е известно, съществуват два типа компресия на изображения: без загуби и с загуби. Както подсказват имената, при компресия без загуби могат да се възстановят данните от оригиналното изображение, а при компресия с загуби някои данни се губят по време на компресията. Например, JPG — това са алгоритми с загуби [бел. прев. — основно, да не забравяме и JPEG без загуби], а PNG — алгоритъм без загуби.
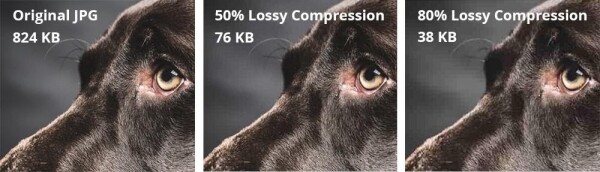
Сравнение на компресия без загуби и с загуби
Обърнете внимание, че на изображението вдясно има много блокови артефакти. Това е загубена информация. Съседните пиксели с подобни цветове се компресират като една област, за да се спести място, но в същото време се губи информация за действителните пиксели. Разбира се, алгоритмите, прилагани в кодеците JPEG, PNG и т.н., са много по-сложни, но това е добър интуитивен пример за компресия с загуби. Компресията без загуби е добра, но файловете, компресирани без загуби, заемат много място на диска. Има по-ефективни методи за компресия на изображения без значителни загуби на информация, но те са доста бавни и много от тях прилагат итеративни подходи. Това означава, че не могат да се изпълняват паралелно на няколко ядра на централния или графичния процесор. Такова ограничение ги прави напълно непрактични в ежедневната употреба.
Вход на свързваща невронна мрежа
Ако нещо трябва да бъде изчислено и изчисленията могат да бъдат приблизителни, добавете . Авторите използваха сравнително стандартна свързваща невронна мрежа за подобряване на компресията на изображения. Представеният метод не само че работи наравно с най-добрите решения (ако не и по-добре), но също така може да използва паралелни изчисления, което води до рязко увеличаване на скоростта. Причината е, че свързващите невронни мрежи (CNN) са много добри в извличането на пространствена информация от изображения, която след това се представя в по-компактна форма (например, запазват се само „важните“ битове на изображението). Авторите искат да използват тази способност на CNN, за да представят изображенията по-добре.
Архитектура
Авторите предложиха двойна мрежа. Първата мрежа приема изображение и генерира компактен представител (ComCNN). Изходните данни на тази мрежа след това се обработват от стандартен кодек (например, JPEG). След обработката от кодека изображението се предава на втората мрежа, която „коригира“ изображението от кодека в опит да възстанови оригиналното изображение. Авторите нарекоха тази мрежа реконструираща CNN (RecCNN). Подобно на GAN, двете мрежи се обучават итеративно.
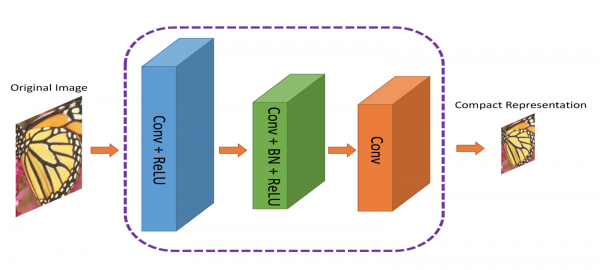
ComCNN Компактното представление се предава на стандартния кодек
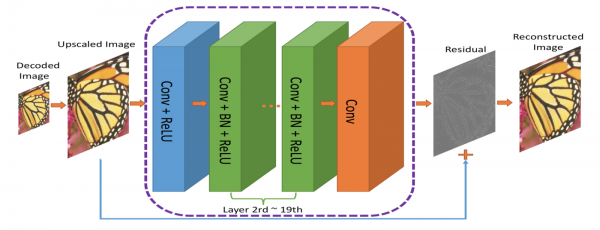
RecCNN. Изходните данни на ComCNN се мащабират с увеличение и се предават на RecCNN, която ще се опита да изучи остатъка.
Изходните данни от кодека се мащабират с увеличаването и след това се предават на RecCNN. RecCNN ще се опита да възпроизведе изображение, което е възможно най-подобно на оригинала.
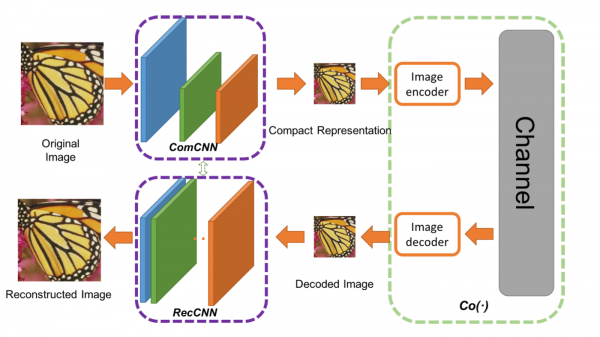
Прозрачен фреймуорк за компресия на изображения. Co(.) е алгоритъм за компресия на изображения. Авторите използват JPEG, JPEG2000 и BPG.
Какво е остатък?
Остатъкът може да се разглежда като стъпка на постобработка за "подобряване" на декодираното изображение от кодека. Разполагаща с много "информация" за света, невронната мрежа може да взема когнитивни решения относно това какво да поправя. Тази идея е основана на , подробности за което можете да прочетете .
Функции на загуба
Използват се две функции на загуба, защото имаме две невронни мрежи. Първата от тях, ComCNN, е обозначена като L1 и се определя по следния начин:
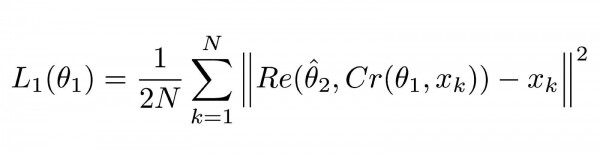
Функция на загуба за ComCNN
Обяснение
Тази формула може да изглежда сложна, но всъщност е стандартна (среднеквадратична грешка) MSE. ||² означава нормата на вектора, който те обхващат.
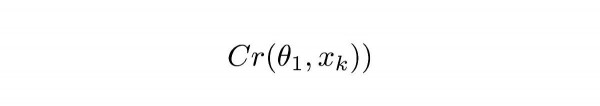
Уравнение 1.1
Cr обозначава изходните данни от ComCNN. θ обозначава обучимите параметри на ComCNN, XK е входното изображение.
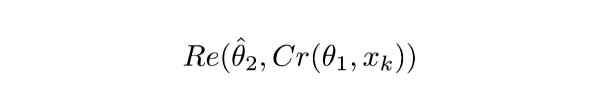
Уравнение 1.2
Re() означава RecCNN. Тази формула просто предава стойността от уравнение 1.1 на RecCNN. θ обозначава обучимите параметри на RecCNN (индикаторът отгоре означава, че параметрите са фиксирани).
Интуитивно определение
Уравнение 1.0 ще накара ComCNN да промени тежестите си, така че след пресъздаването чрез RecCNN, окончателното изображение да изглежда максимално подобно на входното изображение. Втората функция на загуба RecCNN се определя по следния начин:
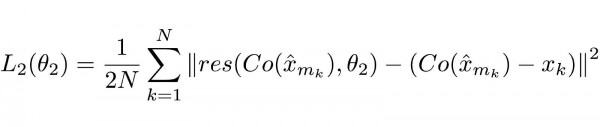
Уравнение 2.0
Обяснение
Отново функцията може да изглежда сложна, но това е предимно стандартна функция на загуба на невронна мрежа (MSE).
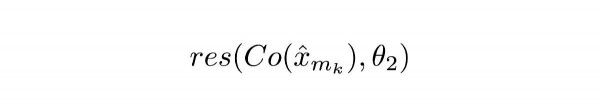
Уравнение 2.1
Co() означава изхода на кодека, x с шапка отгоре означава изхода на ComCNN. θ2 са обучимите параметри на RecCNN, res() представлява просто остатъчния изход на RecCNN. Струва си да се отбележи, че RecCNN се обучава на разликата между Co() и входното изображение, а не на входното изображение.
Интуитивно определение
Уравнение 2.0 ще накара RecCNN да промени тежестите си, така че изходните данни да изглеждат максимално подобно на входното изображение.
Схема на обучение
Моделите се обучават итеративно, подобно на Теглата на първия модел се фиксират, докато теглата на втория модел се обновяват, след това теглата на втория модел се фиксират, докато първият модел се обучава.
Тестове
Авторите сравниха своя метод с наличните методи, включително прости кодеци. Методът им работи по-добре от другите, като същевременно запазва висока скорост на съответното оборудване. Освен това авторите се опитаха да използват само една от двете мрежи и отбелязаха спад в производителността.
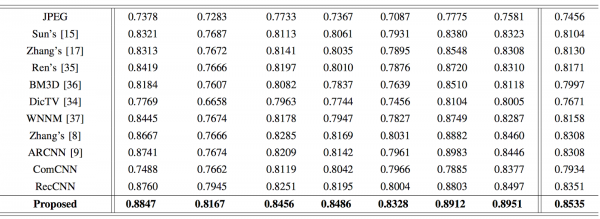
Сравнение на индекса на структурна подобие (SSIM). Високите стойности показват по-добро сходство с оригинала. Резултатите на авторите са отбелязани с удебелен шрифт.
Заключение
Разгледахме нов начин за приложение на дълбочинно обучение за компресия на изображения, говорихме за възможността за използване на невронни мрежи в задачи извън 'общите', като класификация на изображения и обработка на език. Този метод не само не отстъпва на съвременните изисквания, но също така позволява много по-бърза обработка на изображения.
Обучението на невронни мрежи стана по-лесно, тъй като специално за хабравчани направихме промокод HABR, който дава допълнителна отстъпка от 10% на посочената на банера отстъпка.
Още курсове
Препоръчани статии
Източник: habr.com
