

Здравейте, казвам се Сергей Емелянчик. Аз съм ръководител на компанията Аудит-Телеком, главен разработчик и автор на системата Veliam. Реших да напиша статия за това как аз и приятелят ми създадохме аутсорсингова компания, написахме софтуер за себе си и впоследствие започнахме да го разпространяваме на всички желаещи чрез система SaaS. Ще споделя как категорично не вярвах, че това е възможно. В статията ще намерите не само разказ, но и технически подробности за създаването на продукта Veliam, включително някои фрагменти от изходния код. Ще разкажа за грешките, които сме допуснали, и как сме ги коригирали. Имахме съмнения дали да публикуваме такава статия. Но реших, че е по-добре да го направя, да получа обратна връзка и да се поправя, отколкото да не публикувам статията и да се питам какво би било ако...
Предистория
Работих в една компания като ИТ служител. Компанията беше доста голяма с разклонена мрежова структура. Няма да се спирам на служебните си задължения, ще кажа само, че те определено не включваха разработка на каквото и да било.
Имахме мониторинг, но чисто от академичен интерес исках да опитам да напиша свой прост мониторинг. Идеята беше такава: искахме всичко да бъде в интернет, за да може лесно и без инсталация на клиенти да влезем и да видим какво се случва в мрежата от всяко устройство, включително мобилно устройство през Wi-Fi, а също така много искахме бързо да разберем в кое помещение се намира оборудването, което "захандрило", тъй като имахме много строги изисквания за време на реагиране на подобни проблеми. В крайна сметка в главата ми се роди план да напиша проста уеб страница, на която фонът да бъде jpeg със схемата на мрежата, да изрежа на тази картинка самите устройства с техните IP адреси, а върху картинката в нужните координати да показвам динамично съдържание под формата на зелен или мигащ червен IP адрес. Задачата е поставена, започваме.
По-рано се занимавах с програмиране на Delphi, PHP, JS и много повърхностно C++. Доста добре познавам работата на мрежите. VLAN, маршрутизиране (OSPF, EIGRP, BGP), NAT. Това беше достатъчно, за да напиша прототип на примитивен мониторинг самостоятелно.
Написах замисленото на PHP. Серверът Apache и PHP бяха на Windows, тъй като Linux по онова време ми се струваше нещо непонятно и много сложно. Както се оказа по-късно, грешах, защото в много отношения Linux е много по-лесен от Windows, но това е отделна тема и всички знаем колко спорове се водят по този въпрос. Планиращият задачи на Windows стартираше PHP скрипт с малък интервал (точно не помня, но нещо като веднъж на три секунди), който опитваше да пингне всички обекти и запазваше състоянието във файл.
system("ping -n 3 -w 100 {$ip_address}");
Да-да, работата с БД по онова време също не беше овладяна от мен. Не знаех, че може да се паралелизират процеси и обходът на всички възли в мрежата отнемаше дълго време, тъй като всичко ставаше в един поток. Особено проблеми възникваха, когато няколко възли бяха недостъпни, тъй като всеки от тях забавяше скрипта с 300 мс. От страна на клиента имаше проста циклична функция, която на интервали от няколко секунди изтегляше обновена информация от сървъра чрез Ajax заявка и обновяваше интерфейса. А след три неуспешни пинга подред, ако на компютъра имаше отворена уеб страница с мониторинг, звучеше весела композиция.
Когато всичко проработи, бях много вдъхновен от резултата и си мислех, че мога да добавя още нещо (според моите знания и възможности). Но винаги не ми харесваха системи с милион графики, които, както смятах тогава и все още смятам, в повечето случаи са ненужни. Исках да добавя само това, което наистина щеше да ми помогне в работата. Този принцип се запазва и до днес като основополагающ при разработката на Veliam. След това разбрах, че би било много готино, ако не трябва да държа мониторинга отворен и да знам за проблемите, а когато те се появят, просто да отварям страницата и да виждам къде се намира проблемният възел в мрежата и какво да направя с него. По някаква причина не четях имейлите си, просто не използвах тази услуга. Случайно попаднах в интернет, че съществуват SMS шлюзове, на които може да се изпратят GET или POST заявки и те ще ми изпратят SMS на мобилния телефон с текста, който напиша. Веднага разбрах, че много искам това. И започнах да изучавам документацията. След известно време успях и сега получавах SMS за проблеми в мрежата на мобилния си телефон с името на „падналия обект“. Макар системата да беше примитивна, тя беше написана от мен, а най-важното, което ме мотивираше за нейното развитие, беше, че това е приложна програма, която наистина ми помага в работата.
И дойде денят, когато един от интернет каналите падна на работа, а мониторингът ми по никакъв начин не ми даде да разбера това. Понеже Google DNS все още отлично се пингваха. Дойде време да помисля как можем да наблюдаваме дали каналът за свързване е жив. Имах различни идеи как да го направя. Нямах достъп до всичкото оборудване. Трябваше да измисля как да разбера кой от каналите е жив, без да имам възможност да погледна това на самото мрежово оборудване. Тогава един колега ми подхвърли идеята, че трасировката до публични сървъри може да е различна, в зависимост от това през кой канал в момента излизам в интернет. Проверих и така и стана. Имаше различни маршрути при трасировката.
system("tracert -d -w 500 8.8.8.8");
Така се появи още един скрипт, а по-точно трасировката бе добавена в края на същия скрипт, който пингуваше всичките устройства в мрежата. Това е един дълъг процес, който се изпълняваше в същия поток и забавяше работата на целия скрипт. Но тогава не беше толкова очевидно. Въпреки това, той вършеше работата си, в кода имаше строго зададено каква трябва да бъде трасировката на всеки от каналите. Така започна да работи системата, която вече мониторираше (гласно казано, тъй като нямаше събиране на метрики, а просто пинг) мрежовите устройства (рутери, суичове, wi-fi и т.н.) и каналите за връзка с външния свят. СМС-ите идваха редовно и на схемата винаги беше добре видно къде е проблемът.
След това, в ежедневната работа, се налагаше да се занимавам с кросировка. И всеки път, когато трябваше да вляза в Cisco суичове, за да видя кой интерфейс да използвам, ставаше досадно. Колко би било страхотно да кликна в мониторинга на обект и да видя списък с неговите интерфейси с описания. Това щеше да спести време. При това в тази схема не би трябвало да стартирам Putty или SecureCRT, да въвеждам учетни данни и команди. Просто ще кликна в мониторинга, ще видя какво ми трябва и ще продължа да си върша работата. Започнах да търся как мога да взаимодействам с суичовете. На пръв поглед на откритие попаднах веднага на 2 варианта: SNMP или да вляза в суича по SSH, да въведа необходимите команди и да парсирам резултата. Отхвърлих SNMP заради сложността на реализацията, не можех да чакам да получа резултата. С SNMP щеше да ми отнеме дълго време да ровя в MIB, за да на базата на тези данни да формирам информация за интерфейсите. Има чудесна команда в CISCO
show interface statusТя показва точно това, от което се нуждая за кросирането. Защо да се мъча с SNMP, когато просто искам да видя изхода от тази команда, помислих си. След известно време реализирах такава възможност. Кликвах на обекта в уеб страницата. Сработваше събитие, по което AJAX клиентът се свързваше със сървъра, а той от своя страна се свързваше по SSH с нужния ми комутатор (данните за вход бяха вградени в кода, нямаше желание да създавам отделни менюта, от където да мога да сменям учетните данни от интерфейса, нужен беше резултат и по-бързо) въвеждах упоменатата по-горе команда и я връщах обратно в браузъра. Така започнах да виждам информация по интерфейсите с един клик. Това беше изключително удобно, особено когато се налагаше да гледам тази информация на различни комутатори едновременно.
Мониторингът на каналите на база трасировка в крайна сметка се оказа не най-добрата идея, тъй като понякога се провеждаха ремонти в мрежата и трасировката можеше да се променя, а мониторингът започваше да ми вика, че има проблеми с канала. Но след като прекарах много време в анализ, разбирах, че всички канали работят, а моят мониторинг ме лъже. В крайна сметка, помолих колегите, които управляваха комутаторите за формиране на канали, просто да ми изпращат syslog, когато се променяше състоянието на видимостта на съседите. Съответно, това беше много по-просто, по-бързо и по-правдиво от трасировката. Дойде събитие от вида neighbor lost и веднага правя уведомление за падането на канала.
По-нататък, се появиха изходи при клик на обект, още няколко команди и добавих SNMP за събиране на някои метрики, а по същество това беше всичко. Системата не се развиваше допълнително. Тя правеше всичко необходимо, беше полезен инструмент. Много читатели вероятно ще ми кажат, че за решаването на тези задачи вече има куп софтуер в интернет. Но всъщност, през това време не намерих безплатни такива продукти и много исках да развивам програмистките си умения, а какво може да е по-добро за това от реалната практическа задача. Така приключи първата версия на мониторинга и повече не беше модифицирана.
Създаване на компания Аудит-Телеком
С течение на времето започнах да работя на непълно работно време в други компании, тъй като работният график ми позволяваше да го правя. Когато работиш в различни компании, уменията ти в различни области нарастват бързо, а светогледът се развива добре. Има компании, в които, както е прието да се казва, си и шивач, и жътвар, и свирец. От една страна, това е трудно, но от друга страна, ако не се мързелува, ставаш специалист с широк профил и това ти позволява по-бързо и ефективно да решаваш задачи, защото знаеш как работи съседната област.
Моят приятел Павел (също айтишник) постоянно се опитваше да ме убеди да започна свой бизнес. Имаше безброй идеи с различни варианти за собствено дело. Това се обсъждаше не един път. И в крайна сметка, нищо не се получи, тъй като аз съм скептик, а Павел е фантазьор. Всеки път, когато той предлагаше някаква идея, аз винаги не вярвах в нея и отказвах да участвам. Но много ни се искаше да отворим свой бизнес.
Накрая успяхме да намерим вариант, който устройва и двамата и да се заемем с това, което умеем. През 2016 година решихме да създадем IT компания, която ще помага на бизнеса с решаването на IT задачи. Това е внедряване на ИТ системи (1С, терминален сървър, пощенски сървър и т.н.), тяхното поддържане, класически HelpDesk за потребителите и администриране на мрежата.
Искрено казано, в момента на създаването на компанията, не вярвах в нея около 99,9%. Но по някакъв начин Павел успя да ме убеди да опитам, и забягвайки напред, той се оказа прав. Събрахме по 300 000 рубли с Павел, регистрирахме новото ООД "Аудит-Телеком", наехме малък офис, направихме яки визитки, както вероятно правят повечето неопитни, начинаещи бизнесмени, и започнахме да търсим клиенти. Търсенето на клиенти е наистина отделна история. Може би ще пишем отделна статия за корпоративния блог, ако това ще е интересно за някого. Студени обаждания, флаери и прочие. Никакви резултати не даваше. Както вече чета сега, от много истории за бизнес, така или иначе, всичко зависи от късмета. Поръчахме си късмет. И буквално след няколко седмици след създаването на фирмата, се свърза с нас брат ми Владимир, който ни доведе първия клиент. Няма да те затормозявам с детайли за работата с клиентите, статията не е за това, просто ще кажа, че отидохме на одит, открихме критичните места и тези места се сринали, докато се взимаше решение за това дали да работим с нас на постоянна основа като аутсорсери. След това веднага беше взето положително решение.
След това, основно чрез уста, започнаха да се появяват и други компании на обслужване. Helpdesk беше в една система. Свързването със мрежовото оборудване и сървъри в друга, а именно при всеки как. Някой запазваше ярлици, друг ползваше адресни книги RDP. Мониторингът е още една отделна система. Работата на екипа в разрознени системи е много неудобна. Загубва се важна информация. Например, терминалният сървър на клиента стана недостъпен. Веднага постъпват заявки от потребителите на този клиент. Специалистът от техническата поддръжка отваря заявка (тя е постъпила по телефона). Ако инцидентите и заявките бяха регистрирани в една система, специалистът от поддръжката моментално щеше да види какъв е проблемът на потребителя и да му каже за него, паралелно извършвайки свързване с необходимия обект за решаване на ситуацията. Всички са запознати с тактическата обстановка и работят скоординирано. Не намерихме такава система, където всичко это може да се обедини. Стана ясно, че е време да създадем свой продукт.
Продължение на работата по собствената система за мониторинг
Беше ясно, че системата, която беше написана преди това, изобщо не отговаря на текущите задачи. Нито по отношение на функционалността, нито по отношение на качеството. Затова беше взето решение да се създаде система от нулата. Графично, тя трябваше да изглежда съвсем различно. Трябваше да бъде йерархична система, за да може бързо и удобно да се отварят нужните обекти за нужния клиент. Схемата от първата версия в текущия случай беше напълно неоправдана, тъй като клиентите бяха различни и изобщо нямаше значение в какви помещения е разположено оборудването. Това вече беше прехвърлено на документацията.
И така, задачите:
- Йерархична структура;
- Нещо като сървърна част, която може да бъде разположена при клиента под формата на виртуална машина за събиране на необходимите ни метрики и изпращането им на централен сървър, който ще обобщава всичко и ще ни показва;
- Уведомления. Такива, които не могат да бъдат пропуснати, тъй като в този момент нямаше възможност някой да седи и просто да наблюдава на монитора;
- Система за заявки. Започнаха да се появяват клиенти, на които обслужвахме не само сървърно и мрежово оборудване, но и работни станции;
- Възможност за бързо свързване с сървърите и оборудването от системата;
Задачите са поставени, започваме да пишем. Паралелно обработваме заявките от клиентите. В този момент вече бяхме 4 души. Започнахме да пишем и двете части - централният сървър и сървъра за инсталиране при клиентите. Към този момент Linux вече не беше чужд за нас и беше взето решение, че виртуалните машини, които ще стоят при клиентите, ще бъдат на Debian. Няма да има никакви инсталатори, просто ще създадем проект на сървърната част на една конкретна виртуална машина, а след това просто ще я клонираме за нужния клиент. Това беше още една грешка. По-късно стана ясно, че в такава схема абсолютно не е проработен механизмът за актуализации. Т.е. добавяхме някаква нова функция, а след това имаше сериозен проблем с разпространението й на всичките сървъри на клиентите, но за това ще се върнем по-късно, всичко по реда си.
Създадохме първия прототип. Той можеше да пингва необходимите ни мрежови устройства на клиентите и сървърите и да изпраща тези данни на нашия централен сървър. А той от своя страна обновяваше тези данни в общото множество на централния сървър. Тук ще пиша не само историята за това какво сме успели, но и какви дилетантски грешки сме правили и как след това са ни стрували време. Така че, всичкото дърво от обекти се съхраняваше в един единствен файл във форма на сериализиран обект. Докато свързахме към системата няколко клиента, всичко беше повече-малко нормално, въпреки че понякога имаше странни артефакти, които бяха напълно неразбираеми. Но когато свързахме към системата десетина сървъра, започнаха да се случват чудеса. Понякога, неясно по каква причина, всички обекти в системата просто изчезваха. Тук е важно да се отбележи, че сървърите, които бяха на клиентите, изпращаха данни на централния сървър на всеки няколко секунди чрез POST заявка. Внимателният читател и опитният програмист вече е осъзнал, че се е появил проблем с многократния достъп до същия файл, в който се съхраняваше сериализирания обект, от различни потоци едновременно. И точно когато това се случваше, се проявяваха чудесата с изчезването на обектите. Файлът просто ставаше празен. Но всичко това не бе открито веднага, а единствено в процеса на експлоатация с няколко сървъра. През това време бе добавен функционал за сканиране на портове (сървърите изпращаха на централния не само информация за наличността на устройства, но и за отворените на тях портове). Това беше направено чрез извикване на команда:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
резултатите често бяха неправилни и сканирането отнемаше много време. Съвсем забравих за пинга, който се изпълняваше чрез fping:
system("fping -r 3 -t 100 {$this->ip}");
И всичко това също не беше паралелизирано и затова процесът беше много дълъг. По-късно в fping вече се предаваше веднага целият списък с необходимите за проверка IP адреси и обратно получавахме готов списък на тези, които отговориха. За разлика от нас, fping можеше да паралелизира процесите.
Една от често срещаните рутинни задачи беше настройването на определени услуги през уеб. Например, ECP от MS Exchange. Всъщност, това е просто линк. И решихме, че е необходимо да предоставим възможност да добавяме такива линкове директно в системата, за да не търсим в документацията или на други места как да влезем в ECP на конкретен клиент. Така се появи понятието за ресурсни линкове за системата, тяхната функционалност е налична и до днес и не е претърпяла промени, почти.
Работа с ресурсни линкове в Veliam
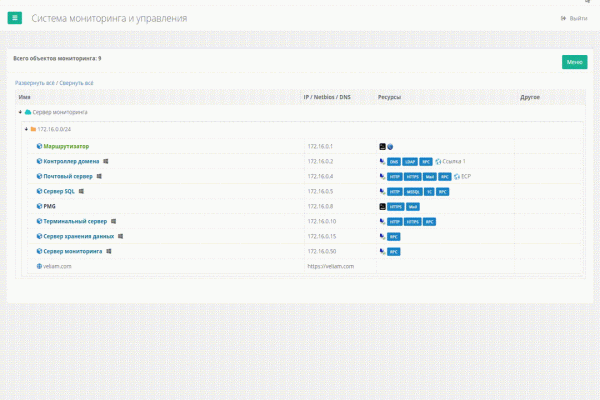
Отдалечени връзки
Ето как изглежда в действие в текущата версия на Veliam
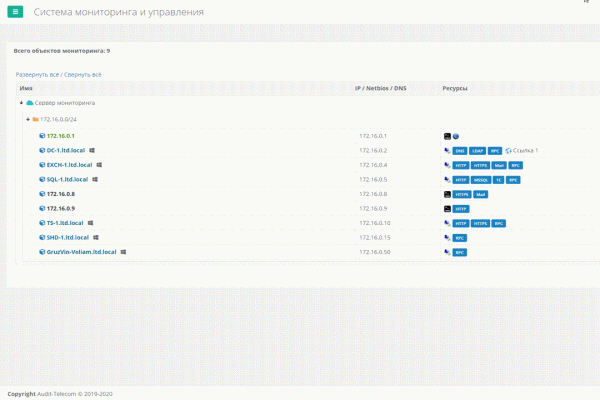
Една от задачите беше бързо и удобно свързване с сървъри, които вече са много (не по-малко от сто) и преглеждането на милиони предварително запазени RDP икони беше изключително неудобно. Имаше нужда от инструмент. В интернет има софтуер, който служи като нещо подобно на адресна книга за RDP връзки, но те не са интегрирани със системата за мониторинг, и не е възможно да запазите акаунтите. Всеки път да въвеждате акаунтите за различни клиенти е истински ад, когато на ден се свързвате многократно с различни сървъри. С SSH ситуацията е малко по-добра, има много добър софтуер, който позволява да организирате такива връзки по папки и да запомняте акаунтите им. Но има два проблема. Първият — не намерихме единствена програма за RDP и SSH връзки. Вторият — ако в даден момент не съм пред компютъра си и трябва бързо да се свържа, или просто съм преинсталирал системата, ще ми се наложи да търся в документацията, за да видя акаунта на този клиент. Това е неудобно и загуба на време.
Необходимата ни йерархична структура по сървърите на клиентите вече съществуваше в нашия вътрешен продукт. Нужно беше само да измислим как да добавим бързи връзки към необходимото оборудване. Първоначално, поне вътре в собствената ни мрежа.
Като се има предвид, че клиентът в нашата система беше браузър, който няма достъп до локалните ресурси на компютъра, за да може просто да стартира необходимото приложение с команда, беше измислено всичко да става чрез “Windows custom url scheme”. Така се появи един вид “плъгин” за нашата система, който просто включваше Putty и Remote Desktop Plus и при инсталация регистрираше URI схемата в Windows. Сега, когато искахме да се свържем с обект по RDP или SSH, натискахме това действие в нашата система и се задействаше работата на Custom URI. Стартираше се стандартният mstsc.exe, вграден в Windows, или putty, който бе част от “плъгина”. Взимам думата плъгин в кавички, защото това не е плъгин на браузъра в класическия смисъл.
Това беше поне нещо. Удобна адресна книга. В случая с Putty всичко беше много добре, можеше да подадем входни параметри, изключвайки IP адреса, логина и паролата. Т.е. до Linux сървърите в мрежата вече се свързвахме с едно натискане без въвеждане на пароли. Но с RDP нещата не са толкова прости. В стандартния mstsc не могат да се подадат данни за вход като параметри. На помощ дойде Remote Desktop Plus. Той позволяваше това. Сега вече се справяме и без него, но дълго време той беше верен помощник в нашата система. С HTTP(S) сайтовете всичко е просто, тези обекти просто се отваряха в браузъра и всичко. Удобно и практично. Но това щастие беше само във вътрешната мрежа.
Тъй като преобладаващото мнозинство от проблемите решавахме дистанционно от офиса, най-простото беше да направим VPN връзки до клиентите. И тогава от нашата система можеше да се свържем и с тях. Но все пак беше малко неудобно. За всеки клиент трябваше да държим на всеки компютър куп запомнени VPN свързвания и преди да се свържем с някое от тях, трябваше да включим съответния VPN. С такова решение ние работехме достатъчно дълго време. Но с увеличаването на клиентите, увеличаваше се и количеството VPN и всичко това започна да натоварва, и трябваше нещо да се направи. Особено се напластяваха сълзи в очите след преинсталирането на системата, когато трябваше отново да въвеждам десетки VPN връзки в новия профил на Windows. Хвани се, казах си, и започнах да мисля какво може да се направи.
Случайно се случи, че всички клиенти използваха маршрутизатори на известната марка Mikrotik. Те са доста функционални и удобни за изпълнение на почти всички задачи. Недостатъкът е, че често биват "откраднати". Решихме този проблем, като затворихме всички външни достъпи. Но трябваше по някакъв начин да имаме достъп до тях, без да е нужно да ходим на място при клиента, тъй като това отнема време. Просто създадохме тунели за всеки такъв Mikrotik и ги отделихме в различен пул, без никаква маршрутизация, за да избегнем свързването на нашата мрежа с мрежите на клиентите и помежду им.
Родиха се идеята да направим така, че при натискане на желания обект в системата, централният мониторингов сървър, знаейки отчетите от SSH на всички клиентски Mikrotik, да се свързва с нужния, да създава правило за пренос до необходимия хост с необходимия порт. Тук веднага има няколко аспекта. Решението не е универсално — то ще работи само за Mikrotik, тъй като синтаксисът на командите при всички маршрутизатори е различен. Освен това, такива преноси след това е трябвало по някакъв начин да бъдат премахвани, а сървърната част на нашата система по същество не можеше да проследи по някакъв начин завършил ли съм сесията си по RDP. И един такъв пренос — това е дупка за клиента. А ние не търсехме универсалност, тъй като продуктът се използваше само в рамките на нашата компания и дори не сме си мислили да го изнасяме на публичната сцена.
Всяка от проблемите беше решена по свой начин. Когато се създаваше правило, то преносът беше достъпен само за един конкретен външен IP адрес (от който беше инициирано свързването). Така успяхме да избегнем пропуските в сигурността. Но при всяко такова свързване, се добавяше правило на Mikrotik на страницата NAT и не се изтриваше. А на всички е известно, че колкото повече правила има там, толкова по-силен е товарът на процесора на маршрутизатора. Всичко това, за мен, беше неприемливо — да вляза веднъж в някой Mikrotik и там да открия стотици мъртви, ненужни правила.
Тъй като нашият сървър не може да следи състоянието на свързването, нека микротикът да следи сам. Написах скрипт, който постоянно наблюдаваше всички правила за пренасочване с определено описание (description) и проверяваше дали има TCP свързване, което отговаря на правилото. Ако такова не е имало от известно време, вероятно свързването вече е приключило и пренасочването може да се изтрие. Всичко стана, скриптът работеше добре.
Между другото ето го:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Премахване на nat правила, добавени автоматично от atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Сигурно можеше да се направи по-красиво, по-бързо и т.н., но той работеше, не натоварваше микротиците и се справяше отлично. Накрая успяхме да се свързваме със сървърите и мрежовото оборудване на клиентите само с едно кликване. Без да вдигаме VPN и без да въвеждаме пароли. Системата стана наистина много удобна за работа. Времето за поддръжка намаля, а всички ние прекарахме времето си в работа, а не в свързване с нужните обекти.
Резервно копие на Mikrotik
При нас беше настроено резервно копие на всички микротиците на FTP. И в общи линии всичко беше добре. Но когато трябваше да вземем бекъпа, трябваше да отворим този FTP и да го търсим там. Имаме система, в която са регистрирани всички рутери, знаем как да комуникираме с устройствата по SSH. Защо да не направим така, че системата сама да взема бекъпите от всички микротиците всеки ден, помислих си. И започнах да го реализирам. Свързахме се, направихме бекъп и го взехме в хранилището.
Код на скрипта на PHP за взимане на бекъп от микротика:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
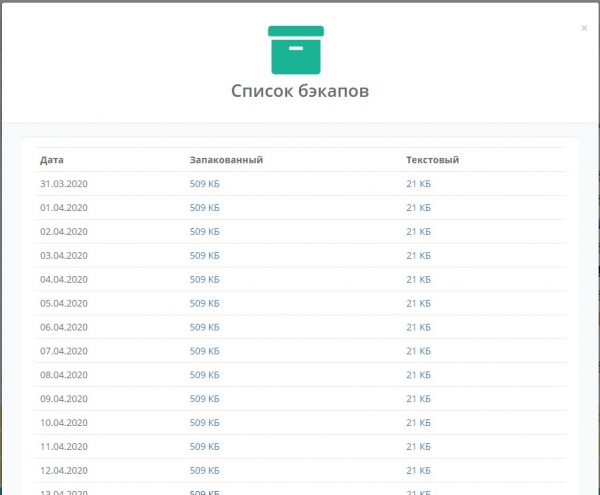
Резервните копия се извършват в два формата — бинарен файл и текстова конфигурация. Бинарният файл помага за бързо възстановяване на необходимата конфигурация, а текстовият позволява да се разбере какво трябва да се направи, ако се наложи замяна на оборудването и бинарният файл не може да бъде качен на него. В крайна сметка получихме още една полезна функция в системата. Освен това, при добавянето на нови микротик устройства не беше необходимо да се настройва нищо, просто добавих обект в системата и зададох учетни дадни за SSH. След това системата сама се зае с резервното копие. В текущата версия на SaaS Veliam тази функционалност все още не е налична, но скоро ще я портнем.
Екранни снимки как изглеждаше това във вътрешната система
Преминаване към нормално съхранение в базата данни
По-горе вече писах за появяващите се артефакти. Понякога просто изчезваше целият списък с обекти в системата, понякога при редактиране на обект информацията не се запазваше и се налагаше да се преименува обектът три пъти. Това адски дразнеше всички. Изчезването на обектите ставаше рядко и лесно се възстановяваше чрез възстановяване на самия файл, но неуспехът при редактиране на обекти ставаше доста често. Вероятно, първоначално не съм направил това чрез базата данни, понеже не можех да разбера как може да се държи дърво с всички връзки в плоска таблица. Тя е плоска, а дървото е йерархично. Но доброто решение за множество достъпи, а по-късно (при усложняване на системата) и транзакционно - това е СУБД. Сигурен съм, че не съм първият, който се е сблъскал с този проблем. Започнах да търся в Google. Оказа се, че всичко е било измислено преди мен и има няколко алгоритъма, които строят дърво от плоска таблица. Разгледах всеки от тях и реализирах един от тях. Но това вече беше нова версия на системата, тъй като по същество трябваше да пренапиша много. Резултатът беше закономерен, проблемите с произволното поведение на системата изчезнаха. Някой може да каже, че грешките са доста аматьорски (еднопоточни скриптове, съхранение на информация, която имаше множество едновременни достъпи от различни потоци в файл и т.н.) в сферата на разработването на софтуер. Може би е така, но основната ми работа беше администриране, а програмирането беше хоби, и просто нямах опит в работа с екип от програмисти, където такива елементарни неща щяха да ми бъдат казани веднага от по-възрастните. Затова всичките тези грешки ги натрупах сам, но много добре усвоих материала. А също, собственото дело - това включва и срещи с клиенти, и действия, насочени към опити за популяризиране на фирмата, и куп административни въпроси вътре в компанията и още много други. Но така или иначе, това, което беше вече - беше търсено. Хората и аз самият използвахме продукта в ежедневната работа. Имаше и откровено неуспешни идеи, и решения, на които беше отделено време, а в крайна сметка стана ясно, че това е неработещ инструмент и никой не го използваше и това не влезе в Veliam.
Служба за поддръжка - HelpDesk
Необходимо да се спомене как се е формирало HelpDesk. Това е съвсем друга история, тъй като в Veliam това е вече третата напълно нова версия, която се различава от всички предишни. В момента това е проста система, интуитивно понятна без излишни детайли и изкуствени елементи, с възможност за интеграция с домейна, както и с достъп до този същия профил на потребителя от всяко място чрез връзка в имейл. И най-важното, има възможност от всяка точка (дали съм у дома или в офиса) да се свържа с подателя по VNC директно от заявката без VPN или пренасочване на портове. Ще разкажа как стигнахме до това, какво беше преди това и какви ужасни решения бяха направени.
Ние се свързвахме с потребителите чрез добре познатия TeamViewer. На всички компютри, на потребителите, които обслужваме, е инсталиран ТВ. Първото нещо, което направихме неправилно и впоследствие премахнахме, беше свързването на всеки клиент с HWID по хардуер. Как потребителят влизаше в системата ХД, за да остави заявка? Освен ТВ, на компютрите беше инсталиран специален инструмент, написан на Lazarus (тук много ще извият очи и може дори да започнат да търсят в Google какво е това, но от компилируемите езици аз познавах най-добре Delphi, а Lazarus е почти същото, само че безплатно). Всъщност потребителят стартираше специален скрипт, който стартираше този инструмент, който от своя страна записваше HWID на системата и след това се отваряше браузъра и се извършваше вход. Защо беше направено това? В някои компании, броят на обслужваните потребители се отчита индивидуално, а цената за обслужване за всеки месец се формира въз основа на броя на хората. Това е ясно, ще кажете вие, но защо свързването с хардуер? Много просто, някои индивиди се прибираха у дома и правеха заявка от личния си лаптоп с молба "направете ми всичко красиво тук". Освен записването на HWID на системата, инструментът извличаше от регистъра текущия ID на TeamViewer и също го предаваше на нас. TeamViewer има API за интеграция. Ние направихме тази интеграция. Но имаше една особеност. Чрез тези API не може да се свържете с компютъра на потребителя, когато той явно не инициира тази сесия и след опит за свързване, той трябва да натисне "потвърдете". Тогава ни се стори логично, че без съгласието на потребителя никой не трябва да се свързва, а тъй като човекът е пред компютъра, той самият инициира сесията и утвърдително отговаря на заявката за отдалечено свързване. Но всичко се оказа по-различно. Заявителите забравяха да иницират сесията и им се налагаше да казват това по телефон. Това отнемаше време и нервираше двете страни в процеса. По-важното е, че не беше рядкост моменти, когато човек оставяше заявка, но разрешава свързването само когато отива на обяд. Понеже проблемът не е критичен и не иска да прекъсва работния си процес. Следователно, той няма да натисне никакви бутони за разрешаване на свързването. Така се появи допълнителният функционал при входа в HelpDesk — записването на ID на TeamViewer. Ние знаехме постоянната парола, която се използваше при инсталирането на TeamViewer. Всъщност, само системата я знаеше, тъй като беше вградена в инсталатора и в нашата система. Следователно имаше бутон за свързване от заявката, при натискането на който не трябваше да чакам, а веднага се отваряше TeamViewer и се извършваше свързване. В крайна сметка имаше два вида възможни свързвания. Чрез официалното API на TeamViewer и нашата самоделка. За мое учудване, първото почти веднага спряха да го ползват, макар и да имаше указание да се използва само в особени случаи и когато потребителят сам дава съгласие за това. Все пак безопасността сега е на цена. Но се оказа, че на заявителите това не им е нужно. Те абсолютно не са против да се свързват без бутон за потвърждение. И тъй като е така, функционалността за свързване чрез API беше отменена поради ненужност.
Преход към многопоточност в Linux
Вече отдавна се задава въпросът за ускоряване на сканирането на мрежата относно отвореността на предварително определен списък от портове и простата пинг проверка на обекти от мрежата. Първото решение, което идва наум, е многопоточността. Понеже основното време, което се отделя за пинга, е чакането на отговор на пакета, а следващият пинг не може да започне, докато не се върне предишният пакет, в компании с 20+ сървъра плюс мрежово оборудване, това вече работи доста бавно. Същността е, че един пакет може да изчезне, без да уведомява системния администратор. Той много бързо ще спре да възприема такъв спам. Следователно, трябва да пингуваме всеки обект не веднъж, преди да направим извод за недостъпност. Ако не навлизаме в подробности, трябва да се паралелизира, защото ако не се направи, най-вероятно системният администратор ще научи за проблема от клиента, а не от системата за мониторинг.
PHP сам по себе си, от кутията, не поддържа многопоточност. Поддържа многопроцесност, може да се форква. Но, всъщност, вече имах написан механизъм за запитвания и исках да направя така, че да прочета веднъж всички необходими възли от базата данни, да ги пингна всички наведнъж, да изчакам отговор от всеки и едва след това да запиша данните. Това спестява от количеството на запитванията за четене. В тази идея отлично се вписваше многопоточността. За PHP има модул PThreads, който позволява реална многопоточност, но се наложи да се поразровя, за да го настроя на PHP 7.2, но работата беше свършена. Сканирането на портове и пинг проверките станаха бързи. Вместо например 15 секунди на цикъл, сега този процес отнема 2 секунди. Това беше добър резултат.
Бърз одит на нови компании
Как се появи функционалът за събиране на различни метрики и характеристики на хардуера? Всичко е просто. Понякога поръчват просто аудит на текущата ИТ инфраструктура. Също така е необходимо за ускоряване на провеждането на аудита на нов клиент. Нужно беше нещо, което да позволи да влезем в средна или голяма компания и бързо да се ориентираме какво имат. Пингът във вътрешната мрежа блокират, според мен, само онези, които искат сами да си усложняват живота, и такива, по нашия опит, има малко. Но и такива се срещат. Съответно, можем бързо да сканираме мрежите за наличието на устройства с прост пинг. След това можем да ги добавим и да ги сканираме за отворени портове, които ни интересуват. По същество този функционал вече беше наличен, необходимо беше само да добавим команда от централния сървър към подчинения, за да сканира зададените мрежи и да добави в списъка всичко, което намери. Забравих да спомена, че се предполагаше, че вече имаме готов образ с настроената система (подчинен сървър за мониторинг), който можехме просто да разпространим на клиента при аудита и да го свържем с нашето облако.
Но резултатът от одита обикновено включва множество различна информация и едно от нещата е — какви устройства има в мрежата. Първоначално ни интересуваха Windows сървъри и работни станции Windows в домейн. Тъй като в средни и големи компании отсъствието на домейн — това е, вероятно, изключение от правилата. За да говорим на един и същи език, средно, в моето представяне, е 100+ души. Трябваше да измислим начин как да съберем данни от всички Windows машини и сървъри, знаейки техните IP адреси и акаунта на домейн администратора, но без да инсталираме софтуер на всяка от тях. На помощ идва интерфейсът WMI. Windows Management Instrumentation (WMI) в буквален превод — инструменти за управление на Windows. WMI — това е една от основните технологии за централизирано управление и наблюдение на работата на различни части от компютърната инфраструктура, управлявани от платформа Windows. Взето от Уикипедия. След това отново беше необходимо да се занимаваме с това, за да съберем wmic (това е клиентът на WMI) за Debian. След като всичко беше готово, оставаше само да запитваме чрез wmic нужните узли за необходимата информация. Чрез WMI може да се извлече почти всякаква информация от Windows компютър, и повече от това, чрез него може да се управлява компютърът, например, да се изпрати за рестартиране. Така се появи събирането на информация за Windows станции и сървъри в нашата система. В допълнение към това, получаваме и текуща информация за актуалните показания на натовареността на системата. Тях запитваме по-често, а информацията за хардуера по-рядко. След това провеждането на одит стана малко по-приятно.
Решение за разпространение на софтуер
Ние самите ежедневно ползваме системата, и тя винаги е отворена пред всеки технически служител. И помислихме, че можем и с другите да споделим това, което вече имаме. Системата все още не беше напълно готова за разпространение. Необходимо беше да се преработи много, за да може локалната версия да се превърне в SaaS. Това включва промени в различни технически аспекти на работата на системата (удалечени връзки, служба за поддръжка), анализ на модулите относно лицензиране, шардириране на бази данни на клиенти, мащабиране на всяка от услугите и разработка на системи за автообновления за всички части. Но за това ще говорим втората част на статията.
Актуализация
Източник: habr.com
