

Добре дошли, Хабр!
В свое време ние бяхме първите, които представиха на руския пазар темата и продължаваме развитието ѝ. В частност, темата за взаимодействието между Kafka и . Обзорът (и доста предпазлив) за тази тема беше публикуван в блога на компания Confluent още през октомври миналата година от Гвен Шапира. Днес обаче искаме да привлечем вниманието ви към по-новата статия от април на Йохан Гайгер (Johann Gyger), който, макар и да не успя да избегне въпросителния знак в заглавието, разглежда темата по-удобно, придружена с интересни връзки. Извинявайте, ако можете, за свободния превод на „chaos monkey“! Kubernetes е предназначен за работа с натоварвания, които не запазват състояние. Обикновено такива работни натоварвания се представят под формата на микросервизна архитектура, те са леки, добре се поддават на хоризонтално мащабиране, спазват принципите на 12-факторните приложения, позволяват работа с автоматични прекъсвачи (circuit breaker) и маймуни на хаоса (chaos monkeys).
Въведение
Kafka, разположен от другата страна, по същество играе роля на разпределена база данни. Следователно, при работа с него трябва да се занимавате със състоянието, а то е много по-тежко от микросервиса. Kubernetes поддържа натоварвания със запазване на състоянието, но, както посочва Келси Хайтауър в два свои туита, с тях трябва да се подхожда внимателно:
Някои смятат, че ако наложите Kubernetes на натоварване с запазено състояние, то се превръща в напълно управлявана база данни, способна да конкурира RDS. Не е така. Може би, ако положите достатъчно усилия, добавите допълнителни компоненти и привлечете екип от SRE инженери, ще успеете да изградите RDS върху Kubernetes.
Винаги препоръчвам да проявявате изключително внимание, когато стартирате натоварвания със запазване на състояние на Kubernetes. Повечето от тези, които се интересуват, „мога ли да стартирам натоварвания със запазване на състояние на Kubernetes“, нямат достатъчно опит в работата с Kubernetes, а често – и с натоварването, за което питат.
Често съветвам всички да бъдат изключително внимателни, когато стартират натоварвания със запазване на състояние в Kubernetes. Много от тези, които се интересуват, "мога ли да стартирам натоварвания със запазено състояние на Kubernetes", не разполагат с достатъчен опит в работата с него, а често - и с конкретното натоварване, за което питат.
Така ли е правилно да стартираме Kafka на Kubernetes? Противопоставен въпрос: ще работи ли Kafka по-добре без Kubernetes? Ето защо искам да подчертая в тази статия как Kafka и Kubernetes си взаимодопълват, и какви подводни камъни могат да се срещнат при тяхната комбинация.
Време на изпълнение
Нека поговорим за основното — средата на изпълнение самата по себе си
Процес
Kafka брокерите работят удобно с CPU. TLS може да добави известни разходи. В същото време, Kafka клиентите могат да натоварят повече CPU, ако използват криптиране, но това не влияе на брокерите.
Памет
Kafka брокерите изразходват много памет. Размерът на JVM купчината обикновено е добре да бъде ограничен на 4–5 ГБ, но също така ще ви трябва много системна памет, тъй като Kafka активно използва страницовия кеш. В Kubernetes задавайте ограничения на контейнерите за ресурси и заявки съответно.
Съхранение на данни
Съхранението на данни в контейнери е ефимерно — данните се губят при повторно стартиране. За данни на Kafka можете да използвате том emptyDir, и ефектът ще бъде аналогичен: данните на вашия брокер ще бъдат загубени след приключване. Вашите съобщения все още могат да се запазят на други брокери като реплики. Така че, след повторно стартиране, проваленият брокер трябва да репликира всичките данни като първо действие, а за този процес може да изисква известно време.
Ето защо трябва да използвате дълготрайно съхранение на данни. Нека бъде недомашно дълготрайно съхранение с файловата система XFS или, по-точно, ext4. Не използвайте NFS. Предупредих. NFS версии v3 или v4 няма да работи. С една дума, Kafka брокерът ще се провали, ако не може да премахне директорията с данни поради проблем с "глупавите преименования", актуален в NFS. Ако все още не съм ви убеди, прочетете много внимателно . Съхранението на данни трябва да бъде недомашно, за да може Kubernetes да избира по-гъвкаво нов узел след повторно стартиране или релокация.
Мрежа
Как и при повечето разпределени системи, производителността на Kafka силно зависи от минимизиране на забавянията в мрежата и максимизиране на пропускателната способност. Не се опитвайте да разположите всички брокери на същия възел, тъй като това ще намали наличността. Ако възелът Kubernetes се срине, целият кластер Kafka ще спре. Също така не разпределяйте кластер Kafka изцяло по датацентрове. Същото важи и за кластера Kubernetes. Добър компромис в този случай е да изберете различни зони на наличност.
Конфигурация
Обикновени манифести
На сайта на Kubernetes има за това как да настроите ZooKeeper с помощта на манифести. Тъй като ZooKeeper е част от Kafka, удобното начало е да се запознаете с концепциите на Kubernetes, които се прилагат тук. След като овладеете това, можете да приложите същите концепции и за клъстера Kafka.
- Под: под е минималната разгръщаема единица в Kubernetes. В пода се съдържа вашето натоварване, а самият под съответства на процеса ви в клъстера. В пода може да има един или повече контейнери. Всеки сървър ZooKeeper в ансамбъла и всеки брокер в клъстера Kafka ще работи в отделен под.
- StatefulSet: StatefulSet е обект на Kubernetes, който работи с множество натоварвания, съхраняващи състояния, а такова натоварване изисква координация. StatefulSet предоставят гаранции относно подредбата на подовете и тяхната уникалност.
- Headless-сервизи: Сервизите позволяват да се открепят подовете от клиентите чрез логично име. Kubernetes в този случай отговаря за балансирането на натоварването. Въпреки това, при операции с натоварвания, съхраняващи състояние, като в случая с ZooKeeper и Kafka, на клиентите е необходимо да обменят информация с конкретен инстанс. Тук идват на помощ headless-сервизите: в този случай клиентът все пак ще има логично име, но директно не се налага да се свързва с пода.
- Том за дългосрочно съхранение: такива томове са необходими за конфигуриране на нелокално блочно дългосрочно хранилище, което беше споменато по-горе.
На предоставя изчерпателен набор от манифести, с помощта на които е удобно да започнете работа с Kafka на Kubernetes.
Helm-диаграми
Helm е мениджър на пакети за Kubernetes, който може да се сравни с мениджърите на пакети за операционни системи като yum, apt, Homebrew или Chocolatey. С негова помощ е удобно да се инсталират предварително определени софтуерни пакети, описани в диаграмите на Helm. Добре подбраната диаграма на Helm улеснява сложната задача: как да конфигурираме всички параметри за използването на Kafka в Kubernetes. Има няколко диаграми на Kafka: официалната е , има една от , още една – от .
Оператори
Тъй като Helm има определени недостатъци, голяма популярност придобиват и други инструменти: оператори за Kubernetes. Операторът не само опакова софтуера за Kubernetes, но и ви позволява да разгръщате такъв софтуер, както и да управлявате него.
В списъка са споменати два оператора за Kafka. Един от тях е . С помощта на Strimzi не е никак трудно да се създаде кластер Kafka за броени минути. Практически не е необходимо да внасяте конфигурации, освен това, самият оператор предлага и някои приятни възможности, например, шифроване TLS тип „точка-точка“ вътре в кластера. Confluent също предлага .
Производителност
Много важно е да тествате производителността, снабдявайки инсталирания от вас екземпляр Kafka с контрольни точки. Такива тестове ще ви помогнат да откритете потенциални тесни места, преди да започнат проблемите. За щастие, Kafka вече предоставя два инструмента за тестване на производителността: kafka-producer-perf-test.sh и kafka-consumer-perf-test.sh. Използвайте ги активно. За справка можете да се сверявате с резултатите, описани в на Джей Крепс, или да се ориентирате на на Amazon MSK от Stéphane Maarek.
Операции
Мониторинг
Прозрачността в системата е много важна – иначе няма да разберете какво се случва в нея. Днес има солиден набор от инструменти, осигуряващи мониторинг на базата на метрики в стил cloud native. Два популярни инструмента за тази цел са Prometheus и Grafana. Prometheus може да събира метрики от всички Java процеси (Kafka, Zookeeper, Kafka Connect) с помощта на JMX експортер – по най-простия начин. Ако добавите метрики от cAdvisor, ще можете по-добре да представите как ресурсите се използват в Kubernetes.
Strimzi предлагается много удобен пример на Grafana за Kafka. Той визуализира ключови метрики, например, за недореплицираните сектори или за тези, които са офлайн. Всичко е много ясно. Тези метрики се допълват с данни за използването на ресурси и производителността, както и с показатели за стабилност. По този начин получавате основен мониторинг на кластера Kafka безплатно!
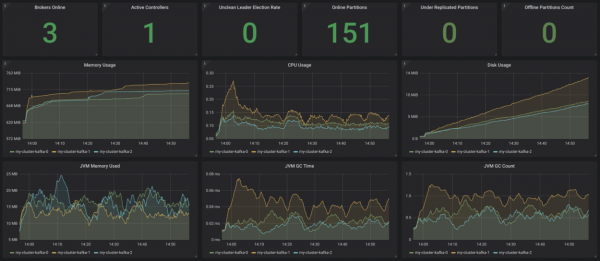
Източник:
Всичко това би било добре да се допълни с мониторинг на клиентите (метрики за консумиращите и произвеждащите), а също и с мониторинг на закъснението (за това има ) и цялостен мониторинг – за това използвайте .
Логиране
Логването е още една важна задача. Убедете се, че всички контейнери в вашата инсталация Kafka логват в stdout и stderr, а също така се погрижете вашият кластер Kubernetes да агректира всички логове в централна логова инфраструктура, например в .
Проверка на работоспособността
Kubernetes използва зондове "живост" (liveness) и готовност (readiness), за да провери дали вашите подове работят нормално. Ако проверката на живост не успее, Kubernetes ще спре този контейнер и след това автоматично ще го рестартира, ако политиката за рестарт е настроена съответно. Ако проверката на готовност не успее, Kubernetes изолира този под от обслужването на заявки. По този начин в такива случаи не се изисква ръчна намеса, което е голямо предимство.
Разполагане на актуализации
StatefulSet поддържат автоматични актуализации: при избиране на стратегия RollingUpdate всеки под Kafka ще бъде актуализиран последователно. По този начин времето на престой може да бъде сведено до нула.
Мащабиране
Мащабирането на кластера Kafka е сложна задача. Въпреки това, в Kubernetes е много лесно да се мащабират подовете до определен брой реплики, което означава, че можете декларативно да определите толкова Kafka брокери, колкото пожелаете. Най-сложното в този случай е преразпределянето на секторите след увеличение на мащаба или преди намаление на мащаба. Отново, с тази задача ще ви помогне Kubernetes.
Администриране
Задачи, свързани с администрирането на вашия Kafka клъстер, по-специално създаването на теми и преразпределението на раздели, могат да се извършват чрез наличните шелл скриптове, отваряйки командния интерфейс във вашите подове. Въпреки това, такова решение не е особено елегантно. Strimzi поддържа управление на теми чрез друг оператор. Има какво да се доразвива тук.
Резервно копиране и възстановяване
Сега наличността на Kafka зависи и от наличността на Kubernetes. Ако вашият Kubernetes клъстер падне, в най-лошия случай и Kafka клъстерът ще падне. Според закона на Мърфи, това неизменно ще се случи и вие ще загубите данни. За да намалите риска от такова нещо, е важно да разработите концепция за архивиране. Можете да използвате MirrorMaker, а друг вариант е да използвате S3, както е описано в това от Zalando.
Заключение
При работа с малки или средни Kafka клъстери определено е разумно да се използва Kubernetes, тъй като той предлага допълнителна гъвкавост и опростява работата с операторите. Ако имате много сериозни нефункционални изисквания, свързани с латентност и/или пропускна способност, може би е по-добре да разгледате друга опция за внедряване.
Източник: habr.com
