

Създадохме дизайн на мрежа от дата центрове, който позволява разполагане на изчислителни клъстери с размер над 100 хиляди сървъра и пикова лента на бискекция (bisection bandwidth) над един петабайт в секунда.
От доклада на Дмитрий Афанасьев ще научите за основните принципи на новия дизайн, мащабиране на топологиите, възникващите проблеми, вариации на решенията, особеностите на маршрутизацията и мащабирането на функциите на forwarding plane на съвременните мрежови устройства в плътно свързани (densely connected) топологии с голям брой ECMP маршрути. Освен това, Дима накратко разказа за организацията на външната свързаност, физическия слой, кабелната система и методите за нататъшно увеличаване на капацитета.
— Здравейте на всички! Аз съм Дмитрий Афанасьев, мрежов архитект в Яндекс и основно се занимавам с дизайна на мрежи от дата центрове.
Моята презентация ще бъде за обновената мрежа от дата центрове на Яндекс. Това е до голяма степен еволюция на дизайна, който имахме, но същевременно включва и нови елементи. Това е обзорна презентация, тъй като трябваше да съберем много информация в малко време. Ще започнем с избора на логическа топология. След това ще направим обзор на control plane и проблемите с мащабируемостта на data plane, ще изберем какво ще се случва на физическия слой и ще разгледаме някои особености на устройствата. Някои аспекти за случващото се в дата центъра с MPLS, за който говорихме преди известно време, също ще бъдат засегнати.
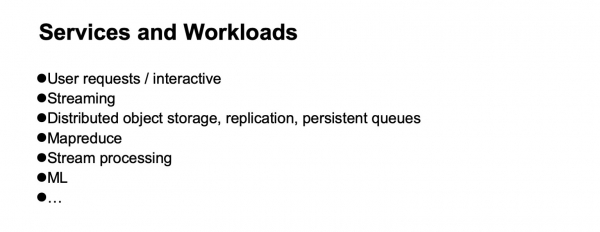
И така, какво представлява Яндекс в контекста на натоварванията и услугите? Яндекс е типичен хиперскейлер. Ако гледаме от гледна точка на потребителите, в нашия случай основната задача е обработката на потребителски заявки. Има и различни стрийминг услуги и предаване на данни, тъй като разполагаме и със storage услуги. Отзад, ние имаме инфраструктурни натоварвания и услуги, като разпределени обектни хранилища, репликация на данни и, разбира се, постоянни опашки. Един от основните типове натоварвания са MapReduce и подобни системи, потокова обработка, машинно обучение и т.н.
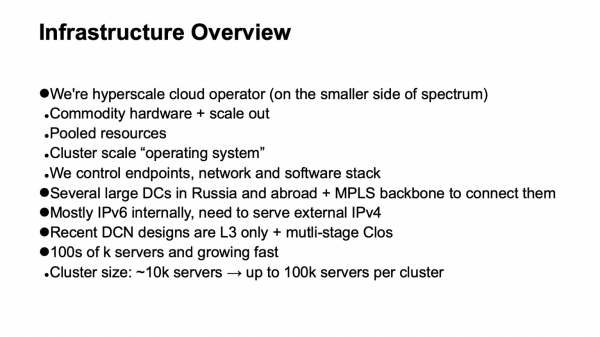
Как е организирана инфраструктура, върху която всичко това се случва? Отново, ние сме напълно типичен хиперскейлер, макар че може би сме доста по-близо до страна на спектъра, където се намират по-малките хиперскейлери. Но имаме всички атрибути. Използваме обикновен хардуер и хоризонтално мащабиране навсякъде, където е възможно. Има пълно наличие на пулове от ресурси: не работим с отделни машини, отделни стелажи, а ги обединяваме в голям пул от взаимозаменяеми ресурси с допълнителни услуги, които се занимават с планирането и алокацията, и работим с целия този пул.
Така че, следващото ниво, което възниква, е операционната система на ниво изчислителен кластер. Изключително важно е, че ние напълно контролираме стек технологиите, които използваме. Контролираме крайни точки (хостове), мрежата и софтуерния стек.
Имаме няколко големи дата центрове в Русия и в чужбина. Те са свързани чрез гръбнака, използващ технологията MPLS. Нашата вътрешна инфраструктура е почти изцяло изградена на IPv6, но тъй като трябва да обслужваме външния трафик, който все още постъпва основно по IPv4, трябва да намерим начин да доставяме заявки, идващи по IPv4, до фронтенд-сървъри, и малко да се свързваме с външния IPv4 интернет — например, за индексиране.
Последните няколко итерации на дизайна на мрежите на дата центровете използват многослойни топологии Clos и в тях се прилага само L3. От L2 се отказахме преди известно време и си поехме дъх с облекчение. Накрая, нашата инфраструктура включва стотици хиляди изчислителни (сървърни) инстанции. Максималният размер на кластера няколко пъти назад беше около 10 000 сървъра. Това в значителна степен е обусловено от начина, по който могат да работят тези операционни системи на ниво кластер, планировчици, алокация на ресурси и т.н. Понеже на страна на инфраструктурния софтуер беше постигнат напредък, целевият размер сега е около 100 000 сървъра в един изчислителен кластер и предизвикателството, което имаме, е да можем да изграждаме мрежови фабрики, които да позволяват ефективно извършване на пулите от ресурси в такъв кластер.
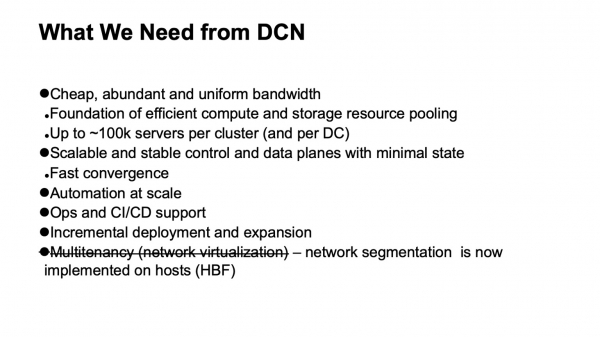
Какво искаме от мрежата на датацентъра? Първо и най-важно — много евтина и сравнително равномерно разпределена пропускателна способност. Защото мрежата е основата, чрез която можем да пулваме ресурси. Новата целева големина е около 100 000 сървъра в един клъстер.
Разбира се, искаме мащабируем и стабилен контролен панел, защото на такава голяма инфраструктура се появяват много главоболия дори от случайни събития, и не искаме и контролният панел да ни носи главоболие. В същото време искаме да минимизираме състоянието в него. Колкото по-малко състояние, толкова по-добре и по-стабилно работи всичко, по-лесно се диагностицира.
Разбира се, нуждаем се от автоматизация, защото ръчното управление на такава инфраструктура е невъзможно и е било невъзможно от доста време. Необходимо ни е, доколкото е възможно, да имаме поддръжка на оперативната дейност и поддръжка на CI/CD.
При такива размери на датацентровете и клъстерите задачата за поддръжка на инкрементално разгръщане и разширение без прекъсване на услугата става доста остър проблем. Ако на клъстери с размер на хиляда машини, близо до десет хиляди машини, все още можеше да се извършва с една операция — тоест планираме разширение на инфраструктурата и добавяме няколко хиляди машини като една операция, клъстер с размер сто хиляди машини не възниква веднага, а се изгражда за определен период от време. И е желателно през това време онова, което вече е изпълнено, инфраструктурата, която е разгръната, да бъде достъпна.
И едно изискване, което имахме и сега отмени: поддръжка на multitenancy, тоест виртуализация или сегментиране на мрежата. Сега не се налага да го правим на нивото на мрежовата фабрика, защото сегментирането премина на хостовете и това значително улесни мащабирането. Благодарение на IPv6 и голямото адресно пространство, не се наложи да използваме дублиращи се адреси във вътрешната инфраструктура, цялата адресация беше така или иначе уникална. А благодарение на факта, че филтрацията и сегментирането на мрежата са пренесени на хостовете, не е необходимо да създаваме виртуални мрежови същности в мрежите на датацентровете.
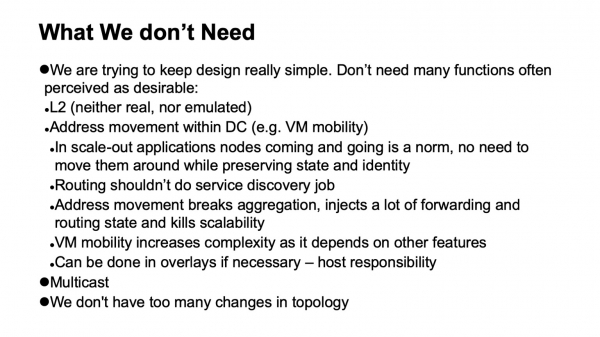
Много важно е, че нямаме нужда от определени неща. Ако можем да премахнем някои функции от мрежата, това значително улеснява живота и обикновено разширява избора на налично оборудване и софтуер, а също така опростява диагностиката.
И така, от какво наистина нямаме нужда, от което успяхме да се откажем, не винаги с радост в момента, в който това се случва, но с голямо облекчение, когато процесът приключи?
На първо място, отказваме се от L2. Няма нужда от L2, нито реален, нито емулаторен. Не се използва в значителна степен, благодарение на контрола върху стек-а на приложенията. Нашите приложения са хоризонтално мащабируеми, те работят с L3 адресация и не се притесняват много, ако някой отделен инстанс бъде спратен, просто пускат нов и той не е задължен да стартира на стария адрес, тъй като има отделен слой за откриване на услуги и наблюдение на машините в клъстера. Ние не прехвърляме тази задача на мрежата. Задачата на мрежата е да доставя пакети от точка А до точка Б.
Също така нямаме ситуации, когато адресите се местят в мрежата и това трябва да бъде проследявано. В много дизайни е необходимо, за да се поддържа мобилността на VM. Не използваме мобилност на виртуалните машини в нашата вътрешна инфраструктура в голям Яндекс, и считаме, че дори ако това се реализира, то не трябва да става с поддръжка от мрежата. Ако наистина е нужно, това трябва да става на ниво хостове и да се инжектират адреси, които могат да мигрират, в overlay, за да не се натоварва и да не се внасят твърде много динамични промени в системата за маршрутизация на собствената подложка (транспортната мрежа).
Още една технология, която не използваме, е мултикаст. На желаещите мога да обясня подробно защо. Това сериозно улеснява живота, защото ако някой е работил с него и е виждал как изглежда контролният слой на мултикаст — в всички инсталации, освен най-простите, това е голяма главоболие. И повече от това, трудно се намира добре работеща отворена реализация.
Накрая, ние проектираме нашите мрежи така, че да не настъпват твърде много промени. Можем да разчитаме на това, че потокът от външни събития в системата за маршрутизация е малък.
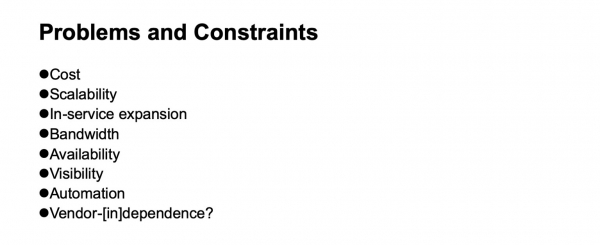
Какви проблеми и ограничения трябва да имаме предвид, когато проектираме мрежа от дата центрове? Разходите, разбира се. Масштабируемостта, до каква степен искаме да растем. Необходимостта от разширение без спиране на услугата. Пропускната способност, достъпността. Видимостта на това, което се случва в мрежата, за мониторинговите системи и оперативните екипи. Поддръжката на автоматизация — отново, колкото е възможно, тъй като различни задачи могат да се решават на различни нива, включително чрез добавяне на допълнителни слоеве. И, разбира се, независимост от доставчиците. Въпреки че в различни исторически периоди, в зависимост от гледната точка, тази независимост е била по-лесно или по-трудно постижима. Ако вземем аспекта на чиповете за мрежови устройства, доскоро говоренето за независимост от доставчиците, ако искахме и чипове с голяма пропускна способност, беше много условно.
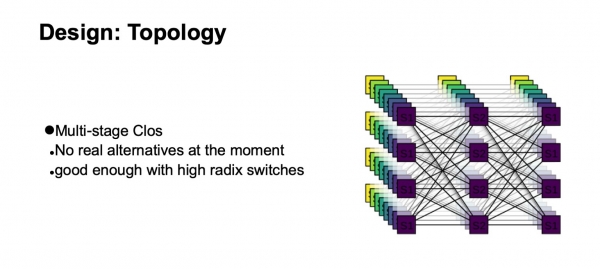
На каква логическа топология ще изградим нашата мрежа? Това ще бъде многостепенен Clos. Всъщност, в момента няма реални алтернативи. И Clos топологията е достатъчно добра, дори когато я сравняваме с различни напреднали топологии, които в момента са повече в сферата на академичния интерес, ако имаме суичове с голям радикс.
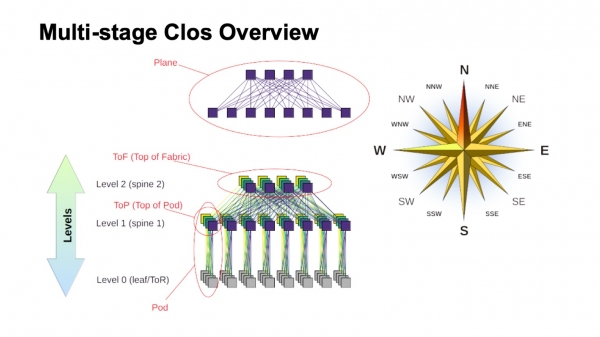
Как е изградена многостепенната Clos мрежа и как се наричат различните елементи в нея? Първо, компас, за да се ориентираме къде е север, къде е юг, къде е изток, къде е запад. Такъв тип мрежи обикновено изграждат тези, които имат много висок трафик от запад на изток. Що се отнася до останалите елементи, отгоре е показан виртуален суич, съставен от по-малки суичове. Това е основната идея на рекурсивното построение на Clos мрежи. Взимаме елементи с определен радикс и ги свързваме така, че това, което е получено, да може да се разглежда като суич с по-голям радикс. Ако е необходимо още повече, процедурата може да се повтори.
В случаите, например, с двуслойните Clos, когато ясно можем да отделим компонентите, които на схемата ми са вертикални, те обикновено се наричат равнини. Ако изграждаме Clos с три нива на spine суичовете (всички, които не са гранични и не са ToR суичове и които се използват само за транзит), тогава равнините биха изглеждали по-сложно, докато двуслойните изглеждат именно така. Блокчето на ToR или leaf суичовете и асоциираните с тях spine суичове от първото ниво го наричаме Pod. Spine суичовете на ниво spine-1 в горната част на Pod — това е top of Pod, върхът на Pod. Суичовете, които са разположени в горната част на цялата фабрика — това е горният слой на фабриката, Top of fabric.
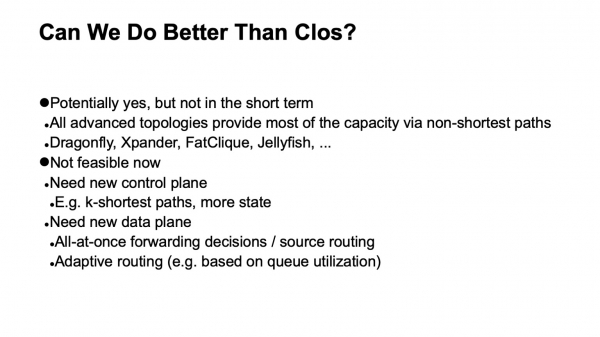
Разбира се, възниква въпросът: Clos мрежите се изграждат вече известно време, самата идея всъщност произхожда от времето на класическата телефония и TDM мрежите. Може би е появило нещо по-добро, може би може да се направи по-добре? И да, и не. Теоретично да, на практика в близко бъдеще определено не. Защото има известно количество интересни топологии, част от тях дори се използват в продукция, например, Dragonfly се използва в HPC приложения; има и интересни топологии като Xpander, FatClique, Jellyfish. Ако погледнете докладите на конференции като SIGCOMM или NSDI напоследък, можете да откриете доста голямо количество работи по алтернативни топологии, притежаващи по-добри свойства (такива или онакива), отколкото Clos.
Но всички тези топологии имат едно интересно свойство. То пречи на тяхното внедряване в мрежи на дата центрове, които се опитваме да изградим на обикновен хардуер и които струват достатъчно разумни пари. В всички тези алтернативни топологии голямата част от пропускателната способност, за съжаление, не е достъпна по най-кратките пътища. Затова веднага се лишаваме от възможността да използваме традиционния control plane.
Теоретично решението на задачата е известно. Това, например, модификации на link state с използването на k-кратки пътища, но отново, няма такива протоколи, които да бъдат реализирани в продукция и масово достъпни на оборудване.
Освен това, тъй като голяма част от капацитета не е достъпна по най-кратките маршрути, трябва да модифицираме не само управленския план, за да избира всичките тези пътища (и, между другото, това е значително по-голямо състояние в управленския план). Също така трябва да модифицираме план за предаване, и обикновено се изискват поне две допълнителни функции. Това е възможността да вземем всички решения за предаване на пакетите веднъж, например, на хоста. Всъщност, това е source routing, понякога в литературата за мрежите за свързване се нарича all-at-once forwarding decisions. И още адаптивен рутинг — това е функция, която ни е необходима на мрежовите елементи, която се свежда, например, до избора на следващия хоп, основавайки се на информация за най-ниската натовареност на опашката. Например, възможни са и други варианти.
Така че, посоката е интересна, но, уви, в момента не можем да я приложим.
Добре, спряхме се на логичната топология Clos. Как ще я мащабираме? Нека разгледаме как е изградена и какво може да се направи.
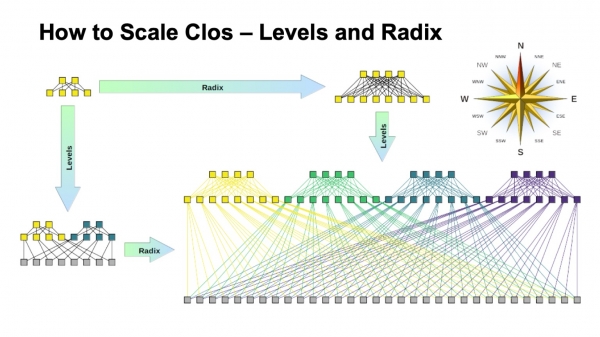
В мрежата Clos има два основни параметъра, които можем да варираме и да получаваме различни резултати: радикс на елементите и брой нива в мрежата. Имам схематично показано как и двете влияят на размера. Идеално е да комбинираме и двете.
Ясно е, че крайната ширина на мрежата Clos е произведението по всички нива на спайн-свитчовете на южния радикс, тоест, колко линка имаме надолу, как се разклонява. Ето как мащабираме размера на мрежата.
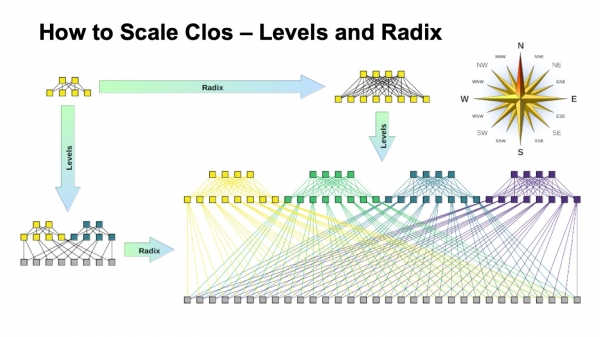
Що се отнася до капацитета, особено на ToR-свитчовете, тук имаме два варианта за мащабиране. Или можем, запазвайки общата топология, да използваме по-бързи линкове, или можем да добавяме повече плоскости.
Ако погледнем разгънатия вариант на мрежата Clos (в долния десен ъгъл) и се върнем към тази картинка с мрежата Clos долу...
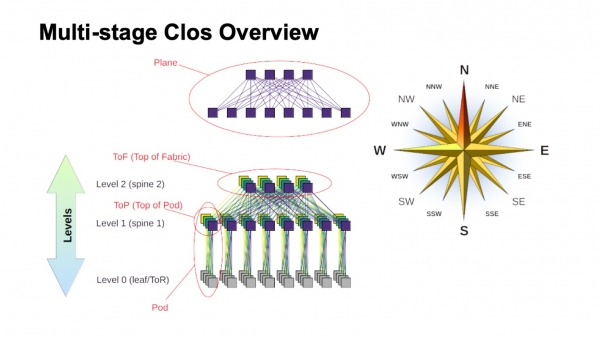
… това е точно същата топология, но на този слайд е свита по-компактно и плоскостите на фабриката са наслагени една върху друга. Това е едно и също.
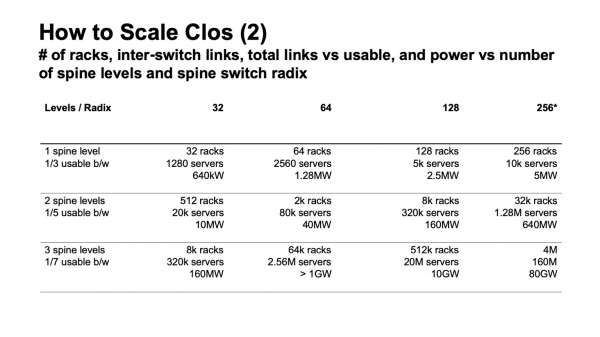
Как изглежда мащабирането на мрежата Clos в числа? Тук имам данни за това каква максимална ширина можем да получим в мрежата, какво максимално количество шкафове, ToR-свитчове или leaf-свитчове, ако не са в шкафовете, можем да получим в зависимост от радикса на свитчовете, използвани за спайн-равнищата, и колко нива използваме.
Тук е посочено колко стоят нашите рафтове, колко сървъри разполагаме и приблизителната консумация, изчислена на база 20 кВт на рафт. По-рано споменах, че целим кластер от около 100 хиляди сървъри.
Ясно е, че в цялата тази конструкция интерес представляват два и половина варианта. Има вариант с два слоя спайн и 64-портови суичове, който малко не достига. След това отличните варианти за 128-портови (с радикс 128) спайн-свитчи с два слоя, или суичове с радикс 32 с три слоя. И в всички случаи, където има повече радикс и повече нива, може да се създаде много голяма мрежа, но ако погледнете очакваното потребление, обикновено там става въпрос за гигава̀ти. Кабел може да се положи, но толкова електричество на едно място едва ли ще получим. Ако погледнете статистиката, публичните данни за дата центрове — много малко можете да намерите дата центрове с изчислителна мощност над 150 МВт. Това, което е повече — обикновено са дата центрови кампуси, няколко големи дата центрове, разположени доста близо един до друг.
Има и друг важен параметър. Ако погледнете лявата колона, там е посочена използваемата честота. Лесно е да се забележи, че в Clos мрежата значителна част от портовете отиват за свързване на суичовете помежду им. Използваемата честота — това е онова, което може да бъде предоставено навън, в посока сървърите. Разбира се, говоря за условни портове и именно за честотната лента. Обикновено линковете в мрежата са по-бързи от линковете в посока сървърите, но за единица честота, колкото можем да я предоставим навън към нашето сървърно оборудване, се отделя и известна част от честотната лента вътре самата мрежа. И колкото повече нива правим, толкова по-големи са специфичните разходи за предоставяне на тази честота навън.
Още повече, дори и тази допълнителна честота не е равномерна. Докато прелетите са кратки, можем да използваме нещо като DAC (direct attach copper, т.е. twinax-кабели) или мултимодова оптика, която все пак е на разумни цени. След като преминем на по-дълги разстояния — обикновено се използва сингъл мод оптика, и цената на тази допълнителна честота значително нараства.
И отново, връщайки се на предишния слайд, ако изграждаме Clos-структура без повторно подписване, не е сложно да се погледне схемата, да видим как се изгражда мрежата — добавяйки всеки слой на спайн суичовете, повтаряме цялата лента, която беше отдолу. Плюс един слой — плюс всичката същата лента, още толкова порта на комутаторите, още толкова трансивери. Затова е много желателно да минимизираме броя на слоевете на спайн суичовете.
С оглед на тази картинка, е видно, че много ни се иска да се изграждаме на нещо като комутатори с радикс 128.
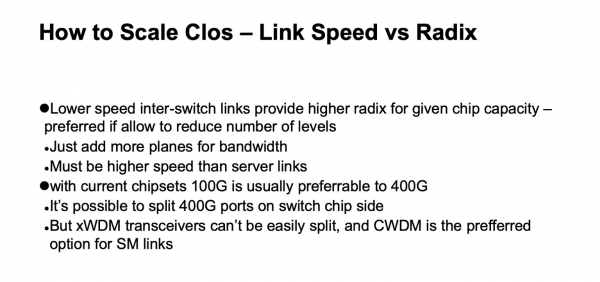
Тук принципно е същото, което току-що разказах, този слайд е по-скоро за последващо разглеждане.
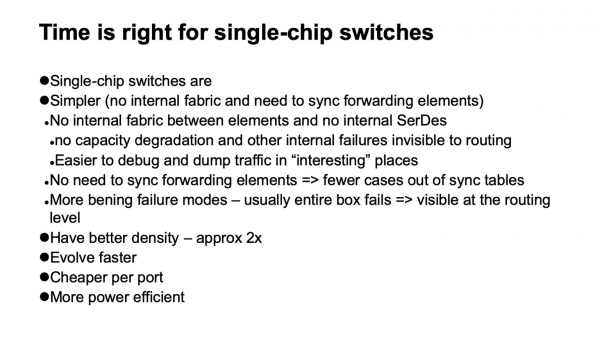
Какви опции имаме, какво можем да изберем като такива комутатори? Много приятно за нас е, че най-накрая такива мрежи могат да се изграждат на одночипови комутатори. И това е чудесно, те имат много приятни особености. Например, практически им липсва вътрешна структура. Това означава, че те са по-лесни за счупване. Счупват се, без това, но за щастие, изцяло. В модулните устройства има много неизправности (много неприятни), когато от гледна точка на съседите и контролния план то изглежда, че работи, но, например, част от фабриката е излязла от строя и не работи на пълния капацитет. А трафикът към него се балансира на базата на това, че то е напълно функционално, и можем да получим претоварване.
Или, например, възникват проблеми с бекплейна, защото вътре в модулното устройство също има високоскоростни SerDes — то по принцип е сложно устроено отвътре. Или таблиците между forwarding елементите се синхронизират или не. Всъщност, всяко производително модулно устройство, състоящо се от много елементи, обикновено съдържа същата Clos-структура, само че тя е много трудна за диагностика. Често дори на самия вендор му е трудно да диагностицира.
Има множество сценарии на отказ, при които устройството деградира, но не отпада напълно от топологията. Понеже мрежата ни е голяма, активно използваме балансиране между идентични елементи, мрежата е много равномерна, т.е. единят път, при който всичко е наред, не се различава от другия път, нашето предимство е просто да загубим част от устройствата от топологията, отколкото да изпаднем в ситуация, при която някои от тях изглежда работят, а всъщност не.
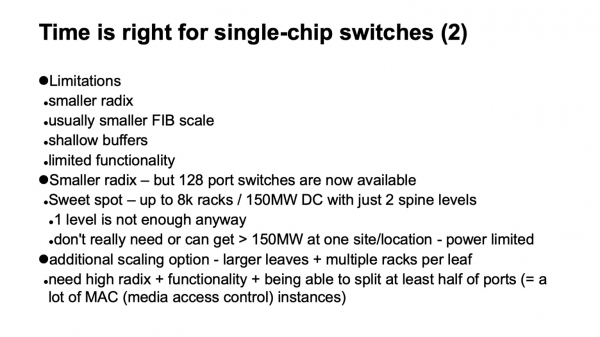
Следващото приятно предимство на едночиповите устройства е, че те еволюират по-добре и по-бързо. Също така, те обикновено имат по-добра капацитет. Ако вземем големите събрани конструкции, които имаме, капацитетът на раково единица по портовете на същата скорост става почти два пъти по-добър от този на модулните устройства. Устройствата, изградени около един чип, стават забележимо по-евтини от модулните и консумират по-малко енергия.
Но, разбира се, всичко това не е просто така, има и недостатъци. Първо, почти винаги по-малък радикс, отколкото при модулните устройства. Ако устройство, построено около един чип, можем да получим на 128 портов, то модулното можем да получим на няколко стотин порта вече без особени проблеми.
Това е значително по-малък размер на форвардинг таблиците и, обикновено, всичко, свързано с мащабируемостта на data plane. Повърхностни буфери. И, като правило, доста ограничена функционалност. Но се оказва, че ако знаем тези ограничения и навреме се погрижим да ги заобиколим или просто да ги вземем под внимание, не е толкова страшно. Това, че радиксът е по-малък, на новопоявилите се устройства с радикс 128 вече не е проблем, можем да се изградим в два слоя спайнове. А под два нищо интересно за нас размер няма как да построим. С един слой получаваме много малки клъстери. Дори предишните ни дизайни и изисквания все още ги надвишават.
Всъщност, ако решение е на ръба, има още един начин да се мащабира. Тъй като последният (или първият), най-нисък ниво, на което се свързват сървърите - ToR комутатори или leaf комутатори, не сме задължени да свързваме една стойка към тях. Следователно, ако решението не достига два пъти, може да помислим просто да използваме комутатор с по-голям радикс на долното ниво и да свържем, например, две-три стойки към един комутатор. Това е също опция, която има свои разходи, но работи и може да се окаже добро решение, когато е необходимо да се удвои размерът.
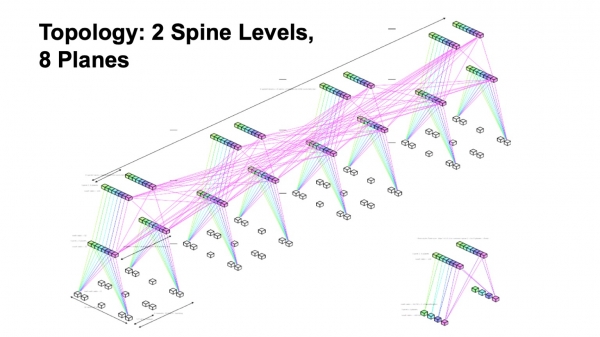
В резюме, строим се по топология с два нива на спайнове, с осем слоя фабрика.
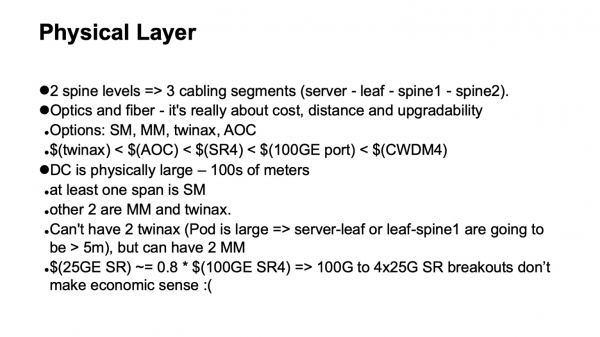
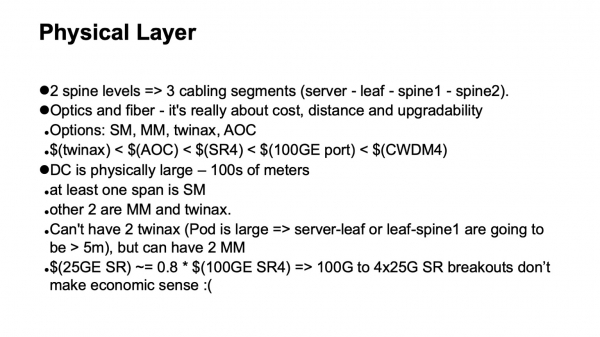
Какво ще стане с физиката? Много простичко изчисление. Ако имаме две нива на спайнове, значи имаме общо три нива на комутатори, и очакваме, че в мрежата ще има три кабелни сегмента: от сървърите до leaf комутаторите, към спайн 1, към спайн 2. Вариантите, които можем да използваме, са twinax, мултимод, сингъл мод. И тук трябва да се вземе предвид каква е наличната лента, колко ще струва, какви са физическите размери, какви разстояния можем да покрием и как ще се обновим.
По отношение на разходите всичко може да се подреди в ред. Твинаксовете са значително по-евтини от активната оптика, по-евтини са от мултимод трансиверите, ако се вземе за разстояние от края, немного по-евтини от 100-гигабитния порт на комутатора. И, внимание, той е по-евтин от сингъл мод оптиката, защото на разстояния, където е необходим сингъл мод, в центровете за данни по редица причини е смислено да се използва CWDM, с паралелен сингъл мод (PSM) не е много удобно, получават се много големи пакети влакна, и ако се спре на тези технологии, получава се горе-долу такава йерархия по цени.
Още едно забележка: за съжаление, не се получава много добре да се използват разглобени 100 к 4х25 мултимодни порта. Поради особеностите на конструкцията на трансиверите SFP28 не е много по-евтино от QSFP28 на 100 Гбит. И тази разглобка за мултимод не работи много добре.
Допълнителното ограничение е, че поради размера на изчислителните клъстери и количеството на сървърите, нашите дата центрове са физически големи. Това означава, че поне един лот ще трябва да бъде направен с единичен режим. Отново, поради физическия размер на Pods, не е възможно да се премине два лота с twinax (медни кабели).
В крайна сметка, ако оптимизираме по цена и вземем предвид геометрията на тази конструкция, получаваме един лот с twinax, един лот с мултимод и един лот с единичен мод с използване на CWDM. Това отчита възможните пътища за надграждане.
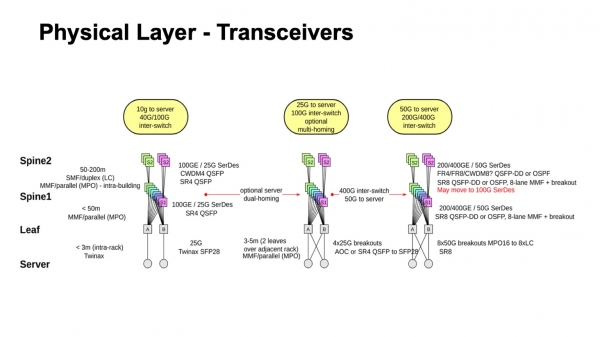
Приблизително така изглежда, какво е било наскоро, накъде отиваме и какво е възможно. Ясно е, поне как да се движим към 50-гигабитни SerDes и за мултимод и за единичен мод. Освен това, ако погледнем наличното в единичния мод трансивъри в момента и в перспектива за 400G, често, дори когато пристигат 50G SerDes от електрическия сектор, оптиката може да поддържа 100 Gbps на линия. Следователно е напълно възможно вместо преход към 50, да последва преход към 100-гигабитни SerDes и 100 Gbps на линия, защото много доставчици обещават, че тяхната наличност се очаква в близко бъдеще. Периодът, когато 50G SerDes бяха най-бързите, изглежда няма да бъде много дълъг, тъй като се предвиждат първите модели на 100G SerDes през следващата година. И след известно време след това, те вероятно ще струват разумни пари.
Още един нюанс относно избора на физика. В принципе, вече сега можем да прилагаме 400- или 200-гигабитни портове с използване на 50G SerDes. Но се оказва, че в това няма особен смисъл, защото, както споменах по-рано, искаме достатъчно голям радикс на комутаторите, в разумни граници, разбира се. Искаме 128. А ако капацитетът на чипа е ограничен и увеличаваме скоростта на връзката, радиксът естествено намалява, чудеса няма.
А общият капацитет можем да увеличим чрез плоскостите, и при това няма особени разходи, можем да добавим количество плоскости. А ако загубим радикс, ще трябва да въвеждаме допълнително ниво, затова при текущите условия, с текущата максимално налична мощност на един чип, се оказва, че по-ефективно е да се използват 100-гигабитни портове, защото те позволяват да получим по-голям радикс.
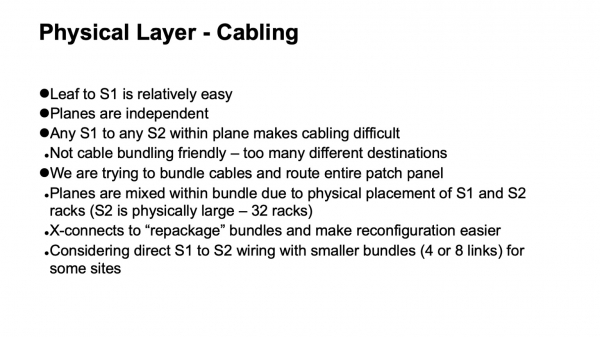
Следващият въпрос е как е организирана физиката, но вече от гледна точка на кабелната инфраструктура. Оказва се, че тя е организирана доста интересно. Кабелите между leaf-свичовете и спайновете от първо ниво – там не е толкова много линкове, там всичко е устроено сравнително просто. Но ако вземем един слой, това, което се случва вътре – там трябва да свържем всички спайнове от първо ниво с всички спайнове от второ ниво.
Плюс това, обикновено има някои желания за това как трябва да изглежда вътре в дата центъра. Например, много искахме да обединяваме кабелите в бандли и да ги теглим така, че един patch panel с висока плътност да отива изцяло в един patch panel, за да няма зоологическа градина по дължини. Успяхме да решим този проблем. Ако погледнем логичната топология, ясно се вижда, че слоевете са независими, всеки слой може да се изгражда сам по себе си. Но когато добавим такова бандлинг и искаме да преместим напълно patch panel в patch panel, трябва да смесим различни слоеве в един бандл и да въведем междинна конструкция под формата на оптични кръстоски свързвания, за да пренаредим кабелите от начина, по който са били сглобени на един сегмент, към начина, по който ще бъдат сглобени на друг сегмент. Благодарение на това получаваме приятна особеност: цялото сложно свързване не излиза извън шкафа. Когато трябва нещо да бъде много заплетено, „да се развият слоевете“, както понякога го наричат в Clos мрежите, всичко това е концентрирано вътре в един шкаф. Нямаме силно разбити, до индивидуални линкове, свързвания между шкафовете.
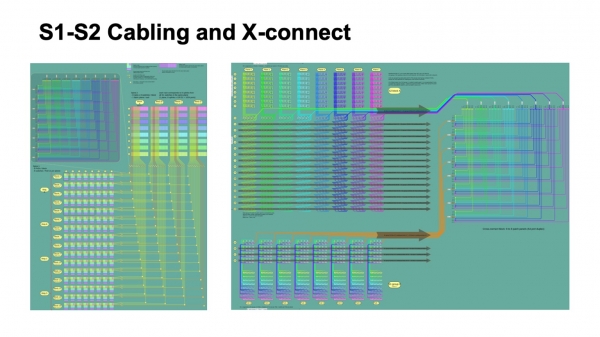
Така изглежда от гледна точка на логическата организация на кабелната инфраструктура. На картинката отляво цветните блокове изобразяват блоковете на спайн-свичовете от първо ниво, по осем на брой, и идущите от тях четири бандла кабели, които се пресичат с бандлата, идущи от блоковете на спайн-2-свичовете.
Малките квадратчета обозначават пресичания. В горния ляв ъгъл е показан разрез на всяко такова пресичане, което наистина е модул за кръстосано свързване с 512 на 512 порта, които опаковат кабелите така, че да идват напълно в един шкаф, където има само един плоскост спайн-2. А вдясно е разрезът на тази картинка, който е малко по-подробен, като се има предвид няколко Pods на ниво спайн-1 и как това се опакова в кръстосаното свързване, как стига до ниво спайн-2.
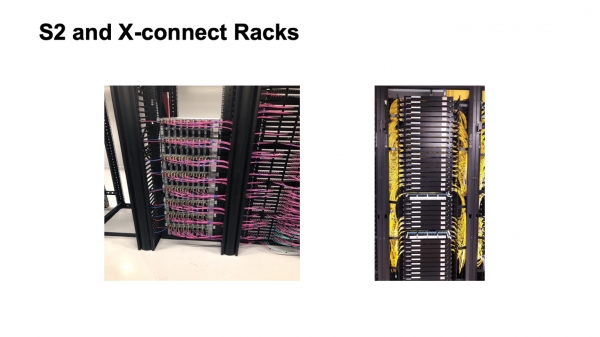
Ето как изглежда. Все още не напълно сглобен шкаф спайн-2 (вляво) и шкаф за кръстосано свързване. За съжаление, не се вижда много. Цялата тази конструкция в момента се разгръща в един от нашите големи дата центрове, който разширяваме. В работа е, ще изглежда по-добре, ще бъде по-добре запълнено.
Немаловажен въпрос: избрахме логическа топология, изградихме физика. Какво ще стане с control plane-а? Достатъчно добре е известно от опита, че има определено количество изказвания, че протоколите с link state са добри, приятно е да се работи с тях, но за съжаление, в плътно свързана топология, те не се мащабират добре. Има един основен фактор, който препятства това — начина, по който работи flooding в link state протоколите. Ако просто вземем алгоритъма за flooding и погледнем как е изградена нашата мрежа, ще е видно, че на всяка стъпка ще има много голям fanout, който ще залее control plane с актуализации. Конкретно такива топологии с традиционен алгоритъм за flooding в link state протоколите се смесват много лошо.
Изборът е — да се използва BGP. Как да го подготвим правилно, е описано в RFC 7938 относно използването на BGP в големи дата центрове. Основните идеи са прости: минимално количество префикси на хост и въобще минимално количество префикси в мрежата, да се използва агрегация, ако е възможно, и да се потисне path hunting. Искаме много внимателно, много контролирано разпространение на актуализациите, което се нарича valley free. Искаме актуализациите, преминавайки през мрежата, да се разгръщат точно веднъж. Ако те произлизат отдолу, те се движат нагоре, разгръщат се не повече от веднъж. Не трябва да има зигзаги. Зигзагите са много лоши.
За целта използваме достатъчно проста схема, за да приложим основните механизми на BGP. Тоест, прилагаме eBGP, работещ на link local, като автономните системи се определят по следния начин: автономна система на ToR, автономна система за целия блок спайн-1-свитчове на един Pod и обща автономна система за целия Top of Fabric. Не е трудно да се види и уверим, че дори нормалното поведение на BGP предоставя разпространението на обновления, което желаем.
Естествено, трябва да проектираме адресацията и агрегацията на адреси, така че това да бъде съвместимо с начина, по който е изградена маршрутизацията, за да осигурим стабилност на control plane. L3 адресацията в транспорта е привързана към топологията, защото без това не можем да постигнем агрегация; без него индивидуалните адреси ще преминават през системата за маршрутизиране. И още едно нещо — агрегацията, за съжаление, не се съчетава добре с multi-path, защото когато имаме multi-path и агрегация, всичко е наред, когато цялата мрежа работи, няма сривове. За съжаление, веднъж щом в мрежата се появят сривове и симетрията на топологията се загуби, можем да стигнем до точка, от която е анонсиран агрегат, и от която не можем да продължим нататък. Затова е най-добре да агрегираме там, където няма multi-path, в нашия случай това са ToR-свитчовете.
Наистина, агрегирането е възможно, но с внимание. Ако можем да направим контролирана дезагрегация при появата на сривове в мрежата. Но това е доста сложна задача, дори опитвахме да преценим дали можем да добавим автоматизация и крайни автомати, които да отговарят на BGP, за да постигнем желаното поведение. За съжаление, обработката на corner cases е много неочевидна и сложна, и чрез присъединяване на външно оборудване към BGP, тази задача не се решава добре.
Много интересна работа в това отношение е извършена в рамките на протокола RIFT, за който ще бъде разказано в следващата презентация.
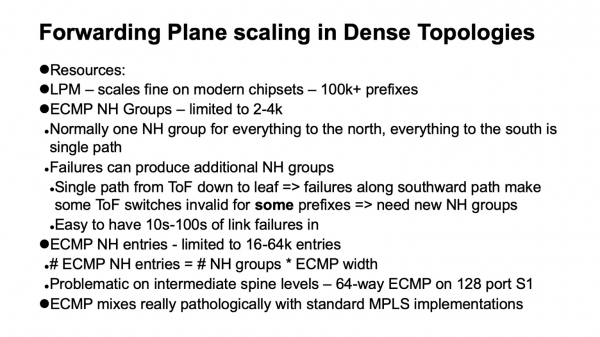
Друга важна тема е как се мащабират data plane в плътни топологии, където имаме голямо количество алтернативни пътища. При това се използват няколко допълнителни структури от данни: ECMP групи, които описват групи Next Hop.
В нормално функционираща мрежа, без сривове, когато се изкачваме по топологията Clos, е достатъчно да използваме само една група, тъй като всичко, което не е локално, се описва по подразбиране и може да се издига. Когато се движим отгоре надолу на юг, всички пътища не са ECMP, това са единични пътеки. Всичко е наред. Проблемът е, и особеността на класическата топология Clos е, че ако погледнем Top of fabric, всеки елемент до всеки елемент отдолу има един път. Ако по този път се случат сривове, той конкретно прави този елемент в горната част на фабриката невалиден именно за тези префикси, които лежат зад счупения път. А за останалите той остава валиден и ни се налага да разформироваме ECMP групите и да въведем ново състояние.
Как изглежда мащабируемостта на data plane на съвременните устройства? Ако правим LPM (най-дълъг префиксен мач), всичко е доста добре, над 100k префикса. Ако говорим за групи Next Hop, положението е по-лошо, 2-4 хиляди. Ако говорим за таблицата, която съдържа описание на Next Hops (или adjacency), това е някъде от 16k до 64k. И това може да стане проблем. И тук стигаме до интересен отстъп: какво се случи с MPLS в дата-центрите? Всъщност, искахме да го направим.
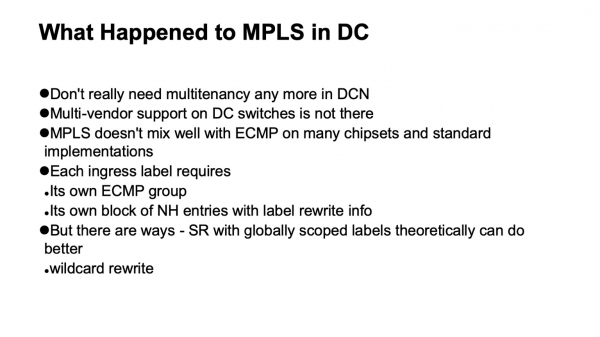
Случиха се две неща. Направихме микросегментация на хостовете, и нямаше нужда да правим това в мрежата. Не беше много добре с поддръжката от различни доставчици, а особенно с откритите реализации на white boxes с MPLS. Освен това, MPLS, поне традиционните му реализации, за съжаление, много лошо съвпадат с ECMP. И ето защо.
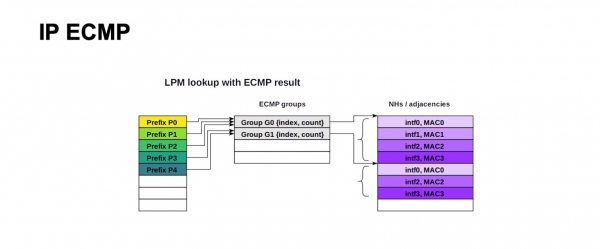
Така изглежда структурата на ECMP-услужването за IP. Голям брой префикси могат да използват една и съща група и един и същ блок Next Hops (или adjacency, в различната документация на различни устройства може да се нарича по различен начин). Същността е, че това се описва като изходящ порт и на какво да се препише MAC адреса, за да стигне до правилния Next Hop. За IP всичко изглежда просто, могат да се използват много префикси на една и съща група, един и същ блок Next Hops.
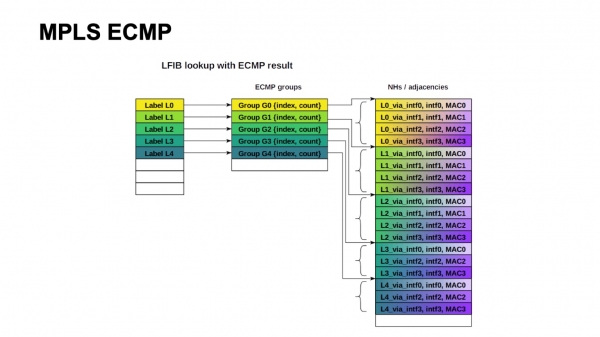
Класическата архитектура на MPLS предполага, че в зависимост от изходящия интерфейс, етикетът може да бъде записан с различни стойности. Поради това трябва да поддържаме група и блок Next Hops за всяка входяща етикет. И това, за съжаление, не се мащабира.
Не е трудно да се види, че в нашата конструкция ни трябват около 4000 ToR превключвателя, с максимална ширина — 64 пътеки ECMP, ако преминем от спайна-1 към спайна-2. С трудности се вписваме в една таблица на ECMP групите, ако само един префикс с ToR излиза, и изобщо не можем да се вместим в таблицата Next Hops.
Не всичко е безнадеждно, тъй като архитектурите от типа Segment Routing предвиждат глобални етикети. Формално, би могло отново да се съкрати всичките тези блокове Next Hops. За това е необходима операция от типа wild card: да вземем етикета и да го запишем на същия, без конкретна стойност. Но за съжаление, в наличните реализации това поне не се среща много.
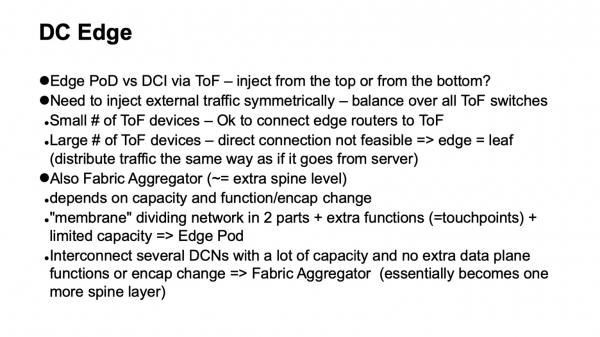
И накрая, трябва да внесем външен трафик в дата центъра. Как да го направим? По-рано трафикът се предоставяше на Clos мрежите отгоре. Тоест имаше гранични рутери, които се свързваха с всички устройства на Top of fabric. Това решение работи доста добре при малки и средни размери. За съжаление, за да въведем трафика по симетричен начин в цялата мрежа, трябва да достигнем едновременно до всички елементи на Top of fabric, и когато те надхвърлят сто, се установява, че ни трябва голям радикс и на граничните рутери. Всъщност, това струва пари, защото граничните рутери са по-функционални, портовете на тях ще са по-скъпи, и конструкцията не е особено красива.
Друг вариант е да внесем този трафик отдолу. Не е трудно да се уверим, че Clos топологията е изградена така, че трафикът, идващ отдолу, т.е. от страната на ToR, се разпределя равномерно по нивата на целия Top of fabric за две итерации, натоварвайки цялата мрежа. Затова въвеждаме специален тип Pod, Edge Pod, които осигуряват външна свързаност.
Има още една опция. Например, така постъпва Facebook. Те имат нещо, наречено Fabric Aggregator или HGRID. Въвежда се допълнителен спайн слой, за да свърже няколко дата центъра. Тази конструкция е възможна, ако нямаме на съединителите допълнителни функции или смяна на инкапсулацията. Ако такива съществуват, това са допълнителни touch points, което е сложно. Като правило възникват повече функции и своего рода мембрана, разделяща различни части на дата центъра. Не трябва да правим такава мембрана голяма, но ако по някаква причина е много необходима, има смисъл да се разгледа възможността да я направим максимално широка и да я преместим на хостовете. Например, така постъпват много облачни оператори. Те имат overlays, които започват от хостовете.
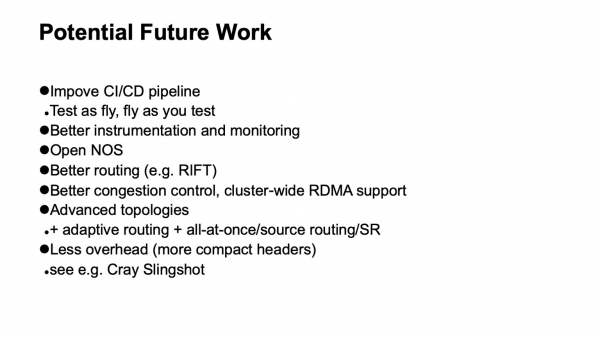
Какви възможности за развитие виждаме? На първо място — подобряване на поддръжката на CI/CD пайплайна. Искаме да летим така, както тестваме, и да тестваме така, както летим. Това не се получава много добре, защото инфраструктурата е голяма, не е възможно да я дублираме за тестове. Трябва да разберем как да внедрим елементи на тестване в работещата инфраструктура, без да я сриваме.
Най-доброто инструментиране и мониторинг са почти винаги полезни. Целият въпрос е в баланса между усилията и резултатите. Ако може с разумни усилия да се добави — много добре.
Отворени операционни системи за мрежови устройства. Най-добрите протоколи и най-добрите системи за маршрутизиране, например RIFT. Също така са необходими изследвания относно прилагането на най-добрите схеми за контрол на задръствания и, възможно е, въвеждането, поне на някои места, на поддръжка на RDMA в рамките на кластера.
Ако погледнем към по-далечното бъдеще, необходимостта от напреднали топологии и, възможно, мрежи с по-малък overhead. От новите технологии — наскоро имаше публикации относно фабричните технологии за HPC Cray Slingshot, които са базирани на обикновен Ethernet, но с опция за използване на много по-кратки заглавия. В резултат overhead-ът намалява.
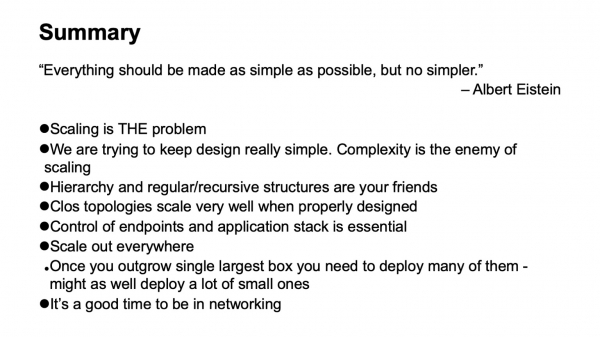
Всичко трябва да се прави толкова просто, колкото е възможно, но не по-просто. Сложността е враг на мащабируемостта. Простотата и регулярните структури са нашите приятели. Ако можете някъде да направите scale out — направете го. И изобщо, сега е чудесно да се занимавате с мрежови технологии. Стават много интересни неща. Благодаря.
Източник: habr.com
