

Здравейте, Хабр! През последните няколко месеца се намирахме в много интересна ситуация и бих искал да споделя нашата история за мащабиране на инфраструктурата. През това време СберМаркет увеличи поръчките си четири пъти и стартира услугата в 17 нови града. Взривният ръст на търсенето за доставка на хранителни стоки наложи значително мащабиране на инфраструктурата. За най-интригуващите и полезни изводи, прочетете по-долу.
Казвам се Дима Бобилев, аз съм технически директор на СберМаркет. Тъй като това е първият пост в нашия блог, ще кажа няколко думи за себе си и за компанията. Миналата есен участвах в конкурса за млади лидери на Рунета. За конкурса аз за това как в СберМаркет виждаме вътрешната култура и подхода към развитието на услугата. И макар да не спечелих конкурса, формулирах основните принципи за развитие на ИТ-екосистемата.
При управлението на екип е важно да се разбере и намери баланс между нуждите на бизнеса и изискванията на всеки конкретен разработчик. В момента СберМаркет расте с 13% на година, което оказва влияние върху продукта, изисквайки постоянно увеличаване на обемите и темповете на разработка. Въпреки това, отделяме достатъчно време на разработчиците за предварителен анализ и качествено писане на код. Формулираният подход помага не само за създаването на работещ продукт, но и за неговото по-нататъшно мащабиране и развитие. В резултат на този ръст, СберМаркет вече е лидер сред услугите за доставка на хранителни стоки: доставяме около 18 хиляди поръчки на ден, докато в началото на февруари бяха около 3500.
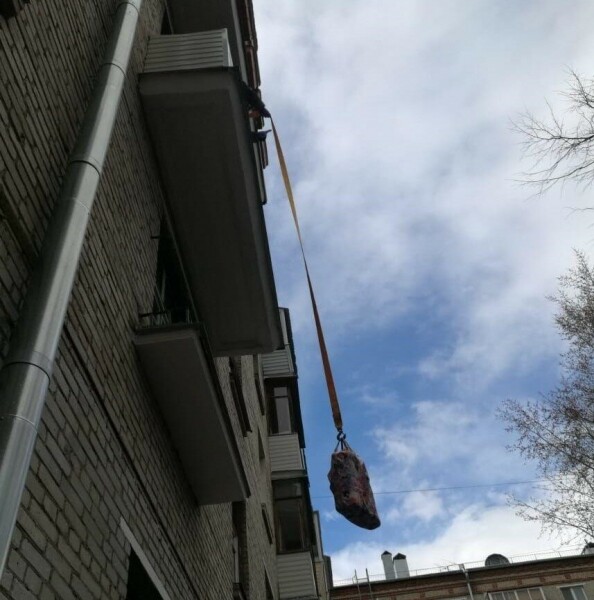
Веднъж клиент помоли куриер на СберМаркет да достави хранителни стоки по безконтактен начин — директно на балкона.
Но нека преминем към конкретиката. Последните няколко месеца активно увеличавахме инфраструктурата на нашата компания. Тази необходимост се обяснява с външни и вътрешни фактори. Паралелно с разширяването на клиентската база, броят на свързаните магазини нарасна от 90 в началото на годината до над 200 през средата на май. Ние, разбира се, се подготвихме, резервирахме основната инфраструктура и разчитахме на възможността за вертикално и horizontally мащабиране на всички виртуални машини, разположени в облака на Яндекс. Въпреки това практиката показа: „Всичко, което може да се обърка, ще се обърка.“ И днес искам да споделя най-интересните ситуации, които се случиха през тези седмици. Надявам се нашият опит да се окаже полезен за вас.
Slave в пълна бойна готовност
Още преди началото на пандемията се сблъскахме с увеличен брой запитвания за нашите backend сървъри. Тенденцията да се поръчват продукти с доставка до дома започна да набира скорост, а с въвеждането на първите мерки за самоизолация по време на COVID-19 натоварването нарастваше драматично пред очите ни през целия ден. Появи се необходимост бързо да разтоварим master-сървърите на основната база данни и да прехвърлим част от запитванията за четене на сървъри-реплики (slave).
Ние предварително се подготвихме за този ход и за подобна маневра вече бяха стартирани 2 slave-сървъра. На тях основно работеха batch-задачи за генериране на информационни фиди за обмен на данни с партньори. Тези процеси създаваха допълнително натоварване и абсолютно справедливо бяха изнесени "извън скобките" няколко месеца по-рано.
Тъй като на Slave се извършваше репликация, ние се придържахме към концепцията, че приложенията могат да работят с тях само в режим read only. Disaster Recovery Plan предвиждаше, че в случай на катастрофа можем просто да монтираме Slave на мястото на Master и да пренасочим всички запитвания за запис и четене към Slave. Въпреки това, ние също искахме да използваме репликите за нуждите на отдела по аналитика, затова сървърите не бяха напълно преведени в статус read only, а на всеки хост имаше свой набор от потребители, и някои имаха права за запис, за да запазят междинни резултати от изчисленията.
До определеното ниво на натоварване ни стигаше единен майстор както за запис, така и за четене при обработката на http запитвания. В средата на март, точно когато Сбермаркет реши да премине напълно на дистанционна работа, при нас започна рязък ръст на RPS. Все повече от нашите клиенти започнаха да се самоизолират или да работят от дома, което се отрази на показателите за натоварване.
Производителността на „майстора“ вече не стигаше, затова започнахме да прехвърляме част от най-тежките запитвания за четене на реплика. За прозрачна насочване на записите към майстора и четенето - към слейва, използвахме ruby gem «». Създадохме специален потребител с постфикс _readonly без права за запис. Но заради грешка в конфигурацията на един от хостовете, част от запитванията за запис се отправиха към slave-сървъра от името на потребителя, който имаше съответните права.
Проблемът не се прояви веднага, тъй като увеличеното натоварване повиши изоставането на слейвовете. Неконсистентността на данните бе открита сутринта, когато след нощните импорти, слейвовете не „настигаха“ майстора. Списахме това на високото натоварване на самия сервис и импорта, свързан с открития на нови магазини. Но предоставянето на данни с многочасово закъснение беше недопустимо, и прехвърлихме процесите на втория аналитичен слейв, защото той разполагаше с бпо-ольше ресурси и не беше натоварен със запитвания за четене (с което обяснихме на самите себе си отсъствието на лаг по репликацията).
Когато разбрахме причините за „разпиляването“ на основния слейв, аналитичният вече беше излязъл от строя по същата причина. Въпреки наличието на два допълнителни сървъра, на които планирахме да прехвърлим натоварването в случай на срив на майстора, заради досадна грешка се оказа, че в критичния момент нямаме нито един.
Но тъй като правехме не само dump на базата данни (възстановяването на този етап отнемаше около 5 часа), а и snapshot на майстор-сървъра, успяхме да стартираме репликата в рамките на 2 часа. Всъщност, след това ни очакваше прилагане на лог репликацията за дълъг период от време (тъй като процесът протича в еднопоточен режим, но това е съвсем друга история).
Извод: След инцидента стана ясно, че трябва да се откажем от практиката на ограничаване на записите за потребителите и да обявим целия сървър за readonly. С подобен подход можем да бъдем сигурни, че репликите ще бъдат достъпни в критичен момент.
Оптимизацията дори на една тежка заявка може да "върне към живот" базата данни.
Въпреки че постоянно обновяваме каталога на сайта, заявките, които извеждахме на Slave-сървърите, допускаха малко закъснение от Master. Времето, за което открихме и отстранихме проблема с „внезапно изчерпващите се“ слейвове, беше повече от „психологическата бариера“ (през това време може да се е случило обновление на цените и клиентите да видят остарели данни), и ние бяхме принудени да пренасочим всички заявки към основния сървър на БД. В резултат сайтът работеше бавно… но поне работеше. А докато Slave-ът се възстановяваше, нямаше какво да правим освен да оптимизираме.
Докато Slave-сървърите се възстановяваха, минутите бавно минаваха, Master оставаше претоварен, а ние насочихме всичките си усилия към оптимизиране на активните задачи съгласно „Правилото на Парето“: избрахме ТОП-заявки, даващи най-голяма част от натоварването, и започнахме тунинг. Това се правеше в движение.
Интересен ефект беше, че натовареният до краен предел MySQL реагира на дори незначително подобрение в процесите. Оптимизацията на две заявки, които дават само 5% от общото натоварване, вече показваше осезаемо облекчение на CPU. В резултат успяхме да осигурим приемлив резерв от ресурси за работата на Master с базата данни и получихме нужното време за възстановяване на репликите.
Извод: Дори малка оптимизация позволява да се "оцелеем" при претоварване в продължение на няколко часа. Нам това ни беше достатъчно в периода на възстановяване на сървърите с реплики. Между другото, техническата страна на оптимизацията на заявките ще обсъдим в един от следващите постове. Така че се абонирайте за нашия блог, ако това може да ви бъде полезно.
Организирайте мониторинг на състоянието на партньорските услуги.
Ние се занимаваме с обработка на поръчки от клиенти и затова нашите услуги постоянно взаимодействат с външни API — това са шлюзове за изпращане на SMS, платежни платформи, системи за маршрутизация, геокодери, служба ФНС и множество други системи. И когато натоварването започна да расте стремително, ние започнахме да се сблъскваме с ограниченията на API на нашите партньори, за които преди не сме се замисляли.
Неочакваното превишаване на квотите на партньорските услуги може да доведе до престой на собствените ви услуги. Много API блокират клиенти, които надхвърлят лимитите, а в някои случаи излишъкът от заявки може да пренатовари продукцията на партньора.
Например, в момент на нарастващ брой доставки, съпътстващите услуги не успяваха да се справят с задачите по разпределение и определяне на маршрути. В резултат на това се оказваше, че поръчките са направени, а услугата, която създава маршрута, не работи. Трябва да кажа, че нашите логисти направиха почти невъзможното в тези условия, а ясното взаимодействие на екипа помогна да се компенсират времевите откази на услугите. Но такъв обем заявки не може да се обработва постоянно ръчно и след известно време щяхме да се сблъскаме с неприемлив разрив между поръчките и тяхното изпълнение.
Бяха предприети редица организационни мерки и синхронизираната работа на колектива помогна да спечелим време, докато се споразумявахме за нови условия и чакахме модернизация на услугите от някои партньори. Има и други API, които радват с висока устойчивост и безумни тарифи при висок трафик. Например, в началото използвахме един известен картографски API за определяне на адреса на точката за доставка. Но в края на месеца получихме сметка от почти 2 милиона рубли. След това решихме бързо да го заменим. Няма да правя реклама, но ще кажа, че разходите ни значително намаляха.
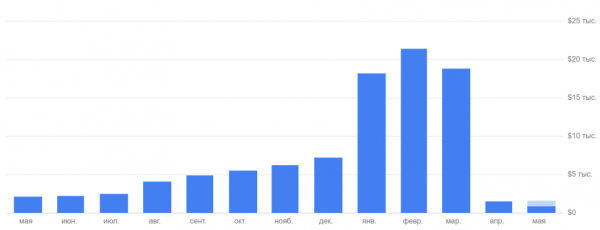
Извод: Задължително трябва да следим условията на работа на всички партньорски услуги и да ги имаме предвид. Дори ако днес изглежда, че те имат "голям запас", това не означава, че утре няма да станат пречка за растежа. И, разбира се, е по-добре предварително да се споразумеем за финансовите условия на увеличените заявки към услугата.
Понякога се оказва, че "" (с) не помага
Привикнахме към "струпванията" в основната БД или на сървърите за приложения, но при мащабиране неприятностите могат да се проявят там, където не сме ги очаквали. За пълнотекстово търсене на сайта използваме движка Apache Solr. С нарастващото натоварване забелязахме намаляване на времето за отговор, а натоварването на процесора на сървъра достигаше 100%. Какво може да е по-просто — даваме на контейнера с Solr повече ресурси.
Вместо очакваното увеличение на производителността, сървърът просто "умря". Той веднага се натоварваше на 100% и отговаряше още по-бавно. Първоначално имахме 2 ядра и 2 ГБ RAM. Решихме да направим нещо, което обикновено помага — увеличихме сървъра до 8 ядра и 32 ГБ. Всичко стана много по-зле (как точно и защо — ще разкажем в отделен пост).
След няколко дни разбрахме тънкостите на този въпрос и постигнахме оптимална производителност при 8 ядра и 32 ГБ. Тази конфигурация позволява и днес да продължаваме да увеличаваме натоварването, което е много важно, тъй като растежът е не само по клиенти, но и по броя на свързаните магазини — за 2 месеца техният брой се удвои.
Извод: Стандартните методи като "добавяне на още хардвер" не работят винаги. Така че при мащабиране на всяка услуга е необходимо добре да разберем как тя използва ресурсите и предварително да тестваме работата ѝ в нови условия.
Stateless — ключът към просто хоризонтално мащабиране
В цялост нашият екип се придържа към известния подход: услугите не трябва да имат вътрешно състояние (stateless) и трябва да бъдат независими от средата на изпълнение. Това ни позволяваше да преживяваме растежа на натоварването чрез просто хоризонтално мащабиране. Но имахме едно изключение — обработчик на дълги фонови задачи. Той се занимаваше с изпращане на имейли и SMS, обработка на събития, генериране на фийдове, импортиране на цени и наличности, обработка на изображения. Така се случи, че той зависеше от локалното файлово хранилище и беше единствен екземпляр.
Когато нарасна броят на задачите в опашката на обработчика (което естествено се случи с увеличаването на поръчките), производителността на хоста, на който се намираха обработчикът и файловото хранилище, стана ограничителен фактор. В резултат на това спря обновлението на асортимента и цените, изпращането на известия до потребителите и много други критични функции, които заседнаха в опашката. Екипът Ops бързо мигрира файловото хранилище в мрежово хранилище, подобно на S3, което ни позволи да увеличим няколко мощни машини, за да мащабираме обработчика за фонови задачи.
Извод: Правилото Stateless трябва да се спазва за всички компоненти без изключение, дори когато изглежда, че "тук със сигурност няма да се сблъскаме с проблем." По-добре е да похарчите малко време за правилна организационна работа на всички системи, отколкото после в бързината да пренаписвате код и да поправяте услуга, която изпитва натоварване.
7 принципа за интензивен растеж
Въпреки наличието на допълнителни ресурси, по време на растежа се сблъскахме с няколко трудности. За този период броят на поръчките се увеличи повече от 4 пъти. В момента вече доставяме над 17 000 поръчки на ден в 62 града и планираме да разширим географията още повече — през първата половина на 2020 г. очакваме стартиране на услугата в цяла Русия. За да се справим с нарастващото натоварване, като вземем предвид вече натрупаните опити, извлякохме 7 основни принципа за работа в условия на постоянен растеж:
- Инцидент мениджмънт. Създадохме дъска в Jira, където всеки инцидент се отразява под формата на тикет. Това ще помогне да приоритизираме и изпълняваме свързаните със инцидента задачи. Все пак в същността си не е страшно да сгрешите — страшно е да сгрешите два пъти по един и същ повод. За случаите, когато инцидентите се повтарят, преди да успеем да поправим причината, трябва да бъде готова инструкция за действие, защото по време на голямо натоварване е важно да реагираме мигновено.
- Мониторинг нужен за всички елементи на инфраструктурата без изключение. Точно благодарение на него успяхме да прогнозираме растежа на натоварването и правилно да изберем „бутилките“, които да приоритизираме за отстраняване. Най-вероятно, при високо натоварване ще се провали или ще започне да забавя всичко, за което дори не сте мислили. Затова новите аларми е най-добре да се създават веднага след настъпването на първите инциденти, за да можем да ги наблюдаваме и предвиждаме.
- Правилните аларми са просто необходими при рязък растеж на натоварването. Първо, те трябва да уведомяват какво точно е счупено. Второ, не трябва да има много аларми, защото изобилието от некритични аларми води до игнориране на всички известия изобщо.
- Приложенията трябва да бъдат статични. Убедихме се, че за това правило не трябва да има изключения. Нужна е пълна независимост от средата на изпълнение. За това можете да съхранявате споделени данни в БД или, например, направо в S3. А още по-добре е да следвате правилата. При рязък растеж времето за оптимизация на кода просто няма и ще трябва да се справите с натоварването чрез директно увеличаване на изчислителните ресурси и хоризонтално мащабиране.
- Квоти и производителност на външните услуги. При бърз растеж проблемът може да възникне не само във вашата инфраструктура, но и във външната услуга. Най-досадното е, когато това се случва не поради сбой, а заради достигане на квоти или лимити. Така че външните услуги трябва да се мащабират толкова добре, колкото и вие самите.
- Разделяйте процесите и опашките. Това много помага, когато на един от шлюзовете настъпи затруднение. Нямаше да се сблъскаме с забавяния в предаването на данни, ако запълнените опашки за изпращане на SMS не пречеха на обмена на известия между информационните системи. И броят на работниците щеше да бъде по-лесно да се увеличава, ако работят поотделно.
- Финансови реалности. Когато протичат експлозивни растежи на потоците данни, нямате време да мислите за тарифи и абонаменти. Но трябва да ги помните, особено ако сте малка компания. Голямо сметка може да издаде собственикът на всяко API, както и вашият хостинг провайдер. Така че трябва да четете договорите внимателно.
Заключение
Не без загуби, но ние преминахме през този етап и днес се стараем да следваме всички намерени принципи, а всяка машина има възможност за лесно увеличаване на производителността х4, за да се справи с неочаквани ситуации.
В следващите постове ще споделим опита си в разследването на спадовете в производителността на Apache Solr и ще разкажем за оптимизацията на заявките, както и как взаимодействието с ФНС помага на компанията да спестява средства. Абонирайте се за нашия блог, за да не пропуснете нищо, и споделете в коментарите, имали ли сте аналогични неприятности по време на растежа на трафика.
Само регистрирани потребители могат да участват в анкетата. , моля.
Случвало ли ви се е забавяне/падане на услугата при рязък ръст на натоварването поради:
55,6%Невъзможността бързо да се добавят изчислителни ресурси10
16,7%Ограниченията на инфраструктурата на хостинг доставчика3
33,3%Ограниченията на външните API6
27,8%Нарушаване на принципите на stateless за собствените приложения5
88,9%Неоптималността на кода на собствените услуги16
Гласували 18 потребители. Въздържали се 6 потребители.
Източник: habr.com
