

Днес, високата достъпност на услугите е необходима навсякъде и винаги, не само в големи скъпи проекти. Временните недостъпни сайтове с надпис „Извинете, провежда се техническо обслужване“ все още се срещат, но обикновено предизвикват снизходителна усмивка. Добавете към това живота в облаците, когато за стартиране на допълнителен сървър е необходим само един извикване на API, като се изключи необходимостта от „желязно“ управление. И вече няма оправдания, защо критичната система не е разработена надеждно с използването на клъстърни технологии и резервиране.
Ще разкажем какви решения разгледахме за осигуряване на надеждността на базите данни в нашите услуги и до какви изводи достигнахме. Плюс демонстрация с далечни изводи.
Легаси в архитектурата на висока достъпност
Още по-добре се вижда в контекста на развитието на различни opensource системи. Старите решения бяха принудени да добавят технологии за висока достъпност, тъй като търсенето нарасна. И качеството им беше различно. Решенията от ново поколение поставят високата достъпност в основата на своята архитектура. Например, MongoDB позиционира клъстъра като основен вариант на приложение. Клъстърът се мащабира хоризонтално, което е силно конкурентно предимство на тази СУБД.
Нека се върнем към PostgreSQL. Това е един от най-старите популярни opensource проекти, първият му релийз е от 95-та година на миналия век. Екипът на проекта дълго време не смяташе, че високата достъпност е задача, която трябва да се решава на системно ниво. Затова технологията за репликация за създаване на копия на данни стана вградена само в версия 8.2 през 2006-та, но тя беше файлово основана (log shipping). През 2010 в версия 9.0 се появи потокова репликация, която е основата за създаване на най-различни клъстъри. Това всъщност изненадва много хора, които се запознават с PostgreSQL след Enterprise SQL или съвременни NoSQL — стандартното решение от общността всъщност е просто двойка master-replica с синхронна или асинхронна репликация. При това, в стоковата версия, превключването на мастера се извършва ръчно и въпросът с превключването на клиентите също се предлага да се решава самостоятелно.
Как решихме да направим надежден PostgreSQL и какво избрахме за това.
Въпреки това, PostgreSQL нямаше да бъде толкова популярен, ако не беше огромното количество проекти и инструменти, които помагат да се изгради отказоустойчиво решение, което не изисква постоянно внимание. В облака (MCS) от самото начало на DBaaS бяха налични единични PostgreSQL сървъри и двойки мастер-реплика с асинхронна репликация.
Естествено, искахме да опростим живота на всички и да направим инсталация на PostgreSQL достъпна, която да служи като основа за високодостъпни услуги, за които не е нужно постоянно да се следи и да ставаме през нощта, за да направим превключване. В този сегмент има и стари проверени решения, и ново поколение утилити, използващи последните разработки.
Днес проблемът с високата достъпност не зависи толкова от резервирането (това е очевидно), а от консенсуса — алгоритъм за избор на лидер (Leader election). Най-често големи аварии се случват не заради липса на сървъри, а заради проблеми с консенсуса: не е избран нов лидер, появяват се двама лидера в различни датацентрове и т.н. Пример — аварията на MySQL кластера на Github — те написаха .
Математичната база за този въпрос е много сериозна. От една страна, има , която налага теоретични ограничения върху възможностите за построяване на HA решения, от друга страна — математически доказани алгоритми за определяне на консенсус, като и . На тази основа съществуват доста популярни DCS (системи за децентрализиран консенсус) — Zookeeper, etcd, Consul. Затова, ако системата за вземане на решения работи на собствен алгоритъм, написан самостоятелно, трябва да се отнасяме към него с особено внимание. След анализ на огромно количество системи, ние избрахме Patroni — open-source система, основно разработвана от компанията Zalando.
Като лирично отклонение, ще кажа, че ние разгледахме и решения с много-подредители, тоест клъстери, които могат да се мащабират хоризонтално за запис. Въпреки това, по две основни причини решихме да не правим такъв клъстер. Първо, такива решения имат висока сложност и съответно повече уязвимости. Ще бъде трудно да се направи стабилно решение за всички случаи. На второ място, в такъв случай PostgreSQL спира да бъде чист (native), някои функции ще бъдат недостъпни, а при работа с някои приложения могат да възникнат скрити проблеми.
Patroni
И така, как работи Patroni? Разработчиците не изобретиха колелото и предложиха да се използва една от проверените DCS-решения. Всички въпроси с синхронизацията на конфигурации, избора на лидер и кворума са оставени в ръцете му. Ние избрахме за това etcd.
След това Patroni се занимава с правилното прилагане на всички настройки в PostgreSQL и конфигурациите за репликация, както и с изпълнението на команди за switchover и failover (тоест – нормално и извънредно превключване на мастера). Конкретно в облака MCS можете да създадете клъстер от мастер, синхронна реплика и една или повече асинхронни реплики. Присъствието на синхронна реплика осигурява запазването на данните на поне 2 сървъра и именно тази реплика ще бъде основният "кандидат за мастер".
Тъй като etcd се инсталира на същите сървъри, се препоръчва брой на сървърите от 3 или 5 за оптимална стойност на кворума. Такъв клъстер се мащабира хоризонтално за четене (за мащабиране на запис, споменах по-горе). Въпреки това, трябва да се вземе под внимание, че асинхронните реплики имат тенденция да изостават, особено при високи натоварвания.
Използването на такива реплики за четене (hot standby) е оправдано за задачи за отчитане или аналитика и облекчава мастер-сървъра.
Ако искате да направите такъв клъстер сами, то ще ви е необходимо:
- да подготвите 3 или повече сървъра, да настроите IP-адресацията и правилата за firewall между тях;
- да инсталирате пакетите за услугите etcd, Patroni, PostgreSQL;
- да настроите etcd клъстер;
- да настроите услугата patroni за работа с PostgreSQL.
То есть, общо взято, необходимо правильно составить десяток конфигурационных файлов и избежать ошибок. Для этого определённо стоит использовать инструмент управления конфигурацией, такой как Ansible, например. При этом здесь всё равно отсутствует высокодоступный TCP-балансировщик. Создание его — отдельная задача.
Для тех, кто нуждается в готовом кластере, но не хочет углубляться в детали, мы постарались упростить процесс и предоставили готовый кластер на Patroni в нашем облаке, который можно протестировать бесплатно. Помимо самого кластера, мы реализовали:
- TCP-балансировщик; он всегда указывает на текущий мастер, синхронную или асинхронную реплику в зависимости от портов;
- API для переключения активного мастера Patroni.
Их можно подключать как через API облака MCS, так и через веб-консоль.
Демо
Для тестирования возможностей кластера PostgreSQL в облаке MCS давайте посмотрим, как будет вести себя живое приложение при возникновении проблем с СУБД.
Далее представлен код приложения, которое будет логировать искусственные события и выводить их на экран. В случае ошибок оно будет сообщать об этом и продолжать свою работу в цикле, пока мы не остановим его комбинацией Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Соединение установлено с", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Значение зафиксировано, общее количество: {}".format(record[0]))
    except Exception as error:
        print ("Ошибка при подключении к PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Соединение закрыто")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Поймано исключение:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("выход")
Приложению для работы необходим PostgreSQL. Создадим кластер в облаке MCS, используя API. В обычном терминале, где в переменной OS_TOKEN содержится токен для доступа к API (его можно получить командой openstack token issue), наберём команды:
Создаем кластер:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
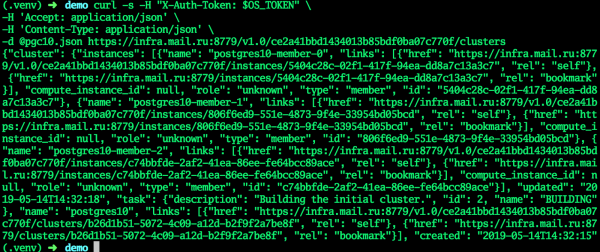
Когато кластерът премине в статус ACTIVE, всички полета ще получат актуални стойности — кластерът е готов.
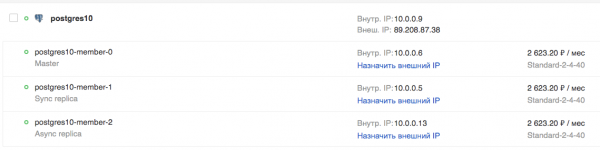
В GUI:
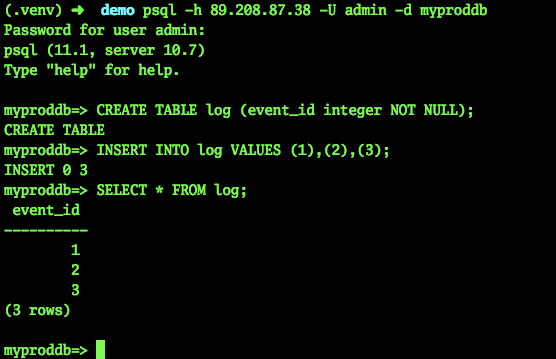
Нека се опитаме да се свържем и да създадем таблица:
psql -h 89.208.87.38 -U admin -d myproddb
Парола за потребител admin:
psql (11.1, сървър 10.7)
Напишете "help" за помощ.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 реда)

myproddb=>
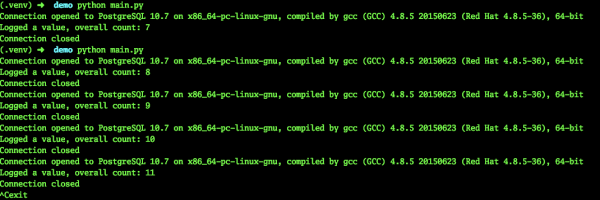
В приложението укажете актуалните настройки за свързване с PostgreSQL. Ще посочим адреса на TCP балансьора, така няма да е необходима ръчна смяна на адреса на мастера. Стартираме го. Както се вижда, събитията успешно се логват в базата данни.
Планирано смяна на мастера
Сега ще тестваме работата на нашето приложение при планирана смяна на мастера:
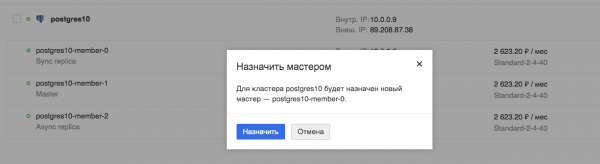
Наблюдаваме приложението. Виждаме, че работата на приложението наистина спира, но това отнема само няколко секунди, в конкретния случай максимум 9.
Падане на машината
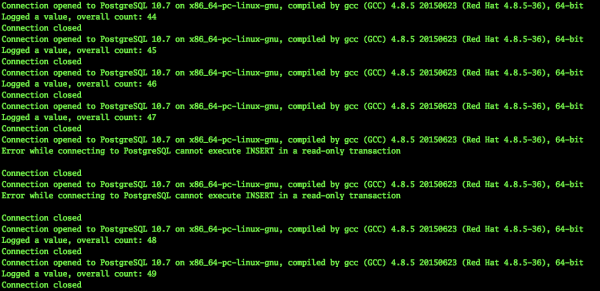
Сега ще се опитаме да симулираме падане на виртуалната машина, текущия мастер. Можехме просто да изключим виртуалната машина през интерфейса Horizon, но това щеше да бъде стандартно изключване. Такава смяна ще бъде обработена от всички услуги, включително Patroni.
Но ние имаме нужда от непредсказуемо изключване. Затова помолих нашите администратори в тестови условия да изключат виртуалната машина — текущия мастер — по нестандартен начин.
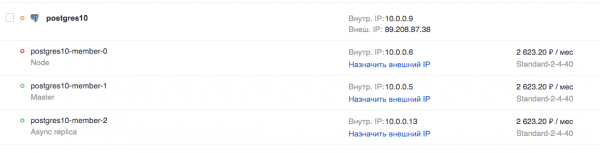
В същото време нашето приложение продължаваше да работи. Разбира се, такава спешна смяна на мастера не може да мине незабелязано.
2019-03-29 10:45:56.071234
Свързване установено с PostgreSQL 10.7 на x86_64-pc-linux-gnu, компилиран от gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-бит
Записан елемент, общ брой: 453
Свързването затворено
2019-03-29 10:45:59.205463
Свързване установено с PostgreSQL 10.7 на x86_64-pc-linux-gnu, компилиран от gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-бит
Записан елемент, общ брой: 454

Свързването затворено
2019-03-29 10:46:02.661440
Грешка при свързването с PostgreSQL, сървърът затвори връзката неочаквано
        Това вероятно означава, че сървърът е приключил ненадейно
        преди или по време на обработката на заявката.

Заловена грешка:
 локалната променлива 'connection' е спомената преди да е зададена
……………………………………………………….. - тук има известно количество грешки
2019-03-29 10:46:30.930445
Грешка при свързването с PostgreSQL, сървърът затвори връзката неочаквано
        Това вероятно означава, че сървърът е приключил ненадейно
        преди или по време на обработката на заявката.

Заловена грешка:
 локалната променлива 'connection' е спомената преди да е зададена
2019-03-29 10:46:31.954399
Свързване установено с PostgreSQL 10.7 на x86_64-pc-linux-gnu, компилиран от gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-бит
Записан елемент, общ брой: 455
Свързването затворено
2019-03-29 10:46:35.409800
Свързване установено с PostgreSQL 10.7 на x86_64-pc-linux-gnu, компилиран от gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-бит
Записан елемент, общ брой: 456
Свързването затворено
^Cизход
Както може да се види, приложението успя да продължи работата си по-малко от 30 секунди. Да, някои потребители на услугата могат да забележат проблемите. Въпреки това, това е сериозен срив на сървъра, който не се случва често. Освен това е малко вероятно администраторът да е успял да реагира толкова бързо, освен ако не е седял на конзолата на готовност със скрипт за превключване.
Извод
На мен ми се струва, че такъв кластер дава огромно предимство на администраторите. По същество, сериозните сривове и неработещи бази данни няма да бъдат забелязани от приложението и съответно от потребителя. Няма да се налага да се ремонтира нещо в бързина и да се преминава на временно конфигуриране, сървъри и т.н. А ако такова решение се използва под формата на готова услуга в облака, то няма да е нужно да се отделя време за подготовка. Може да се занимавате с нещо по-интересно.
Източник: habr.com
