

Здравейте! Аз се казвам Алексей Пьянков, разработчик в компанията Спортмастер. В това разказах как започна работата по сайта Спортмастер през 2012 година, какви инициативи успяхме да "протолкнем" и обратно, какви капани събрахме.
Днес искам да споделя мисли, които следват друг сюжет – избор на система за кеширане за java-бекенда в административната част на сайта. Този сюжет има особено значение за мен – макар историята да се разгръщаше само 2 месеца, през тези 60 дни работихме по 12-16 часа без един единствен почивен ден. Никога преди не бях мислил и не си представях, че е възможно да се работи толкова много.
Затова разделям текста на 2 части, за да не натоваря изцяло. Обратно, първата част ще бъде много лека — подготовка, въвеждане, някои разсъждения за това какво е кеширане. Ако вече сте опитен разработчик или сте работили с кешове — от техническа гледна точка в тази статия вероятно няма да намерите нищо ново. А за начинаещите, малък преглед може да насочи в коя посока да погледнете, ако се окажат на такъв разклон.
Когато новата версия на сайта Спортмастер беше пусната в продукция, данните постъпваха по начин, меко казано, не много удобен. Основата бяха таблици, подготвени за предишната версия на сайта (Bitrix), които трябваше да бъдат изтеглени в ETL, приведени в нов вид и обогатени с различни финтифлюшки още от десетина системи. За да се появят новите изображения или описания на продуктите на сайта, трябваше да изчакаме до следващия ден — обновлението ставаше само през нощта, веднъж на ден.
Поначалото имаше толкова много грижи през първите седмици след пускането в продукция, че такива неудобства за съдържателите на съдържание бяха дреболия. Но, щом всичко се утаи, развитието на проекта продължи — след няколко месеца, в началото на 2015 година, започнахме активно да разработваме административната част. През 2015 и 2016 всичко вървеше добре, редовно публикувахме новини, административната част обхващаше все по-голяма част от подготовката на данните и се подготвяхме за това, че скоро на нашия екип ще бъде доверено най-важното и сложно – стоковият контур (пълна подготовка и поддържане на данни за всички стоки). Но през лятото на 2017, точно преди пускането на стоковия контур, проектът ще се окаже в много сложна ситуация – именно заради проблеми с кеширането. За този епизод искам да разкажа във втората част на тази двусерийна публикация.
Но в този пост ще започна отдалече, ще обсъдя някои мисли – представления за кеширане, които би било добре да прегледате преди стартирането на голям проект.
Когато се появи задачата за кеширане
Задачата за кеширане не се появява просто така. Ние сме разработчици, пишем софтуерни продукти и искаме те да бъдат търсени. Ако продуктът е търсен и успешен, потребителите идват. И идват все повече. И ето, че потребителите са много, а продуктът става високонагрузен.
В началните етапи не мислим за оптимизация и производителност на кода. Основното е функционалността, да пуснем пилот и да тестваме хипотезите. И ако натоварването нараства – ние увеличаваме хардуера. Увеличаваме го два, три, пет, дори десет пъти. Някъде тук – финансите вече не позволяват. А колко ще нарасне броят на потребителите? Това няма да е просто 2-5-10, но в случай на успех – това ще бъде от 100 до 1000 и до 100 хиляди пъти. Тоест, рано или късно, но ще се наложи да се занимаем с оптимизация.
Да предположим, че част от кода (нека наречем тази част функция) работи неоправдано дълго и искаме да намалим времето за изпълнение. Функцията може да е достъп до база данни, или да извършва сложна логика – важното е, че се изпълнява дълго. С колко можем да намалим времето за изпълнение? В крайния случай – можем да го сведем до нула, не повече. А как можем да сведем времето за изпълнение до нула? Отговор: напълно да изключим изпълнението. Вместо това – веднага да върнем резултата. А как да узнаем резултата? Отговор: или да изчислим, или да го погледнем някъде. Изчислението отнема време. А поглеждането – например, да запомним резултата, който функцията е дала при предишното си извикване с еднакви параметри.
Тоест, реализация на функцията не е важна за нас. Достатъчно е само да знаем от какви параметри зависи резултатът. Тогава, ако стойностите на параметрите се представят под формата на обект, който може да се използва като ключ в някакво хранилище — можем да запазим резултата от изчислението и при следващото му извикване да го считаме. Ако записването и четенето на резултата става по-бързо от изпълнението на функцията – имаме печалба по скорост. Размерът на печалбата може да достигне 100, 1000 или дори 100 хиляди пъти (10^5 – това е по-скоро изключение, но в случай с бази, които куцамят немалко – е напълно възможно).
Основни изисквания за системата за кеширане
Първото изискване за системата за кеширане е бързата скорост на четене и в малко по-малка степен – скоростта на запис. Така е, но само дотогава, докато не внедрим системата в продукция.
Нека разгледаме един такъв случай.
Допускаме, че сме подсигурили хардуера за текущото натоварване и сега постепенно внедряваме кеширане. Потребителите нарастват малко, натоварването се увеличава – добавяме малко кешове, прикрепяме тук-там. Това продължава известно време и ето, тежките функции вече почти не се извикват — цялото основно натоварване пада на кеша. Броят на потребителите през това време е нараснал N пъти.
И ако началният запас от хардуер е бил 2-5 пъти, то с помощта на кеша сме могли да увеличим производителността в 10 или, в добър случай, 100 пъти, на места, може би, и 1000. Тоест, на същия хардуер – обработваме 100 пъти повече заявки. Отлично, заслужихме награда!
Но сега, в един прекрасен момент, случайно, системата се срина и кеша падна. Нищо особено – защото кеша е избран по изискване "висока скорост на четене и запис, останалото не е важно".
Относно началното натоварване запасът от хардуер е бил 2-5 пъти, а натоварването през това време е нараснало 10-100 пъти. С помощта на кеша сме изключвали извикванията за тежките функции и затова всичко работеше бързо. А сега, без кеша – колко много ще падне нашата система? Какво ще се случи? Системата ще се срути.
Дори ако нашият кеш не се е сринал, а само се е изчистил за известно време – ще трябва да го прогреем, и това ще отнеме известно време. И за това време – основното натоварване ще падне на функционала.
Извод: високо натоварените проекти в продукцията изискват от системата за кеширане не само висока скорост на четене и запис, но също така и запазване на данните и устойчивост на сривове.
Мъките на избора
В проекта с административен панел – избора премина така: първо инсталирахме Hazelcast, тъй като вече бяхме запознати с този продукт от опита на основния сайт. Но тук такъв избор се оказа неуспешен – под нашия профил на натоварване Hazelcast работи не просто бавно, а ужасно бавно. А по сроковете за преминаване в продукция вече бяхме подписали.
Спойлер: как точно се стекоха обстоятелствата, че пропуснахме такъв удар и получихме остър и напрегнато ситуация – ще разкажа във втората част — и как се оказахме, и как избягахме. Но сега — ще кажа само, че това беше силен стрес, и "мислене – нещо не идва на ум, разтърсваме бутилката". "Разтърсваме бутилката" – това също е спойлер, за това малко по-късно.
Какво направихме:
- Съставяме списък от всички системи, които подсказва Google и StackOverflow. Малко над 30.
- Пишем тестове с натоварване, характерно за продукцията. За това записахме данните, които преминават през системата в продукционно окружение — нещо като сниффер за данни не в мрежата, но вътре в системата. В тестовете пускахме точно тези данни.
- Целият екип, всеки избира следващата система от списъка, настройва, изпълнява тестовете. Не минава теста, не издържа натоварването – изхвърляме, преминаваме към следващата в реда.
- На 17-тата система стана ясно, че всичко е безнадеждно. Хватит "да разтърсваме бутилката", време е да помислим сериозно.
Но това е вариант, когато трябва да изберем система, която "преминава по скорост" в предварително подготвените тестове. А какво ако такива тестове все още няма и искаме да изберем по-бързо?
Моделираме такъв вариант (трудно е да си представим, че средно плюс разработчик живее в вакуум, и в момента на избора все още не е оформил предпочитание, какъв продукт да пробва първо — затова, по-нататъшните разсъждения са по-скоро теория/философия/за джуниор).
Определяйки изискванията, ще започнем да избираме решение от кутията. Зачем да изобретяваме велосипед: ще отидем и вземем готова система за кеширане.
Ако току-що започвате и ще търсите в Гугъл, ще се запознаете с реда, но основните насоки ще са следните. Първо, ще се натъкнете на Redis, който е познат на всеки. Последва EhCache – най-старата и проверена система. След това ще прочетете за Tarantool – местна разработка с уникален аспект на решението. И Ignite, тъй като в момента е на възход и се радва на подкрепа от СберТех. Накрая, Hazelcast, тъй като често присъства в корпоративния свят на големи компании.
Този списък не е изчерпателен, съществуват десетки системи. Ние ще вземем само една. Нека да изберем 5 системи за „красота“ и да проведем отбор. Кой ще бъде победителят?
Redis
Четем какво пише на официалния сайт.
— opensource проект. Предлага in-memory хранилище за данни, възможност за запазване на диска, автоматично разпределение на партиции, висока наличност и възстановяване след мрежови прекъсвания.
Изглежда прекрасно, може да се вземе и внедри — прави всичко, което е нужно. Но нека просто от любопитство погледнем другите кандидати.
EhCache
— „най-широко използваният кеш за Java“ (превод на слоган от официалния сайт). Също opensource. И осъзнаваме, че Redis не е за Java, а е общ и за взаимодействие с него ни е необходима обвивка. EhCache ще е по-удобен. Какво още обещава системата? Надеждност, провереност, пълна функционалност. И е най-разпространената. И кешира терабайти данни.
Redis е забравен, готов съм да избера EhCache.
Но чувството на патриотизъм ме подтиква да видя какво доброто предлага Tarantool.
Tarantool
— описва се като „Платформа за интеграция на данни в реално време“. Звучи много сложно, затова четем страницата подробно и намираме шумно изявление: „Кешира 100% от данните в оперативната памет“. Това трябва да събуди въпроси — понеже данните могат да бъдат значително повече от паметта. Обяснението е, че тук подразбираме, че за запис на данни на диск от паметта, Tarantool не извършва сериализация. Вместо това — използва нискоуровневите характеристики на системата, когато паметта просто се мапва на файловата система с много добри показатели I/O. Общо взето, направили са нещо чудесно и страхотно.
Нека видим внедренията: Mail.ru корпоративна магистрала, Авито, Билайн, Мегафон, Алфа-Банк, Газпром…
Ако все още остават съмнения относно Tarantool, то случаят с внедряването в Mastercard ме убива. Взимам Tarantool.
Но все пак...
Ignite
... все още има , обявен като «in-memory изчислителна платформа… in-memory скорости на петабайти данни». И тук също има много плюсове: разпределен in-memory кеш, най-бързото key-value хранилище и кеш, хоризонтално мащабиране, висока наличност, строга цялост. В общи линии, най-бързият всъщност е Ignite.
Внедрения: Сбербанк, American Airlines, Yahoo! Japan. А след това научавам, че Ignite не само е внедрен в Сбербанк, а екипът на СберТеха изпраща свои хора в екипа на Ignite, за да доразвият продукта. Това напълно ме печели и съм готов да взема Ignite.
Напълно неразбираемо защо, гледам на петия пункт.
Hazelcast
Влизам на сайта , чета. И се оказва, че най-бързото решение за разпределено кеширане е Hazelcast. Той е многократно по-бърз от всички останали решения и изобщо е лидер в областта на in-memory data grid. На фона на това е нелепо да вземеш нещо друго – да нямаш самоуважение. А също така използва излишно съхранение на данни за непрекъсната работа на клъстера без загуба на данни.
Всичко, готов съм да взема Hazelcast.
Сравнение
Но ако погледнем, всички пет кандидата са описани така, че всеки от тях е най-добрият. Как да изберем? Можем да видим кой от тях е най-популярен, да потърсим сравнения и главоболието ще отмине.
Намираме такова , избираме нашите 5 системи.
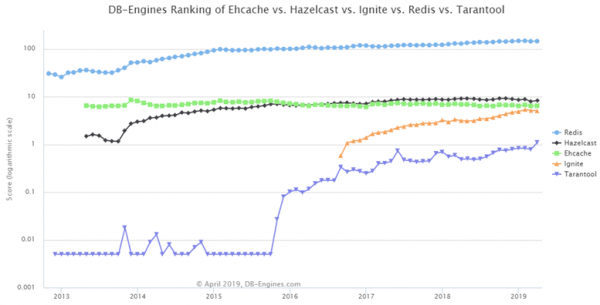
Тук те са сортирани: на върха е Redis, на второ място — Hazelcast, набират популярност Tarantool и Ignite, EhCache остава така, както беше.
Но да погледнем на : линкове към уебсайтове, общ интерес към системата, предложения за работа — чудесно! Тоест, когато системата ми падне, ще кажа: «Не, тя е надеждна! Вот много предложения за работа…». Такова просто сравнение няма да е подходящо.
Всички тези системи не са просто системи за кеширане. Те имат много функции, включително – когато не данните се предават на клиента за обработка, а обратното: кодът, който трябва да се изпълни над данните, преминава на сървъра, там се изпълнява и резултатът се връща. И като отделна система за кеширане, не се разглеждат толкова често.
Добре, не се предаваме, ще намерим директно сравнение на системите. Ще вземем двата горни варианта — Redis и Hazelcast. Интересува ни скоростта, по този параметър ще ги сравним.
Hz vs Redis
Намираме такова :
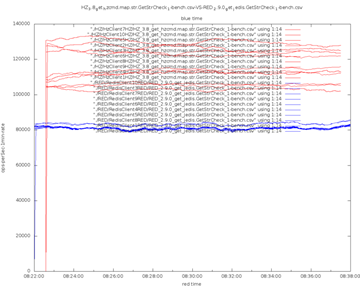
Синият е Redis, червеният е Hazelcast. Hazelcast печели навсякъде, а това е оправдано: той е многопоточен, високо оптимизиран, всеки поток работи със собствената си партиция, така че няма блокировки. Redis, от друга страна, е еднопоточен и не печели от съвременните многоядрени CPU. Hazelcast има асинхронно I/O, а Redis-Jedis — блокиращи сокети. Накрая, Hazelcast използва бинарен протокол, а Redis е текстово ориентиран, т.е. той е неефективен.
Просто за всеки случай, ще погледнем и на друг източник за сравнение. Какво ще ни покаже той?
Redis срещу Hz
Още едно :
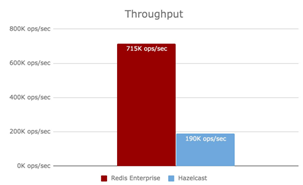
Тук наоборот, червеният е Redis. Тоест, Redis печели по производителност спрямо Hazelcast. В първото сравнение спечели Hazelcast, а във второто — Redis. много точно обясниха защо в предишното сравнение спечели Hazelcast.
Оказва се, че резултатът от първото сравнение е бил фактически манипулиран: взели са Redis в базова конфигурация, а Hazelcast е бил настройван за тестовия случай. Следователно, на първо място, не трябва да се вярва на никого, а на второ място, когато все пак изберем система, трябва да я настроим правилно. Тези настройки включват десетки, почти стотици параметри.
Разтърсваме бутилката
И целият процес, който току-що извършихме, мога да обясня с метафората "Разтърсваме бутилката". Тоест, сега не е необходимо да програмираме; сега най-важното е да умеем да четем stackoverflow. В екипа ми има човек, професионалист, който работи по този начин в критични моменти.
Какво прави той? Вижда неработещо нещо, вижда stack trace, взема няколко думи от него (които точно — това е неговата експертиза в програмата), търси в гугъл, намира stackoverflow сред отговорите. Не чете, не се замисля, сред отговорите на въпроса — избира нещо, което най-много прилича на предложението "направи това и това" (изборът на такъв отговор — това е неговият талант, тъй като не винаги е именно този отговор, който събра повече лайкове), прилага, проверява: ако нещо се е променило, отлично. Ако не се е променило — оттегляме и повтаряме стартиране-проверка-търсене. И по този интуитивен начин той постига, че след известно време кодът работи. Не знае защо, не знае какво е направил, не може да обясни. Но! Това нещо работи. И "пожарът е погасен". Сега разбираме какво сме направили. Когато програмата работи — това е с порядки по-лесно. И спестява значително време.
Този метод се обяснява много добре с такъв пример.
Някога беше много популярно да се сглобяват корабчета в бутилки. Корабчето е голямо и крехко, а шията на бутилката е много тясна, не може да се промъкне вътре. Как да се сглоби?
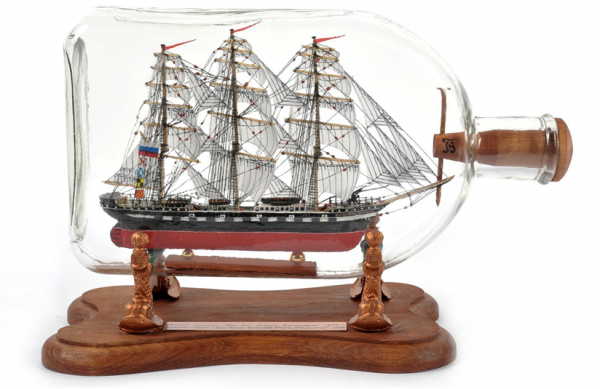
Има един метод, много бърз и много ефективен.
Корабът се състои от купчини дреболии: пръчки, връзки, платна, лепило. Всичко това слагаме в бутилката.
Държим бутилката с две ръце и започваме да я разклащаме. Разклащаме я, разклащаме я. И обикновено – получава се пълна глупост, разбира се. Но понякога. Понякога се получава кораб! По-точно, нещо, което прилича на кораб.
Показваме това нещо на някого: „Серога, виждаш ли!?“. И наистина, отдалеч – изглежда като кораб. Но после не може да се пусне.
Има и друг метод. По-напредналите момчета, така наречените хакери, го използват.
Зададох задача на такъв човек, той всичко направи и си тръгна. И гледаш – изглежда, че е направено. Но след известно време, когато трябва да преработиш кода – започват да стават неща заради него… Добре, че вече е успял да се отдалечи. Тези момчета, които на примера с бутилката правят така: виждате ли, където е дъното – стъклото се извива. И не е съвсем ясно, прозрачно ли е или не. Тогава „хакерите“ отрязват дъното, вмъкват там корабчето, а след това отново приклеят дъното и е като че така и трябва.
От гледна точка на поставяне на задача, изглежда всичко е правилно. Но на примера с корабите: за какво изобщо да направим този кораб, на кого всъщност е нужен? Той не носи никаква функционалност. Обикновено такива корабчета са подаръци на много високи хора, които ги поставят на рафта над себе си като символ, знак. И ако на такъв човек, ръководител на голям бизнес или високопоставен чиновник, стои такова дърворезба, на което дъното е отрязано? По-добре е, ако той никога не научи за това. Та, как всъщност правят тези кораби, които могат да бъдат подарени на важен човек?
Единственото място, с което наистина не може да се направи нищо, е корпусът. И корпусът на кораба преминава точно през шията на бутилката. Докато корабът се сглобява извън бутилката. Но не е просто да се сглобиш кораб; това е истинско златарско изкуство. В съставните части се добавят специални лостчета, които позволяват след това да се повдигнат. Например, платната се сгъват, вписват се внимателно вътре и след това с пинцет много внимателно, точно, ги навиват и повдигат. В резултат се получава произведение на изкуството, което може да се подари с чиста съвест и гордост.
И ако искаме проектът да бъде успешен, в екипа трябва да има поне един златар. Този, който се грижи за качеството на продукта и взема предвид всички аспекти, без да жертва нито един, дори в моменти на стрес, когато обстоятелствата изискват да се направи нещо бързо, в ущърб на важните неща. Всички успешни проекти, които са устойчиви и са издържали проверката на времето, са изградени на този принцип. В тях има нещо много точно и уникално, нещо, което използва всички налични възможности. В примера с кораба в бутилка се обиграва фактът, че корпусът на кораба преминава през шията.
Връщайки се на задачата да изберем нашия кеширащ сървър, как бихме могли да приложим този метод? Предлагам вариант за избор от всички налични системи — да не разклащаме бутилката, а да разгледаме какво всъщност имат, за какво да обърнем внимание при избора на система.
Къде да търсим bottle-neck
Ще се опитаме да не разклащаме бутилката, а вместо това да видим какви задачи могат да възникнат, ако, например, под своя задача — проектираме такава система сами. Разбира се, няма да сглобим велосипед, но ще използваме тази схема, за да се ориентираме какви моменти да вземем предвид в описанията на продуктите. Нека начертаем такава схема.
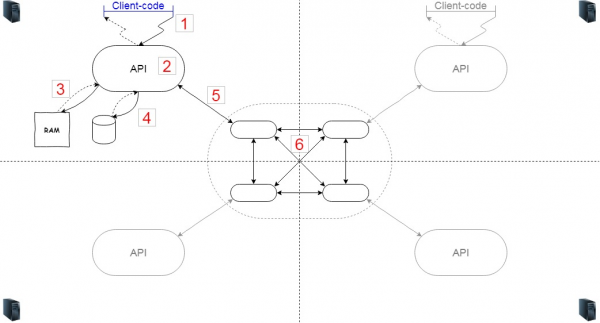
Ако системата е разпределена, значи ще имаме няколко сървъра (6). Да кажем, че са четири (удобно е да бъдат показани на изображението, но разбира се, колкото и да е необходимо). Ако сървърите са на различни възли, значи на тях всички работи определен код, който отговаря за образуването на клъстер и в случай на скъсване — свързват се и разпознават един друг.
Сега е необходим код-логика (2), която е всъщност за кеширането. С този код клиентите взаимодействат чрез определено API. Клиентският код (1) може да бъде както в рамките на същата JVM, така и да се свързва с него по мрежата. Логиката, реализирана вътре, е решението какви обекти в кеша да оставим и какви да изхвърлим. За съхранение на кеша използваме памет (3), но ако е необходимо, част от данните можем да запазим и на диск (4).
Нека погледнем къде ще възникне натоварването. Всъщност натоварване ще имат всяка стрелка и всеки възел. На първо място, между клиентския код и API, ако това е мрежово взаимодействие, проседването може да е доста забележимо. На второ място, в рамките на самото API — ако прекалим със сложната логика, можем да се сблъскаме с CPU. И добре би било логиката да не върти паметта излишно. Остава взаимодействието с файловата система – в обикновения вариант това е сериализиране / възстановяване и записване / четене.
Следва взаимодействието с клъстера. Най-вероятно той ще бъде в същата система, но може да бъде и отделно. Тук също трябва да се вземе предвид предаването на данни към него, скоростта на сериализация на данните и взаимодействието между клъстера.
Сега, от една страна – можем да си представим "какви зъбни колела ще се въртят" в кеш-системата при обработка на заявки от нашия код, а от друга страна – можем да предвидим какви и колко заявки нашият код ще генерира към тази система. Това е достатъчно, за да направим сравнително разумен избор – да подберем система според нашия вариант на използване.
Hazelcast
Нека видим как да приложим такова разпределение към нашия списък. Например, Hazelcast.
За да постави / вземе данни от Hazelcast, клиентският код се обръща (1) към API. Hz позволява да се стартира сървър като вграден, и в този случай извикването на API е повикване на метод вътре в JVM, може да се счита за безплатно.
За да сработи логиката в (2), Hz разчита на хеш от байт-масива на сериализирания ключ – тоест, сериализацията на ключа ще се случи във всеки случай. Това е неизбежен разход за Hz.
Стратегиите за изхвърляне са реализирани добре, но за специални случаи – можете да свържете своите. За тази част не е нужно да се притеснявате.
Хранилището (4) може да се свързва. Отлично. Взаимодействието (5) за embedded може да се счита за моментално. Обменът на данни между възлите в клъстера (6) – да, той съществува. Това е принос за отказоустойчивост за сметка на скоростта. Намаляването на цената е възможно благодарение на Hz-функцията Near-cache – данните, получени от други нодове на клъстера, ще бъдат кеширани.
Какво може да се направи в такива условия за повишаване на скоростта?
Например, за да избегнем сериализацията на ключа в (2) – върху Hazelcast да добавим още един кеш за най-горещите данни. В Спортмастер за тази цел избраха Caffeine.
За настройките на ниво (6), в Hz са предложени два типа съхранение: IMap и ReplicatedMap.
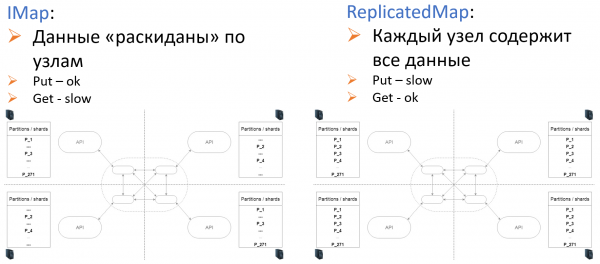
Трябва да кажем как Hazelcast попадна в технологичния стек на Спортмастер.
През 2012 година, когато работихме по най-ранния пилот на бъдещия сайт, именно Hazelcast се оказа първата връзка, която търсачката предостави. Запознанството започна „от първия път“ — впечатли ни, че само два часа след като добавихме Hz в системата — той работеше. И работеше добре. До края на деня написахме още няколко теста, зарадвахме се. И този запас от бодрост стигна, за да преодолеем изненадите, които Hz ни подаваше с времето. В момента екипът на Спортмастер няма причина да се отказва от Hazelcast.
Но такива аргументи, като „първа връзка в търсачката“ и „бързо направихме HelloWorld“ — това, разбира се, е изключение и особеност на момента, в който се водеше изборът. Истинските изпитания за избраната система започват с преминаването в продукция, и именно на този етап трябва да се обърне внимание при избора на всяка система, включително и кеша. Всъщност, в нашия случай може да се каже, че избрахме Hazelcast случайно, но после се оказа, че сме избрали правилно.
За продукция много по-важни са: мониторинг, справяне с аварии на отделни възли, репликация на данни, цена на мащабиране. Тоест, стоит да се акцентира на задачите, които ще възникнат точно при поддръжка на системата – когато натоварването превиши планираното десетократно, когато случайно заредим нещо неподходящо и не там, когато е нужно да пуснем нова версия на кода, да сменим данните и да направим това незабележимо за клиентите.
За всички тези изисквания, Hazelcast несъмнено подхожда.
Следва продължение
Но Hazelcast не е панацея. През 2017 година избрахме Hazelcast за кеша в админ панела, основно на база на доброто впечатление от предишния опит. Това изигра ключова роля в много злостна шега, поради което се оказахме в сложна ситуация и "героично" се изтегляхме от нея 60 дни. Но за това в следващата част.
А засега… Happy New Code!
Източник: habr.com
