

Когато работата ти е да създаваш нещо красиво, не е нужно да се говори много за нея, защото резултатът е пред очите на всички. Обаче, ако изтриваш надписи от огради, никой не забелязва работата ти, докато оградите изглеждат прилично или докато не изтриеш нещо неподходящо.
Всеки сервис, в който може да се остави коментар, отзив, да се изпрати съобщение или да се качат снимки, рано или късно се сблъсква с проблема с спама, измамите и нецензурния език. Това е неизбежно, но с него трябва да се борим.
Казвам се Михаил и работя в екипа по антиспам, който защитава потребителите на услугите на Яндекс от подобни проблеми. Работата ни рядко е видима (и добре!), затова днес ще разкажа повече за нея. Ще научите в кои случаи модерацията не е полезна и защо точността не е единственият показател за нейната ефективност. Освен това ще поговорим за нецензурния език, използвайки примери с котки и кучета, и защо понякога е полезно да „мислим като човек, който използва нецензурен израз“.
В Яндекс се появяват все повече услуги, където потребителите публикуват своето съдържание. Може да зададеш въпрос или да напишеш отговор в Яндекс.Кю, да обсъждаш новини от района в Яндекс.Район, да споделиш пътната обстановка в разговорите на Яндекс.Карти. Но когато аудиторията на услугата нараства, тя става привлекателна за измамници и спамери. Те идват и запълват коментарите: предлагат лесна печалба, рекламират чудодейни средства и обещават социални помощи. Поради спамерите едни потребители губят пари, а други — желанието да прекарват време на занемарена, запълнена със спам услуга.
И това не е единственият проблем. Стремим се не само да защитим потребителите от измамници, но и да създадем комфортна атмосфера за общуване. Ако хората в коментарите се сблъскват с нецензурен език и обиди, те с голяма вероятност ще си тръгнат и няма да се върнат. Следователно, с това също трябва да можем да се борим.
Чистият Уеб
Както често се случва при нас, първоначалните разработки се появиха в Търсенето, в частта, която се бори с спама в резултатите. Още преди десет години там се постави задача за филтриране на възрастно съдържание за семейното търсене и за запитвания, които не предполагат отговори от категорията 18+. Така се появиха първите, ръчно написани речници за порнография и нецензурен език, които се попълваха от анализатори. Основната задача беше класификация на запитванията на тези, където е допустимо да се показва възрастно съдържание и където не е. За тази задача събираха разметка, изграждаха хеуристики, обучаваха модели. Така се появиха първите разработки за филтриране на нежелателно съдържание.
С времето в Яндекс започна да се появява UGC (потребителски генерирано съдържание) — съобщения, които самите потребители пишат, а Яндекс само публикува. По изброените по-горе причини, много съобщения не можеха да се публикуват без проверка — необходима беше модерация. Тогава решихме да създадем услуга, която да предоставя защита от спам и злонамерени действия за всички UGC-продукти на Яндекс и да използва разработки за филтриране на нежелателно съдържание в Търсенето. Услугата беше наречена „Чист Веб“.
Нови задачи и помощ от толокери
Първоначално при нас работеше само простата автоматизация: услугите ни изпращаха текстове, а ние ги проверявахме с речници за нецензурен език, речници за порнография и регулярни изрази — аналитиците всичко съставяха ръчно. Но с времето услугата се приложи в все повече продукти на Яндекс, и ние трябваше да се научим да работим с новите проблеми.
Често вместо отзиви потребителите публикуват безсмислен набор от букви, опитвайки се да си увеличат рейтинга, понякога рекламират своята компания в отзиви за конкурентна компания, а понякога просто бъркат организациите и в отзив за зоомагазин пишат: «Прекрасно приготвена риба!». Възможно е, в някакъв момент, изкуственият интелект да научи идеално да улавя смисъла на всеки текст, но в момента автоматизацията понякога се справя по-зле от човека.
Станало ясно, че без ръчно обозначаване тук не може да стане, и ние добавихме втори етап към нашата схема — изпращане за ръчна проверка от човек. Там попадаха публикувани текстове, за които классификаторът не откри проблеми. Размерите на тази задача можете лесно да си представите, затова ние не само разчитахме на оценителите, но и използвахме "мъдростта на тълпата", т.е. обърнахме се за помощ към толоци. Именно те ни помагат да разкрием това, което машината е пропуснала, и по този начин я обучават.
Умно кеширане и LSH хеширане
Още един проблем, с който се сблъскахме при работа с коментари, е спамът, а именно неговите обеми и скорост на разпространение. Когато аудиторията на Яндекс.Района започна бързо да нараства, там се появиха спамери. Те научиха как да заобикалят регулярките, леко променяйки текста. Спамът, разбира се, все пак беше откриван и премахван, но в мащабите на Яндекс дори съобщение, публикувано за 5 минути, можеше да бъде видяно от стотици хора.
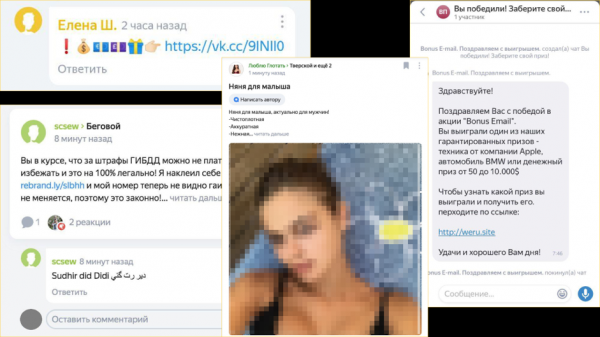
Нас, разбира се, това не ни устройваше, и ние направихме умно кеширане на текстовете на основата на LSH (). Работи по следния начин: нормализирахме текста, премахвахме от него линкове и го разделяхме на n-грамове (последователности от n букви). След това изчислявахме хешовете от n-грамовете, а по тях вече изграждахме LSH вектора на документа. Същността е, че подобни текстове, дори и да са малко променени, се преобразуваха в подобни вектори.
Това решение ни позволи да повторно използваме verdict-ите на классификаторите и толокерите за подобни текстове. При спам атака, веднага щом първото съобщение преминеше проверка и попадаше в кеша с verdict "спам", всички нови подобни съобщения, дори и изменени, получаваха същия verdict и бяха автоматично премахвани. По-късно научихме как да обучаваме и автоматично преобучаваме спам классификаторите, но този "умен кеш" остана с нас и до днес често ни помага.
Классификатор на добри текстове
След като почти успяхме да се справим с борбата срещу спама, осъзнахме, че 95% от съдържанието ни се модерира ръчно: класификационните модели реагират само на нарушения, а повечето текстове са добри. Наложи се да ангажираме презентиращи лица, които в 95 от 100 случая дават оценка „Всичко е наред“. Трябваше да се занимаваме с необичайна работа — да създаваме класификатори за добро съдържание, за щастие, по време на тези усилия натрупахме достатъчно информация.
Първият класификатор изглеждаше така: лематизираме текста (привеждаме думите в основна форма), отстраняваме всички служебни части на речта и прилагаме предварително подготвен „речник на добрите леми“. Ако всички думи в текста са „добри“, значи и самият текст не съдържа нарушения. При различни услуги такъв подход веднага доведе до автоматизация от 25 до 35% на ръчната разметка. Разбира се, този подход не е идеален: лесно е да комбинирате няколко безобидни думи и да получите много обидно изказване, но той ни позволи бързо да достигнем до добро ниво на автоматизация и ни даде време да обучим по-сложни модели.
Следващите версии на класификаторите за добри текстове вече включваха линейни модели, решаващи дървета и техни комбинации. Например, за разметка на грубости и обиди пробваме невронната мрежа BERT. Тук е важно да уловим значението на думата в контекста и връзката между думите в различни изречения, и BERT се справя добре с това. (Между другото, наскоро колегите от Новини , как прилагат технологията за нестандартна задача — търсене на грешки в заглавията.) В крайна сметка успяхме да автоматизираме до 90% от потока в зависимост от услугата.
Точност, пълнота и скорост
За да се развиваме, трябва да разберем каква полза носят различните автоматични класификатори, измененията в тях, както и дали качеството на ръчните проверки не се влошава. За целта прилагаме показатели за точност и пълнота.
Точността е делът на правилните решения сред всички решения за лошо съдържание. Колкото по-висока е точността, толкова по-малко са фалшивите срабатывания. Ако не следим за точността, теоретично можем да премахнем целия спам и нецензурни думи, а заедно с тях - половината от добрите съобщения. От друга страна, ако се опираме само на точността, най-добра ще е технологията, която изобщо не хваща никого. Затова имаме и показателя пълнота: делът на откритото лошо съдържание сред общия обем на лошо съдържание. Тези две метрики се балансират помежду си.
За измерване събираме всички входящи потоци по всеки сервис и предоставяме извадки от съдържанието на оценители за експертна оценка и сравнение с решенията на машината.
Но има и един важен показател.
По-горе писах, че неприемливо съобщение дори за 5 минути могат да видят стотици хора. Затова смятаме колко пъти сме успели да покажем на хората лошо съдържание преди да го скрием. Това е важно, защото не е достатъчно да работим качествено - трябва да работим и бързо. И когато изграждахме защита от нецензурни думи, усетихме това напълно.
Антицензура на примера на котки и кучета
Небольшо лирично отклонение. Някой може да каже, че нецензурните думи и обидите не са толкова опасни, колкото злонамерени линкове, и не са толкова дразнещи, колкото спам. Но ние се стремим да поддържаме комфортни условия за общуване на милиони потребители, а хората не обичат да се връщат на места, където ги обиждат. Не е случайно, че забраната на нецензурни думи и обиди е предписана в правилата на много общности, включително и на Хабра. Но се отклонихме.
Речниците на нецензурните думи не се справят с всичкото богатство на руския език. Въпреки че има само четири основни нецензурни корена, от тях могат да се съставят безброй думи, които не се хващат с никакви регулярни изрази. Освен това може да се пише транслит част от думата, да се заменят букви с подобни съчетания, да се разместват букви, да се добавят звезди и т.н. Понякога без контекст изобщо не може да се определи какво е имал предвид потребителят с нецензурната дума. Ние уважаваме правилата на Хабра, затова ще демонстрираме това не на живи примери, а на котки и кучета.
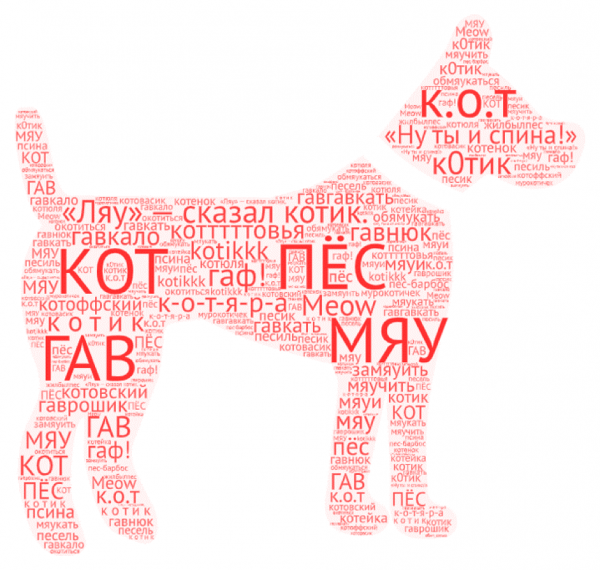
„Мяу“, — каза котето. Но ние разбираме, че котето каза друга дума…
Започнахме да мислим за алгоритмите за "неясно съвпадение" на нашия речник и за по-умно предпроцесиране: довеждахме транслит, свързвахме пробелите и пунктуацията, търсехме шаблони и пишехме отделни регулярни изрази за тях. Такъв подход даваше резултати, но често намаляваше точността, не предоставяйки желаната пълнота.
Тогава решихме да "мислим като нецензурни автъри". Започнахме сами да внасяме шум в данните: разменяхме букви, генерирахме правописни грешки, заменяхме букви с подобни по изглед и така нататък. Началната разметка за това взимахме, като прилагахме речници на нецензурния език на големи корпуси текстове. Ако вземете едно изречение и го изкривите по няколко начина, ще получите много изречения. Така можем да увеличим обучаващия набор десетки пъти. Оставаше само да обучим на полученото множество някаква по-умна модел, която взима предвид контекста.
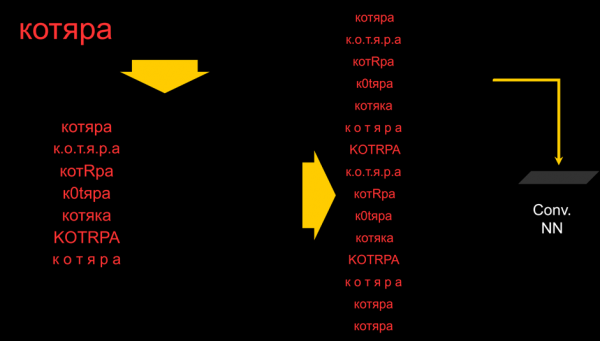
Все още е рано да говорим за окончателно решение. Все още експериментираме с подходите към този проблем, но вече виждаме, че проста символна конволюционна мрежа от няколко слоя съществено превъзхожда речниците и регулярните изрази: успяваме да увеличим както точността, така и пълнотата.
Разбира се, осъзнаваме, че винаги ще се намерят начини да се заобиколи дори най-напредналата автоматизация, особено когато става въпрос за нещо толкова забавно: да се напише така, че глупавата машина да не разбере. Тук, както и при борбата със спама, нашата цел не е да изкореним самата възможност за написване на нещо нецензурно, задачата ни е да направим така, че играта да не си заслужава.
Да се отвори възможността за изразяване на мнение, комуникация и коментиране — не е трудно. Много по-трудно е да се постигнат безопасни, комфортни условия и уважение към хората. А без това няма да има развитие на всяка общност.
Източник: habr.com
