

Знам много Data Scientist-ове — всъщност вероятно сам съм един от тях — които работят на машини с GPU, локални или виртуални, разположени в облака, либо чрез Jupyter Notebook, либо през някаква среда за разработка на Python. Работейки в продължение на 2 години като експерт-разработчик в AI/ML, правех точно така, като подготвях данните на обикновен сървър или работна станция, а обучението стартирах на виртуалка с GPU в Azure.
Разбира се, всички сме чували за — специализирана облачна платформа за машинно обучение. Въпреки това, след първоначалния поглед на , се създава впечатление, че Azure ML ще ви създаде повече проблеми, отколкото да реши. Например, в споменатия по-горе обучителен пример обучението на Azure ML стартира от Jupyter Notebook, като самият обучителен скрипт трябва да се създава и редактира като текстов файл в една от клетките — без да се използва автоматично допълнение, синтактична подсветка и други предимства на нормална среда за разработка. Поради тази причина дълго време не използвахме сериозно Azure ML в нашата работа.
Но наскоро открих начин как да започна да използвам ефективно Azure ML в работата си! Интересно ли е за вас?
Основната тайна е . То ви позволява да разработвате обучителни скриптове директно в VS Code, използвайки всички предимства на средата — освен това можете дори да стартирате скрипта локално, а след това просто да го изпратите за обучение в кластер Azure ML с няколко клика на мишката. Удобно, нали?
При това получавате следните предимства от използването на Azure ML:
- Можете да работите по-голямата част от времето локално на машината си в удобна IDE, а да използвате GPU само за обучаване на модела. Освен това пулът от обучителни ресурси може автоматично да се адаптира към необходимото натоварване, а като зададете минимален брой възли на 0, можете автоматично да стартирате виртуалка "по искане" при наличие на учебни задачи.
- Вие можете да съхранявате всичките резултати от обучението на едно място, включително постигнатите метрики и получените модели — не е нужно сами да измисляте някаква система или порядок за съхранение на всички резултати.
- При това над един проект могат да работят няколко души — те могат да използват един и същ изчислителен клъстер, като всички експерименти ще бъдат подредени в опашка, а също така могат да виждат резултатите от експериментите на другите. Един от тези сценарии е използването на Azure ML в обучението по Дълбоко обучение, когато вместо да предоставяте на всеки студент виртуална машина с GPU, можете да създадете един клъстер, който да се използва централизирано от всички. Освен това обща таблица с резултатите за точността на модела може да служи като добър състезателен елемент.
- С помощта на Azure ML можете лесно да провеждате серии експерименти, например, за оптимизация на хиперпараметри — това може да стане с няколко реда код, без да е необходимо да провеждате серии експерименти ръчно.
Надявам се, че успях да ви убедя да опитате Azure ML! Ето как можете да започнете:
- Уверете се, че имате инсталирано , както и разширенията и
- Клонирайте репото — той съдържа някакъв демонстрационен код за обучение на модели за разпознаване на ръчно писани цифри на датасета MNIST.
- Отворете клонираното хранилище в Visual Studio Code.
- Четете нататък!
Azure ML Workspace и Azure ML Portal
Azure ML е организиран около концепцията за работна област — Workspace. В работната област могат да се съхраняват данни, там се изпращат експериментите за обучение, както и резултатите от обучението — получените метрики и модели. Можете да видите какво се намира в работната област чрез — и оттам можете да извършвате множество операции, начиная от качването на данни и стигайки до мониторинг на експериментите и разгръщането на модели.
Създаването на работна област може да се извърши чрез уеб интерфейса на (вж. ), или чрез използването на командния ред Azure CLI ():
az extension add -n azure-cli-ml
az group create -n myazml -l northeurope
az ml workspace create -w myworkspace -g myazml
С работната област са свързани и някои изчислителни ресурси (Изчисление). Създавайки скрипт за обучение на модел, можете да изпратите експеримента за изпълнение в работната област и да посочите compute target — в този случай скриптът ще бъде опакован, стартиран в необходимата изчислителна среда, а след това всички резултати от експеримента ще бъдат запазени в работната област за последващ анализ и използване.
Обучаващ скрипт за MNIST
Необходимо е да разгледаме класическата задача с употреба на набора данни MNIST. По подобен начин, по-късно ще можете да изпълнявате всякакви свои обучителни скриптове.
В нашето хранилище има скрипт train_local.py, който обучава проста линейна регресионна модел с използване на библиотеката SkLearn. Разбира се, разбирам, че това не е най-добрият начин да решим задачата — използваме го за пример, като най-прост.
Скриптът първо изтегля данните MNIST от OpenML, след което използва класа LogisticRegression за обучение на модела и след това отпечатва получената точност:
mnist = fetch_openml('mnist_784')
mnist['target'] = np.array([int(x) for x in mnist['target']])

shuffle_index = np.random.permutation(len(mnist['data']))
X, y = mnist['data'][shuffle_index], mnist['target'][shuffle_index]

X_train, X_test, y_train, y_test =
  train_test_split(X, y, test_size = 0.3, random_state = 42)

lr = LogisticRegression()
lr.fit(X_train, y_train)
y_hat = lr.predict(X_test)
acc = np.average(np.int32(y_hat == y_test))

print('Overall accuracy:', acc)
Можете да стартирате скрипта на компютъра си и след vài секунди ще получите резултат.
Стартираме скрипта в Azure ML
Ако стартираме скрипта за обучение чрез Azure ML, имаме две основни предимства:
- Стартиране на обучението на произволен изчислителен ресурс, който обикновено е по-мощен от локалния компютър. В същото време Azure ML сам ще се погрижи за това да опакова нашия скрипт с всички файлове от текущата директория в docker-контейнер, да инсталира необходимите зависимости и да го изпрати за изпълнение.
- Записване на резултатите в единен регистър в работната област на Azure ML. За да се възползваме от тази възможност, трябва да добавим няколко реда код в нашия скрипт за записване на получената точност:
from azureml.core.run import Run
...
try:
    run = Run.get_submitted_run()
    run.log('accuracy', acc)
except:
    pass
Съответната версия на скрипта се нарича train_universal.py (той е малко по-сложно устроен от написаното по-горе, но не много). Този скрипт може да се стартира както локално, така и на отдалечен изчислителен ресурс.
За да го стартирате в Azure ML от VS Code, трябва да направите следното:
Уверете се, че Azure Extension е свързан с вашата абонамент. Изберете иконката Azure в лявото меню. Ако не сте свързани, в долния десен ъгъл ще се появи уведомление (), като натиснете върху което ще можете да влезете през браузъра. Може също да натиснете Ctrl-Shift-P за извикване на командния ред на VS Code и да напишете Azure Sign In.
След това, в секцията Azure (иконката наляво) намерете секцията МОДЕЛИРАНЕ НА МАШИНИ:
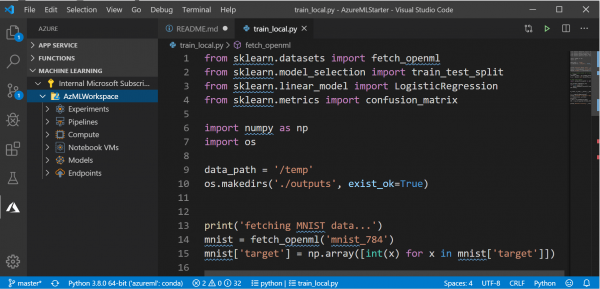
Тук трябва да виждате различни групи обекти в работната област: изчислителни ресурси, експерименти и т.н.
- Отидете до списъка с файлове, щракнете с десния бутон на скрипта
train_universal.pyи изберете Azure ML: Изпълни като експеримент в Azure.
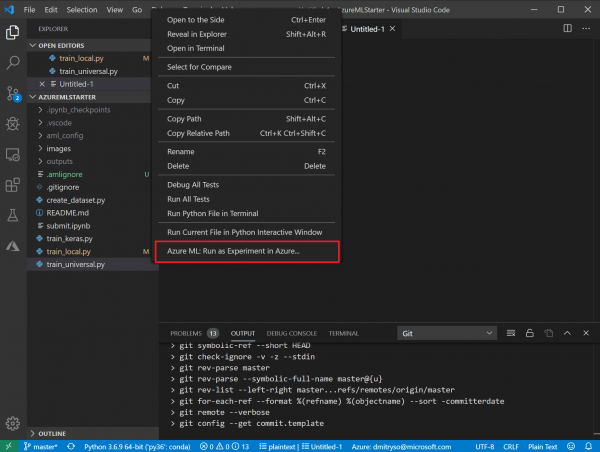
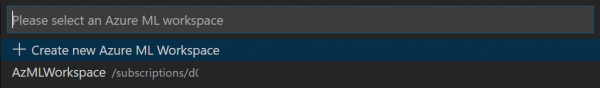
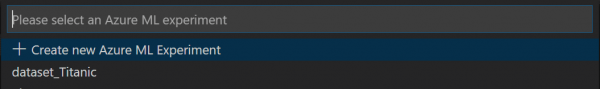
- След това ще последва серия от диалози в областта на командния ред на VS Code: потвърдете използвания абонамент и работна област в Azure ML, както и изберете Създайте нов експеримент:
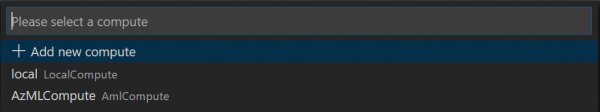
Изберете създаване на нова изчислителна единица Създайте ново изчисление:
- Изчисление определя изчислителния ресурс, на който ще се проведе обучението. Можете да изберете локалния компютър или облачен клъстер AmlCompute. Препоръчвам да създадете мащабируем клъстер от машини
STANDARD_DS3_v2, с минимален брой машини 0 (а максималният може да бъде 1 или повече, в зависимост от вашите нужди). Това може да се направи чрез интерфейса на VS Code или предварително чрез .

- Изчисление определя изчислителния ресурс, на който ще се проведе обучението. Можете да изберете локалния компютър или облачен клъстер AmlCompute. Препоръчвам да създадете мащабируем клъстер от машини
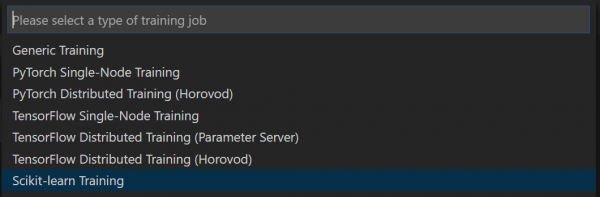
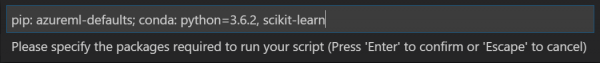
След това е необходимо да изберете конфигурация Конфигурация на изчисляването, която определя параметрите на контейнера, създаден за обучение, по-специално всички необходими библиотеки. В нашия случай, тъй като използваме Scikit Learn, избираме SkLearn, и след това просто потвърдете предложения списък с библиотеки с натискане на Enter. Ако използвате допълнителни библиотеки, те трябва да бъдат посочени тук.


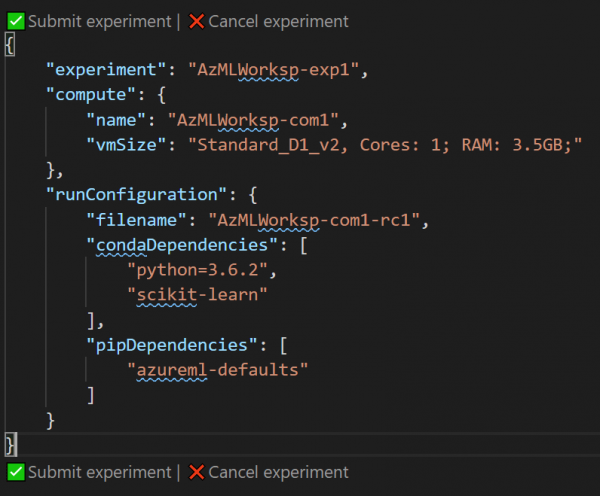
След това ще се отвори прозорец с JSON файл, описващ експеримента. В него можете да коригирате някои параметри — например, името на експеримента. След това натиснете на връзката Изпрати експеримент вътре в този файл:
- След успешно подаване на експеримента чрез VS Code, отдясно в областта за известия ще видите връзка към , където можете да проследявате статуса и резултатите от експеримента.
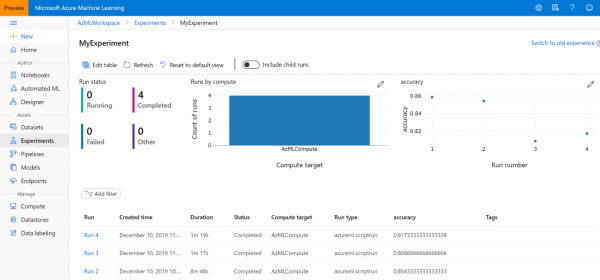
Впоследствие винаги можете да го намерите в раздела Експерименти , или в раздела Azure Machine Learning в списъка с експерименти:
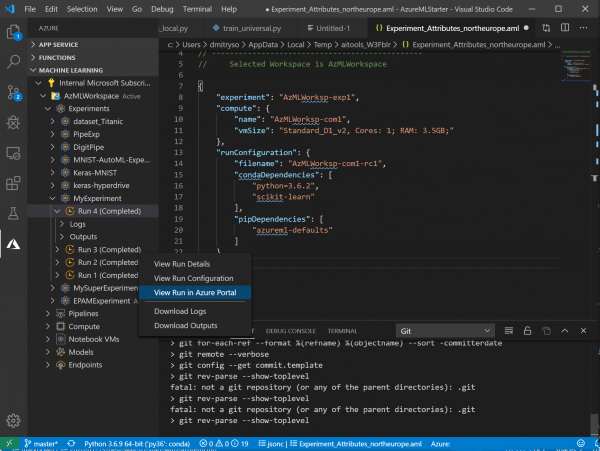
- Ако след това сте направили някакви корекции в кода или сте променили параметрите — повторното стартиране на експеримента ще бъде много по-бързо и лесно. Щраквайки с десния бутон на файла, ще видите нова опция в менюто Повтори последното изпълнение — просто я изберете и експериментът ще стартира веднага:
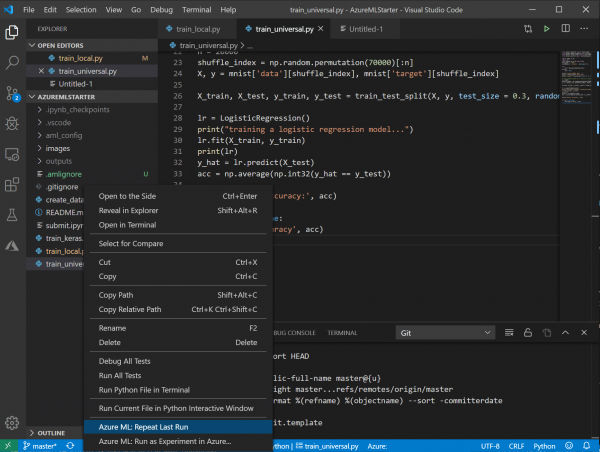
Резултатите от метриките от всички изпълнения винаги можете да намерите на Azure ML Portal, няма нужда да ги записвате.
Сега знаете, че стартирането на експерименти с Azure ML е просто и безболезнено, и получавате редица приятни предимства.
Но вие може би забелязахте и недостатъците. Например, стартирането на скрипта отне значително повече време. Разбира се, за опаковането на скрипта в контейнер и разгръщането му на сървъра е необходимо време. Ако в същото време клъстерът е бил сведен до 0 възела — за стартиране на виртуалната машина ще е нужно още повече време, и всичко това е много забележимо, когато експериментираме с прости задачи като MNIST, които се решават за секунди. Въпреки това, в реалния живот, когато обучението продължава часове, а понякога и дни или седмици, това допълнително време става незначително, особено на фона на значително по-високата производителност, която може да предостави изчислителният клъстер.
Какво следва?
Надявам се, че след прочитането на тази статия вие ще можете и искате да използвате Azure ML в работата си за изпълнение на скриптове, управление на изчислителните ресурси и централизирано съхранение на резултати. Въпреки това Azure ML може да ви предостави още повече предимства!
В рамките на работното пространство можете да съхранявате данни, като по този начин създавате централизирано хранилище за всичките си задачи, до което е лесно да се получи достъп. Освен това можете да стартирате експерименти не от Visual Studio Code, а с помощта на API — това може да бъде особено полезно, ако трябва да извършите оптимизация на хиперпараметри и трябва да стартирате скрипта многократно с различни параметри. Освен това в Azure ML е вградена специална технология , която позволява по-добро търсене и оптимизация на хиперпараметри. За тези възможности ще поговоря в следващата си статия.
Полезни ресурси
За по-подробно изучаване на Azure ML, следните курсове на Microsoft Learn може да ви бъдат полезни:
Източник: habr.com
