

Прим. прев.: Представяме ви техническите подробности за причините за неотдавнашния престой в работата на облачната услуга, обслужвана от създателите на Grafana. Това е класически пример за това как нова и на пръв поглед изключително полезна функция, предназначена да подобри качеството на инфраструктурата… може да навреди, ако не се предвидят многобройни нюанси на нейното приложение в условията на production. Прекрасно е, когато се появяват подобни материали, които позволяват да учим не само от собствените си грешки. Подробности — в превода на този текст от вицепрезидента по продукта в Grafana Labs.
В петък, 19 юли, услугата Hosted Prometheus в Grafana Cloud спря да функционира за около 30 минути. Извинявам се на всички клиенти, които пострадаха от повредата. Нашата задача е да предоставяме необходимите инструменти за мониторинг и разбираме, че тяхната недостъпност усложнява живота ви. Отнасяме се много сериозно към този инцидент. В тази бележка се обяснява какво се случи, как реагирахме и какво правим, за да предотвратим подобно повторение.
Предистория
Услугата Grafana Cloud Hosted Prometheus се основава на — проектът CNCF за създаване на хоризонтално мащабируем, високодостъпен, мулти-тенантен (multi-tenant) сервиз Prometheus. Архитектурата Cortex се състои от набор от отделни микросервизи, всеки от които изпълнява своята функция: репликация, съхранение, заявки и т.н. Cortex активно се разработва, постоянно се добавят нови възможности и се подобрява производителността. Редовно внедряваме нови версии на Cortex в клъстери, за да може клиентите да се възползват от тези възможности — слава богу, Cortex може да се обновява без престои.
За обновления без престои услугата Ingester на Cortex изисква допълнителна реплика на Ingester по време на процеса на обновление. (Прим. прев.: — основният компонент на Cortex. Неговата задача е да събира постоянния поток от проби, да ги групира в chunk'ове на Prometheus и да ги съхранява в база данни като DynamoDB, BigTable или Cassandra. Това позволява на старите Ingester-и да предават текущи данни на новите Ingester-и. Следва да се отбележи, че Ingester-ите са взискателни към ресурсите. За тяхната работа е необходимо да имате по 4 ядра и 15 ГБ памет на pod, т.е. 25% от процесорната мощност и паметта на основната машина за нашите Kubernetes клъстери. Общо взето, ние обикновено имаме много повече неизползвани ресурси в клъстера, отколкото 4 ядра и 15 ГБ памет, затова лесно можем да стартираме тези допълнителни Ingester-и по време на обновления.
Обаче често се случва така, че по време на нормалната работа нито на една от машините няма тези 25% неизползвани ресурси. Да, ние и не се стремим: CPU и памет винаги са необходими за други процеси. За да решим този проблем, решихме да се възползваме от . Идеята е да присвояваме на Ingester-ите по-висок приоритет от този на другите (stateless) микросервизи. Когато е необходимо да стартираме допълнителен (N+1) Ingester, временно изтласкаме другите, по-малки pod-ове. Тези pod-ове се преместват в свободни ресурси на други машини, оставяйки достатъчно голям "отсек" за стартиране на допълнителен Ingester.
В четвъртък, 18 юли, ние разположихме четири нови нива на приоритет в нашите клъстери: критичен, висок, среден и нисък. Те бяха тествани на вътрешен клъстер без клиентски трафик около една седмица. По подразбиране pod-овете без зададен приоритет получаваха среден приоритет, за Ingester-ите беше зададен клас с висок приоритет. Критичен беше резервиран за мониторинг (Prometheus, Alertmanager, node-exporter, kube-state-metrics и т.н.). Нашата конфигурация е отворена и можете да видите PR .
Авария
В петък, 19 юли, един от инженерите стартира нов посветен клuster Cortex за голям клиент. Конфигурацията за този клъстер не включваше новите приоритети на pod-овете, затова на всички нови pod-ове беше зададен приоритет по подразбиране — среден.
В Kubernetes клъстера нямаше достатъчно ресурси за новия клъстер Cortex, а съществуващият продукционен клъстер Cortex не беше обновен (Ingester-ите останаха без висок приоритет). Тъй като Ingester-ите на новия клъстер по подразбиране имат среден приоритет, а съществуващите в продукция pod-ове работят изцяло без приоритет, Ingester-ите на новия клъстер изтласкаха Ingester-а от съществуващия продукционен клъстер Cortex.
ReplicaSet за изгонен Ingester в production-кластера откри нов изгонен pod и създаде нов, за да поддържа зададеното количество копия. Новият pod по подразбиране получи среден приоритет, и следващият "стар" Ingester в production загуби ресурси. Резултатът беше лавинообразен процес, който доведе до изгонване на всички pod’ове с Ingester за production-кластерите на Cortex.
Ingester’ите запазват състоянието (stateful) и съхраняват данни за предишните 12 часа. Това ни позволява по-ефективно да ги компресираме преди запис в дългосрочно хранилище. За това Cortex извършва шардирене на данните по серии, използвайки разпределена хеш-таблица (Distributed Hash Table, DHT), и репликира всяка серия на три Ingester’а с помощта на кворумна съгласуваност по стил Dynamo. Cortex не записва данни в Ingester’и, които са изключени. Така, когато голям брой Ingester’и напуснат DHT, Cortex не може да осигури достатъчна репликация на записите и те „падат“.
Откритие и отстраняване
Новите известия на Prometheus на базата на "бюджет на грешките" (error-budget-based — подробности ще бъдат предоставени в бъдеща статия) започнаха да сигнализират след 4 минути от началото на изключването. В течение на следващите около пет минути извършихме диагностика и увеличихме основния кластер Kubernetes, за да разположим както новите, така и съществуващите production-кластери.
Още пет минути по-късно старите Ingester’и успешно записаха данните си, а новите се стартираха, и кластерите Cortex отново станаха достъпни.
Още 10 минути отнеха за диагностика и отстраняване на грешки с out-of-memory (OOM) от обратни прокси-сървъри за автентикация, разположени пред Cortex. OOM грешките бяха предизвикани от десеткратно увеличение на QPS (както предполагаме, поради прекалено агресивни заявки от сървърите на клиента Prometheus).
Последствия
Общата продължителност на прекъсването беше 26 минути. Данните не бяха изгубени. Ingester’ите успешно заредиха всички in-memory данни в дългосрочно хранилище. По време на изключването Prometheus-сървърите на клиентите буферираха отдалечените (remote) записи чрез на базата на WAL (изобретението на от Grafana Labs) и повториха неуспешните записи след повредата.
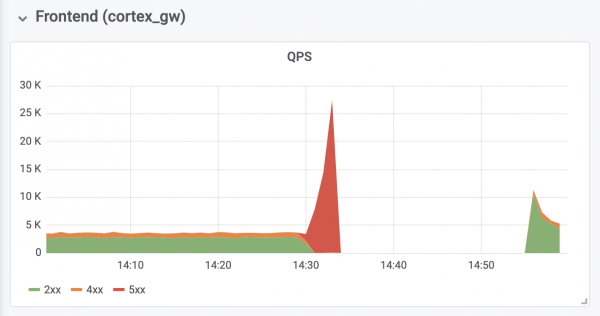
Операциите по запис на production-кластера
Изводи
Важно е да извлечем поуки от този инцидент и да предприемем необходимите стъпки, за да избегнем повторението му.
Огледайки се назад, трябва да признаем, че не трябваше да задаваме по подразбиране среден приоритет, докато всички Ingester-и в производствената среда не получиха висок приоритет. Освен това, трябваше предварително да се погрижим за техния висок приоритет. Сега всичко е поправено. Надяваме се, че нашият опит ще помогне на други организации, които обмислят използването на приоритети на pod-ове в Kubernetes.
Ще добавим допълнителен контролен слой за разгръщането на всякакви допълнителни обекти, чиято конфигурация е глобална за клъстера. Оттук нататък подобни промени ще бъдат оценявани отпо-по-голямо количество хора. Освен това, модификацията, която доведе до провала, се считаше за твърде незначителна за отделен проектен документ – тя беше обсъждана само в GitHub issue. От този момент нататък всички подобни промени в конфигурации ще бъдат съпътствани от съответната проектна документация.
Накрая, ще автоматизираме промените в размерите на обратния прокси сървър за удостоверяване, за да предотвратим OOM при натоварване, свидетели на което станахме, и ще анализираме настройките по подразбиране на Prometheus, свързани с откат и мащабиране, за да предупреждаваме в бъдеще за подобни проблеми.
Преживеният провал имаше и някои позитивни последици: получавайки необходимите ресурси, Cortex автоматично се възстанови без допълнителна намеса. Получихме и ценен опит в работата с – нашата нова система за агрегация на лога, – която помогна да се уверим, че всички Ingester-и са се държали адекватно по време и след провала.
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «»;
- «».
Източник: habr.com
