

В тази статия е описана реализацията на конвейерите в ядрото на Unix. Бях малко разочарован, че неотдавнашна статия с название „“ се оказа не за вътрешната структура. Интересувах се и се задълбах в стари източници, за да намеря отговор.
За какво става въпрос?
Конвейерите — „вероятно най-важното изобретение в Unix“ — са определяща характеристика на философията на Unix, която обединява малки програми, а също така познатият запис в командния ред:
$ echo hello | wc -c
6
Тази функционалност зависи от системния повик, предоставен от ядрото pipe, който е описан в документацията и :
Конвейерите осигуряват еднопосочен канал за междупроцесорно взаимодействие. Конвейерът има вход (write end) и изход (read end). Данните, записани в входа на конвейера, могат да бъдат прочетени на изхода.
Конвейерът се създава с помощта на повикване
pipe(2), което връща два файлови дескриптора: един, който сочи към входа на конвейера, и втори към изхода.
Резултатите от проследяването на горната команда демонстрират създаването на конвейера и потока от данни през него от един процес до друг:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Родителският процес извиква pipe(), за да получи свързани файлови дескриптори. Един от дочерните процеси записва в един дескриптор, а другият процес чете същите данни от друг дескриптор. Оболочката с помощта на dup2 „преименува“ дескрипторите 3 и 4, така че да отговарят на stdin и stdout.
Без конвейерите, оболочката щеше да трябва да записва резултата от един процес в файл и да го предава на друг процес, за да прочете данните от файла. В резултат на това щяхме да загубим повече ресурси и дисково пространство. Въпреки това, конвейерите са полезни не само защото избягват използването на временни файлове:
Ако процесът се опита да прочете от празен конвейер, тогава
read(2)ще блокира, докато данните не станат налични. Ако процесът се опита да запише в запълнен конвейер, тогаваwrite(2)ще блокира до момента, в който от конвейера бъдат прочетени достатъчно данни за изпълнение на записа.
Както изисква POSIX, това е важно свойство: запис в конвейера до PIPE_BUF байта (поне 512) трябва да бъде атомарен, за да могат процесите да взаимодействат помежду си чрез конвейера, по начина, по който обикновените файлове (които не предоставят такива гаранции) не могат.
Когато се използва обикновен файл, процесът може да запише всичките си изходни данни и да ги предаде на друг процес. Или процесите могат да действат в режим на строго паралелизиране, съобщавайки си помежду чрез външен сигнален механизъм (като семафор) за завършване на записа или четенето. Конвейерите ни избавят от всички тези главоболия.
Какво търсим?
Ще обясня на пръстите, за да ви е по-лесно да си представите как може да работи конвейерът. Ще ви е необходимо да отделите буфер в паметта и някакво състояние. Ще са необходими функции за добавяне и премахване на данни от буфера. Ще е нужно средство, за да се извикват функциите по време на операции по четене и запис в файловите дескриптори. И ще са необходими заключвания, за да реализираме описаното по-горе специално поведение.
Сега сме готови да приветстваме източния код на ядрото при ярка светлина, за да потвърдим или опровергаем нашата смутна умствена модел. Но винаги бъдете готови за изненади.
Къде търсим?
Не знам къде се намира моя екземпляр на известната книга "" с изходния код на Unix 6, но благодарение на можете да потърсите онлайн в на още по-стари версии на Unix.
Разглеждането на архивите на TUHS е като посещение на музей. Можем да се погледнем зад нашата обща история, и изпитвам уважение към многогодишните усилия за възстановяване на всичките тези материали бит по бит от стари касети и отпечатъци. И остро осъзнавам онези фрагменти, които все още липсват.
Удовлетворявайки любопитството си относно древната история на конвейерите, за сравнение, можем да погледнем и съвременни ядра.
Между другото, pipe е системен повик номер 42 в таблицата sysent[]. Съвпадение?
Традиционни ядра на Unix (1970–1974)
Не намерих никакви следи pipe(2) нито в (януари 1970 г.), нито в (ноември 1971 г.), нито в непълния изходен код (юни 1972 г.).
TUHS твърди, че (февруари 1973) стана първата версия с конвейери:
Третото издание на Unix беше последната версия с ядро, написано на асемблер, но същевременно първата версия с конвейери. През 1973 година се работеше по подобряване на третото издание, ядрото беше презаписано на C, и така се появи четвъртото издание на Unix.
Един от читателите намери скан на документ, в който Даг МакИлрой предложи идеята за „свързване на програми по принципа на градинския маркуч“.
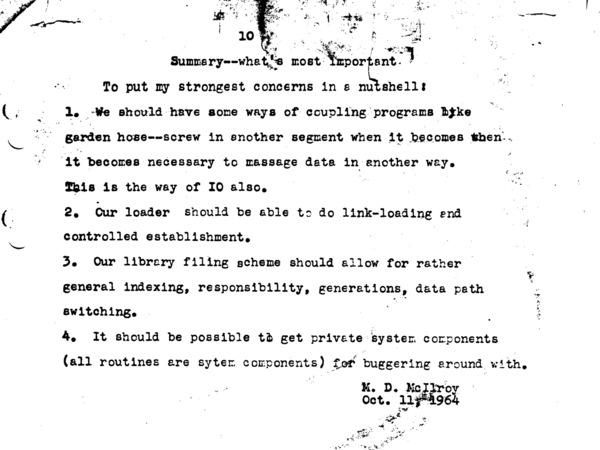
В книгата на Брайън Керниган „“, в историята на появата на конвейерите също се споменава този документ: „… той висеше на стената в моя офис в Bell Labs в продължение на 30 години“. Ето , и още една история от :
Когато се появи Unix, моето увлечение с корутините ме накара да помоля автора на ОС, Кен Тъмпсън, да позволи данните, записани в определен процес, да текат не само към устройството, но и към изхода на друг процес. Кен реши, че това е възможно. Въпреки това, като минималист, той искаше всяка системна функция да играе значителна роля. Има ли наистина голямо предимство в директното записване между процесите в сравнение с записването в междинен файл? И едва когато внесох конкретно предложение с привлекателното заглавие „конвейер“ и описание на синтаксиса за взаимодействие на процесите, Кен най-накрая извика: „Ще го направя!“.
И го направи. В един съдбоносен вечер Кен промени ядреното и обвивката, поправи няколко стандартни програми, стандартизирайки тяхната процедура за приемане на входни данни (които могат да идват от конвейера), както и смени имената на файловете. На следващия ден конвейерите започнаха да се използват широко в приложенията. До края на седмицата секретарите изпращаха на принтера документи от текстовите редактори с тяхна помощ. Няколко по-късно Кен замени оригиналния API и синтаксиса за употреба на конвейерите с по-чисти споразумения, които се прилагат и до днес.
За съжаление, изходният код на ядрата на третото издание на Unix е загубен. И въпреки че разполагаме с написания на C изходен код на ядрото на , излязло през ноември 1973 г., обаче то е излязло няколко месеца преди официалния релиз и не съдържа реализация на конвейерите. Жалко е, че изходният код на легендарната функция на Unix е загубен, вероятно завинаги.
Имаме текст на документацията за pipe(2) от двете версии, така че можем да започнем с търсене в документацията (по определени думи, подчертаващи "ръчно", низ от литерали ^H, след което следва долно подчертаване!). Този прототипpipe(2) е написан на асемблер и връща само един файлов дескриптор, но вече предоставя очакваната основна функционалност:
Системен повик pipe създава механизъм за вход и изход, който се нарича конвейер. Върнатият файлов дескриптор може да се използва за операции по четене и писане. Когато във конвейера се записва нещо, се буферират до 504 байта данни, след което процесът на запис се спира. При четене от конвейера, буферираните данни се взимат.
До следващата година ядрото беше презаписано на C, а придоби съвременния си вид с прототипа "pipe(fildes)»:
Системен повик pipe създава механизъм за вход и изход, който се нарича конвейер. Върнатите файлови дескриптори могат да се използват в операции по четене и писане. Когато нещо се записва в конвейера, се използва дескрипторът, върнат в r1 (съответно fildes[1]), и се буферират до 4096 байта данни, след което процесът на запис се спира. При четене от конвейера, дескрипторът, върнат в r0 (съответно fildes[0]), взима данни.
Предполага се, че след определяне на конвейера два (или повече) взаимодействуващи процеса (създадени с последващи повиквания fork) ще предават данни от конвейера чрез повиквания read и write.
В шел-а съществува синтаксис за определяне на линейна маса от процеси, свързани чрез конвейер.
Повикванията за четене от празен конвейер (не съдържащ буферирани данни), който има само един край (всички записващи файлови дескриптори са затворени), връщат "край на файла". Повикванията за запис в подобна ситуация се игнорират.
Най-старото се отнася (юни 1974 г.), но е почти идентично на това, което се появи в следващото издание. Единствено са добавени коментари, така че петото издание може да бъде пропуснато.
Шестото издание на Unix (1975)
Започваме да четем изходния код на Unix (май 1975 г.). По много отношение благодарение на Лионс е много по-лесно да се намери, отколкото изходния код на по-ранни версии:
Много години книгата Лионс беше единственият документ за ядрото на Unix, достъпен извън стените на Bell Labs. Въпреки че лиценза на шестото издание позволяваше на преподавателите да използват нейния изходен код, лиценза на седмото издание изключи тази възможност, така че книгата се разпространяваше под формата на нелегални машинописни копия.
Днес можете да купите репринт на книгата, на чийто корицата са изобразени студенти до копирен апарат. А благодарение на Уорън Туми (който стартира проекта TUHS) можете да изтеглите . Искам да ви покажа колко труд бе вложен в създаването на файла:
Повече от 15 години назад написах копие на изходния код, представен в Лионс, защото не ми харесваше качеството на моето копие от неизвестен брой други копия. TUHS още не съществуваше и нямах достъп до стари изходни кодове. Но през 1988 г. намерих стара лента с 9 канала, на която имаше резервно копие от компютър PDP11. Трудно беше да се разбере дали работи, но там имаше непокътнато дърво /usr/src/, в което повечето файлове бяха обозначени с 1979 г., което вече изглеждаше като антиквария. Това беше седмото издание или производно PWB, поне така смятах.
Взех находката за основа и ръчно редактирах изходните кодове до състояние на шестото издание. Част от кода остана същата, част трябваше да се коригира леко, заменяйки модерния токен += с остарял =+. Нещо просто изтрих, а нещо трябваше да пренаписвам напълно, но не твърде много.
И днес можем онлайн да четем на TUHS изходния код на шестото издание от .
Между другото, на пръв поглед, основната характеристика на C кода преди периода на Керниган и Ричи е неговата краткост. Не така често успявам да вмъкна фрагменти от код без обширно редактиране, за да съответстват на относително тясното пространство на сайта ми.
В началото има пояснителен коментар (и да, там има още ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Размерът на буфера не се е променял от времето на четвъртото издание. Но тук виждаме без никаква публична документация, че някога конвейерите са използвали файловете като резервно хранилище!
Що се отнася до LARG файловете, те съответстват на , който се използва от „алгоритъма на голямо адресиране“ за обработка с цел да се поддържат по-големи файлови системи. След като Кен каза, че е по-добре да не ги използваме, с радост му вярвам.
Ето истински системен повик pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
В коментара ясно е описано какво се случва тук. Но разбирането на кода не е толкова просто, отчасти заради начина, по който се предават параметрите на системните повиквания и връщаните стойности чрез „и регистрите R0 и R1 .
Нека опитаме чрез да разположим на диска , а чрез да разположим в паметта два . Ако всичко мине добре, задаваме флаговете, за да определим тези файлове като двата края на конвейера, посочваме ги в същия inode (чийто брояч на референции ще стане 2) и маркираме inode-а като променен и използван. Обърнете внимание на достъпите до в грешните пътеки (error paths) за намаляване на брояча на референциите на новия inode.
pipe() трябва да връща номера на файловите дескриптори за четене и запис. R0 и R1 върта указател на файловата структура, но също така „върта“ през falloc() u.u_ar0[R0] и файловия дескриптор. Тоест, кодът запазва в файловия дескриптор за четене и присвоява дескриптора за запис директно от r след второто извикване и файловия дескриптор. Тоест, кодът запазва в Флагът falloc().
FPIPE , който зададохме при създаването на конвейера, контролира поведението на функциятаrdwr() в sys2.c След това функцията
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
readp() pipe.c в чете данни от конвейера. Но е по-добре да проследите реализацията, започвайки от writep(). Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат.writep(fp) { register *rp, *ip, c;rp = fp; ip = rp->f_inode; c = u.u_count;loop: /* Ако всичко е свършено, върни. */plock(ip); if(c == 0) { prele(ip); u.u_count = 0; return; }/* * Ако не са активни и двете страни на четене и запис на * конвейера, върни грешка и сигнализирай също. */if(ip->i_count i_size1 == PIPSIZ) { ip->i_mode =| IWRITE; prele(ip); sleep(ip+1, PPIPE); goto loop; }/* Напиши каквото е възможно и се върни в цикъла. */u.u_offset[0] = 0; u.u_offset[1] = ip->i_size1; u.u_count = min(c, PIPSIZ-u.u_offset[1]); c =- u.u_count; writei(ip); prele(ip); if(ip->i_mode&IREAD) { ip->i_mode =& ~IREAD; wakeup(ip+2); } goto loop; }
На входа на конвейера искаме да запишем байтове
u.u_count u.u_count. Първо, трябва да блокираме индексния дескриптор (вж. по-долу plock/prele).
След това проверяваме броя на ссылките inode. Докато и двата края на тръбата остават отворени, броят трябва да е равен на 2. Държим една ссылка (от rp->f_inode), така че ако броят е по-малък от 2, това трябва да означава, че четящият процес е затворил своя край на тръбата. С други думи, опитваме се да пишем в затворена тръба, което е грешка. Кодът на грешката EPIPE и сигналът SIGPIPE появиха се в шестата версия на Unix.
Но дори и ако тръбата е отворена, тя може да бъде запълнена. В такъв случай сваляме блокировката и отиваме да спим с надеждата, че друг процес ще прочете от тръбата и ще освободи достатъчно място в нея. Събуждайки се, се връщаме обратно, отново слагаме блокировката и започваме нов цикъл на запис.
Ако в тръбата има достатъчно свободно място, записваме данни в нея с помощта на . Параметърът i_size1 на inode (при празна тръба може да е равен на 0) указва края на данните, които вече се съдържат в нея. Ако има достатъчно място за запис, можем да запълним тръбата от i_size1 до PIPESIZ. След това сваляме блокировката и се опитваме да събудим всеки процес, който очаква възможност да прочете от тръбата. Връщаме се обратно, за да видим дали сме записали толкова байтове, колкото ни бяха нужни. Ако не успеем, започваме нов цикъл на запис.
Обикновено параметърът i_mode на inode се използва за съхраняване на разрешенията r, w и x. Но в случая на тръби сигнализираме за изчакване от записващ или четящ процес с помощта на битовете IREAD и IWRITE съответно. Процесът задава флаг и извиква sleep(), и се очаква, че в бъдеще някой друг процес ще извика wakeup().
Истинското чудо се случва в sleep() и wakeup(). Те са реализирани в , източникът на известния коментар «Не се очаква да разбирате това». За щастие, не е необходимо да разбираме кода, просто нека погледнем някои коментари:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Процесът, който извиква sleep() за определен канал, може по-късно да бъде събуден от друг процес, който извиква wakeup() за същия канал. Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат. и pipe.c Координират действията си с помощта на такива двойни извиквания. Обърнете внимание, че чете данни от конвейера. Но е по-добре да проследите реализацията, започвайки от винаги дава приоритет на PPIPE при извикване sleep(), така че всички sleep() могат да бъдат прекъснати от сигнал.
Сега имаме всичко, за да разберем функцията pipe.c:
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Много консервативно заключване. */

    plock(ip);

    /*
     * Ако главата (четене) е достигнала
     * опашката (писане), нулираме и двете на 0.
     */

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Ако и читателят, и
         * писателят не са активни, връщаме без
         * да задоволим четенето.
         */

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Четем и връщаме */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Може да ви бъде по-лесно да прочетете тази функция отдолу нагоре. Клонът „четене и връщане“ обикновено се използва, когато в конвейера има данни. В този случай, използваме за да прочетем толкова данни, колкото са налични, започвайки от текущото f_offset за четене и след това актуализираме стойността на съответното отклонение.
При следващото четене конвейерът ще бъде празен, ако стойността на четенето е достигнала стойността i_size1 на inode-a. Ние нулираме позицията на 0 и се опитваме да събудим всякакъв процес, който иска да запише в конвейера. Знаем, че когато конвейерът е пълен, Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат. той ще заспи на ip+1. А сега, когато конвейерът е празен, можем да го събудим, за да възобнови цикъла си на запис.
Ако няма какво да се чете, pipe.c може да зададе флаг IREAD и да заспи на ip+2. Знаем, че него ще събуди Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат., когато запише данни в конвейера.
Коментарите към ще помогнат да разберете, че вместо да предаваме параметри през „u“, можем да се отнасяме с тях като с обикновени функции за вход-вывод, които взимат файл, позиция, буфер в паметта и броят на байтовете за четене или запис.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
Що се отнася до „консервативното“ заключване, pipe.c и Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат. заключват inode, докато не приключат работа или не получат резултат (т.е. не извикат wakeup). plock() и prele() работят просто: с помощта на друг набор от извиквания sleep и wakeup ни позволяват да събудим всякакъв процес, който се нуждае от заключване, което току-що освободихме:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
Първоначално не можех да разбера защо pipe.c не извиква prele(ip) преди да извика wakeup(ip+1). Първото нещо,което Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат. извиква в цикъла си, е plock(ip),което води до взаимоблокиране, ако pipe.c все още не е освободил заключването си, затова кодът по някакъв начин трябва да работи правилно. Ако погледнете на wakeup(), става ясно, че той просто отбелязва заспалия процес като готов за изпълнение, за да може в бъдеще sched() наистина да го стартира. Така че pipe.c извиква wakeup(), сваля блокировката, задава IREAD и извиква sleep(ip+2)— всичко това преди Повтарям, кодът стана по-сложен поради особеностите на споразумението за предаване на аргументи, но някои детайли може да се пропуснат. да възобнови цикъла.
С това описанието на конвейерите в шестата редакция приключва. Просто код, с далечни последици.
(януари 1979 г.) беше нов основен релиз (след четири години), в който се появиха много нови приложения и характеристики на ядрото. Имаше също така значителни промени, свързани с използването на приводящи типове, union-и и типизирани указатели към структури. Въпреки това практически не се промени. Можем да пропуснем тази редакция.
Xv6, просто Unix-подобно ядро
На създаването на ядрото влияе шестата редакция на Unix, но е написано на съвременен C, за да може да се стартира на x86 процесори. Кодът е лесен за четене и разбираем. Освен това, за разлика от изходниците на Unix от TUHS, можете да го компилирате, модифицирате и стартирате на нещо друго, освен PDP 11/70. Затова това ядро се използва широко в университети като учебен материал по операционни системи. Изходниците .
Кодът съдържа разбираема и продумана реализация , подкрепена от буфер в паметта вместо inode на диска. Тук давам само определението за "структурен конвейер" и функцията pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() задава състоянието на останалата част от реализацията, която включва функциите piperead(), pipewrite() и pipeclose(). Фактическият системен повик sys_pipe е обвивка, реализирана в . Препоръчвам да прочетете целия му код. Сложността е на ниво изходен код от шестата редакция, но е много по-лесен и приятен за четене.
Linux 0.01
Можете да намерите изходния код на Linux 0.01. Бъде интересно да се изучи реализацията на конвейерите в него fs/чете данни от конвейера. Но е по-добре да проследите реализацията, започвайки от. Тук за представянето на конвейера се използва inode, но самият конвейер е написан на съвременен C. Ако сте преминали през кода на шестата редакция, тук няма да имате затруднения. Това е функцията write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* няма читатели */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE(PIPE_HEAD(*inode));
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Дори без да се разглеждат определения на структурите, може да се разбере как счетчика на линкове inode се използва за проверка дали операцията за запис води до SIGPIPE. Освен байтовата работа, тази функция лесно може да бъде свързана с описаните по-горе идеи. Дори логиката sleep_on/wake_up не изглежда толкова чужда.
Съвременните ядра на Linux, FreeBSD, NetBSD, OpenBSD
Бързо прегледах някои от съвременните ядра. Нито едно от тях вече не включва реализация с дискове (не е изненадващо). В Linux има собствена реализация. И докато трите съвременни BSD ядра съдържат реализации, базирани на код, написан от Джон Дайсън, през годините те се различават твърде много помежду си.
За да се чете fs/чете данни от конвейера. Но е по-добре да проследите реализацията, започвайки от (на Linux) или sys/kern/sys_pipe.c (на *BSD), изисква истинска самоотдаденост. Днес в кода важни са производителността и поддръжката на функции като векторни и асинхронни операции за вход/изход. И подробностите за управление на паметта, блокировки и конфигурация на ядрото – всичко това варира значително. Това не е нещо, което университетите предлагат в основните курсове по операционни системи.
Във всеки случай, беше ми интересно да разкопая някои стари модели (като генериране SIGPIPE и връщане EPIPE при запис в затворен конвейер) във всички тези, толкова различни, съвременни ядра. Вероятно никога няма да видя на живо компютъра PDP-11, но все още има какво да се научи от кода, написан години преди моето раждане.
Статията на Диви Капур от 2011 г. "" представлява преглед на това как работят (все още) конвейерите в Linux. А илюстрира модела на взаимодействие с конвейери, чиито възможности надвишават възможностите на временните файлове; а също така показва колко далеч са се отдалечили конвейерите от "много консервативното блокиране" в ядрото на Unix шесто издание.
Източник: habr.com
