

Прим. прев.: Тази статия е резултат от мини-изследване, проведено от инженерите на IBM Cloud в търсене на решение на реален проблем, свързан със експлоатацията на база данни etcd. За нас беше актуална подобна задача, но мислите и действията на авторите могат да бъдат интересни и в по-широк контекст.
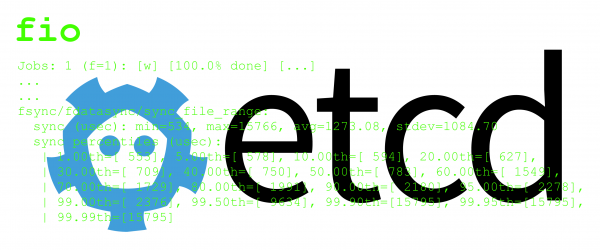
Кратко резюме на цялата статия: fio и etcd
Производителността на кластера etcd зависи значително от скоростта на основното хранилище. За мониторинг на производителността etcd експортира различни метрики на Prometheus. Една от тях е wal_fsync_duration_seconds. В документацията на etcd , основното хранилище може да се счита за достатъчно бързо, ако 99-иятPercentile на тази метрика не надвишава 10 ms...
Ако обмисляте възможността да организирате кластер etcd на машини с Linux и искате да проверите дали хранилището (например SSD) е достатъчно бързо, препоръчваме да използвате популярния тестер за I/O с името . Достатъчно е да стартирате следната команда (директорията test-data трябва да бъде разположена в монтирания дял на тестваното хранилище):
fio --rw=write --ioengine=sync --fdatasync=1 --directory=test-data --size=22m --bs=2300 --name=mytestОстава само да погледнете изхода и да проверите дали 99-ият Percentile е в 10 ms. Ако е така, значи вашето хранилище работи достатъчно бързо. Ето пример за изход:
fsync/fdatasync/sync_file_range:
  sync (usec): min=534, max=15766, avg=1273.08, stdev=1084.70
  sync percentiles (usec):
   | 1.00th=[ 553], 5.00th=[ 578], 10.00th=[ 594], 20.00th=[ 627],
   | 30.00th=[ 709], 40.00th=[ 750], 50.00th=[ 783], 60.00th=[ 1549],
   | 70.00th=[ 1729], 80.00th=[ 1991], 90.00th=[ 2180], 95.00th=[ 2278],
   | 99.00th=[ 2376], 99.50th=[ 9634], 99.90th=[15795], 99.95th=[15795],
   | 99.99th=[15795]
Някои забележки:
- В дадения по-горе пример адаптирахме параметрите
--sizeи--bsкъм конкретния случай. За да получите значим резултат отfio, задавайте стойности, подходящи за вашия сценарий на употреба. За това как да ги изберете ще стане въпрос по-долу. - По време на теста само
fioнатоварва дисковата подсистема. В реалния живот е доста вероятно, че на диска ще записват и други процеси (освен тези, свързани сwal_fsync_duration_seconds). Подобно допълнително натоварване може да доведе до увеличаване наwal_fsync_duration_seconds. С други думи, ако 99-ият Percentile, получен от теста сfio, е само леко под 10 ms, е много вероятно производителността на хранилището да не е достатъчна. - За теста ще ви трябва версия
fioне по-ниска от 3.5, тъй като по-старите версии не агрегират резултатитеfdatasyncв проценти. - По-горе представеното изходно съдържание представлява само малка част от общия изход.
fio.
Подробно за fio и etcd
Няколко думи за WAL-овете на etcd
Обикновено базите данни използват (write-ahead logging, WAL). Това важи и за etcd. Обсъждането на WAL излиза извън обхвата на тази статия, но за нашите цели е важно да знаем следното: всеки член на кластера на etcd съхранява WAL в постоянно хранилище. etcd записва някои операции с хранилище на ключове и стойности (например, актуализации) в WAL, преди да ги изпълни. Ако възелът падне и се рестартира между snapshot-ите, etcd може да възстанови транзакции, проведени от последния snapshot, на базата на съдържанието на WAL.
Следователно всеки път, когато клиент добавя ключ в хранилището KV или актуализира стойността на съществуващ ключ, etcd добавя описание на операцията в WAL, който представлява обикновен файл в постоянно хранилище. Преди да продължи работата си, etcd ТРЯБВА да е 100% уверена, че записът в WAL наистина е запазен. За да се постигне това в Linux, не е достатъчно да се използва системен повик , тъй като самята операция по запис на физически носител може да бъде отложена. Например, Linux за известно време може да държи WAL-записа в кеша на ядрото в паметта (например, в кеша на страниците). За да се гарантира, че данните са записани на носителя, след записа трябва да се задейства системно повикване fdatasync — именно така постъпва etcd (както е видно от следващия изход ; тук 8 — дескриптор на файла WAL):
21:23:09.894875 lseek(8, 0, SEEK_CUR)   = 12808
21:23:09.894911 write(8, ".      20210220361223255266632$10 20103026"34"rn3fo"..., 2296) = 2296
21:23:09.895041 fdatasync(8)            = 0
За съжаление, записът на постоянното хранилище отнема известно време. Забавеното изпълнение на повикването fdatasync може да повлияе на производителността на etcd. В документацията на хранилището , че за достатъчна производителност е необходимо 99-ият процентил на продължителността на всички повиквания fdatasync при запис в файл WAL да бъде под 10 мс. Има и други метрики, свързани с хранилището, но в тази статия ще се говори именно за тях.
Оценяваме хранилището с помощта на fio
Може да се оцени дали дадено хранилище е подходящо за използване с etcd, чрез утилитата — популярният тестер I/O. Имайте предвид, че дисковият вход-изход може да се извършва по различни начини: синхронно/асинхронно, множество различни класове системни повиквания и т.н. Обратната страна на монетата е, че fio е изключително сложен за използване. Утилитата има множество параметри и различни комбинации от техните стойности водят до съвсем различни резултати. За да получите разумна оценка в случая с etcd, трябва да се уверите, че натоварването на запис, генерирано от fio, максимално прилича на натоварването, което etcd записва в WAL файловете:
- Това означава, че генерираното
fioнатоварване, най-малкото, трябва да представлява поредица от последователни записи в файл, където всяка операция по запис се състои от системно повикване , следвано отfdatasync. - За да включите последователния запис, трябва да зададете флага
--rw=write. - За да
fioкоято пише, използвайки повикванияwrite(а не други системни повиквания — например, ), използвайте флага--ioengine=sync. - Накрая, флагът
--fdatasync=1гарантира, че след всякоwriteследваfdatasync. - Два други параметъра в нашия пример:
--sizeи--bs— могат да варират в зависимост от конкретния сценарий на използване. В следващия раздел ще бъде описана тяхната настройка.
Защо избрахме fio и откъде научихме как да го конфигурираме
Тази бележка произхожда от реален случай, с който се сблъскахме. Имахме клъстер на Kubernetes v1.13 с мониторинг на Prometheus. Като хранилище за etcd v3.2.24 използвахме твърдотелни дискове. Метриките на etcd показваха прекалено високи закъснения fdatasync, дори когато клъстерът беше в покой. Тези метрики ни се струваха доста съмнителни и не бяхме сигурни какво точно представляват. Освен това, клъстерът се състоеше от виртуални машини, така че не можехме да кажем дали закъснението е свързано с виртуализацията или всичко беше заради SSD.
Освен това разглеждахме различни промени в конфигурацията на хардуера и софтуера, така че беше необходим начин за тяхната оценка. Разбира се, можеше да стартираме etcd в всяка конфигурация и да погледнем съответните метрики на Prometheus, но това би изисквало значителни усилия. Нуждаехме се от прост начин, позволяващ оценка на конкретна конфигурация. Искахме да проверим разбирането си за метриките на Prometheus, идващи от etcd.
За целта беше необходимо да решим два проблема:
- Първо, как изглежда I/O натоварването, генерирано от etcd при писане в WAL файлове? Какви системни повиквания се използват? Какъв е размерът на записните блокове?
- На второ място, да предположим, че имаме отговори на по-горе споменатите въпроси. Как да възпроизведем съответното натоварване с
fio? Ведьfio— изключително гъвкава утилита с множество параметри (в това е лесно да се уверите, например, — бел. на прев.),.
Решихме и двата проблема с един и същ подход, разчитайки на команди и :
- С помощта на
lsofможете да прегледате всички файлови дескриптори, използвани от процеса, както и файловете, към които те се отнасят. - С помощта на
straceможете да анализирате вече стартиран процес или да стартирате процес и да го наблюдавате. Командата извежда всички системни повиквания, направени от този процес и, ако е необходимо, от неговите потомци. Последното е важно за процеси, които форкват, и etcd е един от тези процеси.
Първото, което направихме, беше да използваме strace за изучаване на сървъра etcd в кластера Kubernetes, докато той беше inactivo.
Така беше открито, че записните блокове в WAL са много плътно групирани, размерът на повечето беше в диапазона 2200-2400 байта. Именно затова в командата в началото на тази статия се използва флаг --bs=2300 (bs — размер в байтове на всеки записен блок в fio).
Обърнете внимание, че размерът на записните блокове на etcd може да варира в зависимост от версията, deployment-а, стойностите на параметрите и т.н. — това влияе на продължителността fdatasync. Ако имате подобен сценарий на използване, анализирайте с помощта на strace вашите процеси etcd, за да получите актуални стойности.
След това, за да получим ясно и всеобхватно разбиране за работата на etcd с файловата система, я стартирахме от strace с флаговете -ffttT. Това позволи да обхванем потомците на процеса и да запишем изхода на всеки в отделен файл. Освен това, бяха получени подробни данни за момента на стартиране и продължителността на всяко системно повикване.
Също така използвахме командата lsof, за да потвърдим разбирането си на изхода strace от гледна точка на това, кой файлов дескриптор за каква цел е използван. Получи се изход strace, подобен на този, който е приведен по-горе. Статистическите манипулации с времето за синхронизация потвърдиха, че метриката wal_fsync_duration_seconds от etcd отговаря на повикванията fdatasync с файловите дескриптори на WAL.
За да генерирате с помощта на fio Рабочата натовареност, подобна на натовареността от etcd, беше проучена документацията на утилитата и подбрани параметри, подходящи за нашата задача. Убедихме се, че са използвани нужните системни повиквания и потвърдихме тяхната продължителност, стартирайки fio от strace (както беше направено в случая с etcd).
Особено внимание беше обърнато на определянето на стойността на параметъра --size. Той представлява общата входно/изходна натовареност, генерирана от утилитата fio. В нашия случай това е общият брой байтове, записани на носителя. Той е право пропорционален на броя на повикванията write (и fdatasync). За определено bs броя на повикванията fdatasync е равно на size / bs.
Тъй като ни интересуваше перцентилът, ние се стремяхме към достатъчно голямо число проби за статистическа значимост. И решихме, че 10^4 (което отговаря на размер от 22 Мб) ще бъде достатъчно. По-малките стойности на параметъра --size даваха по-изразен шум (например, повиквания fdatasync, които отнемат много повече време от обикновено и влияят на 99-ти перцентил).
Работата е ваша
В статията е показано как с помощта на fio може да се оцени дали носителят, предназначен за използване с etcd, е достатъчно бърз. Сега работата е ваша! Изследвайте виртуалните машини с хранилище, базирано на SSD, в услугата .
P.S. от преводача
С готови примери за използване fio за решаване на други задачи можете да се запознаете в или директно в (там са представени значително повече, отколкото са споменати в документацията).
P.P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
