

В тази статия са събрани някои общи шаблони, които помагат на инженерите да работят с мащабни услуги, към които отправят заявки милиони потребители.
Според опита на автора, това не е изчерпателен списък, но наистина ефективни съвети. И така, да започнем.
Преведено с подкрепата на .
Начално ниво
Посочените по-долу мерки са относително лесни за реализиране, но дават висока възвращаемост. Ако досега не сте ги предприемали, ще бъдете изненадани от значителните подобрения.
Инфраструктура като код
Първата част от съветите е да реализирате инфраструктура като код. Това означава, че трябва да имате софтуерен начин за разгръщане на цялата инфраструктура. Звучи сложно, но всъщност говорим за следния код:
Разгръщане на 100 виртуални машини
- с Ubuntu
- 2 ГБ RAM на всяка
- те ще имат следния код
- с тези параметри
Можете да проследявате промените в инфраструктурата и бързо да се връщате към тях с помощта на система за управление на версиите.
Модернистът в мен казва, че можем да използваме Kubernetes/Docker, за да направим всичко гореизброено, и той е прав.
Освен това, автоматизацията може да бъде осигурена с помощта на Chef, Puppet или Terraform.
Непрекъсната интеграция и доставка
За създаването на мащабируема услуга е важно наличието на конвейер за изграждане и тестване за всяко пул-реквест. Дори и тестът да е най-прост, той поне гарантира, че кодът, който внедрявате, се компилира.
Винаги на този етап задавате въпроса: ще се компилира ли моят билд и ще премине тестовете, валиден ли е? Това може да изглежда като ниско ниво, но решава множество проблеми.
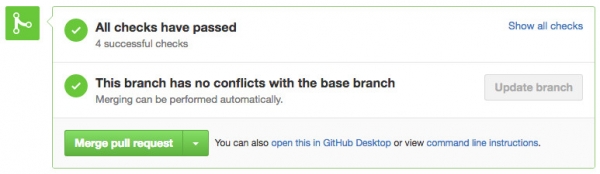
Няма нищо по-прекрасно от това да видите тези отметки
За тази технология можете да оцените Github, CircleCI или Jenkins.
Балансири на натоварването
Така че, искаме да стартираме балансир на натоварването, за да пренасочим трафика и да осигурим равномерно натоварване на всички възли или работата на услугата в случай на неизправност:
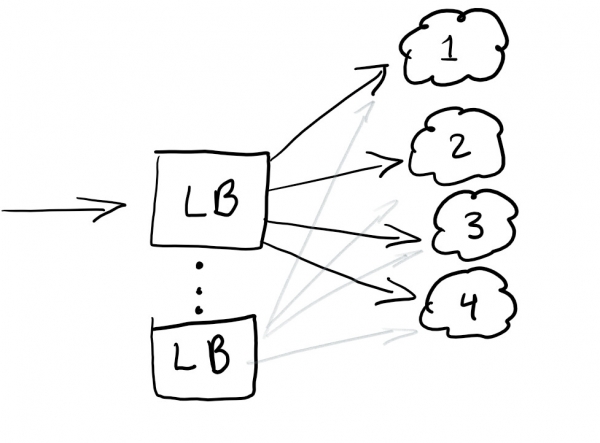
Балансир на натоварването обикновено помага да се разпределя трафика. Най-добрата практика е излишното балансиране, за да нямате единична точка на отказ.
Обикновено балансирите на натоварването се настройват в облака, който използвате.
RayID, идентификатор за корелация или UUID за заявки
Срещали ли сте някога грешка в приложението с подобно съобщение: „Нещо не е наред. Запазете този идентификатор и го изпратете на нашата поддръжка“?
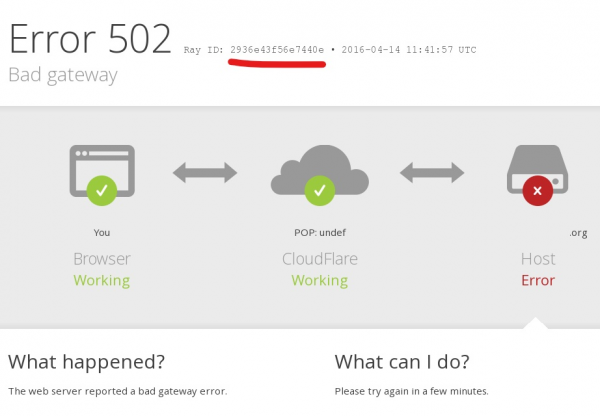
Уникалният идентификатор, correlation ID, RayID или някой от вариантите - това е уникален идентификатор, който позволява проследяване на заявките през жизнения им цикъл. Това позволява да се проследи целия път на заявката в логовете.
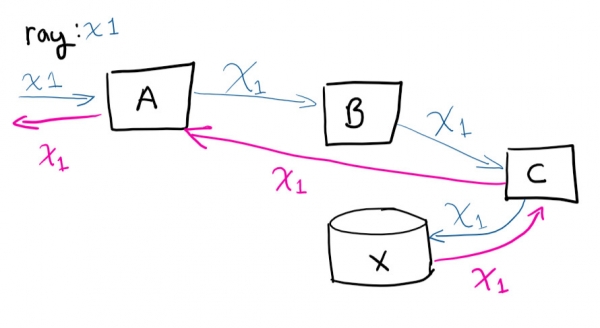
Потребителят прави заявка към система А, след което А се свързва с B, B се свързва с C, записва в X и след това заявката се връща в А.
Ако се свържете дистанционно с виртуалните машини и се опитате да проследите пътя на заявката (и ръчно да съпоставите какви привиквания се извършват), ще полудеете. Наличието на уникален идентификатор значително улеснява ситуацията. Това е едно от най-простите неща, които можете да направите, за да спестите време с нарастващия бизнес.
Средно ниво
Тук съветите са по-сложни от предишните, но правилните инструменти улесняват задачата, осигурявайки възвръщаемост на инвестициите дори за малки и средни компании.
Централизирано водене на логове
Поздравления! Разширихте 100 виртуални машини. На следващия ден главният изпълнителен директор идва и се оплаква от грешка, която е получил по време на тестването на услугата. Той съобщава съответния идентификатор, за който говорихме по-горе, но вие ще трябва да прегледате логовете на 100 машини, за да намерите тази, която предизвика срив. И трябва да я намерите преди утрешната презентация.
Въпреки че звучи като забавно приключение, по-добре е да сте сигурни, че имате възможност за търсене на всички логове от едно място. Реших проблема с централизацията на логовете с вградената функционалност на стека ELK: тук се поддържа събиране на логове с възможност за търсене. Това наистина ще помогне да решите проблема с намирането на конкретен лог. Като бонус, можете да създавате диаграми и подобни забавни неща.
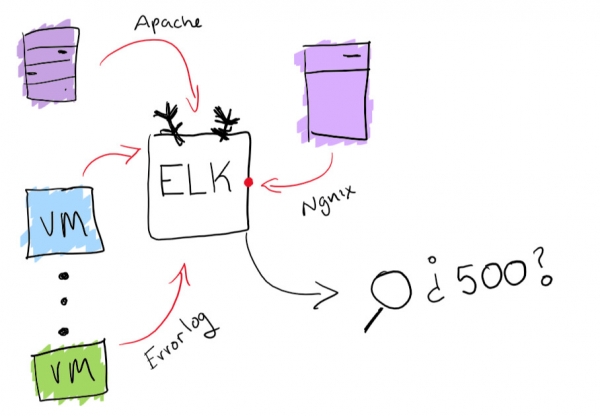
Функционалност на стека ELK
Мониторинг агенти
Сега, когато вашата услуга е в действие, трябва да се уверите, че работи безпроблемно. Най-добрият начин да направите това е да стартирате няколко агенти, които работят паралелно и проверяват, че тя работи и основните операции са извършени.
На този етап проверявате, че Започнатата сборка работи отлично и функционира нормално..
За малки и средни проекти препоръчвам Postman за мониторинг и документиране на API. Важно е да имате начин да разберете кога е възникнала грешка и да получавате навременни известия.
Автоматичноо мащабиране спрямо натоварването
Това е много просто. Ако имате виртуална машина, която обслужва заявки и достига 80% заета памет, можете или да увеличите ресурсите й, или да добавите повече виртуални машини в клъстера. Автоматизираното изпълнение на тези задачи е отличен начин за еластична промяна на мощността спрямо натоварването. Въпреки това, винаги трябва да внимавате колко пари харчите и да установите разумни лимити.
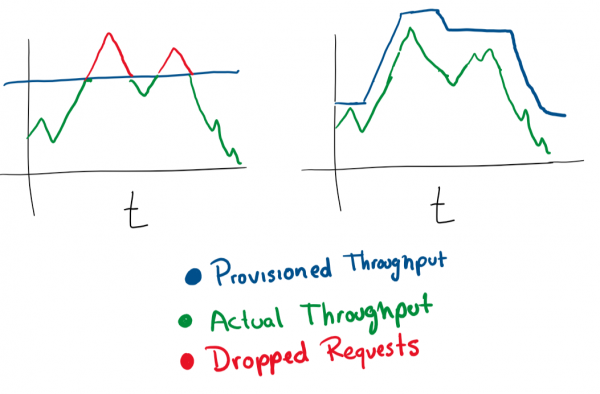
В повечето облачни услуги можете да настроите автоматично мащабиране, използвайки повече или по-мощни сървъри.
Система за експерименти
Добър начин безопасно да внедрите актуализации е да имате възможност да тествате нещо за 1% от потребителите в продължение на час. Разбира се, виждали сте подобни механизми в действие. Например, Facebook показва различна част от аудиторията с различен цвят или променя размера на шрифта, за да види как потребителите възприемат промените. Това се нарича A/B тестване.
Дори пускането на нова функция може да се реализира като експеримент, след което да се определи как да бъде внедрена. Освен това получавате възможност да 'отмените' или промените конфигурацията в реално време, в зависимост от функция, която причинява влошаване на услугата ви.
Напреднало ниво
Тук са съвети, които са доста сложни за реализиране. Вероятно ще ви трябват малко повече ресурси, затова на малка или средна компания ще е трудно да се справи с това.
Синьо-зелени внедрявания
Това, което наричам 'ерланговски' метод на внедряване. Erlang стана широко използван, когато се появиха телефонни компании. За маршрутизиране на телефонни обаждания се прилагаха софтуерни комутатори. Основната задача на софтуера на тези комутатори е да не прекъсва обажданията по време на актуализация на системата. Erlang предлага отличен начин за зареждане на нов модул без сваляне на предишния.
Тази стъпка зависи от наличието на балансировщик на натоварването. Да предположим, че имате версия N на вашето софтуерно решение и след това искате да внедрите версия N+1.
Вие можехте просто да спрете услугата и да внедрите следващата версия в удобно за вашите потребители време и да имате известно време на престой. Но да предположим, че имате наистина строги условия на SLA. Така че, SLA от 99,99% означава, че можете да бъдете офлайн само в рамките на 52 минути годишно.
Ако наистина искате да постигнете такива показатели, ви трябват два внедрявания едновременно:
- това, което имате в момента (N);
- следващата версия (N+1).
Вие указвате на балансировщика на натоварването да пренасочи процент от трафика към новата версия (N+1), докато активно следите за регресии.
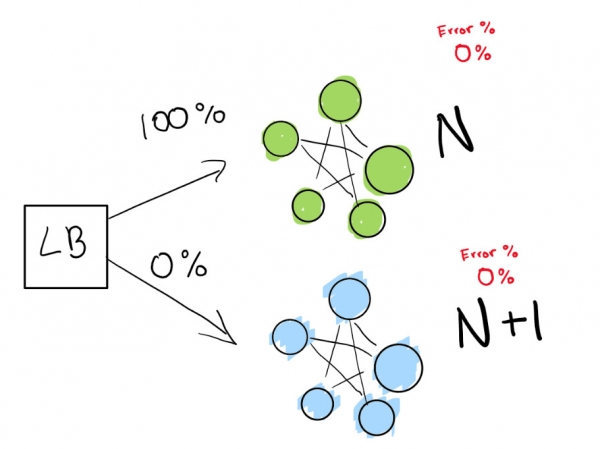
Тук имаме зеленото внедряване N, което работи нормално. Опитваме се да преминем към следващата версия на това внедряване.
Първо изпращаме наистина малък тест, за да видим дали нашето внедряване N+1 работи с малко количество трафик:
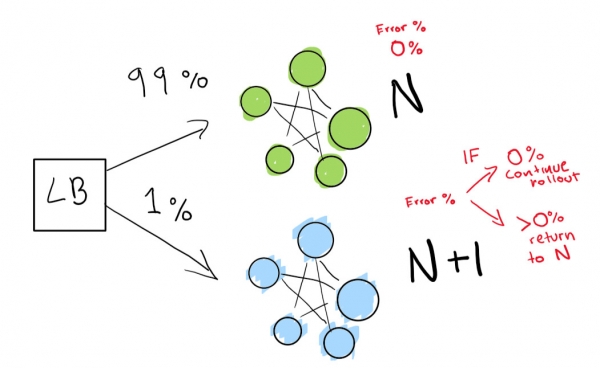
Накрая имаме набор от автоматични проверки, които в крайна сметка извършваме, докато внедряването ни не бъде завършено. Ако вие много-внимателни можете също така да запазите внедряването N завинаги за бързо връщане в случай на лоша регресия:
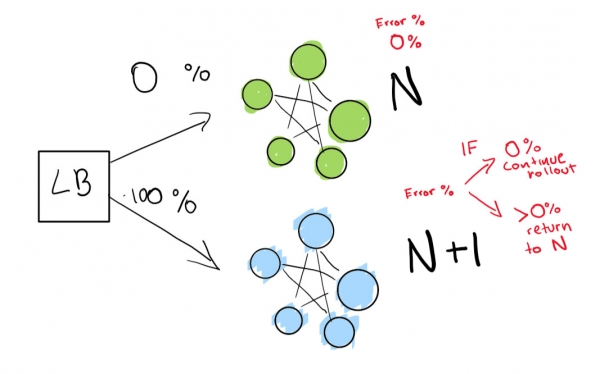
Ако искате да преминете на още по-напреднало ниво, нека всичко в синьо-зеленото внедряване да се изпълнява автоматично.
Откриване на аномалии и автоматично смекчаване на последствията.
С оглед на факта, че имате централизирано водене на записи и добро събиране на логове, можете да поставите по-високи цели. Например, проактивно да прогнозирате неизправности. На мониторите и в логовете се проследяват функции и се изграждат различни диаграми — и можете да предскажете предварително какво ще се обърка:
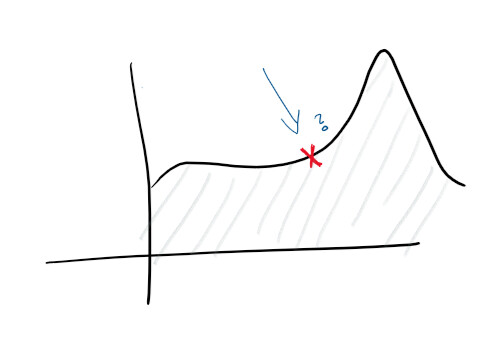
С откритие на аномалии започвате да изучавате някои подсказки, които предоставя услугата. Например, рязък скок на натоварването на CPU може да сигнализира, че твърдият диск се поврежда, а ръстът на броя на заявките означава, че е необходимо мащабиране. Такъв тип статистически данни ви позволяват да направите услугата проактивна.
С получените такива аналитични данни, можете да мащабирате по всякакъв начин, проактивно и реактивно да променяте характеристиките на машините, базите данни, връзките и другите ресурси.
Това е всичко!
Този списък с приоритети ще ви помогне да избегнете много проблеми, ако управлявате облачен сервис.
Авторът на оригиналната статия кани читателите да оставят своите коментари и да направят промени. Статията се разпространява като open source, пул-реквести авторът .
Какво още да прочетете по темата:
Източник: habr.com
