

Много хора знаят за СУБД PostgreSQL и тя е доказала своята ефективност при малки инсталации. Въпреки това, тенденцията за преминаване към Open Source става все по-очевидна, дори когато става въпрос за големи компании и изисквания за корпоративно ниво. В тази статия ще разкажем как да интегрираме Postgres в корпоративна среда и ще споделим опит за създаване на система за резервно копие (СРК) за тази база данни на примера на системата за резервно копие Commvault.
PostgreSQL вече е доказала своята стойност — СУБД работи отлично, използва се от модни цифрови компании като Alibaba и TripAdvisor, а отсъствието на лицензионни такси я прави привлекателна алтернатива на монолити като MS SQL или Oracle DB. Но щом започнем да размишляваме за PostgreSQL в контекста на корпоративния сектор, веднага се сблъскваме с жестоки изисквания: „Какво ще кажете за отказоустойчивостта на конфигурацията? Какво с катастрофоустойчивостта? Къде е цялостният мониторинг? Каква е автоматизацията на резервното копие? А използването на лентови библиотеки, както пряко, така и за вторично хранилище?“
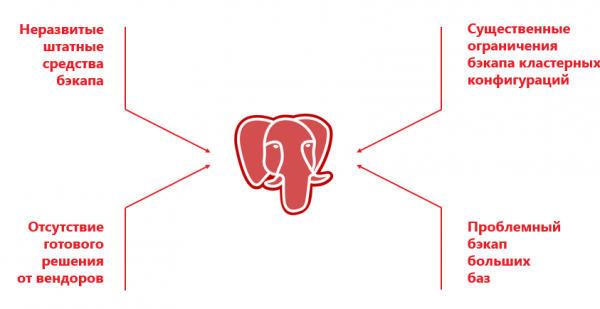
От една страна, PostgreSQL няма вградени средства за резервно копие, подобно на „възрастните“ СУБД, като RMAN в Oracle DB или SAP Database Backup. От друга страна, доставчиците на корпоративни системи за резервно копие (Veeam, Veritas, Commvault) макар и да поддържат PostgreSQL, по принцип работят само с определена (обикновено standalone) конфигурация и с набор от различни ограничения.
Специално проектираните за PostgreSQL системи за резервно копие, като Barman, Wal-g, pg_probackup, са изключително популярни в малки инсталации на СУБД PostgreSQL или в случаи, където тежки резервни копия на другите елементи от ИТ-ландшафта не са необходими. Например, освен PostgreSQL, в инфраструктурата могат да присъстват физически и виртуални сървъри, OpenShift, Oracle, MariaDB, Cassandra и т.н. Всичко това е желателно да бъде архивирано с общ инструмент. Поставянето на отделно решение само за PostgreSQL е неудачна идея: данните ще бъдат копирани някъде на диск, а след това трябва да бъдат преместени на лента. Това дублиране на резервните копия увеличава времето за архивиране, а също така, което е още по-критично, — възстановяването.
В enterprise решение за резервно копиране на инсталацията става с определен брой възли от выделен клъстер. Например, Commvault може да работи само с двувъзлов клъстер, в който Primary и Secondary са строго закрепени за определени възли. Има смисъл да се прави бекъп само от Primary, защото резервното копиране от Secondary има свои ограничения. Заради особеностите на СУБД, дамп на Secondary не се създава, така че остава само възможността за файлов бекъп.
За да се намалят рисковете от простои, при създаването на отказоустойчива система се създава „жива“ кластерна конфигурация и Primary може постепенно да мигрира между различни сървъри. Например, софтуерът Patroni автоматично стартира Primary на случайно избран възел от клъстера. SRK няма начин да проследява това „извън кутията“ и ако конфигурацията се променя, процесите се счупват. Тоест, внедряването на външно управление пречи на SRK да работи ефективно, защото управляващият сървър просто не разбира откъде и какви данни трябва да копира.
Още един проблем – реализирането на бекъп в Postgres. Това е възможно чрез dump и работи при малки бази. Но при големи БД дампът отнема много време, изисква много ресурси и може да доведе до срив на инстанцията на БД.
Файловият бекъп решава проблема, но при големи бази върви бавно, защото работи в еднопоточен режим. Освен това, вендорите имат редица допълнителни ограничения. Веднъж не може да се използват едновременно файлов и дампов бекъп, а друг път не се поддържа дедупликация. Проблемите са много и често вместо Postgres е по-лесно да се избере скъпа, но доказана СУБД.
Няма накъде да отстъпваме! Зад нас е Москва, разработчиците!
Но наскоро нашият екип се изправи пред непрост предизвикателство: в проекта за създаване на АИС ОСАГО 2.0, където изграждахме ИТ инфраструктура, разработчиците избраха PostgreSQL за новата система.
На големите разработчици на софтуер им е много по-лесно да използват „модерни“ open-source решения. В екипа на Facebook има достатъчно специалисти, които поддържат работата на тази СУБД. А в случая с РСА всички задачи за „втория ден“ падат на нашите плещи. От нас се изискваше да осигурим отказоустойчивост, да изградим клъстер и, разбира се, да наложим резервно копиране. Логиката на действията беше следната:
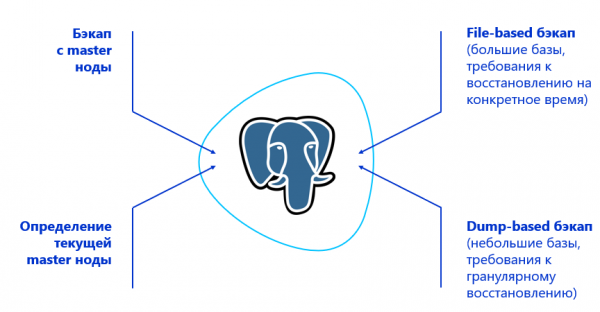
- Научете SRK да прави резервно копие от основния възел на клъстера. За целта, SRK трябва да го намери — следователно, необходима е интеграция с решение за управление на PostgreSQL клъстери. В случая с РСА, за тази цел е използвано софтуерното решение Patroni.
- Определете типа резервно копие в зависимост от обема на данните и изискванията за възстановяване. Например, ако е необходимо грануларно възстановяване на страници, използвайте дамп; а ако базите данни са големи и гранулярно възстановяване не е необходимо — работете на ниво файлове.
- Добавете функционалност за блочно резервно копие, за да се създава резервна копия в многопоточен режим.
В същото време, първоначално си поставихме за цел да създадем ефективна и проста система без обременяваща обвивка от допълнителни компоненти. Колкото по-малко "костури", толкова по-малко натоварване за персонала и по-нисък риск от неизправност на SRK. Подходите, при които са използвани Veeam и RMAN, веднага изключихме, тъй като комплектът от две решения вече намеква за ненадеждност на системата.
Малко магия за enterprise
Така, бяхме длъжни да гарантираме надеждно резервно копие за 10 клъстера по 3 възела всеки, при което в резервния ЦОД се намира идентична инфраструктура. ЦОД-те по отношение на PostgreSQL работят по принципа на активен-пасивен режим. Общият обем на базите данни беше 50 TB. С това лесно може да се справи всяка корпоративна SRK. Но особеността беше, че в Postgres няма и зацепка за пълна и дълбока съвместимост с решения за резервно копие. Затова бяхме принудени да търсим решение, което първоначално да осигури максимална функционалност в комбинация с PostgreSQL и след това да доразвием системата.
Проведохме 3 вътрешни хакатона — прегледахме повече от петдесет разработки, тестваме ги, внесохме промени въз основа на нашите хипотези и повторно проверявахме. След анализ на наличните опции, избрахме Commvault. Този продукт вече "из кутията" можеше да работи с най-простата клъстерна инсталация на PostgreSQL, а неговата отворена архитектура даде надежда (която се оправда) за успешна доработка и интеграция. Освен това, Commvault може да извършва резервни копия на логовете на PostgreSQL. Например, Veritas NetBackup може да прави само пълни резервни копия в частта на PostgreSQL.
Научете повече за архитектурата. Управляващите сървъри на Commvault бяха инсталирани във всеки от двата ЦОД в конфигурация CommServ HA. Системата е зеркална, управлява се от един консул и от гледна точка на HA отговаря на всички изисквания на enterprise.
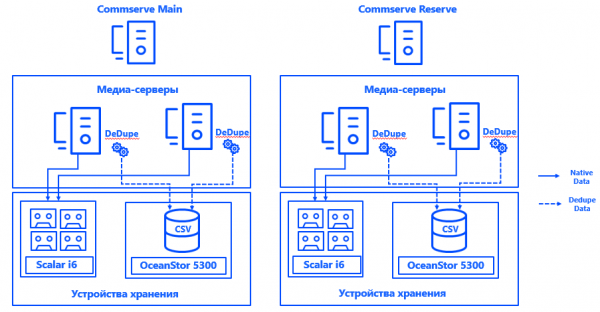
Също така в всеки ЦОД стартирахме по два физически медиа-сървъра, които чрез SAN по Fibre Channel свързахме с дискови масиви и лентови библиотеки, специално предназначени за резервното копие. Разпределените бази за дедупликация осигуриха отказоустойчивост на медиасървърите, а свързването на всеки сървър с всеки CSV – възможност за непрекъсната работа при отказ на която и да е компонента. Архитектурата на системата позволява продължаване на резервното копие, дори ако един от ЦОД падне.
Patroni определя Primary-нода за всеки кластер. Това може да е всяка свободна нода в ЦОД – но само в основния. В резервния всички ноди са Secondary.
За да може Commvault да разбере коя нода на клъстера е Primary, интегрирахме системата (благодарение на отворената архитектура на решението) с Postgres. За целта беше създаден скрипт, който уведомява за текущото местоположение на Primary-нода управляващия. сървъра Commvault.
По принцип, процесът изглежда така:
Patroni избира Primary → Keepalived стартира IP-кластера и стартира скрипта → агентът на Commvault на избраната нода на клъстера получава уведомление, че това е Primary → Commvault автоматично преподрежда резервното копие в рамките на псевдоклиента.
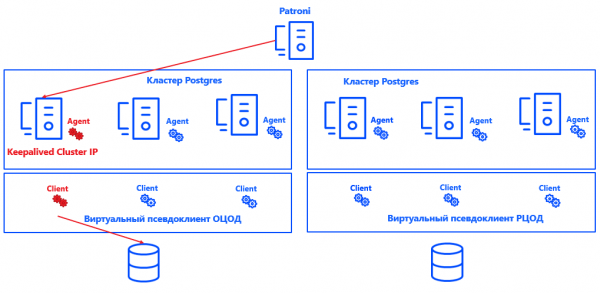
Предимството на този подход е, че решението не влияе нито на консистентността, нито на коректността на логовете, нито на възстановяването на инстанса на Postgres. То също така лесно се мащабира, защото не е необходимо да се фиксират Primary и Secondary-ноди за Commvault. Достатъчно е системата да разбира къде е Primary, и броят на нодовете може да бъде увеличен практически до всяка стойност.
Решението не претендира за съвършенство и има свои нюанси. Commvault може да резервира само целия инстанс, а не отделни бази. Затова за всяка БД е създаден отделен инстанс. Реалните клиенти са обединени в виртуални псевдоклиенти. Всеки псевдоклиент на Commvault представлява UNIX кластер. В него се добавят тези ноди на клъстера, на които е инсталиран агентът на Commvault за Postgres. В резултат на това всички виртуални ноди на псевдоклиента се резервират като един инстанс.
Вътре във всеки псевдоклиент е посочен активният възел на клъстера. Именно той определя нашето интеграционно решение за Commvault. Принципът на работа е достатъчно прост: ако на възела се стартира клъстерен IP, скриптът задава в бинарника на агента Commvault параметъра "активен възел" — по същество скриптът слага "1" в необходимата част от паметта. Агентът предава тези данни на CommServe и Commvault прави резервно копие от необходимия узел. Освен това, на ниво скрипт се проверява коректността на конфигурацията, помагайки да се избегнат грешки при стартиране на резервното копиране.
При това големите бази данни се резервират на блокове в няколко потока, отговарящи на изискванията RPO и времевия прозорец за резервно копиране. Натоварването на системата е незначително: Цялостните копия не се правят толкова често, а в останалите дни се събират само логове, и то в периоди на ниско натоварване.
Между другото, приложихме отделни политики за резервно копиране на архивни журнали на PostgreSQL — те се съхраняват по различни правила, копират се по различно разписание и за тях не се включва дедупликация, тъй като тези журнали съдържат уникални данни.
За да осигурим консистентността на цялата ИТ инфраструктура, отделни файлови клиенти на Commvault са инсталирани на всеки от възлите на клъстера. Те изключват от резервните копия файловете на Postgres и са предназначени само за резервно копиране на ОС и приложни програми. И за тази част от данните е предвидена своя политика и срок за съхранение.
В момента СРК не влияе на продуктивните услуги, но ако ситуацията се промени, в Commvault може да се включи система за ограничения на натоварването.
Доволни ли сте? Доволни сме!
Така, получихме не просто работещ, а и напълно автоматизиран резервен копие за клъстерна инсталация на PostgreSQL, съответстваща на всички изисквания на enterprise предизвикателствата.
Параметрите RPO и RTO от 1 час и 2 часа са покрити с резерв, което означава, че системата ще отговаря на тях дори при значително нарастване на обема на съхраняваните данни. Въпреки многото съмнения, PostgreSQL и enterprise средата се оказаха напълно съвместими. И сега по собствен опит знаем, че резервното копие за подобни СУБД е възможно в най-разнообразни конфигурации.
Разбира се, по пътя ни се наложи да износим седем чифта железни ботуши, да преодолеем редица трудности, да стъпим на няколко гребла и да поправим известно количество грешки. Но сега подходът е тестван и може да се прилага за внедряване на Open Source вместо собственически СУБД в сурови условия на корпоративния сектор.
Опитвали ли сте да работите с PostgreSQL в корпоративна среда?
Автори:
Олег Лавренов, инженер-проектировщик на системи за съхранение на данни в «Инфосистемы Джет»
Дмитрий Ерыкин, инженер-проектировщик на изчислителни комплекси в «Инфосистемы Джет»
Източник: habr.com
