

В предишните статии започнахме да говорим за това какво е Proxmox VE и как работи. Днес ще ви разкажем за възможностите за клъстеризация и ще покажем какви предимства предоставя това.
Какво точно е клъстер и за какво е нужен? Клъстер (от английски cluster) — това е група сървъри, обединени със скорости на свързване, която работи и се представя на потребителя като едно цяло. Съществуват няколко основни сценария за използване на клъстер:
- Осигуряване на отказоустойчивост (High-availability).
- Балансировка на натоварването (Load Balancing).
- Увеличаване на производителността (High Performance).
- Изпълнение на разпределени изчисления (Distributed computing).
Всеки сценарий поставя свои специфични изисквания към компонентите на клъстера. Например, за клъстер, който извършва разпределени изчисления, основното изискване е висока скорост на изпълнение на операции с плаваща запетая и ниска латентност на мрежата. Подобни клъстери често се използват в научни изследвания.
След като засегнахме темата за разпределените изчисления, трябва да споменем, че съществува и такова понятие като грид-система (от английски grid — решетка, мрежа). Въпреки общото сходство, не бива да се бърка грид-системата с клъстер. Гридът не е клъстер в обичайния смисъл. За разлика от клъстера, възлите в грида често са хетерогенни и имат ниска достъпност. Такъв подход опростява решаването на задачи с разпределени изчисления, но не позволява създаването на единно цяло от възлите.
Ясен пример за грид-система е популярната изчислителна платформа (Berkeley Open Infrastructure for Network Computing). Тази платформа първоначално е създадена за проекта (Search for Extra-Terrestrial Intelligence at Home), който се занимава с търсенето на извънземен разум чрез анализ на радиосигнали.
Как работи товаОгромният масив от данни, получени от радиотелескопи, се разделя на множество малки парчета, които се изпращат към възлите на грид-системата (в проекта SETI@home ролята на такива възли играят компютри на доброволци). Данните се обработват на възлите и след завършване на обработката се изпращат на централния сървър на проекта SETI. По този начин проектът решава сложна глобална задача, без да разполага с необходимите изчислителни мощности.
Сега, когато имаме ясна представа за това какво представлява клъстър, нека разгледаме как можем да го създадем и използваме. Ще използваме система за виртуализация с отворен код. .
Особено важно е, преди да започнем създаването на клъстър, да разберем ограниченията и системните изисквания на Proxmox, а именно:
- максимален брой ноди в клъстъра — 32;
- всички ноди трябва да имат еднаква версия на Proxmox (има изключения, но не се препоръчват за продукция);
- ако впоследствие се планира да се използва функционалността за висока наличност, то в клъстъра трябва да има поне 3 ноди;
- за взаимодействие между нодите трябва да бъдат отворени портовете UDP/5404, UDP/5405 за corosync и TCP/22 за SSH;
- забавянето в мрежата между нодите не трябва да надвишава 2 мс.
Създаване на клъстър
Важно! Следващата конфигурация е тестова. Не забравяйте да проверите с на Proxmox VE.
За да стартираме тестов клъстър, взехме три сървъра с инсталиран хипервизор Proxmox с еднаква конфигурация (2 ядра, 2 Гб оперативна памет).
Ако искате да разберете как можете да инсталирате Proxmox, препоръчваме да прочетете предишната ни статия — .
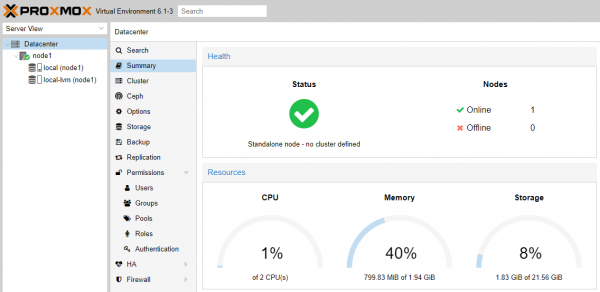
Първоначално, след инсталацията на ОС, единичният сървър работи в Standalone-mode.
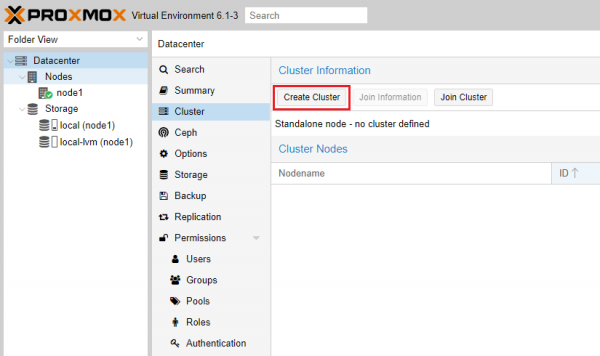
Създайте клъстър, натискайки бутона Create Cluster в съответния раздел.
Задайте име на бъдещия клъстър и изберете активно мрежово свързване.
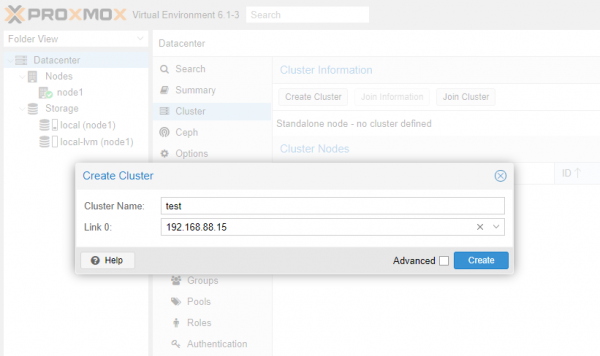
Бутонът Create. Сървърът ще генерира 2048-битов ключ и ще го запише заедно с параметрите на новия клъстър в конфигурационните файлове.
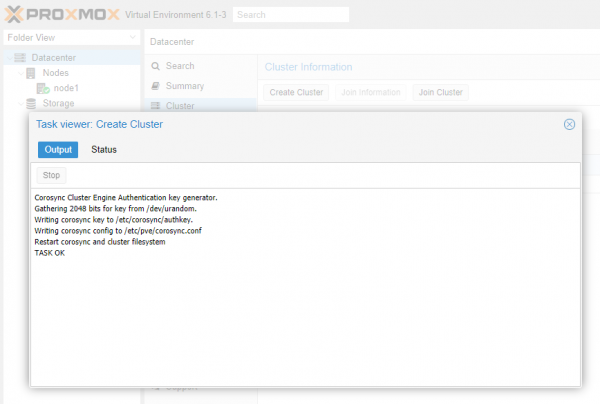
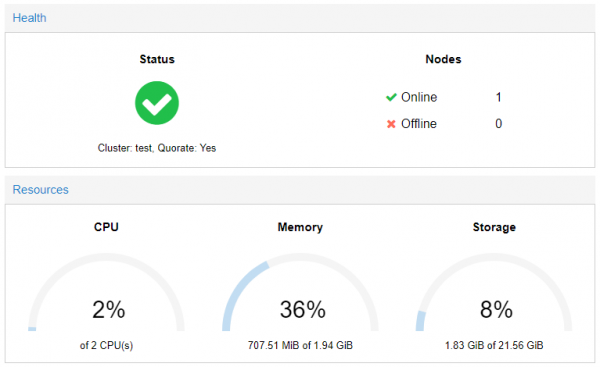
Надписът TASK OK свидетелства за успешно изпълнение на операцията. Сега, поглеждайки към общата информация за системата, е видно, че сървърът е преминал в режим на клъстър. Засега клъстърът се състои само от една нода, т.е. в момента няма онези възможности, за които е необходим клъстър.
Присъединяване към клъстера
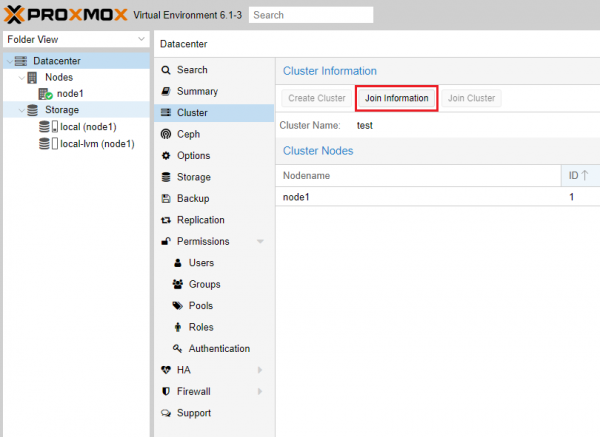
Преди да се свържем с създадените клъстър, трябва да получим информация за извършване на свързването. За целта влизаме в раздела Cluster и натискаме бутона Join Information.
В отворилото се прозорче ни интересува съдържанието на едноименното поле. Необходимо е да бъде копирано.
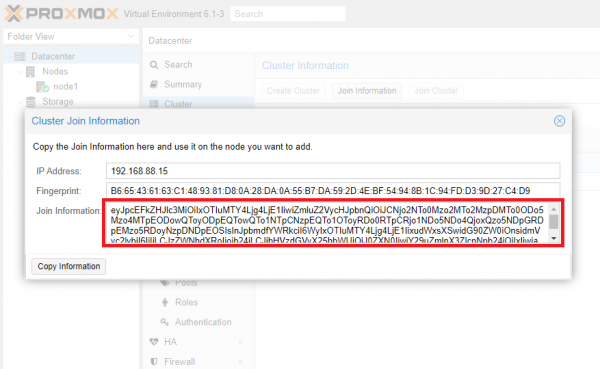
Тук са кодирани всички необходими параметри за свързване: адрес на сървъра за свързване и цифров отпечатък. Преминаваме към сървъра, който трябва да бъде добавен в клъстера. Натискаме бутона Присъединяване към клъстера и в отворилото се прозорче поставяме копираното съдържание.

Полета Адрес на партньора и Отпечатък ще бъдат попълнени автоматично. Въвеждаме паролата на root от възел номер 1, избираме мрежовото свързване и натискаме бутона Присъедини.
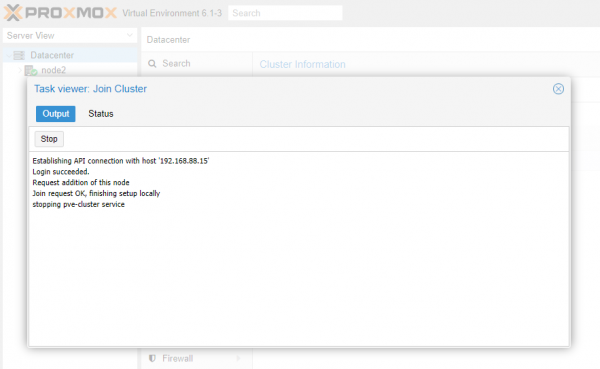
По време на процеса на присъединяване към клъстера уеб страницата GUI може да спре да се обновява. Това е нормално, просто презаредете страницата. По същия начин добавяме още един възел и в крайна сметка получаваме напълно функциониращ клъстер от 3 работещи възли.
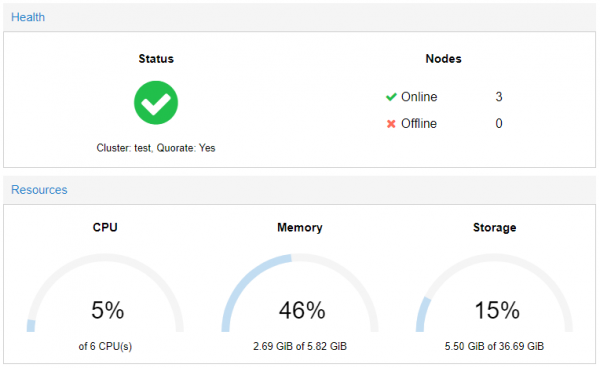
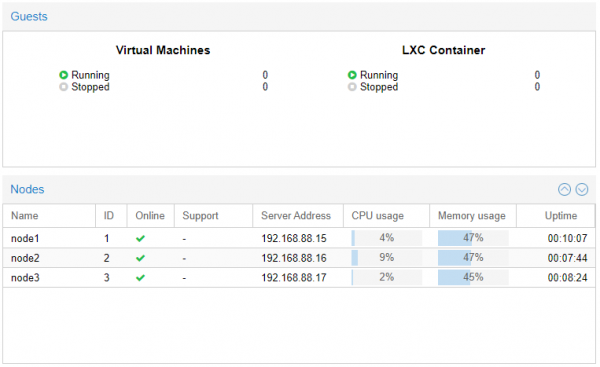
Сега можем да контролираме всички възли на клъстера от един GUI.
Организация на висока наличност
Proxmox «извън кутията» поддържа функционалност за организация на HA както за виртуални машини, така и за LXC контейнери. Утилитата ha-manager открива и реагира на грешки и повреди, извършвайки аварийно превключване от повредения възел към работещия. За да работи механизмът коректно, е необходимо виртуалните машини и контейнерите да имат общо файлово хранилище.
След активиране на функционалността за висока наличност, софтуерният стек ha-manager ще започне постоянно да следи състоянието на работата на виртуалната машина или контейнера и асинхронно да взаимодействат с другите възли на клъстера.
Присъединяване на общото хранилище
За пример разгръщаме малко файлово хранилище NFS на адрес 192.168.88.18. За да могат всички възли на клъстера да го използват, трябва да извършим следните манипулации.
Избиране от менюто на уеб интерфейса Datacenter — Storage — Add — NFS.
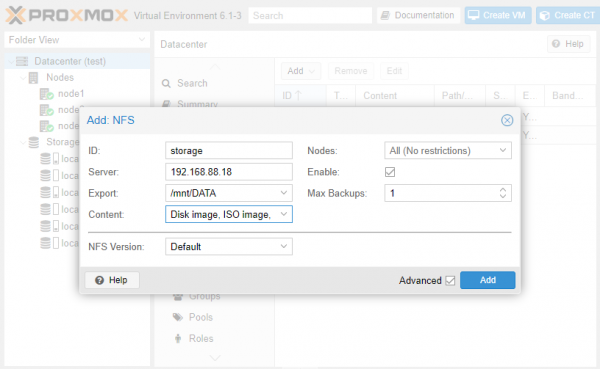
Попълваме полетата ID и Сървър. В падащото меню Експорт избираме необходимата директория от наличните и в списъка Съдържание — необходимите типове данни. След натискане на бутона Добави хранилището ще бъде свързано към всички възли на клъстера.
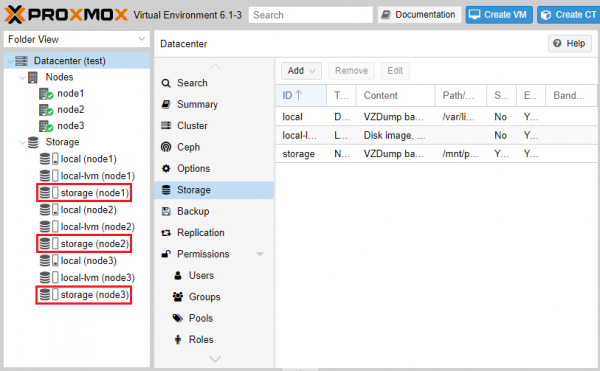
При създаване на виртуални машини и контейнери на който и да е възел, указваме нашето хранилище като хранилище.
Настройване на HA
За пример ще създадем контейнер с Ubuntu 18.04 и ще настроим за него висока наличност. След създаването и стартирането на контейнера влизаме в секцията Datacenter — HA — Add. В отворилото се поле посочваме ID на виртуалната машина/контейнера и максимален брой опити за рестарт и преместване между възлите.
Ако това количество бъде надвишено, хипервизорът ще маркира VM като неуспешна и ще я премести в състояние Error, след което ще спре да изпълнява каквито и да било действия с нея.
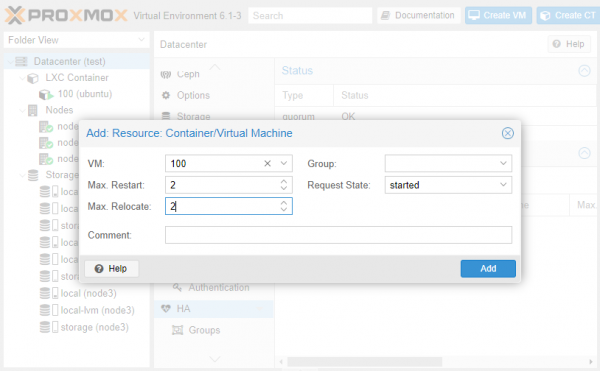
След натискване на бутона Добави утилита ha-manager ще уведоми всички възли на кластера, че сега VM с указаното ID се контролира и в случай на срив, трябва да бъде рестартирана на друг възел.
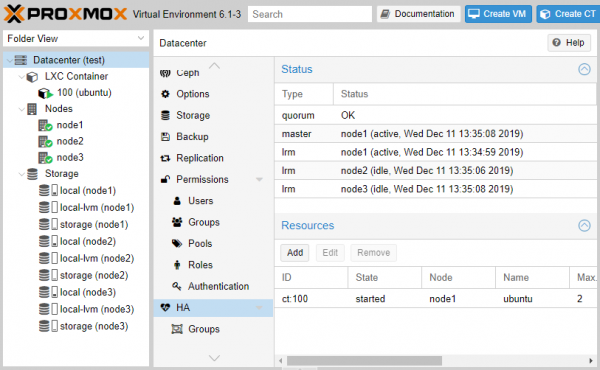
Нека симулираме срив
За да видим как точно работи механизма за превключване, ще изключим node1 от захранването. Наблюдаваме от друг възел какво се случва с клъстера. Виждаме, че системата е регистрирала срив.
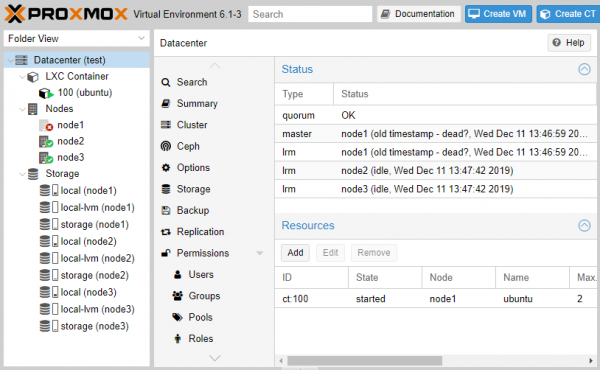
Работата на механизма HA не означава непрекъснато функциониране на VM. След като възелът „падне“, работата на VM временно спира до момента на автоматичното рестартиране на друг възел.
И тук започва „магията“ — клъстерът автоматично е преназначил възел за изпълнение на нашата VM и в течение на 120 секунди работата е била автоматично възстановена.

Изключваме node2 от захранването. Да видим дали клъстерът ще издържи и дали VM ще се върне в работно състояние автоматично.
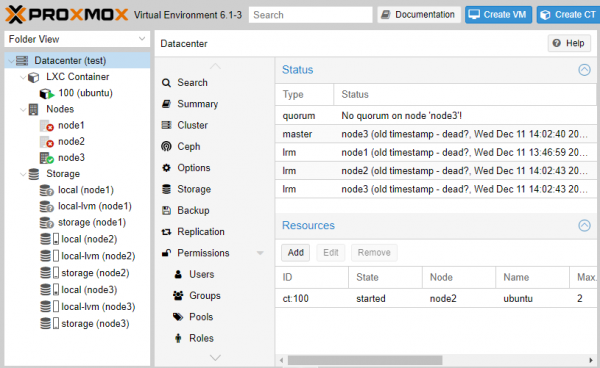
За съжаление, както виждаме, имаме проблем с това, че на единственото оставено в живо положение възел вече няма кворум, което автоматично изключва работата на HA. Даваме команда в консолата за принудително установяване на кворум.
pvecm очаква 1 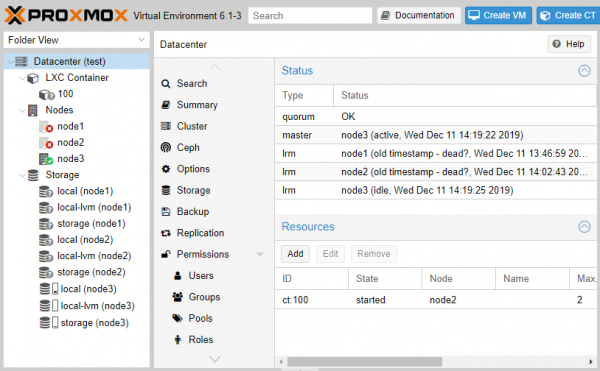
След 2 минути механизмът HA работи коректно и, не намирайки node2, стартира нашата VM на node3.
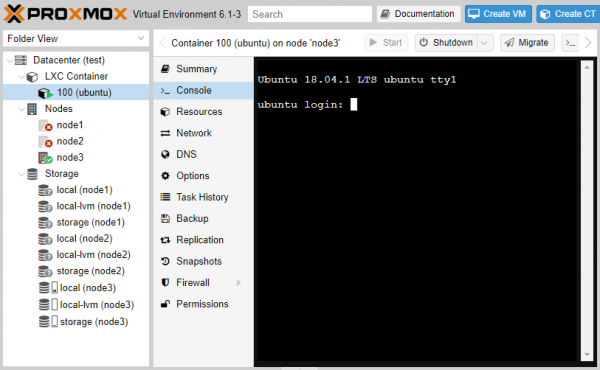
След като включихме отново node1 и node2, работата на клъстера беше напълно възстановена. Обърнете внимание, че обратно на node1 VM не мигрира автоматично, но това може да се направи ръчно.
Обобщаваме
Разказахме ви как е устроен механизма за клъстеризация в Proxmox, както и как се конфигурира HA за виртуални машини и контейнери. Правилното използване на клъстеризация и HA значително увеличава надеждността на инфраструктурата и осигурява възстановяване след сривове.
Преди да създадете клъстер, трябва веднага да планирате за какви цели ще се използва и колко ще трябва да се мащабира в бъдеще. Също така е необходимо да проверите мрежовата инфраструктура за готовност за работа с минимални забавяния, за да работи бъдещият клъстер без сривове.
Кажете ни — използвате ли възможностите за клъстеризация в Proxmox? Очакваме ви в коментарите.
Предходни статии по темата на хипервизора Proxmox VE:
Източник: habr.com
