

За какво ще говорим:
Как бързо да разширим общо хранилище за два сървъра на базата на решения drbd+ocfs2.
За кого е полезно:
Този урок ще бъде полезен на системните администратори и на всички, които избират метод за реализиране на хранилище или искат да пробват решение.
От какви решения се отказахме и защо
Често се сблъскваме със ситуация, в която трябва да реализираме общо хранилище с добра производителност на четене и запис в малък уеб клъстер. Пробвали сме различни варианти за реализиране на общо хранилище за нашите проекти, но малко от тях успяха да ни задоволят по множество показатели. Сега ще разкажем защо.
- Glusterfs не ни удовлетворява с производителността на четене и запис, появяват се проблеми с едновременното четене на голям брой файлове, има високо натоварване на CPU. Проблемът с четенето на файлове може да се реши с директно извикване от brick-овете, но това не винаги е приложимо и е противоречиво.
- Ceph не ни допадна с излишна сложност, която може да е вредна за проекти с 2-4 сървъри, особено, ако проектът впоследствие се поддържа. Отново има сериозни ограничения по производителността, които принуждават да се изграждат отделни storage клъстери, както при glusterfs.
- Използването на един nfs сървър за реализиране на общо хранилище повдига въпроси относно отказоустойчивостта.
- s3 — отлично популярно решение за определен кръг задачи, но това не е файлова система, което стеснява обхвата на приложение.
- lsyncd. Ако вече започнахме да говорим за «не-филмови системи», струва си да споменем и това популярно решение. Освен че не е подходящо за двустранен обмен (но ако много искате, може), то не работи стабилно с голям брой файлове. Хубаво допълнение е, че е еднопоточно. Причината е в архитектурата на програмата: тя използва inotify за мониторинг на обектите за работа, които инсталира при стартиране и при повторно сканиране. Като средство за предаване се използва rsync.
Урок: как да реализираме общо хранилище на базата на drbd+ocfs2
Едно от най-удобните решения за нас стана комбинацията ocfs2+drbd. Сега ще разкажем как бързо да разширим общо хранилище за двата сървъри на базата на решения. Но първо малко за компонентите:
DRBD — система за съхранение, стандартно предлагана от Linux, която позволява репликация на данни между сървъри на блокове. Основното приложение е в изграждането на отказоустойчиви хранилища.
OCFS2 — файлова система, която позволява споделено ползване на едно и също хранилище от множество системи. Включена е в доставката на Linux и представлява модул на ядрото и инструменти за работа с файловата система. OCFS2 може да се използва не само върху DRBD, но и върху iSCSI с множество свързвания. В нашия пример използваме DRBD.
Всички действия се извършват на ubuntu server 18.04 в минимална конфигурация.
Стъпка 1. Настройваме DRBD:
В файла /etc/drbd.d/drbd0.res описваме нашето виртуално блоково устройство /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — да се използват същите блокови устройства за съхранение на метаданни
device /dev/drbd0 — да се използва /dev/drbd0 като път към drbd-то.
disk /dev/vdb1 — да се използва /dev/vdb1
syncer { rate 1000M; } — да се използва гигабитна пропускна способност на канала
allow-two-primaries — важна опция, разрешаваща приемането на промени на два основни сървъра
after-sb-0pri, after-sb-1pri, after-sb-2pri — опции, отговорни за действията на възела при открития на split-brain. Можете да намерите повече информация в документацията.
become-primary-on both — настройва и двата възела в primary.
В нашия случай имаме две абсолютно идентични виртуални машини, с изолирана виртуална мрежа с пропускна способност от 10 гигабита.
В нашия пример, имената на мрежовите възли на клъстера са drbd1 и drbd2. За да работят правилно, е необходимо да коригирате в /etc/hosts имената и IP адресите на възлите.
10.10.10.192 drbd1
10.10.10.193 drbd2
Стъпка 2. Настройваме възлите:
На двете сървъра изпълняваме:
drbdadm create-md drbd0 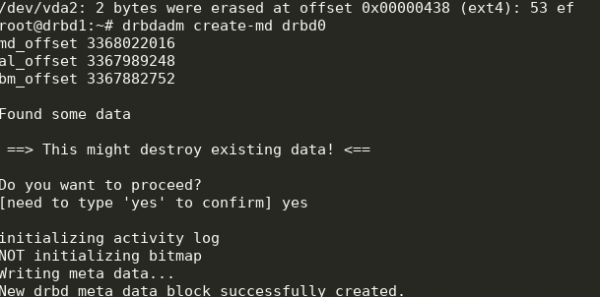
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
Получаваме следното:
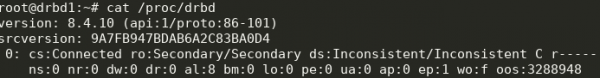
Може да стартираме синхронизацията. На първия възел трябва да изпълните:
drbdadm primary --force drbd0Проверяваме статуса:
cat /proc/drbd 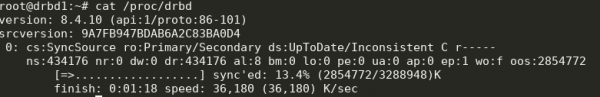
Отлично, синхронизацията започна. Изчакваме приключването и виждаме картината:
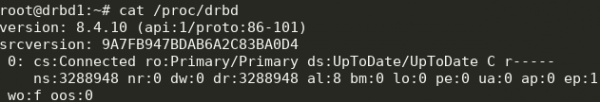
Стъпка 3. Стартираме синхронизацията на втория възел:
drbdadm primary --force drbd0
Получаваме следното:
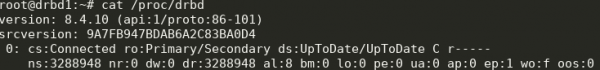
Сега можем да записваме в drbd от двата сървъра.
Стъпка 4. Инсталиране и настройка на ocfs2.
Ще използваме достатъчно тривиална конфигурация:
клъстер:
     брой_възли = 2
     име = ocfs2cluster

възел:
     номер = 1
     клъстер = ocfs2cluster
     ip_порт = 7777
     ip_адрес = 10.10.10.192
     име = drbd1

възел:
     номер = 2
     клъстер = ocfs2cluster
     ip_порт = 7777
     ip_адрес = 10.10.10.193
     име = drbd2
Трябва да се запише в /etc/ocfs2/cluster.conf и на двата възела.
Създаваме ФС на drbd0 на произволен възел:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Тук създадохме ФС с етикет testVol на drbd0, използвайки параметрите по подразбиране.
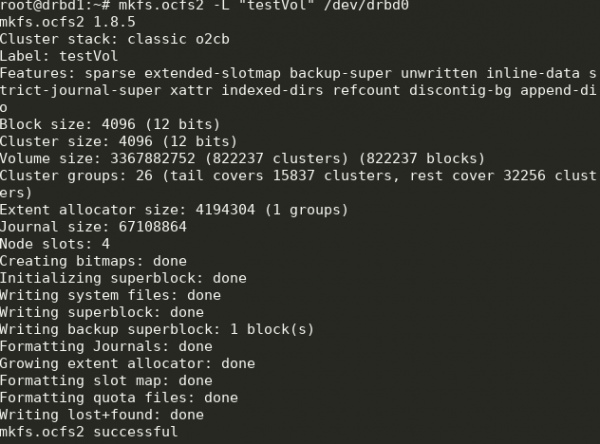
В /etc/default/o2cb е необходимо да зададете (както в нашия конфигурационен файл)
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
и да изпълните на всеки възел:
o2cb register-cluster ocfs2clusterСлед това активираме и добавяме в автоматичен старт всичките нужни юнити:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
Част от това вече ще бъде стартирано в процеса на конфигурация.
Стъпка 5. Добавяме точки за монтиране в fstab на двата възела:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0Директория /media/shared като предварително трябва да е създадена.
Тук използваме опцията noauto, която означава, че ФС няма да бъде монтирано при стартиране (предпочитам да монтирам мрежови ФС чрез systemd) и heartbeat=local, което означава използване на сървиса heartbeat на всеки възел. Съществува и global heartbeat, който е по-подходящ за големи клъстери.
След това може да се монтира /media/shared и да се провери синхронизацията на съдържанието.
Готово! В резултат получаваме до известна степен отказоустойчиво хранилище с възможност за мащабиране и добра производителност.
Източник: habr.com
