

Платформа позволява да се ускори процесът на създаване на , включително в инфраструктурата на доставчиците на облачни услуги, на платформите за виртуализация или в системи bare-metal. За да създадем в истинския смисъл облачна платформа, трябваше да вземем под сериозен контрол всички използвани елементи и по този начин да увеличим надеждността на сложния процес на автоматизация.
Очевидното решение беше да използваме като стандарт Red Hat Enterprise Linux CoreOS (разновидност на Red Hat Enterprise Linux) и CRI-O, и ето защо…
Тъй като темата за мореплаването е доста удачна за търсене на аналогии при обяснението на работата на Kubernetes и контейнерите, ще се опитаме да разкажем за бизнес-проблемите, които решават CoreOS и CRI-O, на примера на . През 1803 година пред Марк Брюнел беше поставена задачата да произведе 100 хиляди такелажни блока за нуждите на растящия търговски флот на Великобритания. Такелажният блок е тип оборудване, използвано за закрепване на въжета към платната. До началото на 19-ти век тези блокове се произвеждаха ръчно, но на Брюнел му успя да автоматизира производството и да започне производството на стандартизирани блокове с помощта на машини. Автоматизацията на този процес означаваше, че всички блокове ставаха практически идентични, лесно заменяеми в случай на повреда и можеха да се произвеждат в голямо количество.
А сега си представете, че Брюнел е трябвало да изпълни тази работа за 20 различни модела кораби (версии на Kubernetes) и за пет различни планети с напълно различни морски течения и ветрове (облачни доставчици). Освен това, всички кораби (кластери OpenShift) трябваше да се държат еднакво независимо от планетите, по които плават, от гледна точка на капитаните (операторите, управляващи работата на клъстерите). Продължавайки морската аналогия, капитаните на корабите не се интересуват какви такелажни блокове (CRI-O) се използват на техните кораби – за тях е важно тези блокове да са здрави и надеждни.
Преди OpenShift 4, като облачна платформа, стои много подобна бизнес задача. Новите нодули трябва да бъдат създадени в момента на създаване на кластера, в случай на срив на един от възлите или при мащабиране на кластера. При създаване и инициализиране на нов възел съответните критични компоненти на хоста, включително CRI-O, трябва да бъдат конфигурирани. Както при всяка друга продукция, в началото е необходимо да се подаде „суровина“. В случая на корабите, суровината се състои от метал и дърво. Все пак, при създаването на хост за разгръщане на контейнери в кластера OpenShift 4, входът трябва да включва конфигурационни файлове и предоставени API сървъри. След това OpenShift ще осигури необходимото ниво на автоматизация през целия жизнен цикъл, предлагайки необходимата продуктова поддръжка за крайните потребители и така ще възстанови инвестициите в платформата.
OpenShift 4 е проектиран по такъв начин, че да осигури удобство при обновяване на системата през целия жизнен цикъл на платформата (за версии 4.X) за всички основни доставчици на облачни услуги, платформи за виртуализация и дори bare metal системи. За целта нодовете трябва да бъдат създадени въз основа на взаимозаменяеми елементи. Когато кластерът изисква нова версия на Kubernetes, той също така получава съответната версия на CRI-O на CoreOS. Тъй като версията на CRI-O е тясно свързана с Kubernetes, всичко това значително улеснява всякакви размени с цел тестване, отстраняване на неполадки или поддръжка. Освен това, такъв подход позволява да се намалят разходите за крайните потребители и Red Hat.
Това е принципно нов поглед върху Kubernetes клъстери, който поставя основите за планиране на нови изключително полезни и привлекателни функции. CRI-O (проект на отворен контейнер Container Runtime Interface — Open Container Initiative, съкратено CRI-OCI) е най-успешният избор за масово създаване на нодули, което е необходимо за работа с OpenShift. CRI-O ще замени предишния Docker двигател, предлагащ на потребителите на OpenShift – да, не сте се объркали – скучен контейнерен двигател, създаден специално за работа с Kubernetes.
Светът на откритите контейнери
Светът отдавна се движи към отворени контейнери. Независимо дали става въпрос за Kubernetes или на по-ниски нива, води до появата на екосистема от иновации на всеки етап.
Всичко започна с създаването на инициативата Open Containers Initiative . На този ранен етап бяха формулирани спецификациите на контейнерния и Това позволи да се гарантира, че инструментите могат да използват единен стандарт и единен формат за работа с тях. По-късно бяха добавени спецификациите което позволи на потребителите лесно да обменят .
След това общността на Kubernetes разработи единен стандарт за свързващ интерфейс (pluggable interface), наречен С това потребителите на Kubernetes могат да свързват различни енджини за работа с контейнери в допълнение към Docker.
Инженерите на Red Hat и Google видяха съществуващата на пазара нужда от контейнерен енджин, който да може да приема заявки от Kubelet по протокола CRI и представиха контейнери, съвместими с гореспоменатите спецификации на OCI. Така Но извинявайте, ние казахме, че този материал ще бъде посветен на CRI-O? Всъщност е точно така, просто с излизането на проектът беше преименуван на CRI-O.
Рис. 1.
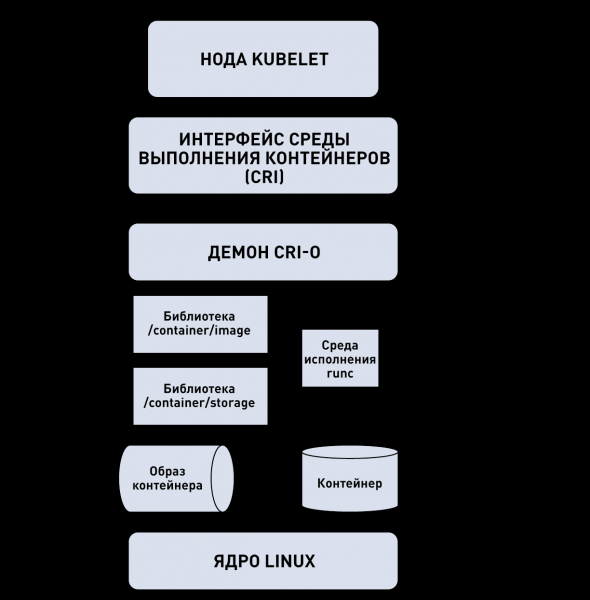
Иновации с CRI-O и CoreOS.
С пускането на платформата OpenShift 4, беше променен използван по подразбиране на платформата, и вместо Docker се появи CRI-O, който предлага икономична, стабилна, проста и скучна среда за стартиране на контейнери, развиваща се паралелно с Kubernetes. Това значително опростява поддръжката и конфигурирането на клъстера. Конфигурирането на контейнерния енджин и хоста, както и управлението им, става автоматизирано в рамките на OpenShift 4.
Стоп, какво?
Точно така, с появата на OpenShift 4, вече не е необходимо да се свързвате с отделни хостове и да инсталирате контейнерния енджин, да конфигурирате хранилището, да настройвате сървъри за търсене или да конфигурирате мрежата. Платформата OpenShift 4 беше напълно преработена за използване на не само по себе, а и по основни операции на нивото на платформата, като разгръщане на образи, конфигуриране на системата или инсталиране на актуализации.
Kubernetes винаги е позволявал на потребителите да управляват приложения, определяйки исканото състояние и използвайки , за да гарантира, че действителното състояние максимално отговаря на зададеното. Този открива големи възможности както от гледна точка на разработка, така и от гледна точка на операции. Разработчиците могат да определят изискваното състояние, на оператора под формата на YAML или JSON файл, след което операторът може да създаде в експлоатационната среда необходимия екземпляр на приложението, при което работното състояние на този екземпляр ще съответства на зададеното.
С помощта на оператори (Operators) в платформата, OpenShift 4 въвежда тази нова парадигма (чрез концепцията за зададено и действително състояние) в управлението на RHEL CoreOS и CRI-O. Задачите по конфигуриране и управление на версиите на операционната система и контейнерния двигател се автоматизират с помощта на така наречения . MCO значително опростява работата на администратора на клъстера, по същество автоматизирайки последните етапи на инсталацията, а също и последващите операции след инсталиране (day two operations). Всичко това прави OpenShift 4 истинска облачна платформа. Ще се спрем на това малко по-късно.
Стартиране на контейнери
Потребителите имаха възможност да използват движка CRI-O в платформата OpenShift от версия 3.7 в статус Tech Preview и от версия 3.9 в статус Generally Available (в момента се поддържа). Освен това Red Hat масово използва в OpenShift Online от версия 3.10. Всичко това позволи на екипа, работещ по CRI-O, да придобие огромен опит в масовото стартиране на контейнери на големи клъстери Kubernetes. За да получим основни представа за това как Kubernetes използва CRI-O, нека разгледаме следната илюстрация, на която е показан принципът на работа на архитектурата.
Рис. 2. Как работят контейнерите в клъстера Kubernetes
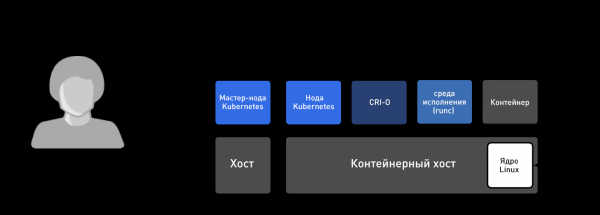
CRI-O опростява създаването на нови контейнерни хостове чрез синхронизация на целия горен слой при инициализация на нови нодове и при пускането на нови версии на платформата OpenShift. Прегледът на цялата платформа позволява извършването на транзакционни актуализации / обратно завъртания, както и предотвратява взаимни блокировки в зависимостите между ядрото на контейнерния хост, контейнерния двигател, нодовете (Kubelets) и майстор нода на Kubernetes. При централизирано управление на всички компоненти на платформата, с контрол и управление на версиите, е възможно винаги да се проследи ясен маршрут от състояние A до състояние B. Това опростява процеса на актуализации, повишава сигурността, подобрява отчетността по производителността и помага за намаляване на разходите за актуализации и инсталиране на нови версии.
Демонстрация на мощността на сменяеми елементи
Както беше споменато по-рано, използването на Machine Config Operator за управление на хостинга на контейнера и контейнерния двигател в OpenShift 4 предлага ново ниво на автоматизация, което не беше възможно на платформата Kubernetes преди. За да демонстрираме новите възможности, ще покажем как можете да направите промени в файла crio.conf. За да не се заплетете в терминологията, опитайте се да се концентрирате върху резултатите.
Първо, нека създадем това, което наричаме конфигурация на средата за изпълнение на контейнера – Container Runtime Config. Смятайте, че това е ресурс Kubernetes, който представлява конфигурация за CRI-O. Всъщност, това е специализирана версия на това, което наричаме MachineConfig, което представлява всяка конфигурация, разгръщана на машина RHEL CoreOS в рамките на кластера OpenShift.
Този персонализиран ресурс, наречен ContainerRuntimeConfig, е създаден, за да улесни настройката на CRI-O за администраторите на клъстера. Това е достатъчно мощен инструмент, който може да се прилага само на определени нодове в зависимост от настройките на MachineConfigPool. Смятайте го за група машини, които служат за една и съща цел.
Обърнете внимание на двата последни реда, които ще променим във файла /etc/crio/crio.conf. Тези два реда са много подобни на редовете в файла crio.conf, а именно:
vi ContainerRuntimeConfig.yaml
Извод:
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Сега ще изпратим този файл в Kubernetes кластера и ще проверим дали наистина е създаден. Имайте предвид, че операцията се извършва точно както с всеки друг ресурс на Kubernetes:
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Извод:
NAME              AGE
set-log-and-pid   22h
След като създадем ContainerRuntimeConfig, е необходимо да променим един от MachineConfigPools, за да информираме Kubernetes, че искаме да приложим тази конфигурация към определена група машини в кластера. В този случай ще променим MachineConfigPool за мастер възлите:
oc edit MachineConfigPool/master
Изход (основната същина е оставена за яснота):
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
В този момент MCO започва да създава нов файл crio.conf за кластера. В същото време напълно готовият файл с конфигурация може да се прегледа чрез Kubernetes API. Запомнете, ContainerRuntimeConfig е просто специализирана версия на MachineConfig, така че можем да видим резултата, като погледнем нужните редове в MachineConfigs:
oc get MachineConfigs | grep rendered
Извод:
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16h
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16h
Обърнете внимание, че полученият файл с конфигурации за мастер възлите е по-нова версия от изходните конфигурации. За да го прегледате, стартирайте следната команда. Като странична бележка, това може да е един от най-добрите едноредовите скриптове в историята на Kubernetes:
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Извод:
pids_limit = 2048
Сега да се уверим, че конфигурацията е приложена към всички мастер възли. Първо ще получим списък с възлите в кластера:
oc get node | grep master

Изход:

ip-10-0-135-153.us-east-2.compute.internal   Ready master 23h v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Ready master 23h v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Ready master 23h v1.12.4+509916ce1
Сега да прегледаме инсталирания файл. Ще видите, че файлът е актуализиран с новите стойности на директивите pid и debug, които посочихме в ресурса ContainerRuntimeConfig. Сама елегантност:
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid’
Извод:
...
pids_limit = 2048
...
log_level = "debug"
...
Всички тези промени в клъстера бяха направени дори без стартиране на SSH. Цялата работа беше извършена чрез обаждане до главния възел на Kubernetes. Тоест, тези нови параметри бяха конфигурирани само на главните възли. Работните възли не бяха променяни, което демонстрира предимствата на методологията Kubernetes с използване на зададени и актуални състояния относно хостовете на контейнери и контейнерни двигатели с взаимозаменяеми елементи.
По-горният пример показва възможността да се внасят промени в малък клъстер OpenShift Container Platform 4 с три работни възела или в огромен производствен клъстер с 3000 възела. Във всеки случай обемът на работата ще бъде същият – и много малък – просто трябва да настроите файла ContainerRuntimeConfig и да промените една етикета (label) в MachineConfigPool. И можете да направите това с всяка версия на използваната в Kubernetes платформа OpenShift Container Platform 4.X през целия й жизнен цикъл.
Често технологичните компании се развиват толкова бързо, че не можем да обясним защо избираме определени технологии за основните компоненти. Контейнерните двигатели исторически бяха компонентът, с който потребителите взаимодействат директно. Тъй като популярността на контейнерите закономерно започна с появата на контейнерни двигатели, потребителите често проявяват интерес към тях. Това е още една причина, поради която Red Hat избра CRI-O. Контейнерите се развиват, а днес основното внимание е насочено към оркестрация и достигнахме до заключението, че CRI-O осигурява най-доброто изживяване при работа с OpenShift 4.
Източник: habr.com
