

Все по-често получаваме запитвания от клиенти: „Искаме нещо като Amazon RDS, но по-евтино“; „Искаме нещо като RDS, но навсякъде, в всяка инфраструктура“. За да реализираме подобно управлявано решение в Kubernetes, разгледахме текущото състояние на най-популярните оператори за PostgreSQL (Stolon, оператори от Crunchy Data и Zalando) и направихме своя избор.
Тази статия е нашият опит, както от теоретична страна (преглед на решения), така и от практическа гледна точка (какво беше избрано и какво постигнахме). Но преди всичко нека да определим какви изисквания имаме към потенциалната замяна на RDS...
Какво е RDS
Когато хората говорят за RDS, от нашия опит те имат предвид управляван (managed) сервиз за СУБД, който:
- лесно се настройва;
- има възможност за работа със снимки и възстановяване от тях (предпочитано — с поддръжка на );
- позволява създаване на топологии master-slave;
- има богат списък от разширения;
- осигурява аудит и управление на потребители/достъпи.
Ако говорим общо, подходите за реализация на поставената задача могат да бъдат доста различни, обаче пътят с условния Ansible не ни привлича. (До същия извод стигнаха и колегите от 2GIS в резултат на да създадат „инструмент за бързо разгръщане на отказоустойчив кластер на базата на Postgres“.)
Операторите са общоприетият подход за решаване на подобни задачи в екосистемата Kubernetes. По-подробно за тях във връзка с базите данни, които се стартират вътре в Kubernetes, вече разказа техническият директор на „Фланта“ , в .
NB: За бързо създаване на прости оператори препоръчваме да се обърнете към нашия Open Source инструмент . Използвайки го, може да се прави без познания по Go, а по-привични за системните администратори начини: на Bash, Python и т.н.
За PostgreSQL съществуват няколко популярни K8s оператора:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Нека да ги погледнем по-внимателно.
Избор на оператор
Освен важните възможности, които вече бяха споменати, ние — като инженери по експлоатация на инфраструктура в Kubernetes — също очаквахме от операторите следното:
- деплой от Git и с ;
- поддръжка на pod anti-affinity;
- установяване на node affinity или node selector;
- установяване на tolerations;
- наличие на възможности за тюнинг;
- разбираеми технологии и дори команди.
Без да навлизам в детайли по всеки от пунктов (питайте в коментарите, ако остават въпроси по тях след прочитане на цялата статия), ще отбележа, че тези параметри са нужни за по-точно описание на специализацията на възлите в клъстера, така че да можем да ги поръчваме за конкретни приложения. Така можем да постигнем оптимален баланс между производителност и цена.
Сега — към самите оператори на PostgreSQL.
1. Stolon
от италианската компания Sorint.lab в беше разглеждан като един вид еталон сред операторите за СУБД. Това е доста стар проект: първият му публичен релиз е направен още през ноември 2015 година(!) и GitHub-репозиторият може да се похвали с почти 3000 звезди и над 40 контрибутори.
И наистина, Stolon е отличен пример за добре обмислена архитектура:
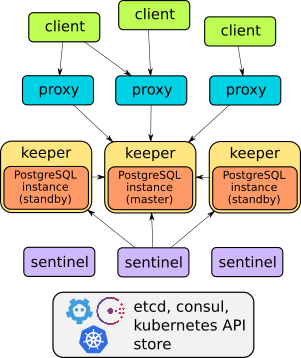
С устройството на този оператор в детайли можете да се запознаете в доклада или . Общо взето, достатъчно е да се каже, че той умее всичко описано: failover, прокси за прозрачен достъп на клиентите, резервни копия… Освен това прокситата предоставят достъп чрез един сервисен endpoint — за разлика от другите две решения, разгледани по-нататък (при тях има по два сервиса за достъп до базата).
Обаче при Stolon , поради което не може да бъде разположен по такъв начин, че просто и бързо — „като горещи пайове“ — да се създават екземпляри на СУБД в Kubernetes. Управлението се осъществява чрез утилита stolonctl, разгръщането — чрез Helm-chart, а потребителските определения се задават в ConfigMap.
От една страна, става така, че операторът не е точно оператор (все пак той не използва CRD). Но от друга страна — това е гъвкава система, която позволява настройка на ресурсите в K8s така, както на вас ви е удобно.
В обобщение, за нас не изглеждаше оптимално да създаваме отделен chart за всяка БД. Затова започнахме да търсим алтернативи.
2. Crunchy Data PostgreSQL Operator
, млад американски стартап, изглеждаше логична алтернатива. Неговата публична история започва с първия релиз през март 2017 година, оттогава GitHub-репозиторият е получил малко под 1300 звезди и над 50 контрибутори. Последният релиз от септември беше тестван за работа с Kubernetes 1.15—1.18, OpenShift 3.11+ и 4.4+, GKE и VMware Enterprise PKS 1.3+.
Архитектурата на Crunchy Data PostgreSQL Operator също отговаря на заявените изисквания:
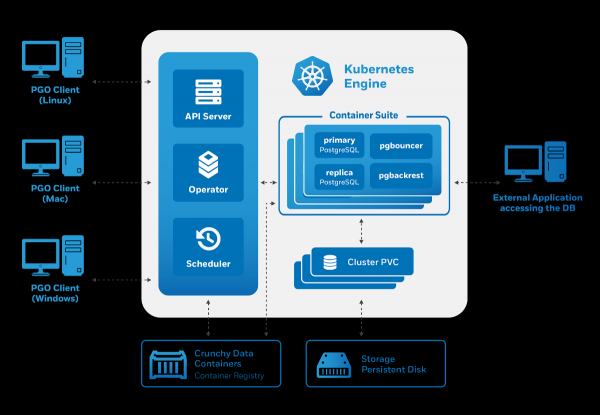
Управлението става чрез утилита pgo, но от друга страна, той генерира Custom Resources за Kubernetes. Затова операторът ни зарадва като потенциални потребители:
- има управление чрез CRD;
- удобно управление на потребители (също чрез CRD);
- интеграция с други компоненти — специализирана колекция от образи на контейнери за PostgreSQL и инструменти за работа с тях (включително pgBackRest, pgAudit, разширения от contrib и т.н.).
Въпреки това опитите да започнем да използваме оператора от Crunchy Data разкриха няколко проблема:
- Нямаше възможност за tolerations — предвиден беше само nodeSelector.
- Създадените pod’ове бяха част от Deployment, въпреки че разгръщахме stateful приложение. За разлика от StatefulSet, Deployment не може да създава дискове.
Последният недостатък води до забавни моменти: в тестовата среда успяхме да стартираме 3 реплики с един диск local storage, в резултат на което операторът съобщаваше, че 3 реплики работят (въпреки че не беше така).
Друг вариант на този оператор е готовата интеграция с различни помощни системи. Например, лесно се инсталират pgAdmin и pgBounce, а в се разглеждат предварително конфигурирани Grafana и Prometheus. В последния отделно се отбелязва подобрената интеграция с проекта , благодарение на което операторът предлага визуализация на метрики по PgSQL «из коробки».
Въпреки това странният избор на генерирани Kubernetes ресурси ни накара да потърсим друго решение.
3. Zalando Postgres Operator
Продуктите на Zalando са ни познати отдавна: имаме опит с Zalenium и, разбира се, сме опитвали — тяхното популярно HA решение за PostgreSQL. За подхода на компанията в създаването на разказва един от неговите автори — Алексей Клюкин — в ефира на , и той ни хареса.
Това е най-младото решение от разглежданите в статията: първият релиз беше през август 2018 година. Въпреки малкия брой формални релизи, проектът премина голямо развитие, вече надминавайки решението от Crunchy Data с 1300+ звезди в GitHub и максимален брой контрибутори (70+).
«Под капака» на този оператор се използват решения, проверени във времето:
- Patroni и за управление,
- — за бекъпи,
- — като пул на връзки.
Ето как е представена архитектурата на оператора от Zalando:
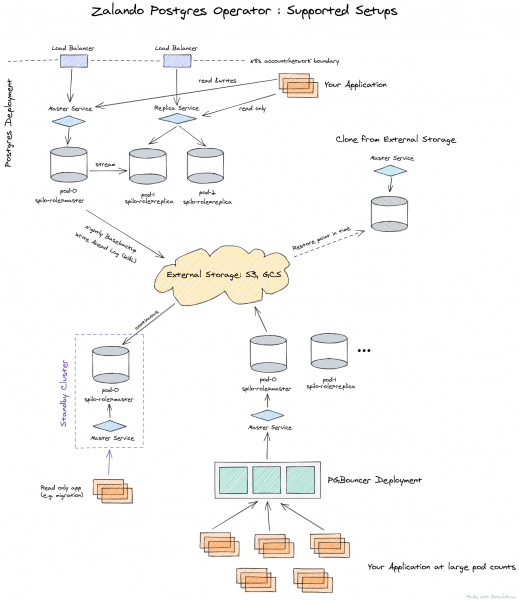
Операторът се управлява напълно чрез Custom Resources, автоматично създава StatefulSet от контейнери, които след това могат да бъдат персонализирани, като се добавят различни sidecar-и в pod-а. Всичко това е значителен плюс в сравнение с оператора от Crunchy Data.
Тъй като избрахме решението от Zalando сред 3 разглеждани опции, по-долу ще представим описанието на неговите възможности, веднага с практиката на приложение.
Практика с Postgres Operator от Zalando
Деплойването на оператора става много лесно: достатъчно е да изтеглите актуалната версия от GitHub и да приложите YAML файловете от директорията. . Като алтернатива, можете също да се възползвате от .
След инсталирането е важно да се погрижите за настройването на . Това става чрез ConfigMap postgres-operator в пространството с име, където сте инсталирали оператора. След настройване на хранилищата, можете да развернете първия кластер PostgreSQL.
Например, стандартното деплойване при нас изглежда по следния начин:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Този манифест деплойва кластер от 3 инстанции с sidecar под формата на , от който извличаме метрични данни за приложението. Както виждате, всичко е много лесно и при желание можете да направите буквално неограничен брой кластери.
Струва си да се обърне внимание и на веб-панела за администриране — . Той се предлага заедно с оператора и позволява създаване и изтриване на кластери, а също така работа с резервни копия, които прави операторът.
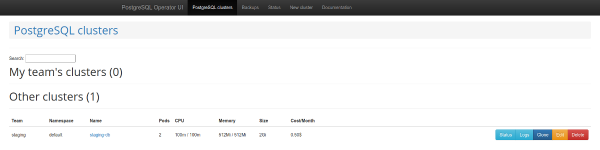
Списък на кластерите PostgreSQL
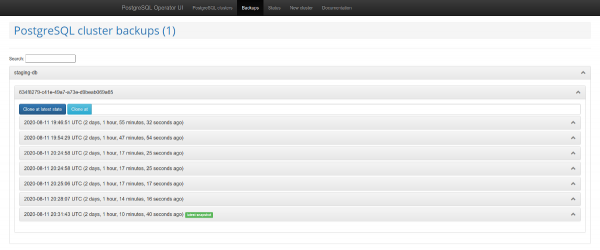
Управление на резервните копия
Друга интересна особеност е поддръжката на . Този механизъм автоматично създава роли в PostgreSQL, въз основа на получен списък от потребителски имена. След това API-то позволява да се върне списък на потребителите, за които автоматично се създават роли.
Проблеми и решения
Обаче, използването на оператора скоро разкри няколко значителни недостатъка:
- липса на поддръжка на nodeSelector;
- невъзможност да се изключат резервните копия;
- при използване на функцията за създаване на бази не се появяват привилегии по подразбиране;
- периодично липсва документация или тя е неактуална.
За щастие, много от тях могат да бъдат решени. Нека започнем в края — проблеми с документацията.
Скорее е възможно да срещнете ситуации, в които не е ясно как да зададете резервно копие и как да свържете резервния bucket към Operator UI. Това е споменато повърхностно в документацията, а реалното описание е в :
- трябва да направите секрет;
- да го предадете на оператора в параметър
pod_environment_secret_nameв CRD с настройките на оператора или в ConfigMap (в зависимост от начина, по който сте решили да инсталирате оператора).
Въпреки това, както се оказа, в момента това е невъзможно. Именно затова събрахме с някои допълнителни функции от трети страни. Подробности — вижте по-долу.
Ако предавате на оператора параметри за резервно копие, а именно — wal_s3_bucket и ключовете за достъп в AWS S3, то той ще архивира всичко: не само базите в продукция, но и staging. Това не ни устройваше.
В описанието на параметрите за Spilo, което представлява основната Docker обвивка за PgSQL при използване на оператора, се оказа: може да предадете параметър WAL_S3_BUCKET празен, с което да изключите резервните копия. Освен това, с голямо удоволствие открихме и , който веднага приехме в нашия fork. Сега е достатъчно просто да добавите enableWALArchiving: false в ресурса на кластера PostgreSQL.
Да, имаше възможност да се направи иначе, стартирайки 2 оператора: един за staging (без резервни копия), а вторият — за продукция. Но така успяхме да се справим с един.
Добре, научихме се да предаваме достъп до S3 за базите и резервните копия започнаха да попадат в хранилището. Как да накараме страниците за резервни копия да работят в Operator UI?
В Operator UI ще трябва да добавите 3 променливи:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
След това управлението на резервните копия ще стане достъпно, което в нашия случай ще опрости работата със staging, позволявайки да се прехвърлят моментни снимки от продукция без допълнителни скриптове.
Като още едно предимство се посочваше работата с Teams API и широките възможности за създаване на бази и роли чрез оператора. Въпреки това създадените роли не разполагаха с права по подразбиране. Съответно, потребител с права за четене не можеше да чете новите таблици.
Защо е така? Въпреки че в кода необходимите GRANT, те не се прилагат винаги. Има 2 метода: syncPreparedDatabases и syncDatabases. В syncPreparedDatabases — въпреки че в секцията preparedDatabases има условие defaultRoles и defaultUsers за създаване на роли, — правата по подразбиране не се прилагат. Работим по подготовката на пач, за да се прилагат автоматично тези права.
И последният момент в актуализациите, които ни интересуват — , добавящ Node Affinity в създадения StatefulSet. Нашите клиенти често предпочитат да намаляват разходите, използвайки spot инстанси, а на тях определено не е добре да се хостват бази данни. Този проблем можеше да се реши и чрез tolerations, но наличието на Node Affinity дава по-голяма сигурност.
Какво постигнахме?
В резултат на решаването на изброените проблеми, направихме форк на Postgres Operator от Zalando в , където той се компилира с толкова полезни пачове. А за допълнително удобство също направихме .
Списък с PR, приети в форка:
- ;
- ;
- ;
- .
Ще бъде страхотно, ако общността подкрепи тези PR, за да влязат в upstream с новата версия на оператора (1.6).
Бонус! История на успеха с миграцията на продукция
Ако използвате Patroni, е възможно да мигрирате жива продукция към оператора с минимално време за престой.
Spilo позволява създаването на standby-кластери чрез S3 хранилища с , когато бинарният лог PgSQL първо се съхранява в S3, а след това се извлича от репликата. Но какво да правим, ако имате не използван Wal-E в старата инфраструктура? Решението на този проблем вече на хабра.
На помощ идва логичната репликация на PostgreSQL. Но да не се вдаваме в детайли как да създаваме публикации и абонаменти, защото… нашият план не успя.
Работата е там, че в базата данни имаше няколко натоварени таблици с милиони редове, които постоянно се попълваха и изтриваха. с copy_data, когато новата реплика копира всичкото съдържание от майстора, просто не успяваше да навакса. Копирането на съдържанието работеше една седмица, но не успя да достигне майстора. В крайна сметка, справянето с проблема помогна на колеги от Avito: можете да прехвърлите данни, използвайки pg_dump. Ще опиша нашия (малко преработен) вариант на този алгоритъм.
Идеята е, че може да се направи деактивирана подписка, свързана с конкретен репликационен слот, и след това да се коригира номера на транзакцията. Имаше реплики за работа на продукция. Това е важно, защото репликата помага да се създаде консистентен dump и да продължи да получава промени от мастера.
В последващите команди, описващи процеса на миграция, ще се използват следните обозначения за хостовете:
- master — изходен сървър;
- replica1 — потокова реплика на стария продукционен сървър;
- replica2 — нова логическа реплика.
План на миграцията
1. Ще създадем на мастера подписка за всички таблици в схемата public база dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Ще създадем слот за репликация на мастера:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Ще спрем репликацията на старата реплика:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Ще получим номера на транзакцията от мастера:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Ще направим dump от старата реплика. Ще го направим в няколко потока, което ще ускори процеса:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Ще заредим dump на новия сървър:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. След зареждането на дампа можем да стартираме репликацията на потоковата реплика:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Ще създадем подписка на новата логическа реплика:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Ще получим oid подписката:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Да предположим, че е получен oid=1000. Ще приложим номера на транзакцията към подписката:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Ще стартираме репликацията:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Ще проверим статуса на подписката, репликацията трябва да работи:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. След като репликацията е стартирана и базите са синхронизирани, можем да предприемем превключване.
13. След спирането на репликацията трябва да коригираме последователностите. Това е добре описано .
Благодарение на този план, превключването премина с минимални забавяния.
Заключение
Операторите на Kubernetes улесняват различни действия, като ги свеждат до създаването на K8s-ресурси. Въпреки че с тях можете да постигнете забележителна автоматизация, трябва да помните, че тя носи и редица неочаквани нюанси, затова подхождайте с ум при избора на оператори.
След като разгледахме трите най-популярни Kubernetes оператора за PostgreSQL, избрахме проекта от Zalando. С него се сблъскахме с определени трудности, но резултатът наистина ни впечатли, така че планираме да разширим опита си и на някои други инсталации на PgSQL. Ако имате опит с подобни решения — ще се радваме да видим детайли в коментарите!
P.S.
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
