

Здравейте отново! Заглавието на статията говори само за себе си. В навечерието на старта на курса предлагаме да разберем кои са дата инженерите. В статията има много полезни връзки. Приятно четене.
Просто ръководство за това как да хванете вълната на Data Engineering и да не позволите тя да ви завлече в бездната.
Създава се впечатление, че напоследък всеки иска да стане дата учен (Data Scientist). Но какво ще стане с Data Engineering (инженеринг на данни)? По същество, това е нещо като хибрид между дата аналитик и дата учен; дата инженерът обикновено отговаря за управлението на работните процеси, конвейерите за обработка и ETL процесите.Поради важността на тези функции, това е поредният популярен професионален жаргон, който активно набира популярност.
Високата заплата и огромното търсене са само малка част от това, което прави тази работа изключително привлекателна! Ако желаете да се присъедините към редиците на героите, никога не е късно да започнете да учите. В този пост събрах цялата необходима информация, за да ви помогна да направите първите стъпки.
И така, да започнем!
Какво е Data Engineering?
Честно казано, няма по-добро обяснение от това:
„Учен може да открие нова звезда, но не може да я създаде. Той ще трябва да помоли инженера да го направи вместо него.“
–Гордон Линдсей Глегг
Следователно, ролята на дата инженера е доста важна.
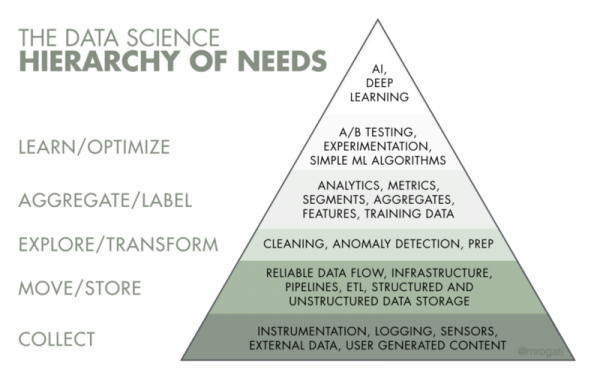
От името следва, че инженерията на данни е свързана с данни, а именно с тяхната доставка, съхранение и обработка. Съответно основната задача на инженерите е да осигурят надеждна инфраструктура за данни. Ако погледнем йерархията на нуждите на ИИ, инженерията на данни заема първите 2–3 етапа: събиране, прехвърляне и съхранение, подготовка на данните..
С какво се занимава дата инженерът?
С появата на големите данни сферата на отговорност рязко се промени. Ако преди тези експерти пишеха големи SQL запитвания и прехвърляха данни с помощта на инструменти като Informatica ETL, Pentaho ETL, Talend, сега изискванията към дата инженерите нараснаха.
Повечето компании с открити позиции за дата инженери предявяват следните изисквания:
- Отлично познаване на SQL и Python.
- Опит с облачни платформи, по-специално Amazon Web Services.
- Предпочитание се дава на знание по Java/Scala.
- Добро разбиране на SQL и NoSQL бази данни (моделиране на данни, съхранение на данни).
Имайте предвид, че това е само най-необходимото. От този списък може да се предполага, че дата-инженерите са специалисти в сферата на разработката на софтуер и бекенда.
Например, ако компанията започне да генерира голям обем данни от различни източници, вашата задача като дата-инженер е да организирате събирането на информацията, нейното обработване и съхранение.
Списъкът с инструментите, използвани в този случай, може да варира, всичко зависи от обема на тези данни, скоростта на тяхното поступление и хетерогенността. Повечето компании изобщо не се сблъскват с големи данни, затова като централизирано хранилище, т. нар. хранилище на данни, може да се използва SQL база данни (PostgreSQL, MySQL и т.н.) с малък набор от скриптове, които насочват данните към хранилището.
IT гиганти като Google, Amazon, Facebook или Dropbox имат по-високи изисквания: познания по Python, Java или Scala.
- Опит с големи данни: Hadoop, Spark, Kafka.
- Познавателни алгоритми и структури от данни.
- Разбиране на основите на разпределените системи.
- Опит с инструменти за визуализация на данни, като Tableau или ElasticSearch, ще бъде голям плюс.
Тоест наблюдава се очевидно изместване към големи данни, именно в тяхната обработка при високи натоварвания. Тези компании имат повишени изисквания за устойчивост на системата.
Дата-инженери срещу дата-саентисти
Добре, това беше просто и забавно сравнение (нищо лично), но всъщност всичко е много по-сложно.
На първо място, трябва да знаете, че съществува доста неяснота в разграничаването на ролите и уменията на дата-саентистите и дата-инженерите. Тоест, лесно можете да се затрудните в това, какви всъщност умения са необходими за успешен дата-инженер. Разбира се, има определени умения, които се припокриват между двете роли. Но също така съществува и цял набор от диаметрално противоположни умения.
Науката за данни е сериозно занимание, но ние се движим към свят с функционална дата саенс, където практикуващите могат да правят свои собствени анализи. За да задействате конвейери от данни и интегрирани структури от данни, ви трябват дата-инженери, а не учени.
Дали дата-инженерът е по-търсен от дата-саентиста?
— Да, защото преди да можете да приготвите морковен пай, първо трябва да съберете, почистите и подготвите морковите!
Дата-инженерът разбира от програмиране по-добре, отколкото всеки дата-сайентист, но когато става въпрос за статистика, всичко е точно обратно.
Но ето предимството на дата-инженера:
без него/нея стойността на модел-прототип, състоящ се най-често от фрагмент от код с ужасно качество в Python файл, получен от дата-сайентист и по някакъв начин даващ резултат, стреми към нула.
Без дата-инженер този код никога няма да стане проект и никакъв бизнес-проблем няма да бъде ефективно решен. Инженерът по данни се опитва да превърне всичко това в продукт.
Основни знания, които трябва да знае дата-инженерът
Така че, ако тази работа пробужда в вас светлина и сте пълни с ентусиазъм — вие можете да се научите на това, можете да усвоите всички необходими умения и да станете истинска рок-звезда в областта на разработката на данни. И, да, можете да постигнете това дори без умения за програмиране или други технически знания. Трудно е, но възможно!
Какви са първите стъпки?
Трябва да имате общо разбиране за това, какво е какво.
Първо, Дата Инженерството се отнася до компютърните науки. Конкретно — трябва да разбирате ефективни алгоритми и структури от данни. На второ място, тъй като дата-инженерите работят с данни, необходимо е разбиране на принципите на работа на бази данни и структурите, стоящи зад тях.
Например, обикновените B-tree SQL бази данни се основават на структурата от данни B-Tree, както и в съвременни разпределени хранилища, LSM-Tree и други модификации на хеш-таблици.
* Тези стъпки са основани на великолепна статия . И така, ако знаете руски, подкрепете този автор и прочетете .
1. Алгоритми и структури от данни
Използването на правилната структура от данни може значително да подобри производителността на алгоритъма. В идеалния случай, всички ние трябва да изучаваме структури от данни и алгоритми в училище, но това рядко се обсъжда. Във всеки случай, никога не е късно да се запознаем.
И така, ето моите любими безплатни курсове за изучаване на структури от данни и алгоритми:
Не забравяйте за класическата книга на алгоритмите на Томас Кормен — . Това е перфектен справочник, когато трябва да освежите паметта си.
- За да подобрите уменията си, използвайте .
Можете също така да се потопите в света на базите данни с чудесни видеа от Университета на Карнеги Мелън в Youtube:
- .
- .
2. Изучаване на SQL
Целият ни живот — това са данни. За да извлечете тези данни от базата данни, трябва да „говорите“ с тях на един и същи език.
SQL (Structured Query Language — език за структурирани запитвания) е езикът за комуникация в областта на данните. Каквото и да казват хората, SQL съществува, съществува и ще съществува много дълго време.
Ако от дълго време сте в разработката, вероятно сте забелязали, че слуховете за близката смърт на SQL периодично се появяват. Езикът е разработен в началото на 70-те години и все още е изключително популярен сред анализаторите, разработчиците и просто ентусиастите.
Без знанието на SQL в инженерството на данни не можете да направите много, тъй като неизбежно ще трябва да пишете запитвания за извличане на данни. Всички съвременни системи за големи данни поддържат SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… и много други.
За анализа на големи обеми данни, съхранявани в разпределени системи, като HDFS, са изобретени SQL механизми: Apache Hive, Impala и т.н. Виждате ли, той няма да изчезне.
Как да научите SQL? Просто го правете на практика.
За целта бих препоръчал да се запознаете с отличен учебник, който, между другото, е безплатен, от .
Отличителната черта на тези курсове е наличието на интерактивна среда, в която можете да пишете и изпълнявате SQL заявки директно в браузъра. Ресурсът няма да е излишен. И можете да приложите тези знания в в раздела за Бази данни.
3. Програмиране на Python и Java/Scala
Защо да учите езика за програмиране Python, вече написах в статията . Що се отнася до Java и Scala, повечето инструменти за съхранение и обработка на огромни обеми данни са написани на тези езици. Например:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
За да разберете как работят тези инструменти, трябва да знаете езиците, на които са написани. Функционалният подход на Scala позволява ефективно решаване на проблеми с паралелна обработка на данни. Python, за съжаление, не може да се похвали със скорост и паралелна обработка. Общо взето, знанието на няколко езика и парадигми за програмиране оказва положително влияние върху разнообразието от подходи за решаване на проблеми.
За да се потопите в езика Scala, можете да прочетете от автора на езика. Освен това, компанията Twitter публикува добро въведение — .
Що се отнася до Python, аз смятам за най-добрата книга на средно ниво.
4. Инструменти за работа с големи данни
Ето списък на най-популярните инструменти в света на големите данни:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Повече информация за изграждането на големи блокове данни можете да намерите в тази удивителна . Най-популярните инструменти са Spark и Kafka. Определено си струва да ги проучите, за предпочитане да разберете как работят от вътре. Jay Kreps (съавтор на Kafka) публикува монументална работа през 2013 година , между другото, основните идеи от този труд бяха използвани за създаването на Apache Kafka.
- Введението в Hadoop може да бъде .
- Най-пълното ръководство за Apache Spark за мен е .
5. Облачни платформи
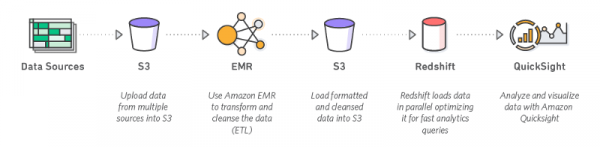
Знанието поне на една облачна платформа е част от основните изисквания за кандидатите за длъжността дата-инженер. Работодателите предпочитат Amazon Web Services, след тях е облачната платформа на Google, а тройката завършва с Microsoft Azure.
Трябва да се ориентирате добре в Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Разпределени системи
Работата с големи данни предполага наличие на клъстери от независимо работещи компютри, свързани помежду си чрез мрежа. Колкото по-голям е клъстърът, толкова по-голяма е вероятността за отказ на членовете му. За да станете страхотен експерт в областта на данните, трябва да се задълбочите в проблемите и съществуващите решения на разпределените системи. Тази област е стара и сложна.
Ендрю Таненбаум е считан за пионер в тази област. За тези, които не се страхуват от теория, препоръчвам неговата книга , за начинаещите може да изглежда сложна, но наистина ще ви помогне да усъвършенствате уменията си.
Смятам за най-добрата въведение в темата. Между другото, Мартин има невероятен . Неговата работа ще помогне да систематизирате знанията за изграждане на съвременна инфраструктура за съхранение и обработка на големи данни.
За тези, които обичат да гледат видеа, в YouTube има курс .
7. Даннини конвейери
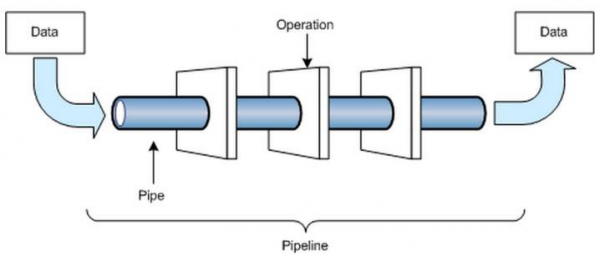
Даннините конвейери са нещо, без което не можете да живеете като инженер по данни.
По-голямата част от времето инженерът по данни изгражда така наречената данна пайплайн, т.е. създава процес за доставка на данни от едно място на друго. Това могат да бъдат потребителски сценарии, които водят до API на външна услуга или правят SQL запитвания, допълват данните и ги поставят в централизирано хранилище (хранилище на данни) или хранилище на неструктурирани данни (езера на данни).
В заключение: основният контролен списък на инженера по данни
Обобщавайки - необходимо е добро разбиране на следното:
- Информационни системи;
- Разработка на софтуер (Agile, DevOps, Техники на проектиране, SOA);
- Разпределени системи и паралелно програмиране;
- Основи на базите данни - планиране, проектиране, експлоатация и отстраняване на неизправности;
- Проектиране на експерименти - A/B тестове за доказване на концепции, определяне на надеждността, производителността на системите, както и за разработване на надеждни пътища за оперативно предоставяне на добри решения.
Това са само някои изисквания, за да станете инженер по данни, така че проучете и разберете системите за данни, информационните системи, непрекъснатото доставяне/разгръщане/интеграция, езиците за програмиране и други теми от информатиката (не във всички предметни области).
И накрая, последното, но много важно, което искам да кажа.
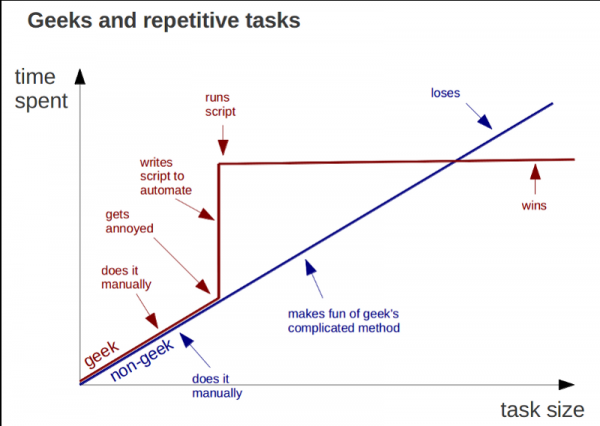
Пътят на Data Engineering не е толкова лесен, колкото изглежда. Той не прощава, предизвиква и трябва да сте готови за това. Някои моменти в това пътуване могат да ви накарат да се откажете. Но това е истински труд и процес на обучение.
Просто не го прелестявайте от самото начало. Целта на пътуването е да научите колкото се може повече и да сте готови за нови предизвикателства.
Ето една отлична картинка, с която се сблъсках, и която добре илюстрира този момент:
И да, не забравяйте да избягвате професионалното прегаряне и да почивате. Това също е много важно. Успех!
Как ви се струва статията, приятели? Каним ви на , което ще се проведе днес в 20:00. В рамките на уебинара ще обсъдим как да изградим ефективна и мащабируема система за обработка на данни за малка компания или стартап с минимални разходи. Като част от практиката ще се запознаем с инструментите за обработка на данни на Google Cloud. До скоро!
Източник: habr.com
