

Типично условие за реализация на CI/CD в Kubernetes: приложението трябва да е в състояние да спре приемането на нови клиентски заявки преди пълното спиране и, най-важното, успешно да завърши вече съществуващите.
Спазването на такова условие позволява да се достигне нулево време на престой по време на деплой. Въпреки това, дори при използването на много популярни комбинации (като NGINX и PHP-FPM), може да се срещнат трудности, които водят до увеличаване на грешките при всеки деплой…
Теория. Как живее pod
Подробно за жизнения цикъл на pod’а вече сме публикували. . В контекста на разглежданата тема ни интересува следното: в момента, когато pod преминава в състояние Terminating, към него спират да се изпращат нови заявки (pod из списъка с endpoints за услугата). По този начин, за да се избегне престой по време на деплой, от наша страна е достатъчно да решим проблема с коректното спиране на приложението.
Също така трябва да помните, че grace period по подразбиране е : след това pod ще бъде терминиран и приложението трябва да успее да обработи всички заявки в този период. Забележка: въпреки че всяка заявка, която се изпълнява повече от 5-10 секунди, вече е проблемна, а graceful shutdown не може да помогне…
За да разберем по-добре какво се случва, когато pod завършва работата си, е достатъчно да изучим следната схема:
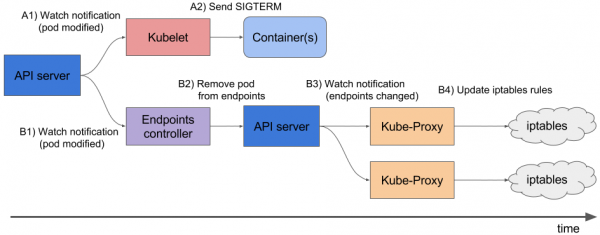
A1, B1 — Получаване на промени за състоянието на pod-а
A2 — Изпращане на SIGTERM
B2 — Премахване на pod-а от endpoints
B3 — Получаване на промени (променен списък на endpoints)
B4 — Актуализиране на правилата в iptables
Обърнете внимание: премахването на endpoint pod-а и изпращането на SIGTERM не се случват последователно, а паралелно. А поради факта, че Ingress получава актуализиран списък с Endpoints не веднага, към pod-ът ще се изпращат нови заявки от клиенти, което ще доведе до 500 грешки по време на терминирането на pod-а. (по-подробен материал по този въпрос сме ). Нужно е да решим този проблем по следните начини:
- Изпращайте в заглавките на отговора Connection: close (ако става въпрос за HTTP приложение).
- Ако няма възможност да правите промени в кода, то в статията по-долу е описано решение, което ще позволи да се обработят заявките до края на grace period.
Теория. Как NGINX и PHP-FPM завършват своите процеси.
NGINX
Нека започнем с NGINX, защото с него всичко е по-очевидно. Потопявайки се в теорията, ще разберем, че NGINX има един главен процес и няколко "работници" — това са дъщерни процеси, които обработват клиентските заявки. Предвидена е удобна възможност: чрез командата nginx -s да се завършат процесите или в режим на бързо приключване, или в режим на грациозно приключване. Очевидно е, че ни интересува именно последният вариант.
Нататък е всичко просто: трябва да добавим в командата, която ще изпрати сигнал за грациозно приключване. Това може да се направи в Deployment, в блока на контейнера:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Сега в момента на приключване на работата на pod-a в логовете на контейнера NGINX ще видим следното:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
И това ще означава точно това, от което се нуждаем: NGINX очаква приключването на изпълнението на заявките, след което убива процеса. Впрочем, по-долу ще бъде разгледан един разпространен проблем, поради който дори при наличието на командата nginx -s quit процесът завършва неправилно.
На този етап приключихме с NGINX: поне по логовете можем да разберем, че всичко работи така, както трябва.
Как стоят нещата с PHP-FPM? Как обработва то грациозното приключване? Нека разберем.
PHP-FPM
В случая с PHP-FPM информацията е малко по-малко. Ако се насочим към по PHP-FPM, в него ще бъде разказано, че се приемат следните POSIX сигнали:
-
SIGINT,SIGTERM— бързо приключване; -
SIGQUIT— грациозно приключване (това, което ни трябва).
Останалите сигнали не са нужни за тази задача, затова тяхното разглеждане пропускаме. За коректно приключване на процеса ще е необходимо да напишем следния preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
На пръв поглед, това е всичко, което е необходимо за изпълнението на грациозно приключване в двата контейнера. Въпреки това, задачата е по-сложна, отколкото изглежда. Следват два случая, при които грациозното приключване не работеше и предизвикваше краткотрайна недостъпност на проекта по време на деплоя.
Практика. Възможни проблеми с грациозното приключване
NGINX
На първо място е полезно да запомните: освен изпълнението на командата nginx -s quit има още една стъпка, на която трябва да обърнем внимание. Срещали сме проблем, при който NGINX вместо сигнала SIGQUIT все пак изпраща SIGTERM, поради което заявките не завършват коректно. Подобни случаи могат да се открият, например, . За съжаление, конкретната причина за такова поведение не успяхме да установим: имаше подозрения за версиите на NGINX, но те не се потвърдиха. Симптомите се състоят в това, че в логовете на контейнера NGINX се наблюдават съобщения «open socket #10 left in connection 5», след което pod-ът се спира.
Можем да наблюдаваме такъв проблем, например, по отговорите на необходимия ни Ingress:
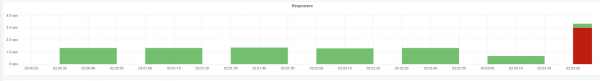
Показателите за статус-кодовете по време на деплоя
В този случай получаваме точно 503 код на грешка от самия Ingress: той не може да се свърже с контейнера NGINX, тъй като той вече не е наличен. Ако погледнем в логовете на контейнера с NGINX, в тях — следното:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
След промяната на стоп-сигнала контейнерът започва да се спира коректно: това се потвърдява от факта, че повече не наблюдаваме 503 грешка.
Ако сте се сблъскали с подобен проблем, има смисъл да разберете какъв стоп-сигнал се използва в контейнера и как изглежда preStop-хукът. Възможно е причината да е точно в това.
PHP-FPM… и не само
Проблемът с PHP-FPM се описва тривиално: той не изчаква завършването на дечицата си, а ги терминира, поради което се получават 502 грешки по време на деплоя и други операции. На bugs.php.net от 2005 година има няколко съобщения за грешки (например, и ), в които е описан този проблем. А в логовете вероятно няма да видите нищо: PHP-FPM ще обяви завършването на своя процес без никакви грешки или чужди уведомления.
Струва си да уточним, че самият проблем може в по-малка или по-голяма степен да зависи от самото приложение и да не се проявява, например, в мониторинга. Ако все пак се сблъскате с него, то наум първо идва простото решение: да добавите preStop-хук с sleep(30). Той ще позволи да завършите всички заявки, които са били до този момент (а нови не приемаме, тъй като pod-ът е в състояние вече ), а след изтичане на 30 секунди самият pod ще се завърши със сигнал Terminatinglifecycle SIGTERM.
Следователно за контейнера ще изглежда следния начин: lifecycle: preStop: exec: command: - /bin/sleep - "30"
Но, поради указанието за 30-секунден силно sleep използваме силно увеличим времето за внедряване, тъй като всеки pod ще бъде прекратен минимум 30 секунди, което е лошо. Какво можем да направим по този въпрос?
Нека се обърнем към страната, която отговаря за непосредственото изпълнение на приложението. В нашия случай това е PHP-FPM, който по подразбиране не следи изпълнението на своите child-процеси: главният процес се прекратява незабавно. Може да промените това поведение с помощта на директивата process_control_timeout, която указва времеви ограничения за изчакване на сигнали от главния процес от дочерните процеси. Ако зададете стойност от 20 секунди, това ще покрие повечето заявки, изпълнявани в контейнера, и след тяхното изпълнение главният процес ще бъде спрен.
С това знание, нека се върнем към нашия последен проблем. Както беше споменато, Kubernetes не е монолитна платформа: за взаимодействието между различните ѝ компоненти е необходимо известно време. Това е особено актуално, когато разглеждаме работата на Ingress и други свързани компоненти, тъй като поради такава забавяне в момента на внедряване лесно може да възникне вълна от 500-ки грешки. Например, грешка може да се появи на етапа на изпращане на заявка към upstream, но самото „временно забавяне“ на взаимодействието между компонентите е наистина кратко — под секунда.
Ето защо, в съвкупност с вече споменатата директива process_control_timeout може да използвате следната конструкция за за контейнера ще изглежда следния начин::
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
В такъв случай компенсираме забавянето с командата sleep и не увеличаваме значително времето за внедряване: все пак има видима разлика между 30 секунди и една?.. По същество "основната работа" всъщност поема именно process_control_timeout, а за контейнера ще изглежда следния начин: се използва само като "осигуровка" в случай на забавяне.
Честно казано, описаното поведение и съответният workaround касаят не само PHP-FPM. Подобна ситуация може по един или друг начин да възникне и при използване на други езици за програмиране/фреймворци. Ако не успеете да коригирате graceful shutdown с други методи — например, да пренапишете кода, така че приложението коректно да обработва сигнали за завършване — можете да приложите описания начин. Нека не е най-красивият, но работи.
Практика. Нагрузочно тестване за проверка на работата на pod-а
Натоварващото тестване е един от начините за проверка на работата на контейнера, тъй като тази процедура приближава до реални бойни условия, когато потребителите влизат в сайта. За тестване на посочените по-горе препоръки можете да използвате : той отлично покрива всичките ни нужди. По-долу са представени съвети и рекомендации за провеждане на тестове с демонстративен — благодарение на графиките в Grafana и самия Яндекс.Танк — пример от нашия опит.
Най-важното тук е да проверявате промените на етапи. След добавяне на ново коригиране стартирайте тестването и наблюдавайте, дали резултатите са се променили в сравнение с предишното стартиране. В противен случай ще бъде трудно да се открият неефективни решения, а в перспектива може дори да навредите (например, да увеличите времето за деплой).
Друг нюанс — наблюдавайте логовете на контейнера по време на неговото терминално състояние. Записва ли се там информация за graceful shutdown? Има ли в логовете грешки при свръзка с други ресурси (например, със съседния контейнер PHP-FPM)? Грешки на самото приложение (както в описания по-горе случай с NGINX)? Надявам се, че въведената информация от тази статия ще помогне да разберете по-добре какво се случва с контейнера по време на неговото терминално състояние.
И така, първото стартиране на тестовете се проведе без за контейнера ще изглежда следния начин: и без допълнителни директиви за сървъра на приложенията (process_control_timeout в PHP-FPM). Целта на този тест беше да се установи приблизителното количество грешки (и дали изобщо има такива). Също така, от допълнителната информация трябва да се знае, че средното време за деплой на всеки pod е било около 5-10 секунди до състояние на пълна готовност. Резултатите са следните:
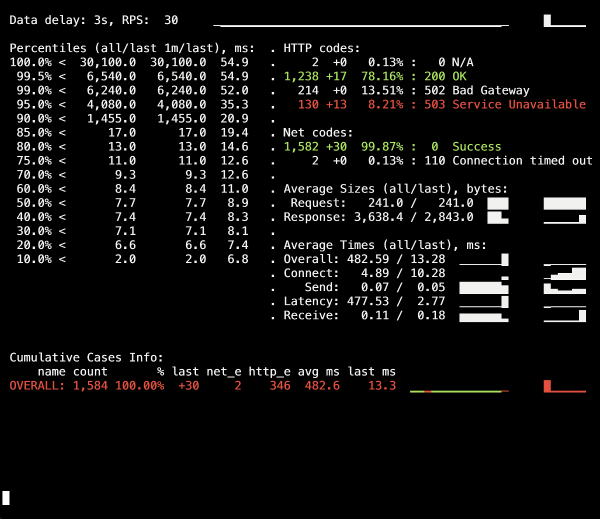
На информационната табло на Яндекс.Танк е видима вълна от 502 грешки, която се е случила в момента на деплой и е продължила средно до 5 секунди. Предполагаемо, това са били прекъснатите съществуващи запитвания към стария pod, когато той е бил терминал. След това са се появили 503 грешки, което е резултат от спряния контейнер NGINX, който също е прекъснал връзките поради бекенда (защо не е могъл да се свърже с Ingress).
Нека видим как process_control_timeout в PHP-FPM ще ни помогне да изчакаме завършването на child-процесите, т.е. да поправим такива грешки. Повторен деплой вече с използване на тази директива:
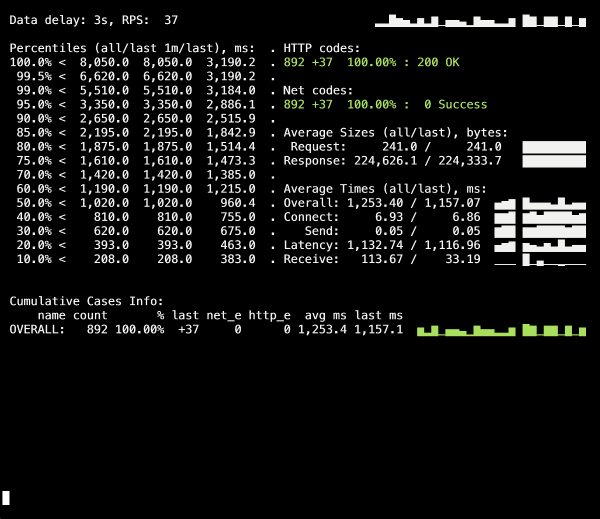
По време на деплоя 500-те грешки повече не съществуват! Деплойът преминава успешно, graceful shutdown работи.
Но е важно да си спомним момент с Ingress контейнерите, малък процент грешки, които можем да получим поради временно забавяне. За да ги избегнем, остава да добавим конструкция с sleep и да повторим деплоя. Впрочем, в нашия конкретен случай не се наблюдаваха промени (грешки отново няма).
Заключение
За коректно приключване на процеса очакваме от приложението следното поведение:
- Да изчака няколко секунди, след което да спре да приема нови връзки.
- Да изчака завършването на всички заявки и да затвори всички keepalive връзки, които не обработват заявки.
- Да приключи своя процес.
Но не всички приложения умеят да работят по този начин. Едно от решенията на проблема в контекста на Kubernetes е:
- добавяне на pre-stop hook, който ще изчака няколко секунди;
- изучаване на конфигурационния файл на нашия бекенд за съответните параметри.
Примерът с NGINX показва, че дори приложението, което първоначално трябва да обработва сигналите за приключване коректно, може да не го прави, затова е критично да проверяваме наличието на 500 грешки по време на деплоя на приложението. Това също позволява да се види проблема по-широко и да не се концентрираме върху отделен pod или контейнер, а да наблюдаваме цялата инфраструктура в цялост.
Като инструмент за тестване може да се използва Yandex.Tank заедно с всяка система за мониторинг (в нашия случай за теста бяха взети данни от Grafana с бекенд под формата на Prometheus). Проблемите с graceful shutdown са добре видими при големи натоварвания, които може да генерира бенчмарк, а мониторингът помага по-подробно да разберем ситуацията по време или след теста.
Отговаряйки на обратната връзка по статията: трябва да се уточни, че проблемите и начините за тяхното решаване тук са описани по отношение на NGINX Ingress. За други случаи има и други решения, които, вероятно, ще разгледаме в следващите материали от цикъла.
P.S.
Друго от цикъла K8s tips & tricks:
- «»;
- «»;
- «»;
- «».
Източник: habr.com
