

Източник:
Линейната регресия е един от основните алгоритми в много области, свързани с анализа на данни. Причината за това е очевидна. Това е много прост и разбираем алгоритъм, което допринася за широкото му приложение през десетилетия, ако не и стотици години. Идеята е, че предполагаме линейна зависимост на една променлива от набор от други променливи, а после се опитваме да възстановим тази зависимост.
Но в тази статия няма да разглеждаме приложението на линейната регресия за решаване на практически задачи. Тук ще бъдат обсъдени интересни особености на реализацията на разпределени алгоритми за нейното възстановяване, с които се сблъскахме при написването на модула за машинно обучение в . Някои основи на математиката, основите на машинното обучение и разпределените изчисления ще помогнат да разберем как да възстановим линейната регресия, дори когато данните са разпределени между хиляди възли.
За какво става въпрос?
Пред нас стои задачата за възстановяване на линейната зависимост. Като входни данни получаваме множество вектори на предположително независими променливи, на които всяка отговаря на определена стойност на зависимата променлива. Тези данни могат да бъдат представени под формата на две матрици:

Сега, след като се предполага зависимост и то линейна, нека запишем нашето предположение под формата на произведение на матрици (за опростяване на записките тук и по-долу се предполага, че свободният член на уравнението е скрит зад  , а последната колона на матрицата
 съдържа единици):

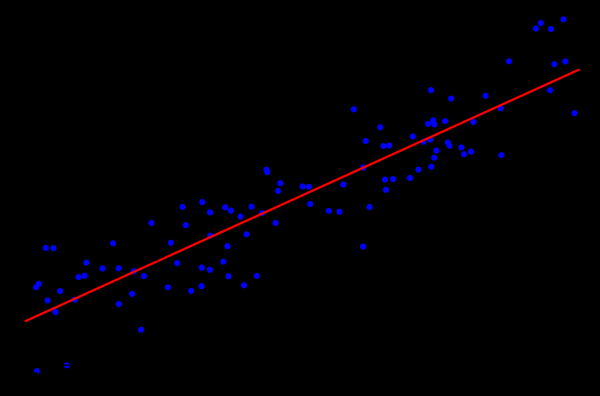
Много прилича на система от линейни уравнения, нали? Прилича, но решения за такава система от уравнения вероятно няма да има. Причината за това е шумът, който присъства практически във всички реални данни. Също така причината може да бъде отсъствието на линейна зависимост като такава, с която може да се опитаме да се борим, въвеждайки допълнителни променливи, нелинейно зависими от основните. Нека разгледаме следния пример:
Източник:
Това е прост пример на линейната регресия, който показва зависимостта на една променлива (по ос  ) от друга променлива (по ос
 ). За да има решение на съответстващата на този пример система от линейни уравнения, всички точки трябва да лежат точно на една права. Но това не е така. А не лежат на една права именно поради шума (или заради факта, че предположението за наличие на линейна зависимост е било грешно). Така че, за да възстановим линейната зависимост от реалните данни, обикновено е необходимо да въведем още едно предположение: входните данни съдържат шум и този шум има . Може да се правят предположения и за други типове разпределение на шума, но в подавляващото мнозинство случаи се разглежда именно нормалното разпределение, за което по-нататък и ще стане дума.
Метод на максималната вероятност
И така, предположихме наличие на случайно нормално разпределен шум. Какво да правим в такава ситуация? За този случай в математиката съществува и се използва широко . Накратко, същността му се състои в избора на и последващото й максимизиране.
Връщаме се към възстановяването на линейната зависимост от данни с нормален шум. Забележете, че предполагаемата линейна зависимост е математическото очакване  на наличното нормално разпределение. В същото време, вероятността, че
 приема определено значение, при условие наличие на наблюдаеми
 , изглежда по следния начин:

Сега вместо  и
 нужните ни променливи:

Остава само да намерим вектора  , при който тази вероятност е максимална. За да максимизираме такава функция, удобно е първо да я логаритмираме (логаритъмът на функцията ще достига максимум в същата точка, в която и самата функция):

Което, от своя страна, се свежда до минимизиране на следната функция:

Между другото, това се нарича метод на . Често всички горепосочени разсъждения се пропускат и просто се използва този метод.
QR разлагане
Минимумът на гореспоменатата функция може да бъде намерен, ако намерим точката, в която градиентът на тази функция е равен на нула. А градиентът ще бъде записан по следния начин:

е матричен метод за решаване на задача за минимизация, използван в метода на най-малките квадрати. Във връзка с това да напишем уравнението в матрична форма:

И така, разлагаме матрицата  на матрици
 и
 и извършваме поредица от преобразувания (самият алгоритъм за QR разлагане няма да се разглежда тук, само неговото приложение в контекста на поставената задача):

Матрицата  е ортогонална. Това ни позволява да се отървем от произведението
 :

А ако заменим  на
 , то ще получим
 . Имайки предвид, че
 е горна треугълна матрица, изглежда по следния начин:

Може да се реши с метода на подстановката. Елементът  се намира като
 , предишният елемент
 се намира като
 и така нататък.
Тук трябва да отбележим, че сложността на получения алгоритъм благодарение на използването на QR разлагане е равна на  . Въпреки че операцията по умножение на матрици се разпаралелизира добре, написването на ефективна разпределена версия на този алгоритъм не представлява възможност.
Градиентен спуск
Говорейки за минимизиране на определена функция, винаги трябва да се споменава методът на (стохастичния) градиентен спуск. Това е прост и ефективен метод за минимизиране, основан на итеративното изчисление на градиента на функцията в точка и последващото му изместване в посока, противоположна на градиента. Всеки такъв стъпка приближава решението към минимума. Градиентът при това изглежда също така:

Този метод също така добре се разпаралелизира и разпределя благодарение на линейните свойства на градиентния оператор. Забележете, че в приведената по-горе формула под знака на сумата присъстват независими членове. С други думи, можем да изчислим градиента независимо за всички индекси  от първия до
 , паралелно с това да изчислим градиента за индексите от
 до
 . След това да съберем получените градиенти. Резултатът от събирането ще бъде такъв, какъвто би бил, ако сме изчислили веднага градиента за индексите от първия до
 . Така че, ако данните са разпределени между няколко части от данни, градиентът може да бъде изчислен независимо на всяка част, а след това резултатите от тези изчисления могат да бъдат сумирани за получаване на окончателния резултат:

От гледна точка на реализацията, това попада в парадигмата . На всяка стъпка на градиентния спуск на всеки възел данни се изпраща задача за изчисление на градиента, след това изчислените градиенти се събират заедно и резултатът от тяхното сумиране се използва за подобряване на резултата.
Въпреки простотата на изпълнението и възможността за работа в парадигмата MapReduce, градиентното спускане има и свои недостатъци. По-специално, броят на стъпките, необходими за постигане на свиване, е значително по-голям в сравнение с други по-специализирани методи.
LSQR
— още един метод за решаване на поставената задача, който е подходящ както за възстановяване на линейна регресия, така и за решаване на системи от линейни уравнения. Основната му характеристика е, че комбинира предимствата на матричните методи и итеративния подход. Реализация на този метод може да се намери в библиотеката , така и в . Описание на този метод няма да бъде предоставено (може да бъде намерено в статията ). Вместо това ще бъде демонстриран подход, който позволява адаптиране на LSQR за работа в разпределена среда.
В основата на метода LSQR лежи . Това е итеративна процедура, всяка итерация от която се състои от следните стъпки:
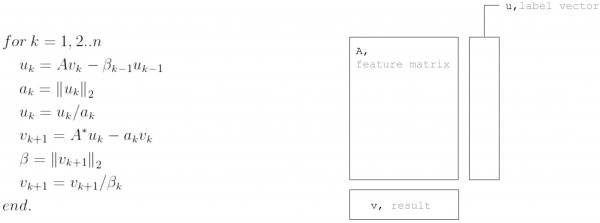
Но ако приемем, че матрицата  е хоризонтално партиционирана, всяка итерация може да бъде представена под формата на две стъпки MapReduce. По този начин успяваме да минимизираме прехвърлянето на данни по време на всяка от итерациите (само вектори с дължина, равна на броя на неизвестните):
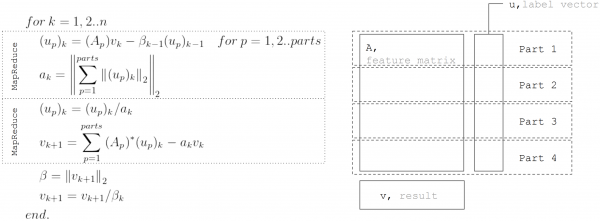
Този подход се използва при реализиране на линейна регресия в .
Заключение
Съществуват много алгоритми за възстановяване на линейна регресия, но не всички могат да бъдат прилагани при всякакви условия. Например QR разлагането е отлично за точно решение на малки масиви от данни. Градиентното спускане е лесно за реализиране и позволява бързо намиране на приблизително решение. А LSQR комбинира най-добрите свойства на предишните два алгоритма, тъй като може да бъде разпределен, по-бързо се свива в сравнение с градиентното спускане и позволява ранно спиране на алгоритма в контекста на QR-разлагането за търсене на приблизително решение.
Източник: habr.com
