

Разшифровка на доклад от 2015 година на Илия Космодемянски "Linux настройка за подобряване на производителността на PostgreSQL"
Отказ от отговорност: Обърнете внимание, че този доклад е датирован през ноември 2015 година — минали са повече от 4 години и времето е напреднало. Версията на PostgreSQL, обсъждана в доклада 9.4, вече не се поддържа. През последните 4 години излязоха 5 нови версии на PostgreSQL и 15 версии на ядрото на Linux. Ако пренапишем тези места, ще се получи в крайна сметка друг доклад. Но тук е разгледано фундаменталното настройване на Linux за PostgreSQL, което е актуално и в момента.
Казвам се Илия Космодемянски. Работя в компанията PostgreSQL-Consulting. Сега ще разкажа малко за това какво да правите с Linux по отношение на бази данни изобщо и PostgreSQL в частност, защото принципите са доста сходни.
За какво ще говорим? Ако общувате с PostgreSQL, до някаква степен трябва да бъдете UNIX администратор. Какво означава това? Ако сравним Oracle и PostgreSQL, в Oracle трябва да бъдете на 80 % DBA администратор на базата данни и на 20 % администратор на Linux.
С PostgreSQL е малко по-сложно. С PostgreSQL трябва много по-добре да разбирате как работи Linux. При това трябва малко да поддържате темпото, защото в последно време всичко се актуализира. И нови ядра излизат, и нови функции се появяват, производителността се подобрява и т.н.
Защо говорим за Linux? Въобще не защото сме на конференцията Linux Питер, а защото в съвременни условия едната от най-обоснованите операционни системи за работа с бази данни изобщо и с PostgreSQL в частност е Linux. Защото FreeBSD, за съжаление, се развива в странна посока. И ще има проблеми както с производителността, така и с много други неща. Производителността на PostgreSQL на Windows – това е изцяло отделна сурова тема, свързана с факта, че Windows няма такова споделено памет, както UNIX, а PostgreSQL е зависим от това, защото е многопроцесна система.
И екзотични системи като Solaris, мисля, интересуват по-малко хора, така че да продължим.
В съвременния дистрибутив на Linux има над 1000 параметра syctl, в зависимост от това как е компилирано ядрото. В същото време, ако погледнем и на различни гайки, там може да се настройва по много начини. Има параметри на файловите системи, как да се монтират. Ако имате въпроси как да стартирате: какво да включите в BIOS, как да настроите оборудването и т.н.
Това е много голям обем, за който може да се говори дни наред, а не в един кратък доклад, но сега ще се спра на важните неща, как да избягате от капаните, които определено няма да ви позволят да експлоатирате добре базата данни на Linux, ако не ги поправите. И в този контекст е важно да се отбележи, че много параметри по подразбиране не са настроени правилно за базата данни. Тоест, по подразбиране ще работи слабо или изобщо няма да работи.
Какви традиционни tuning targets съществуват в Linux? Мисля, че тъй като всички вие се занимавате с администриране на Linux, не е нужно да обяснявам какво представляват targets.
Може да се тюнингува:
- ЦП.
- Памет.
- Съхранение.
- Друго. За това ще говорим в края за десерт. Дори например такива параметри, като политиката за пестене на енергия, може да окажат много непредсказуемо и не особено приятно влияние върху производителността.
Каква специфика има PostgreSQL и базата данни изобщо? Проблемът е, че не можете да настроите някакъв отделен детайл и да видите, че производителността ни е значително подобрена.
Да, такива детайли съществуват, но базата данни е сложна система. Тя взаимодейства с всички ресурси на сървера и предпочита да взаимодейства пълноценно. Ако погледнете съвременните препоръки на Oracle за това как да се използва хостващата ОС, те ще бъдат като в анекдота за монголския космонавт – нахранете кучето и не пипайте нищо. Дайте на базата всички ресурси, базата данни сама всичко ще управлява.
В принцип, донякъде ситуацията с PostgreSQL е точно такава. Разликата е в това, че базата не може сама да си вземе всичките ресурси, тоест, някъде е нужно на ниво Linux всичко това да се управлява ръчно.
Основната идея е да не изберете само един target и да започнете да го тюнингувате, например памет, ЦП или нещо подобно, а да анализирате работното натоварване и да се опитате максимално да подобрите пропускната способност, така че през базата ни данни да преминава максимално ефективно натоварването, което добри програмисти ни създадоха, включително и нашите потребители.
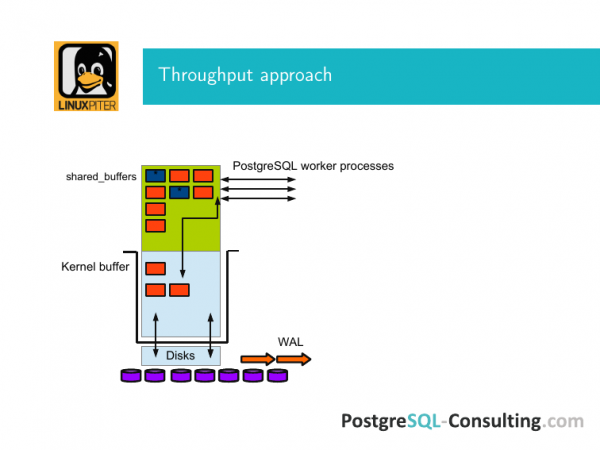
Ето такава картинка за пояснение на това какво е. Има буфер на ОС Linux, има споделена памет и има споделени буфери на PostgreSQL. PostgreSQL, за разлика от Oracle, работи директно само през буфера на ядрото, т.е. за да попадне страница от диска в неговата споделена памет, тя трябва да премине през буфера на ядрата, а после обратно е точно същата ситуация.
Под тази система живеят дисковете. Набросих го като дискове. Всъщност там може да има RAID контролер и т.н.
И този вход-изход по един или друг начин се случва чрез всичко това.
PostgreSQL е класическа база данни. Там вътре има страници. И целият вход-изход се случва с помощта на страници. Ние повдигаме блокове в паметта със страници. И ако нищо не се е случило, просто сме ги прочели, те постепенно затъват от този кеш, от споделените буфери и отиват обратно на диска.
Ако някъде нещо сме заменили, то цялата страница се маркира като мръсна. Тук съм ги отбелязал с син цвят. И това означава, че тази страница трябва да бъде синхронизирана с блочното хранилище. Т.е. когато я направим мръсна, правим запис в WAL. И в някакъв прекрасен момент дойде явлението, наречено checkpoint. И в този лог беше записана информация за това, че той е дошъл. И това означава, че всички мръсни страници, които тук бяха в този момент в споделените буфери, те се синхронизираха с диска на хранилището с помощта на fsync чрез буфера на ядрото.
Защо се прави това? Ако изгубим захранването, няма да получим ситуация, при която всички данни са изчезнали. Персистентната памет, за която ни разказваха, в момента е в теорията на базите данни – това е светлото бъдеще, към което определено се стремим и ни харесва, но в момента все още живеем в минус 20 години. И, разбира се, за всичко това трябва да се следи.
И задачата за максимизиране на пропускната способност е да нагласим всички тези етапи, за да работят бързо. Споделената памет – това е основно кеш на страниците. В PostgreSQL изпращаме запитване select нещо там, той взима тези данни от диска. Те попадат в споделените буфери. Следователно, за да работи по-добре, трябва да има много памет.
За да работи всичко добре и бързо, е необходимо да настроите операционната система правилно на всички етапи. И трябва да изберете балансирано оборудване, защото ако в някое отношение има дисбаланс, можете да имате много памет, но тя ще се обслужва с недостатъчна скорост.
И ще разгледаме всеки от тези точки.
За да пътуват тези страници по-бързо, трябва да се постигне следното:
- На първо място, трябва да работите по-ефективно с паметта.
- На второ място, преходът, при който страниците от паметта попадат на диска, трябва да бъде по-ефективен.
- И на трето място, трябва да имате хубави дискове.
Ако имате 512 GB оперативна памет в сървър и всичко това в крайна сметка отива на SATA твърд диск без никакъв кеш, то целият сървър с база данни не просто ще се превърне в тиква, а в тиква със SATA интерфейс. Ще се сблъскате директно с това. И нищо няма да ви спаси.
Що се отнася до първата точка с паметта, има три неща, които могат сериозно да затруднят живота.
Първото от тях е NUMA. NUMA е концепция, която е създадена, за да подобри производителността. В зависимост от натоварването можете да оптимизирате различни неща. И в настоящия й вид, тя не е много добра за приложения като база данни, които интензивно използват page cache.shared буфери.
С две думи. Как да разберете, че с NUMA не е наред? Имате неприятни удари, изведнъж някой CPU се оказва претоварен. При това вие анализирате заявките в PostgreSQL и виждате, че нищо подобно там няма. Тези заявки не трябва да консумират толкова интензивно CPU. Можете да ловите това дълго време. По-добре е да използвате от самото начало правилната препоръка как да настроите NUMA за PostgreSQL.
Какво всъщност се случва? NUMA – това е Non-Uniform Memory Access. Какво означава това? Имате CPU, до него има локалната му памет. И тази памет interconnects може да достъпва памет от други CPU.
Ако стартирате numactl --hardware, ще получите голямо количество информация. Сред другото там ще има поле distances. Ще видите цифри – 10-20, нещо такова. Тези цифри не са нищо друго освен брой на хоповете, за да достъпите тази отдалечена памет и да я използвате локално. В принцип, добра идея. Това значително подобрява производителността при редица натоварвания.
Представете си, че имате един CPU, който първо се опитва да използва локалната си памет, а след това се опитва да изтегли друга памет през interconnect за нещо. И на този CPU попада целият ви page cache на PostgreSQL – всичките тези гигабайти. Винаги получавате най-лошия случай, защото на CPU в този модул памет обикновено е малко. Цялата памет, която се обслужва, минава през тези interconnects. Получава се бавно и тъжно. И имате процесор, който постоянно е натоварен от този възел. И времето за достъп до тази памет е лошо, бавно. Това е ситуацията, която не искате, ако използвате това за база данни.
Следователно, по-правилният вариант за база данни е операционната система Linux изцяло да не знае какво се случва там. Да се отнася към паметта, както обикновено.
Защо е така? Изглежда, че трябва да е обратното. Това се случва по една проста причина: нуждаем се от много памет за page cache – десетки, стотици гигабайти.
Ако сме выделили всичко това и кеширали данните си там, печалбата от използването на кеша ще бъде значително по-голяма, отколкото печалбата от хитрото обращение към паметта. По този начин ще спечелим несравнимо повече, отколкото ако се опитваме да се трудим за по-ефективно ползване на паметта чрез NUMA.
Така че в момента има два подхода, докато светлото бъдеще не настъпи и базата данни не научи сама на кои CPU работи и от къде ѝ трябва да изтегли нещо.
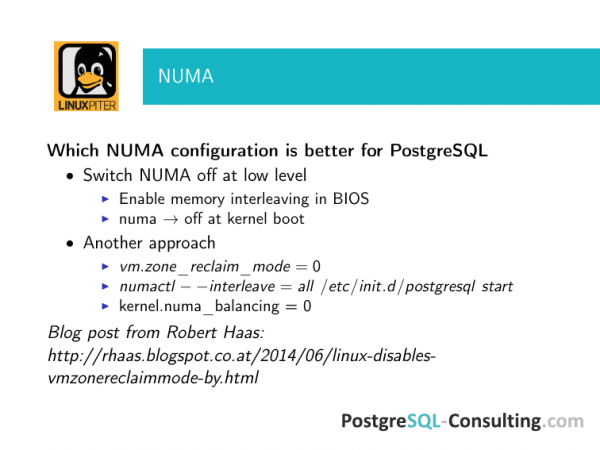
Следователно, правилният подход е изобщо да се изключи NUMA, например, при рестартиране. В повечето случаи печалбите са толкова големи, че въпросът как е по-добре изобщо не възниква.
Има и друг вариант. Ние го използваме по-често от първия, защото, когато клиент идва при нас за поддръжка, рестартирането на сървъра е цяло дело. Има бизнес, който работи. А проблемите, свързани с NUMA, ги изпитват. Затова се опитваме да изключим по-малко инвазивни начини, отколкото чрез рестарт, но тук внимавайте и проверявайте, че е било изключено. Защото, както показва опитът, изключването на NUMA в родителския процес на PostgreSQL е добре, но съвсем не е задължително да сработи. Трябва да проверявате и да наблюдавате, че то наистина е било изключено.
Има добър пост на Robert Haas. Той е един от комитерите на PostgreSQL. Един от ключовите разработчици на всичките нискоуровневи части. И ако посетите линковете от този пост, там се описват няколко колоритни истории за това как NUMA е затруднявала живота на хората. Погледнете, изследвайте чек-листа за системни администратори, какво трябва да се настрои на сървъра, за да работи базата данни добре. Тези настройки трябва да бъдат записани и проверявани, защото в противен случай няма да е много добре.
Обърнете внимание, че това се отнася за всички настройки, за които ще говоря. Обикновено базите данни се събират в режим master-slave за отказоустойчивост. Не забравяйте да внесете тези настройки на slave, защото в един прекрасен момент може да се случи авария и вие ще превключите на slave, който ще стане master.
В аварийна ситуация, когато всичко е много лошо, телефонът ви постоянно звъни и началникът идва с голяма палка, няма да имате време да мислите за проверка. И резултатите могат да бъдат доста плачевни.
Следващият момент – това са huge pages. Huge pages е трудно да се тества отделно и всъщност няма смисъл, въпреки че има бенчмаркове, които могат да го правят. Те лесно могат да се намерят в интернет.
В какво е смисълът? Имате не особено скъп сървър с много оперативна памет, например повече от 30 GB. Не използвате huge pages. Това означава, че имате ясна overhead за изразходването на памет. И този overhead не е най-приятният.
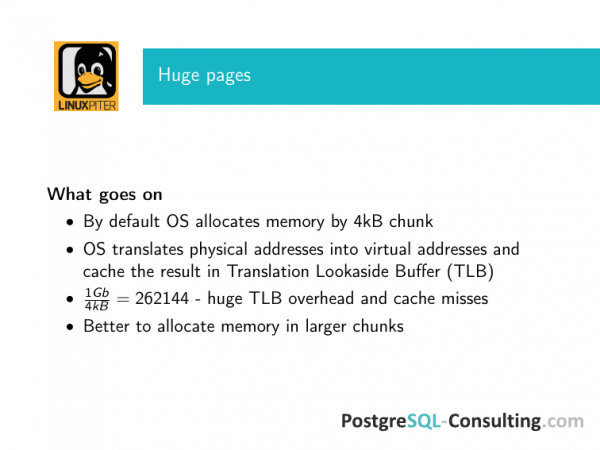
Защо е така? Какво се случва? Операционната система разпределя памет на малки парчета. Така е удобно, така е исторически установено. И ако влезем в подробности, ОС трябва да трансформира виртуалните адреси в физически. И този процес не е най-простият, затова ОС кешира резултата от тази операция в Translation Lookaside Buffer (TLB).
И тъй като TLB е кеш, в такава ситуация възникват всички проблеми, присъщи за кеша. На първо място, ако имате много оперативна памет и тя е разпределена на малки части, този буфер става много голям. А ако кешът е голям, търсенето в него става по-бавно. Здравият overhead заема пространство, т.е. оперативната памет се потребява не по най-добрия начин. Това е първата причина.
Две – колкото повече нараства кешът в такава ситуация, толкова по-голяма е вероятността да имате кеш пропуски. И ефективността на този кеш бързо спада с нарастващия му размер. Затова в операционните системи е измислен прост подход. В Linux той отдавна се използва. В FreeBSD неотдавна се появи. Но говорим за Linux. Това са huge pages.
И тук трябва да отбележим, че huge pages, като идея, първоначално беше наложена от общности, включващи Oracle и IBM, т.е. производители на бази данни сериозно обмислиха, че това ще бъде полезно, включително и за бази данни.
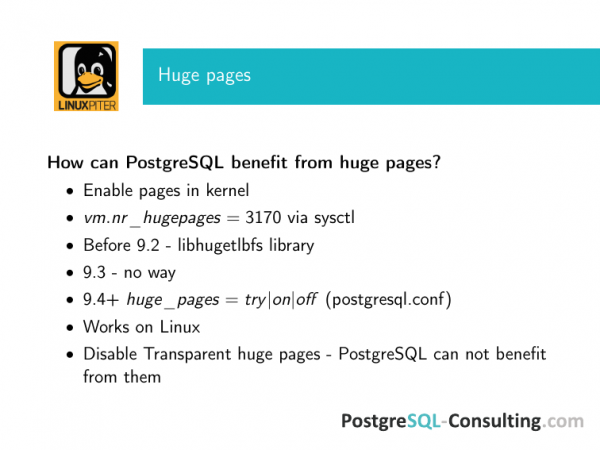
И как да го свържем с PostgreSQL? Първо, в ядрото на Linux трябва да бъдат активирани huge pages.
На второ място, те трябва да бъдат явно посочени чрез параметъра sysctl – колко от тях. Числата тук са от някой стар сървър. Можете да изчислите колко приблизително имате shared buffers, за да може huge pages да се впишат там.
Ако целият ви сървър е отдаден на PostgreSQL, то добра отправна точка е да отдадете или 25 % от оперативната памет на shared buffers, или 75 %, ако сте сигурни, че вашата база данни със сигурност ще се побере в тези 75 %. Първата отправна точка. И изчислете, ако имате 256 GB оперативна памет, то съответно 64 GB ще бъдат shared buffers. Изчислете приблизително с известно запазване – в какво примерно трябва да бъде поставена тази цифра.
До версия 9.2 (ако не се лъжа, от версия 8.2) можеше с помощта на външна библиотека да свържете PostgreSQL с huge pages. А това винаги трябва да се прави. Първо, необходимо е ядрото да може да разпределя huge pages правилно. А второ, приложението, което работи с тях, трябва да може да ги използва. Просто така няма да може. Понеже PostgreSQL разпределя паметта в стил system 5, това можеше да се направи с помощта на libhugetlbfs — това е пълното наименование на библиотеката.
В версия 9.3 беше подобрена производителността на PostgreSQL по отношение на паметта и се отказаха от системата за разпределение на паметта 5. Всички бяха много щастливи, защото в противен случай, когато се опитвате да стартирате два инстанса на PostgreSQL на една машина, той казва, че му липсва споделена памет. И казва, че трябва да коригирате sysctl. А там такъв sysctl, че е нужно да се рестартира и т.н. Като цяло, всички бяха развълнувани. Но разпределението на памет mmap е счупило използването на huge pages. Повечето ни клиенти използват големи споделени буфери. И силно препоръчахме да не преминават на 9.3, защото там overhead започна да се усеща в добри проценти.
Но пък общността обърна внимание на този проблем и в 9.4 значително преработи тази функция. В 9.4 се добави параметър в postgresql.conf, в който може да се включи try, on или off.
Try – най-безопасният параметър. При стартиране на PostgreSQL, когато той разпределя споделена памет, се опитва да вземе памет от huge pages. И ако не успее, се връща към обикновеното разпределение. И ако имате FreeBSD или Solaris, можете да поставите try, това е винаги безопасно.
Ако е on, той просто не стартира, ако не е успял да разпредели от huge pages. Тук вече – на кого какво е по-угодно. Но ако имате try, проверявайте дали наистина е разпределено това, което е нужно, защото има много място за грешки. Сега тази функция работи само на Linux.
Още едно малко забележка, преди да продължим. Transparent huge pages – това не е още за PostgreSQL. Той не може да се възползва от тях нормално. И при Transparent huge pages за такъв workload, когато е необходим голям блок споделена памет, предимствата се проявяват само при много големи обеми. Ако имате терабайти памет, тогава това може да играе роля. Ако говорим за по-обичайни приложения, когато имате 32, 64, 128, 256 GB памет на машината, обикновените huge pages са Ok, а Transparent просто изключваме.
И последната точка, свързана с паметта, не е пряко свързана с производителността, но може много да развали живота. Цялата пропускна способност може да пострада сериозно от това, че сървърът постоянно swap-ва.
И това ще бъде много неприятно в редица моменти. Основната неприятност е, че в съвременните ядра поведението малко се различава от това в по-старите ядра на Linux. И това е нещо, на което е доста неприятно да стъпваш, защото, когато говорим за работа с swap, това не завършва с навременното пристигане на OOM-killer. И OOM-killer, който не е пристигнал навреме и е убил PostgreSQL, е неприятно. Всички ще разберат за това, т.е. до последния потребител.
Какво се случва? Имате голямо количество оперативна памет, всичко работи добре. Но по някаква причина сървърът зацикля в swap и забавя. Изглежда, че паметта е много, но така се случва.
По-рано съветвахме vm.swappiness да се настрои на нула, т.е. да се изключи swap. По-рано изглеждаше, че 32 GB оперативна памет и съответните споделени буфери са огромно количество. Основната цел на swap е да има място, където да се постави нещо, ако се случи отказ. И това вече не се изпълнява много. А какво ще правим после с това нещо? Това вече е задача, при която не е много ясно защо swap е необходим, още по-малко в такъв размер.
Но в по-современните, т.е. в третите версии на ядрото, поведението се е променило. И ако настройте swap на нула, т.е. да го изключите, то рано или късно, дори и при наличието на известно количество оперативна памет, OOM-killer ще дойде, за да убие най-интензивните потребители. Защото той ще смята, че при такова натоварване ни е останало още малко и ще се опитва да убие не системния процес, а нещо по-малко важно. Това по-малко важно ще е интензивният потребител на споделена памет, а именно postmaster. И след това ще бъде добре, ако не се наложи да възстановяваме базата.
Затова сега по подразбиране, доколкото помня, повечето дистрибуции са около 6, т.е. в кой момент да започнем да използваме swap в зависимост от количеството останала памет. Сега съветваме да настроите vm.swappiness на 1, защото това практически го изключва, но не води до такива ефекти, като неочаквано пристигнал OOM-killer, който всичко това убива.
Какво следва? Когато говорим за производителността на базите данни и постепенно се насочваме към дисковете, всички започват да се хвърлят в главоблъсканица. Истината, че дискът е бавен, а паметта бърза, е позната на всички от детството. И всички знаят, че в базата данни ще има проблеми с производителността на диска.
Основният проблем с производителността на PostgreSQL, свързан с пиковете на checkpoints, не произлиза от факта, че дискът е бавен. По-скоро, той е резултат от това, че пропускателната способност на паметта и диска не е балансирана. Освен това, те могат да бъдат необременени на различни места. PostgreSQL не е конфигуриран, операционната система не е настроена, хардуерът не е оптимален и изборът на хардуер е грешен. Тази проблема не възниква само в случай, че всичко е както трябва, т.е. или няма натоварване, или настройките и хардуерът са добре подбрани.
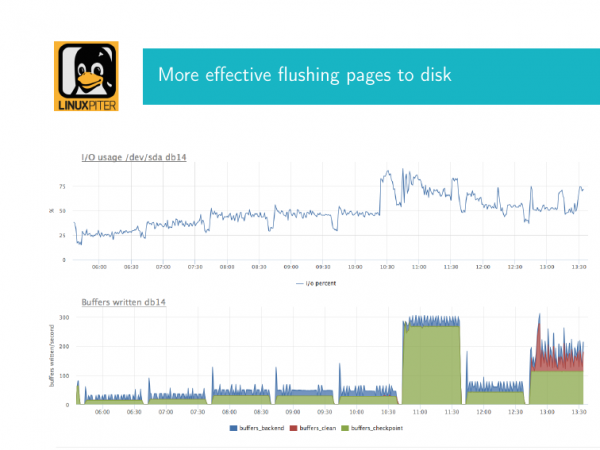
Какво представлява това и как изглежда? Обикновено, хората, които работят с PostgreSQL, многократно преминават през този процес. Ще поясня. Както казах, PostgreSQL периодично извършва checkpoints, за да запише замърсените странички в споделената памет на диска. Ако имаме голям обем споделена памет, тогава checkpoint започва да оказва интензивно влияние върху диска, тъй като записва тези странички чрез fsync. Те попадат в ядрения буфер и се записват на дисковете с помощта на fsync. И ако обемът бъде много голям, можем да наблюдаваме неприятен ефект, а именно много висока утилизация на дисковете.
Тук имам две изображения. Сега ще поясня какво представляват. Това са два графика с времева коррелация. Първият график – е утилизацията на диска. Тук тя достига почти 90 % в този момент. Ако базата данни ви е на физически дискове с RAID контролер и утилизацията е почти 90 %, то това са лоши новини. Това означава, че скоро ще достигне 100 и входно-изходните операции ще спрат.
Ако имате дисков масив, тогава историята е малко по-различна. Там зависи от това как е настроен, какъв тип масив е и т.н.
А паралелно тук е конфигуриран график от вътрешна postgres вюха, която показва как протича checkpoint. И в зелено тук е показано какво количество буфери, тези мръсни странички, в този момент са дошли в този checkpoint за синхронизация. И това е основното, което трябва да знаете. Виждаме, че тук има много странички и в един момент достигаме до ограничения, т.е. пишем-пишем, тук е явно, че дисковата система е много заета. И нашият checkpoint оказва голямо влияние на диска. В идеалния случай ситуацията трябва да изглежда по-скоро така, т.е. тук е имало по-малко записване. И с настройки можем да оправим това, за да продължи така. Т.е. утилизацията е малка, но където и да е, ние тук пишем.
Какво трябва да направите, за да преодолеете този проблем? Ако IO под базата данни е спряло, това означава, че всички потребители, които са дошли да изпълняват своите заявки, ще чакат.
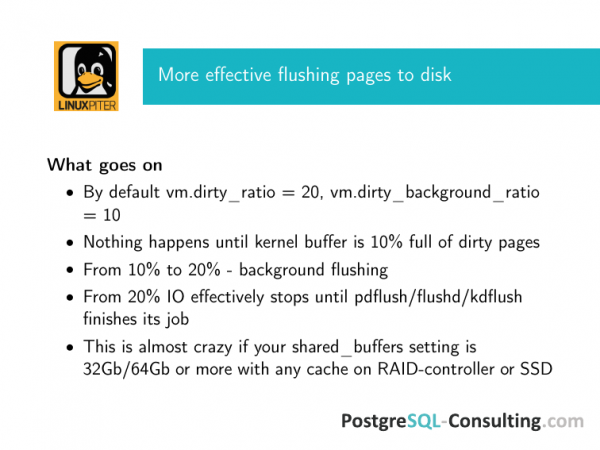
Ако погледнете от гледна точка на Linux, ако имате добро оборудване, правилно сте го настроили и нормално сте конфигурирали PostgreSQL, за да прави тези checkpoints по-рядко и да ги разпределя във времето един между друг, то влизате в стандартните параметри на Debian. За повечето дистрибуции на Linux такъв е сценарият: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Какво означава това? С ядрото 2.6 се появи един демон за flushing. Pgflush, в зависимост от това какво използвате, който се занимава с фоново изтегляне на мръсни странички от kernel buffer и изтегляне, когато е необходимо, за да се изтеглят мръсни странички, когато фоновото изтегляне вече не помага.
Кога настъпва background? Когато 10% от цялата оперативна памет, която е на сървера, е заета с мръсни странички в kernel buffer, се извиква специална функция за изписване във фона. Защо е фоново? Тя приема в параметъра си колко странички да изготви. И, да кажем, изготвя N странички. И за определено време това нещо заспива. А след това отново идва и изготвя още известно количество странички.
Това е изключително проста история. Тук задачата е като с басейн, когато в една тръба изтича, в друга влива. Нашият checkpoint е дошъл и ако е изпратил малко мръсни странички за изтегляне, постепенно от kernel buffer pgflush всичко това внимателно ще се разсее.
Ако тези мръсни страници продължат да се натрупват, те ще достигнат 20%, след което операционната система ще приоритизира записването им на диска, тъй като захранването може да се изключи и всичко ще бъде лошо. Ще загубим тези данни, например.
Какъв е трикът? Трикът е, че тези параметри в съвременния свят – 20 и 10% от общата оперативна памет на машината – са напълно неадекватни от гледна точка на пропускната способност на всяка дискова система, която имате.
Представете си, че имате 128 GB оперативна памет. 12,8 GB отиват във вашата дискова система. И какъвто и кэш да имате там, какъвто и масив да имате, той няма да може да понесе това количество.
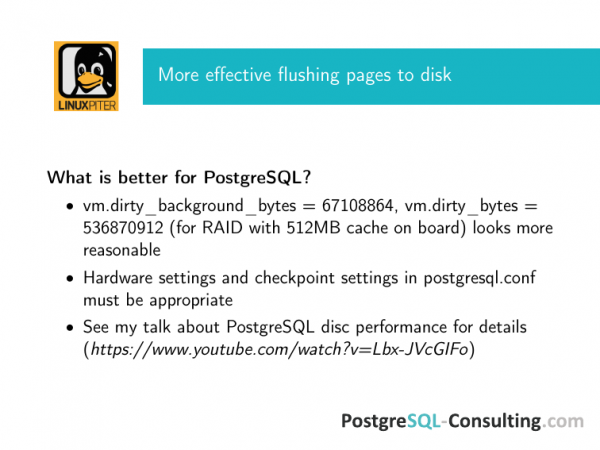
Затова препоръчваме веднага да настроите тези цифри спрямо възможностите на вашия RAID контролер. Имам веднага тук препоръка за контролера с 512 MB кэш.
Всичко е много просто. Можете да зададете vm.dirty_background в байтове. И тези настройки отменят предходните две. Или по подразбиране ratio, или активирате тези с байтове, то тогава ще работят тези с байтове. Но тъй като съм консултант DBA и работя с различни клиенти, се старая да предвидя всичко и затова, ако е в байтове, то е в байтове. Никой не е дал никаква гаранция, че добрият админ няма да добави памет на сървъра, няма да го рестартира и цифрата да остане същата. Просто изчислявайте тези цифри, за да сте сигурни, че всичко ще влезе.
Какво ще се случи, ако не успеете да влезете? Написано е, че всяко flushing ефективно спира, но всъщност това е фигура на речта. Операционната система има голям проблем – много мръсни страници, така че наистина се спира ефективно IO-то, което произвеждат вашите клиенти, т.е. когато приложението изпрати SQL заявка към базата данни, то чака. Всеки вход-изход към нея е на най-нисък приоритет, защото базата е заета с checkpoint. И кога ще я завърши е напълно неясно. И когато достигнете не фоновото, не бекграундното flushing, то това означава, че цялото ви IO е заето от него. И докато не приключи, не можете да направите нищо.
Тук има още два важни момента, които излизат извън рамките на тази презентация. Настройките трябва да съвпадат с настройките в postgresql.conf, т.е. настройките за checkpoints. И вашата дискова система трябва да бъде адекватно настроена. Ако имате кеш на RAID, трябва да имате батерия. Хората купуват RAID с добър кеш без батерии. Ако имате SSD в RAID, те трябва да са сървърни, трябва да имате кондензатори. Тук е подробен чеклист. На този линк можете да намерите моя доклад за това как да настроите производителността на диска в PostgreSQL. Всички тези чеклистове са включени.
Какво друго би могло да усложни живота? Има два параметъра. Те са относително нови. По подразбиране те могат да бъдат включени в различни приложения. И могат да усложнят живота не по-малко, ако бъдат включени неправилно.
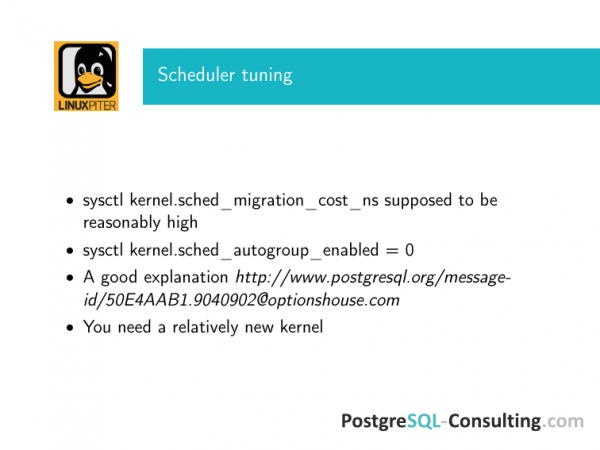
Има две относително нови неща. Те вече се появиха в третите ядра. Това е sched_migration_cost в наносекунди и sched_autogroup_enabled, което по подразбиране е включено.
И как те усложняват живота? Какво е sched_migration_cost? Linux scheduler може да мигрира процес от едно CPU на друго. И за PostgreSQL, който изпълнява заявки, миграцията на друго CPU е напълно неясна защо е необходима. От гледната точка на операционната система, когато превключвате прозорците между openoffice и терминала, може би е добре, но за базата данни – това е много лошо. Ето защо разумната политика е да зададете миграционната цена на голямо значение, поне няколко хиляди наносекунди.
Какво означава това за scheduler? Ще счита, че през това време този процес все още е активен. Т.е. ако имате дълга транзакция, която прави нещо дълго, scheduler ще разбере това. Ще счита, че докато не изтече този таймаут, не е нужно да мигрира този процес никъде. Ако в същото време процесът нещо прави, той няма да бъде мигриран, а ще завърши на това CPU, което му е било отредено. И резултатът е отличен.
Вторият момент – това е autogroup. Има добра идея за специфични работни натоварвания, които нямат отношение към съвременните бази данни – да се групират процесите по виртуалния терминал, от който са стартирани. Това е удобно за определени задачи. На практика PostgreSQL е многопроцесорна система с prefork, която стартира от един терминал. Имате lock writer, checkpoint и всичките ви клиентски заявки ще се групират на един scheduler, на един CPU. Те ще чакат дружно, когато се освободи, за да не си пречат и да заемат процесора по-дълго. Това е история, която изобщо не е нужна при такава натовареност и затова трябва да се изключи.
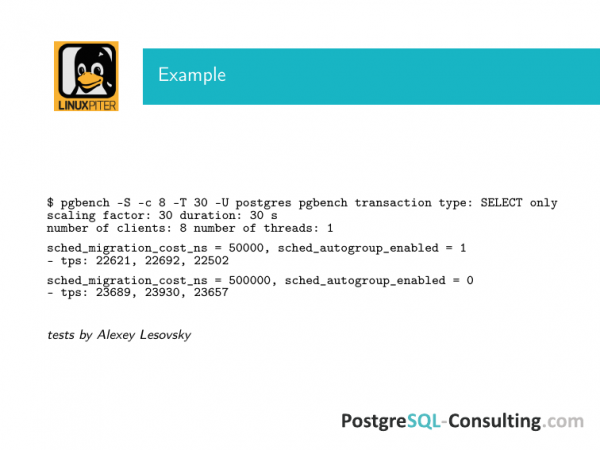
Моят колега Алексей Лесовски провеждаше тестове с прост pgbench, където увеличаваше порядъка на migration_cost и изключваше autogroup. Разликата на лошото оборудване е почти 10 %.Има обсъждане в имейл списъка на PostgreSQL, където хората представят резултатите от това как подобни промени влияят на скоростта на заявките. влияли на 50 %.Такива истории има доста.
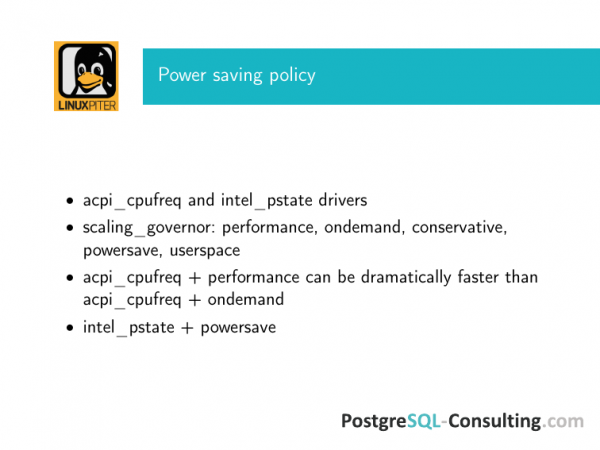
И накрая за политиката за пестене на енергия. Добре е, че сега Linux може да се използва на лаптоп. И той уж ще пести батерията. Но изведнъж се оказва, че такова нещо може да бъде и на сървър.
По-во да, ако наемате сървъри от някой хостинг, то „доброжелателите“ хостери не се грижат за производителността ви. Ние сме поставени да направим така, че оборудването им да се утилизира максимално ефективно. Затова по подразбиране могат да включат в операционната система режим на пестене на енергия за лаптопи.
Ако използвате на сървър с база данни под интензивно натоварване такова нещо, то вашият избор е acpi_cpufreq + performance. Дори с ondemand ще имате проблеми.
Intel_pstate – е малко по-различен драйвер. И сега предпочитанието е към него, тъй като е по-нов и по-добре работещ.
И, съответно, governor само performance. Ondemand, powersave и всичко останало – не е за вас.
Резултатите от explain analyze в PostgreSQL могат да се различават с няколко порядъка, ако включите powersave, защото практически CPU-то ви ще бъде шедулирано по напълно непредсказуем начин.
Тези неща могат да бъдат включени по подразбиране. Внимателно проверете – дали не са включили по подразбиране. Това може да бъде наистина голям проблем.
И в края на краищата искам да благодаря на екипа от нашата DBA команда PosgreSQL-Consulting, а именно на Макс Богук и Алексей Лесовски, които всеки ден натрупват опит в тази сфера. За нашите клиенти се опитваме да осигурим всичко да работи максимално добре. Тук е като с инструкциите за авиационна безопасност. Всичко е написано с кръв. Всяка от тези гайки е открита в процеса на възникнала проблематика. С удоволствие ги споделям с вас.
Вопроси:
Благодаря! Ако, например, компания иска да спести и да хоства база данни и приложна логика на един сървър или ако компанията следва модната тенденция на микросервизните архитектури, в които PostgreSQL се стартира в контейнер. Каква е особеността? Sysctl глобално влияе на ядрото. Не съм чул sysctl да се виртуализира, за да работи поотделно в контейнер. Има само cgroup и там управлението е ограничено до част от ресурсите. Как да се справим с това? Или, ако искате производителност, стартирайте PostgreSQL на отделен физически сървър и го настройте.
Отговорили сме на вашия въпрос по три различни начина. Ако става въпрос не за физически сървър, който може да се настрои и т.н., просто се отпуснете, всичко ще работи добре и без тези настройки. Ако имате натоварване, при което трябва да направите тези настройки, ще преминете към физически сървър много преди да достигнете до тях.
В какъв е проблемът? Ако това е виртуална машина, вероятно ще имате много проблеми, например с факта, че повечето виртуални машини имат доста неконсистентна латентност на диска. Дори да е добра пропускната способност на дисковете, една повредена транзакция при операции за въвеждане-извеждане, която не влияе много на средната пропускна способност, случваща се по време на checkpoint или при запис в WAL, сериозно ще натовари базата. И вие ще го усетите преди да се сблъскате с тези проблеми.
Ако имате NGINX на същия сървър, също ще имате същия проблем. Той ще се бори за споделена памет. И няма да достигнете до проблемите, описани тук.
Но от друга страна, някои от тези параметри все пак ще ви бъдат актуални. Например, с sysctl да зададете dirty_ratio, за да не е толкова безумно – така или иначе това ще помогне. По един или друг начин, вие ще имате взаимодействие с диска. И то ще бъде по неправилна схема. Това са по подразбиране параметрите, които показах. И във всеки случай е по-добре да ги промените.
А с NUMA могат да възникнат проблеми. VmWare, например, работи добре с NUMA с точно противоположни настройки. И тук трябва да избирате – железен сървър или не.
Имам въпрос, свързан с Amazon AWS. Те имат предварително настроени имиджи. Един от тях се нарича Amazon RDS. Има ли там някакви персонализирани настройки за тяхната операционна система?
Там има настройки, но това са различни настройки. Тук настраняваме операционната система от гледна точка на това как базата данни ще използва тази информация. А там има параметри, които определят накъде да отидем в момента, т.е. имаме нужда от толкова ресурси, които сега ще използваме. След това Amazon RDS тези ресурси прикрепя и производителността пада. Има отделни истории, как хората започват да експериментират с това. Понякога дори доста успешно. Но това няма отношение към настройките на ОС. Това е по-скоро хакване на облака. Това е друга тема.
Защо Transparent huge pages не дават ефект в сравнение с Huge TLB?
Не дават. Може да се обясни по много начини. Но фактически те просто не дават такъв ефект. Каква е историята с PostgreSQL? При старта той заделя голямо количество споделена памет. Дали Transparent или не transparent – съвсем не е важно. Фактът, че те се заделят при старта, обяснява всичко. И ако паметта е много и трябва да се реструктурира shared_memory сегмент, тогава Transparent huge pages ще бъде актуален. В PostgreSQL той просто е заделен като огромен блок при старта и всичко, и след това нищо особено не се случва. Разбира се, може да се използва, но има риск от повреждане на shared_memory, когато ще се преизползва нещо. PostgreSQL не знае за това.
Източник: habr.com
