

Нека разгледаме основите на логването в Docker и Kubernetes, а след това ще разгледаме два инструмента, които спокойно могат да се използват в продукция: Grafana Loki и стека EFK (Elasticsearch + Fluent Bit + Kibana).
Материалът на статията е резюме от . Ако имате желание, а още повече производствена необходимост, можете да преминете пълно обучение — запишете се на курс по .
Логване в Docker
На ниво Kubernetes приложенията са стартирани в подове, но на по-долно ниво те всъщност работят обикновено в Docker. Следователно е нужно да настроим логването по такъв начин, че да събираме логовете от контейнерите. Контейнерите стартира Docker — следователно трябва да разберем как е устроено логването на ниво Docker.
Надявам се, че всеки читател знае: логовете на приложението трябва да се записват в stdout/stderr, а не вътре в контейнера. Логовете се агрегира от Docker Daemon, и той работи именно с тези логове, които се изпращат на stdout/stderr. Освен това записването на логовете вътре в контейнера е проблематично: контейнерът се увеличава по размер от растящия лог (тъй като вероятно няма Logrotate в контейнера), а Docker Daemon изобщо не е наясно с този лог.
Docker предлага няколко лог-драйвера или плъгини за събиране на логове от контейнерите. В безплатната версия на Docker Community Edition (CE) log-драйверите са по-малко, отколкото в комерсиалната Docker Enterprise Edition (EE).
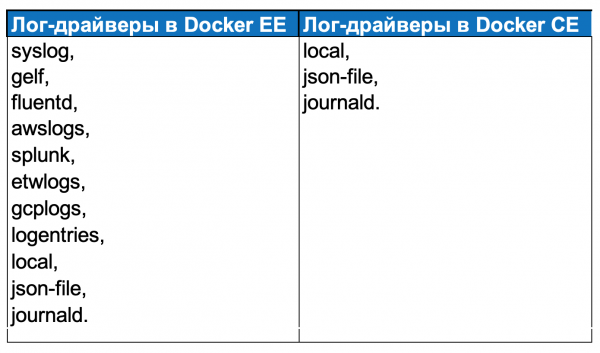
Никога не съм използвал Docker EE на практика: в Southbridge се стараем да се придържаме към решения с отворен код, а и на повечето клиенти не им трябват допълнителните функции на Docker EE.
Лог-драйвери в Docker CE:
local — записване на логовете във вътрешни файлове на Docker Daemon;
json-file — създаване на json-лог в папката на всеки контейнер;
journald — изпращане на логовете в journald.
Настройките за логване в Docker се намират в файла daemon.json.
В полето “log-driver” се посочва плъгин, а в полето “log-opts” — неговите настройки. В примера по-горе е посочен плъгинът “json-file”, ограничение по размер на логовете — “max-size”: “10m”; ограничение по брой файлове (настройки за ротация) — “max-file”: “3”; и стойности, които ще бъдат прикрепени към логовете.
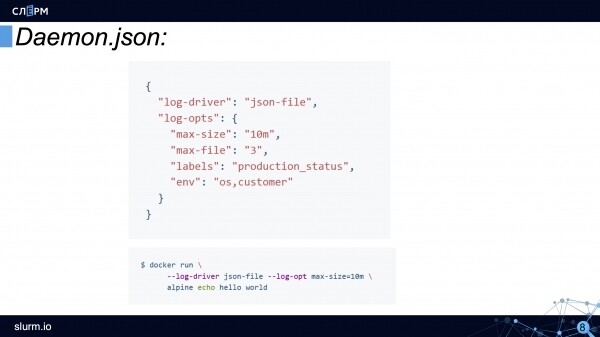
Някои настройки на лог-драйвера могат да бъдат зададени чрез командна утилита. Това е удобно, ако е необходимо да стартирате отделен контейнер с друг лог-драйвер.
Ето как изглежда схемата на логването в Docker:
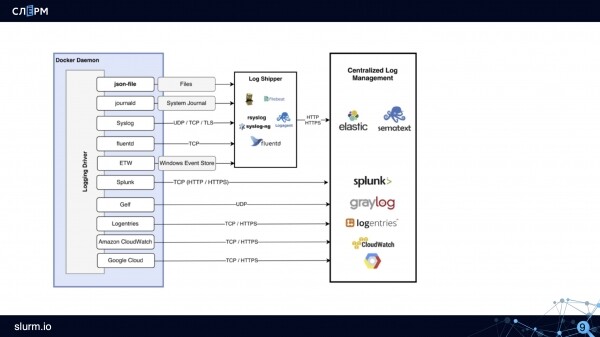
Как работи схемата: лог-драйверът, например json-file, създава файлове. Събирачите на логове (Rsyslog, Fluentd, Logagent и други) събират тези файлове и ги предават за съхранение в Elastic, Sematext или други хранилища.
Характеристики на логването в Kubernetes
Оптимизираната схема на логване в Kubernetes изглежда по следния начин: има pod, в което е стартиран контейнер, контейнерът изпраща логове в stdout/stderr. След това Docker създава файл и записва логовете, които впоследствие могат да се ротат.
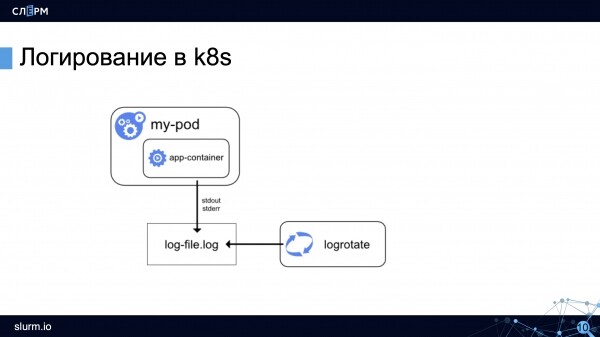
Нека разгледаме особеностите на логването в Kubernetes.
Запазване на логовете между деплойменти. Това е задължително условие за правилна настройка на логването. Ако не се запазват логовете между деплойментите, при излизане на нова версия на приложението логовете от предишната версия ще се затират, а перезапускането на контейнера също ще доведе до загуба на логове. Kubernetes разполага с ключа —previous, който позволява да се видят логовете на приложението преди последния рестарт на Pod, но не и по-дълбоко.
Агрегиране на логовете от всички инстанции. Ако микросервисите са хоствани в облака, облачният доставчик отговаря за контрола на системата. Ако микросервисите са на собствено оборудване, то освен логовете от контейнерите е необходимо да се събират и логовете на системата.
Преди не съществуваха удобни инструменти за събиране на логове както от системата, така и от микросервисите. Обикновено един инструмент събираше системни логове (например, Rsyslog), втори — логовете от Docker (например, journal-bit с конфигурация на лог-драйвера на Docker за journald). Опитвахме да използваме journal-bit — да събира логове и от контейнерите (в лог-драйвера на Docker се указваше, че логовете трябва да се записват в journald), и от системата (в CentOS 7 вече има systemd и journald). Решението работеше, но не беше идеално. При много логове journal-bit започва да забавя и съобщенията се губят.
Експериментите продължаваха — и намерихме друг начин. В CentOS 7 основните системни логове (messages, audit, secure) се дублират в var-лог под формата на файлове. В Docker също може да се настрои запазване на логовете в json файлове. Съответно, тези файлове от CentOS 7 и Docker могат да се събират заедно.
С времето стана популярно решението ELK Stack. Това е комбинация от няколко инструмента: Elasticsearch, Logstash и Kibana.
Elasticsearch съхранява логовете от контейнерите, Logstash събира логовете от инстанциите, Kibana позволява обработка на получените логове и изграждане на графики. Някое време ELK Stack активно се използваше, но на моето мнение, времето му изтича. По-късно ще обясня защо.
Добавяне на метаданни. Pod-овете, приложенията и контейнерите могат да бъдат стартирани навсякъде. Освен това, едно приложение може да има няколко инстанции. Логовете са записани в един формат, а ние трябва да разберем коя точно е тази реплика, кой Pod го записва и в кой namespace се намира. Именно затова на логовете им е необходимо да се добавят метаданни.
Парсване на логовете. Забавно е, но разходите за поддръжка на системата за логиране и мониторинг могат да надвишат разходите за основното приложение. Когато имате десетки и стотици хиляди логове в секунда, това изглежда естествено, но все пак трябва да знаете границата. Един от начините да откриете тази граница е парсването на логовете.
Обикновено не е необходимо да събирате и съхранявате всички логове, трябва да изпращате на съхранение само част — например, логовете със статус «warning» или «error». Ако става дума за логове на nginx или ingress-контролери, може да се съхраняват само тези, чийто статус е различен от 200. Но това не е универсален съвет: ако изграждате по някакъв начин анализа на логовете от Nginx, очевидно е, че те трябва да се събират.
Безразборното филтриране на логовете не се препоръчва, защото отфилтрираните данни може да не са достатъчни за нормална аналитика. От друга страна, възможно е анализът да трябва да се проведе не на ниво логиране, а на ниво събиране на метрики. Тогава няма да е необходимо да съхранявате стотици хиляди реда с код 200. Един от подходите е да получавате информация за трафика и грешките от метриките на ingress-контролерите.
В общи линии, тук трябва да помислите добре: какво искате да съхранявате и за колко дълго, защото иначе ще възникне ситуация, при която системата за логиране ще отнема повече ресурси, отколкото основният проект.
Все още няма стандартно решение за логиране. В отличие от мониторинга, където има едно най-разпространено решение Prometheus, в логирания няма стандарт.
В рамките на тази лекция ще разгледаме два инструмента: един популярен и втори — набиращ популярност. Освен тях има и други, но в тази статия няма да ги обсъждаме.
С оглед на всички горепосочени особености, логиране в Kubernetes сега може да бъде представено на такава схема:
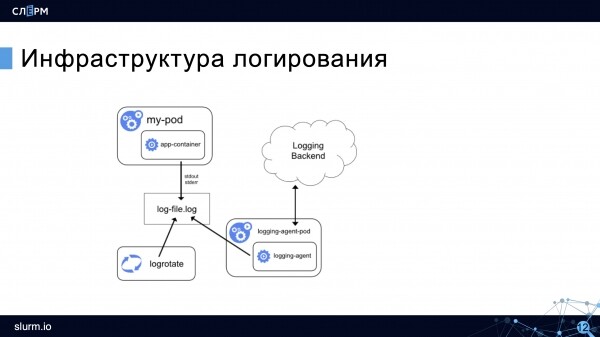
Остава логът на контейнера, ротацията, но се появява агент-събирател, който подбира логовете и ги изпраща на съхранение (на схемата — в Logging Backend). Агентът работи на всяка нода и обикновено е стартиран в Kubernetes.
Сега ще разгледаме инструментите за логиране.
Grafana Loki
появи се наскоро, но вече стана доста известен. Неговите предимства: лесно се инсталира, консумира малко ресурси, не изисква инсталиране на Elasticsearch, тъй като съхранява данни в TSDB (база данни за времеви редове). В предишната статия писах, че в такава база съхранява данни Prometheus, и това е едно от многобройните сходства между двата продукта. Разработчиците дори твърдят, че Loki е "Prometheus за света на логовете".
Няма малка отстъпка за TSDB за тези, които не четоха. : TSDB отлично се справя със задачата за съхраняване на голямо количество данни, времеви редове, но не е предназначена за дълго съхранение. Ако по някаква причина трябва да съхранявате логовете по-дълго от две седмици, по-добре е да настроите тяхната предаване в друга БД.
Още едно предимство на Loki е, че за визуализация на данните се използва Grafana. Много удобно: в Grafana преглеждаме данните за мониторинг и там също, свързвайки Loki, преглеждаме логовете. По логовете може да се построят графики.
Архитектурата на Loki изглежда по следния начин:
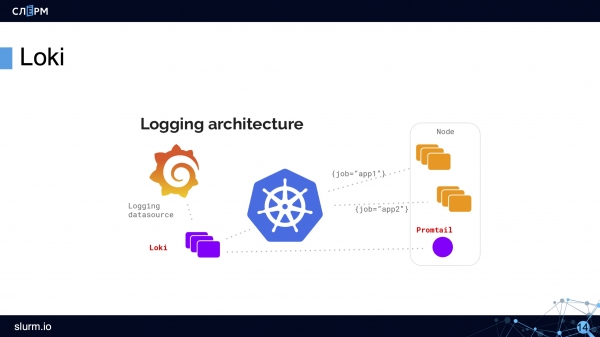
С помощта на DaemonSet на всички сървъри в кластера се разгръща агент — Promtail или Fluent Bit. Агентът събира логовете. Loki ги взима и ги съхранява в TSDB. Към логовете веднага се добавят метаданни, което е удобно: може да се филтрира по Pods, namespaces, имена на контейнери и дори по етикети.
Loki работи в познатия интерфейс на Grafana. Loki дори има свой собствен език за заявки, наречен LogQL — по името си и по синтаксиса напомня на PromQL в Prometheus. В интерфейса на Loki има подсказки за заявки, така че не е нужно да ги знаете наизуст.
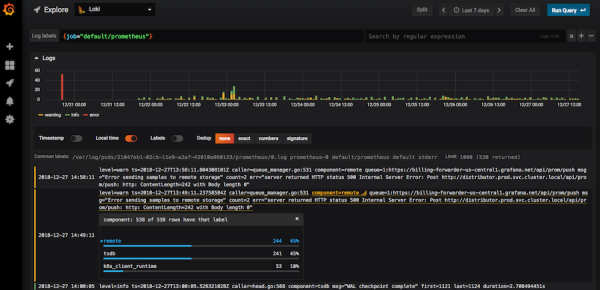
Loki в интерфейса на Grafana
Използвайки филтри, в Loki можете да намерите кодове ("400", "404" и всеки друг); да прегледате логовете от целия възел; да филтрирате всички логове, в които има думата "error". Ако щракнете върху лог, ще се отвори карта с цялата информация по събитието.
В Loki има достатъчно инструменти, които позволяват извлечението на необходимите логове, въпреки че честно казано, технически те можеше да бъдат и повече. В момента Loki активно се развива и набира популярност.
Elastic + Fluent Bit + Kibana (EFK Stack)
Стек EFK е по-класически и в същото време не по-малко популярен инструмент за логиране.
В началото на статията се споменава ELK (Elasticsearch + Logstash + Kibana), но този стек остаря заради не особено ефективния и същевременно ресурсно интензивен Logstash. Вместо него започнаха да използват по-лек и производителен Fluentd, а след известно време му беше добавен — дори още по-лек и дори още по-производителен агент за събиране.
Ако вярваме на разработчиците, Fluent Bit е над 100 пъти по-добър по производителност от Fluentd: „докато Fluentd консумира 20 МБ RAM, Fluent Bit ще консумира 150 КБ“ — директна цитата от документацията. С оглед на това, Fluent Bit се използва все по-често.
Fluent Bit има по-малко възможности от Fluentd, но покрива основните нужди, поради което основно използваме Fluent Bit.
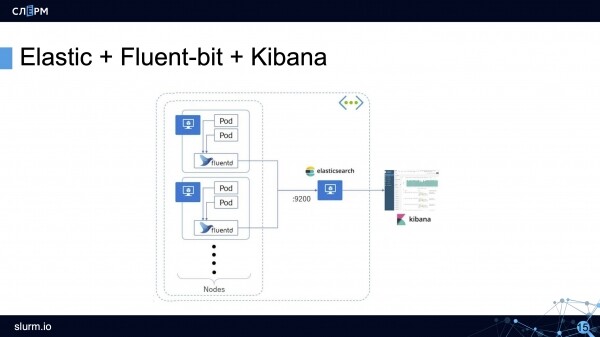
Схемата на работа на стека EFK: агентът събира логове от всички подове (обикновено това е DaemonSet, стартиран на всички сървъри в кластера) и ги изпраща в хранилище (Elasticsearch, PostgreSQL или Kafka). Kibana се свързва с хранилището и изтегля цялата необходима информация.
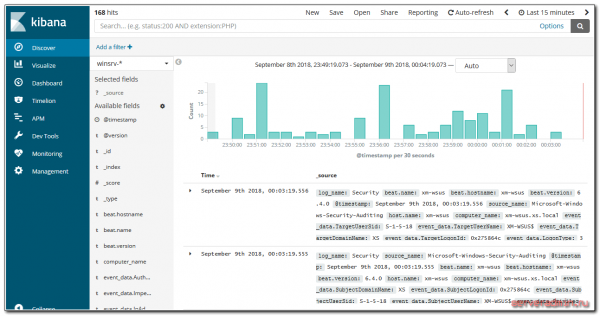
представя информацията в удобен уеб интерфейс. Има графики, филтри и много други.
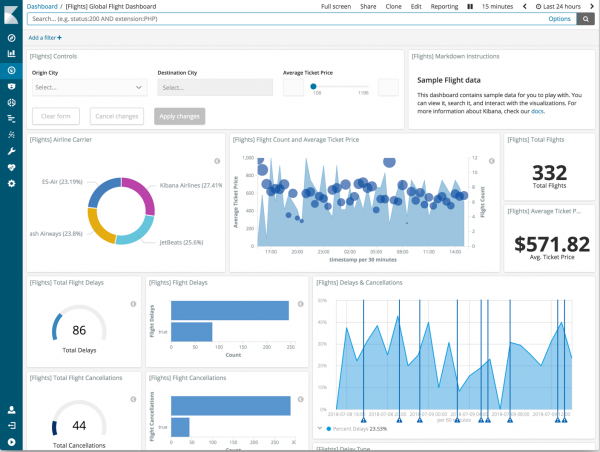
На базата на логовете могат да се създават цели табла.
Възможности на Fluent Bit
Тъй като Fluent Bit, като правило, е по-малко известен от Logstash, нека разгледаме го малко по-подробно. Fluent Bit може логически да бъде разделен на 6 модула, част от които могат да бъдат надстроени с плъгини, които разширяват възможностите на Fluent Bit.
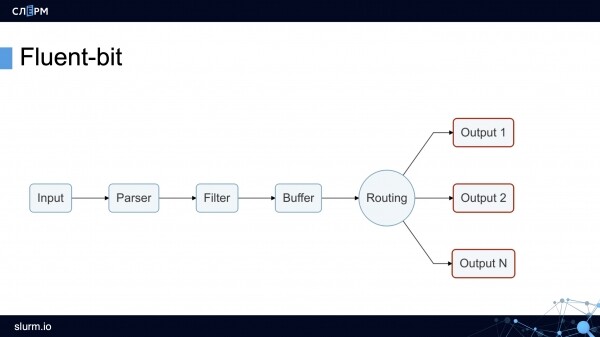
Модул Input събира логове от файлове, системни услуги systemd и дори от tcp-socket (само трябва да посочите endpoint и Fluent Bit ще започне да се свързва). Тези възможности са достатъчни, за да събира логове както от системата, така и от контейнери.
В продукция ние най-често използваме плъгини (може да се насочи към папка с логове) и (може да се зададе от кои услуги да се събират логовете).
Модул Parser приближава логовете до общ стандарт. По подразбиране логовете на Nginx са низ. С помощта на плъгин този низ може да бъде преобразуван в JSON: да се зададат полета и техните стойности. С JSON е много по-лесно да се работи, отколкото със строкови лог, тъй като предлага по-гъвкави възможности за сортиране.
Модул Filter. На това ниво се отсяват ненужните логове. Например, на хранилище се изпращат логове само с стойност „warning“ или с определени етикети. Отбраните логове попадат в буфер.
Модул Buffer. Fluent Bit предлага два вида буфери: буфер в паметта и буфер на диск. Буферът е временно хранилище за логове, необходимо в случай на грешки или сривове. Всеки иска да спести от RAM, затова обикновено се избира буфер на диск. Но трябва да се има предвид, че преди да се запише на диска, логовете все пак се извеждат в паметта.
Модул Routing/Output съдържа правила и адреси за изпращане на логове. Както вече бе споменато, логовете могат да се изпращат в Elasticsearch, PostgreSQL или, например, Kafka.
Интересно е, че логовете от Fluent Bit могат да се изпращат и към Fluentd. Понеже първият е по-лек и с по-малко функции, чрез него могат да се събират логове и да се изпращат към Fluentd, а там, с помощта на допълнителни плъгини, да се обработват и изпращат към хранилища.
Ако планирате да използвате Elasticsearch…
Накрая, две съвета за тези, които планират да използват Elasticsearch като хранилище за логове в продукция.
- Настройте известия с помощта на . Тази програма извлича важни съобщения от общия поток от логове и прави известия по тях в електронната поща или друг канал. Всъщност, наскоро излезе .
- Ротирате логовете с помощта на приложението или чрез API повиквания към Elasticsearch. Самият Elastic, всъщност, в момента прави значителни стъпки за управление на жизнения цикъл на индексите без използване на външни инструменти. В крайна сметка, няма никакъв смисъл да се държат логовете дълго: едва ли някой лог ще е нужен след две седмици — ако наистина е критичен, за две седмици той със сигурност ще бъде обработван. В краен случай старите логове могат да се архивират и да се изпращат някъде за дългосрочно съхранение. Чух за специални логове, които по закон трябва да се съхраняват до 5 години. Лично аз не съм се сблъсквал с такова нещо, но бих приравнил тази информация на обикновените логове и вероятно дори бих ги съхранявал отделно.
Продължение следва…
Автор: Марсел Ибраев, сертифициран администратор Kubernetes, практикуващ инженер в компания , лектор и разработчик на курсове .
Източник: habr.com
