

TL;DR
- За да постигнете висока видимост на контейнерите и микросервисите, логовете и основните метрики не са достатъчни.
- За по-бързо възстановяване и повишаване на отказоустойчивостта, приложенията трябва да прилагат Принципа на висока видимост (HOP, High Observability Principle).
- На ниво приложение за HOP са необходими: адекватно логване, внимателен мониторинг, проверки за работоспособност и трасировка на производителността/преминаванията.
- Като елемент на HOP използвайте проверки readinessProbe и livenessProbe Kubernetes.
Какво е Шаблон за проверка на работоспособността?
Когато проектирате критично важен и високо достъпен приложение, е много важно да обмислите такъв аспект като отказоустойчивостта. Приложението се счита за отказоустойчиво, ако бързо се възстановява след отказ. Типично облачно приложение използва архитектура на микросервизи – когато всеки компонент е поставен в отделен контейнер. И за да се уверите, че приложението на k8s е високо достъпно, когато проектирате клъстер, трябва да следвате определени шаблони. Сред тях е Шаблон за проверка на работоспособността. Той определя как приложението информира k8s за своята работоспособност. Това не е само информация за това дали pod-ът работи, а също така как приема и отговаря на заявки. Колкото повече Kubernetes знае за работоспособността на pod-а, толкова по-умни решения взема за маршрутизация на трафика и балансиране на натоварването. По този начин, Принцип на висока видимост позволява на приложението да отговаря на заявките навреме.
Принцип на висока видимост (HOP)
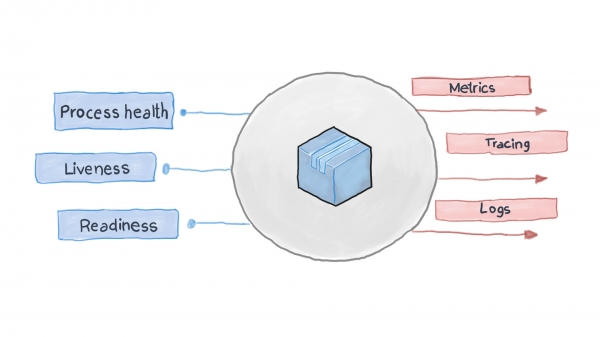
Принцип на висока видимост е един от . В микросервизната архитектура, услугите не се интересуват как се обработват техните заявки (и това е правилно), но е важно как се получават отговорите от приемниците. Например, за аутентификация на потребителя, един контейнер изпраща на друг HTTP заявка, очаквайки отговор в определен формат – и това е всичко. Заявката може да се обработва от PythonJS, а отговорът – от Python Flask. Контейнерите са един за друг – като черни кутии с скрито съдържание. Въпреки това, принципът NОR изисква всеки сервис да разкрива няколко крайни точки на API, показващи колко е работоспособен, както и състоянието на готовност и отказоустойчивост. Тези показатели запитва Kubernetes, за да обмисли следващите стъпки за маршрутизиране и балансиране на натоварването.
Правилно проектираното облачно приложение логва основните си събития, използвайки стандартните потоци на вход-изход STDERR и STDOUT. След това работи помощен сервис, като например filebeat, logstash или fluentd, които доставят журналите в централизирана система за мониторинг (като например Prometheus) и система за събиране на журнали (набор от софтуер ELK). На схемата по-долу е показано как облачното приложение работи в съответствие с Шаблона за проверка на работоспособността и Принципа на висока наблюдаемост.
Как да приложим Шаблона за проверка на работоспособността в Kubernetes?
Извън кутията k8s следи състоянието на pod-овете с помощта на един от контролерите (, , , и др., др.). Когато контролерът забележи, че pod по някаква причина е паднал, той се опитва да го рестартира или да го премести на друг узел. Въпреки това, pod може да съобщи, че е стартиран и работи, докато всъщност не функционира. Например, вашето приложение използва Apache като уеб сървър и сте инсталирали компонента на няколко pod-а в клъстера. Поради некоректно конфигуриране на библиотеката, всички заявки към приложението получават код 500 (вътрешна грешка на сървъра). При проверката на доставката, проверката на състоянието на pod-овете дава успешен резултат, но клиентите не мислят така. Нежеланата ситуация можем да опишем следния начин:
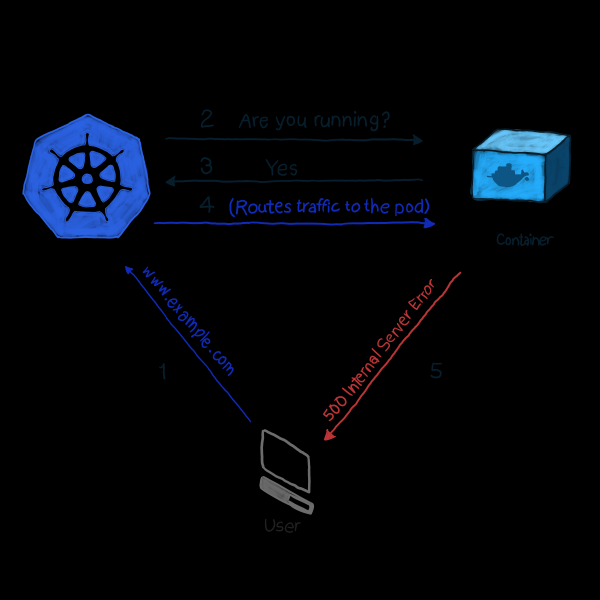
В нашия пример k8s извършва проверка на работоспособността. С този вид проверка kubelet постоянно проверява състоянието на процеса в контейнера. Достатъчно му е да разбере, че процесът е спряL и той го рестартира. Ако грешката се отстранява с прост рестарт на приложението и програмата е проектирана да се изключва при всяка грешка, тогава за спазване на НОР и Шаблона за проверка на работоспособността е достатъчно проверката на работоспособността на процеса. Жалко е само, че не всички грешки могат да се отстранят с рестарт. В този случай k8s предлага 2 по-дълбоки начина за откриване на неизправности в работата на pod’а: и .
LivenessProbe
По време на livenessProbe kubelet извършва 3 типа проверки: не само установява, дали pod’ът работи, но и дали е готов да получава и адекватно да отговаря на запитвания:
- Да се определи HTTP запитване към pod’а. Отговорът трябва да съдържа HTTP код на отговор в диапазона от 200 до 399. По този начин кодовете 5хх и 4хх сигнализират, че pod’ът има проблеми, дори и процесът да работи.
- За проверка на pod’ове с не-HTTP услуги (например, пощенския сървър Postfix) трябва да се установи TCP свързване.
- Изпълнение на произволна команда за pod’а (вътрешно). Проверка се счита за успешна, ако кодът на завършване на командата е – 0.
Пример за това как работи. Определението на следния pod съдържа приложение на NodeJS, което при HTTP запитвания връща грешка 500. За да се уверим, че контейнерът се рестартира, получаваща такава грешка, използваме параметъра livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Това не се различава от всяко друго определение на pod, но добавяме обект .spec.containers.livenessProbe. Параметърът httpGet приема пътя, по който изпраща HTTP GET заявка (в нашия пример това е /, но в бойни сценарии може да бъде нещо подобно на /api/v1/status). Освен това livenessProbe приема параметър initialDelaySeconds, който предписва операциите за проверка да изчакат зададеното количество секунди. Забавянето е необходимо, тъй като контейнерът изисква време за стартиране, а при рестарт той ще бъде недостъпен за известно време.
За да приложите тази настройка към клъстера, използвайте:
kubectl apply -f pod.yamlСлед няколко секунди можете да проверите съдържанието на pod’а с помощта на следната команда:
kubectl describe pods node500В края на изхода намерете .
Както можете да видите, livenessProbe инициира HTTP GET заявка, контейнерът върна грешка 500 (както и беше програмирано), kubelet го рестартира.
Ако ви интересува как е програмирано NideJS приложението, ето файла app.js и Dockerfile, които бяха използвани:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Срещнахме грешка
");
});

server.listen(3000, function() {
    console.log('Сървърът работи на порт 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Важно е да се обърне внимание на следното: livenessProbe ще рестартира контейнера само при отказ. Ако рестартирането не реши грешката, която пречи на работата на контейнера, kubelet няма да може да предприеме мерки за отстраняване на неизправността.
readinessProbe
readinessProbe работи по аналогичен начин на livenessProbes (GET заявки, TCP връзки и изпълнение на команди), с изключение на действията за отстраняване на неизправности. Контейнер, в който е установена неизправност, не се рестартира, а се изолира от входящия трафик. Представете си, че един от контейнерите извършва много изчисления или е под тежко натоварване, поради което времето за отговор на заявките нараства. При livenessProbe се задейства проверка на наличността на отговора (чрез параметъра timeoutSeconds), след което kubelet рестартира контейнера. При рестартиране контейнерът започва да изпълнява ресурсоемки задачи и отново се рестартира. Това може да бъде критично за приложения, за които скоростта на отговор е важна. Например, машина по пътя очаква отговор от сървъра, ако отговорът закъснява - и машината се сблъсква.
Нека напишем определение на redinessProbe, което да зададе време за отговор на GET заявката не повече от две секунди, а приложението да отговаря на GET заявка след 5 секунди. Файлът pod.yaml трябва да изглежда по следния начин:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Нека развернем pod с kubectl:
kubectl apply -f pod.yamlДа изчакаме няколко секунди и след това да видим как сработи readinessProbe:
kubectl describe pods nodedelayedВ края на изхода можете да видите, че част от събитията е аналогична .
Както виждате, kubectl не рестартира pod-а, когато времето за проверка надмина 2 секунди. Вместо това той отмени заявката. Входящите връзки се пренасочват към други работещи pod-ове.
Обърнете внимание: сега, когато излишното натоварване от pod-а е премахнато, kubectl отново насочва заявките към него: отговорите на GET заявките вече не се забавят.
За сравнение: по-долу е приложен промененият файл app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Сървърът работи на порт 3000')
})
TL;DR
Преди появата на облачни приложения основният инструмент за мониторинг и проверка на състоянието на приложенията бяха логовете. Въпреки това, нямаше инструменти за предприемане на мерки при проблеми. Логовете и днес са полезни, те трябва да се събират и изпращат в системата за събиране на логове за анализ на аварийни ситуации и вземане на решения. [всичко това можеше да се прави и без облачни приложения с помощта на monit, например, но с k8s стана много по-лесно 🙂 – забележка на редактора. ]
Днес обаче поправките трябва да се правят почти в реално време, поради което приложенията вече не трябва да бъдат черни кутии. Не, те трябва да показват крайни точки, позволяващи на мониторинговите системи да запитват и събират ценни данни за състоянието на процесите, за да реагират мигновено при необходимост. Това се нарича Шаблон за проектиране на проверка на работоспособността, който следва Принципа на висока наблюдаемост (СНО).
Kubernetes по подразбиране предлага 2 вида проверки на работоспособността: readinessProbe и livenessProbe. И двете използват еднакви типове проверки (HTTP GET заявки, TCP връзки и изпълнение на команди). Те се различават в това, какви решения вземат в отговор на проблеми в pod-овете. livenessProbe рестартира контейнера в надеждата, че грешката няма да се повтори, а readinessProbe изолира pod-а от входящия трафик – до отстраняването на причината за проблема.
Правилното проектиране на приложението трябва да включва и двата вида проверки и да събира достатъчно данни, особено когато е създадена извънредна ситуация. То трябва също така да показва необходимите API крайни точки, които предават важни метрики за работоспособността на системата за мониторинг (същия Prometheus).
Източник: habr.com
