

Ако сте като повечето хора, вероятно използвате ресурси, които функционират извън вашия клъстер. Може би използвате API на Taleo за изпращане на текстови съобщения или анализирате изображения с API на Google Cloud Vision.
Ако използвате една и съща крайна точка endpoint — точка за приемане на заявки на страна на сървъра във всичките си среди и не планирате да прехвърлите сърверите си в Kubernetes, е напълно нормално да имате endpoint на услугата направо в кода си. Въпреки това, съществуват множество други сценарии. В тази серия „Най-добрите практики на Kubernetes“ ще научите как да използвате вградените механизми на Kubernetes за откриване на услуги както вътре, така и извън клъстера.
Като пример за широко разпространена външна услуга може да се посочи база данни, работеща извън клъстера Kubernetes. За разлика от облачните бази данни като Google Cloud Data Store или Google Cloud Spanner, които използват една крайна точка за всички видове достъп, повечето бази данни имат отделни крайни точки за различни обстоятелства.
Предварителната практика при използване на традиционни бази данни, като MySQL и MongoDB, обикновено изисква да се свързвате с различни компоненти в различни среди. Може да имате голям сървър за продукционни данни и по-малък сървър за тестова среда. Всеки от тях ще има свой IP адрес или домейн име, но със сигурност не искате да променяте кода си при преминаване от една среда в друга. Затова вместо да кодите твърдо тези адреси, можете да използвате вграденото в Kubernetes откриване на външни услуги на базата на DNS точно както за нативните услуги на Kubernetes.
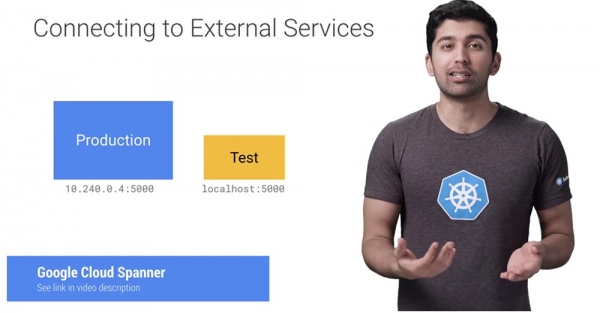
Предположете, че стартирате база данни MongoDB в Google Compute Engine. Ще останете в този хибриден свят, докато не успеете да я прехвърлите в клъстера.
На щастие, можете да използвате статични услуги на Kubernetes, за да си облекчите живота поне малко. В този пример създадох сървър MongoDB, използвайки Google Cloud Launcher. Тъй като е създаден в същата мрежа (или VPC на клъстера Kubernetes), достъпът до него се осъществява чрез високопроизводителен вътрешен IP адрес.
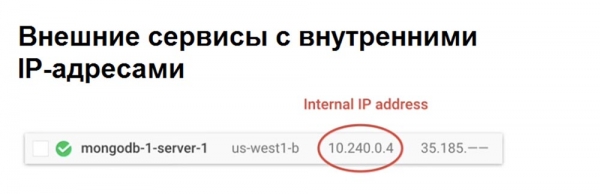
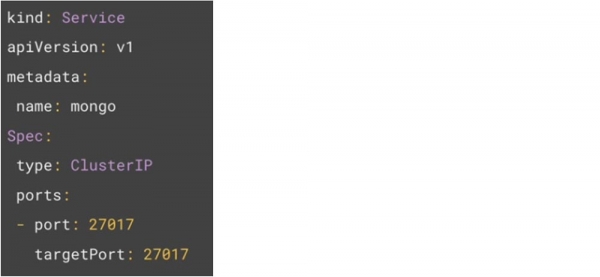
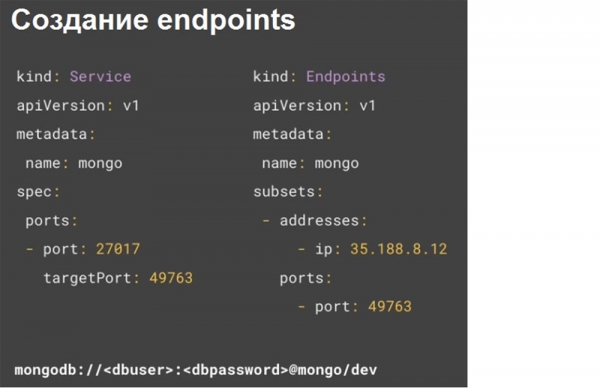
В Google Cloud това е настройка по подразбиране, така че не е нужно да конфигурирате нищо. Сега, когато имате IP адрес, първата стъпка е създаването на услуга. Можете да забележите, че за тази услуга няма селектори на подовете. Тоест, създадохме услуга, която няма да знае къде да изпраща трафик. Това позволява ръчно да създадете обект на endpoint, който ще получава трафик от тази услуга.
Следващият пример за код показва, че крайните точки определят IP адрес за базата данни, използвайки същото име mongo, което и услугата.
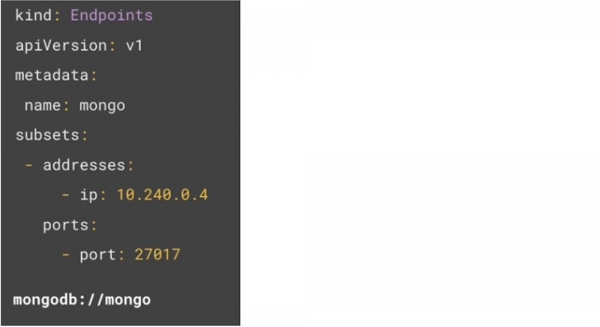
Kubernetes ще използва всички IP адреси, за да намери крайните точки, както ако те бяха обикновени подове на Kubernetes, така че сега можете да получите достъп до базата данни с проста стринг за свързване на гореспоменатото име mongodb://mongo. При това не е необходимо изобщо да използвате IP адреси в кода си.
Ако в бъдеще IP адресите се променят, можете просто да обновите крайните точки с новия IP адрес, и приложенията ви няма да трябва да бъдат променяни по никакъв допълнителен начин.
Ако използвате база данни, хоствана на външен хост, то вероятно собствениците на хоста ви предоставили унифициран идентификатор на ресурса URI за свързване. Така че, ако сте получили IP адрес, можете просто да се възползвате от предишния метод. Този пример показва, че имам две MongoDB бази данни, хоствани на mLab.
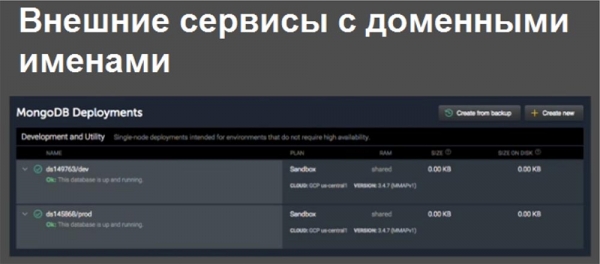
Едната е база данни за разработчици, а другата – продукционна БД. Стринг за свързване на тези бази данни изглеждат по следния начин – mLab ви осигурява динамичен URI и динамичен порт. Както виждате, те са различни.
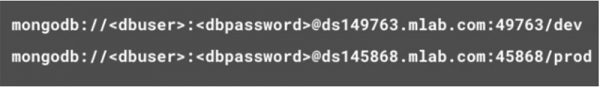
За да се абстрахираме от това, използваме Kubernetes и се свързваме с базата данни за разработчици. Можете да създадете външно име на услугата Kubernetes, което ще ви предостави статична услуга, която ще пренасочва трафик към външната услуга.
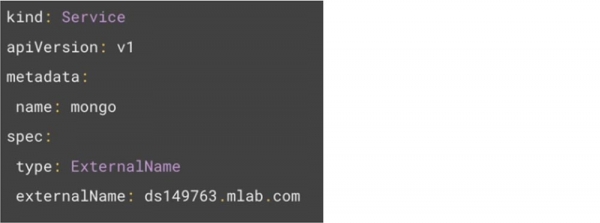
Тази услуга ще извърши проста CNAME пренасочване на ниво ядро, което ще има минимално влияние върху производителността. Благодарение на това можете да използвате по-проста стринг за свързване.

Но тъй като външното име използва пренасочване CNAME, то не може да изпълнява преназначение на портове. Следователно, това решение е приложимо само за статични портове и не може да се използва с динамични портове. Обаче безплатният mLab Free Tier по подразбиране предоставя на потребителя динамичен номер на порта, и вие не можете да го промените. Това означава, че за dev и prod ви трябват различни команди за свързване. Лошото е, че ще трябва да кодиране номерът на порта. Как да накарате да работи пренасочването на портовете?
Първата стъпка е да получите IP адреса от URI. Ако изпълните команда nslookup, hostname или пингнете URI, можете да получите IP адреса на базата данни. Ако услугата при това ви върне няколко IP адреса, всички тези адреси могат да се използват в крайните точки на обекта.
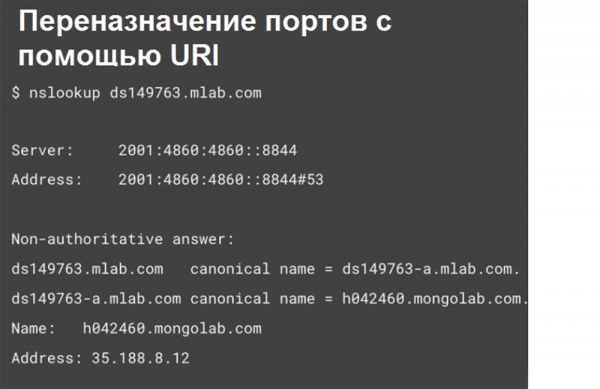
Трябва да запомните, че IP адресите на URI могат да се променят без предизвестие, така че е доста рисковано да се използват в prod. С такъв IP адрес можете да се свържете с отдалечена база данни, без да посочвате порта. Следователно, услугата Kubernetes доста прозрачно изпълнява пренасочването на портовете.
Мапингът, или съпоставянето на външни ресурси с вътрешни, ви дава възможност да използвате тези услуги гъвкаво в бъдеще в кластерите, като минимизирате усилията за рефакторинг. Той също така улеснява управлението и дава разбиране за това, какви външни услуги използва вашата компания.
Продължението ще бъде скоро...
Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
