

Управлението на разпределени системи може да бъде предизвикателство, тъй като те съдържат много подвижни и променливи елементи, които трябва да функционират нормално, за да осигурят работоспособността на системата. Ако един от елементите се провали, системата трябва да го открие, да го обходи и да го поправи, всичко това трябва да се извърши автоматично. В тази серия "Kubernetes Best Practices" ще научим как да настройваме тестове за Readiness и Liveness за проверка на жизнеспособността на Kubernetes клъстера.
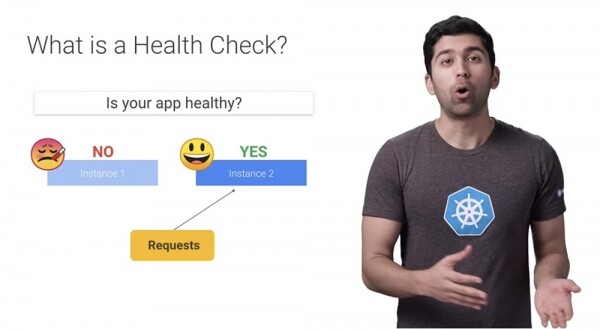
Здравният тест Health Check е прост начин да уведомите системата дали вашето приложение работи или не. Ако вашето приложение не функционира, другите услуги не трябва да се свързват с него или да му изпращат заявки. Вместо това, заявките трябва да бъдат насочвани към друг екземпляр на приложението, който вече работи или ще бъде стартиран по-късно. Освен това, системата трябва да възстанови работоспособността на вашето приложение.
По подразбиране Kubernetes започва да изпраща трафик към pod, когато всички контейнери в подовете са стартирани, и рестартира контейнерите, когато те завършат аварийно. За начало, това поведение по подразбиране може да е достатъчно добро, но можете да повишите надеждността на разгръщането на продукта си, като използвате персонализирани проверки за работоспособност.
За щастие, Kubernetes позволява да се извърши това доста лесно, така че няма оправдания за игнориране на подобни проверки. Kubernetes предлага два типа тестове Health Check и е важно да се разберат разликите в прилагането на всеки от тях.
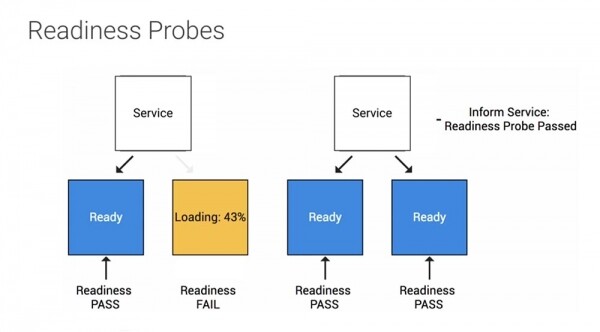
Тестът за готовност Readiness е предназначен да информира Kubernetes за готовността на вашето приложение да обслужва трафик. Преди да разреши на услугата да изпраща трафик към pod, Kubernetes трябва да се увери в успешността на теста за готовност. Ако тестът Readiness се провали, Kubernetes ще спре да изпраща трафик към pod, докато тестът не премине успешно.
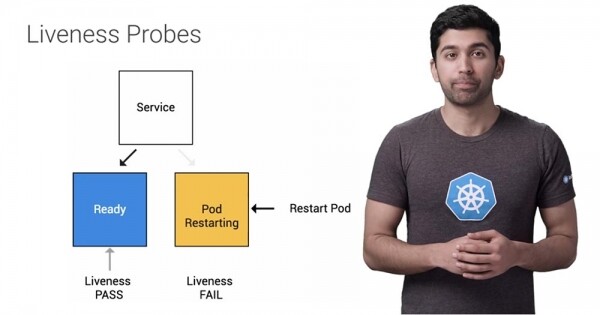
Тестът за жизнеспособност Liveness информира Kubernetes дали вашето приложение е живо или мъртво. В първия случай Kubernetes ще остави приложението на мира, а в втория ще премахне непригодния pod и ще го замени с нов.
Представете си сценарий, в който на вашето приложение е нужно 1 минута за "разогрев" и стартиране. Вашият сервис няма да започне работа, докато приложението не се зареди и не стартира напълно, въпреки че работният процес вече е започнал. В допълнение, ще имате проблеми, ако искате да увеличите мащаба на това разгръщане до няколко копия, тъй като тези копия не трябва да получават трафик, докато не са напълно готови. Въпреки това, по подразбиране Kubernetes ще започне да изпраща трафик веднага след стартиране на процесите вътре в контейнера.
При използване на теста за готовност Readiness, Kubernetes ще изчака, докато приложението не бъде напълно стартирано и едва след това ще позволи на сервиса да изпраща трафик на новата копия.
Представете си друг сценарий, при който приложението се засяда за дълго време и спира да обслужва заявки. Тъй като процесът продължава да работи, по подразбиране Kubernetes ще сметне, че всичко е наред и ще продължи да изпраща заявки към неработещия pod. Но при използване на Liveness, Kubernetes ще открие, че приложението вече не обслужва заявки и по подразбиране ще рестартира неработещия pod.
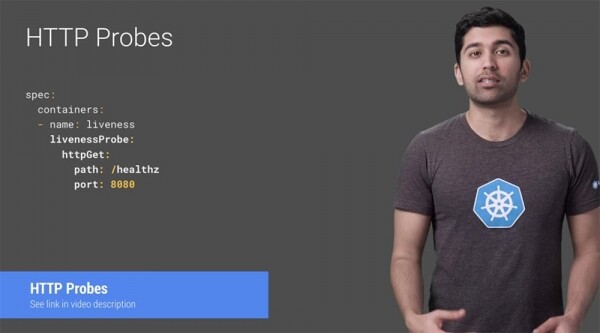
Нека да разгледаме как се тестват готовността и жизнеспособността. Съществуват три начина за тестване — HTTP, Сommand и TCP. Можете да използвате всеки от тях за проверка. Най-разпространеният начин за потребителски тест е HTTP probe.
Дори ако вашето приложение не е HTTP-сървър, все още можете да създадете лек HTTP-сървър вътре в приложението си за взаимодействие с теста Liveness. След това Kubernetes ще започне да пингва pod-а и ако HTTP отговорът е в диапазона 200 или 300 мс, това ще означава, че pod-ът е "здрав". В противен случай модулът ще бъде означен като "нездрав".
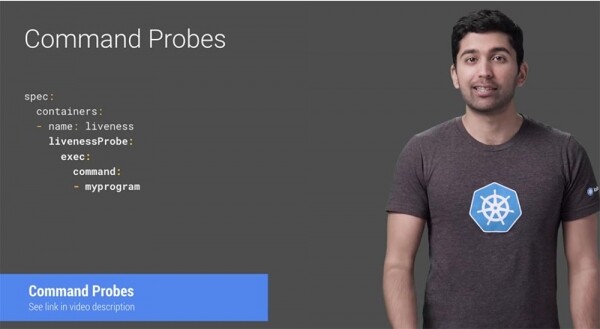
За тестовете с помощта на Command Kubernetes изпълнява команда вътре в контейнера ви. Ако командата се върне с нулев exit код, контейнерът ще бъде означен като здрав, в противен случай, при получаване на число от exit статус между 1 и 255, контейнерът ще бъде обозначен като "болен". Този метод на тестване е полезен, ако не можете или не искате да стартирате HTTP-сървър, но имате възможност да стартирате команда, която да провери "здравето" на приложението ви.
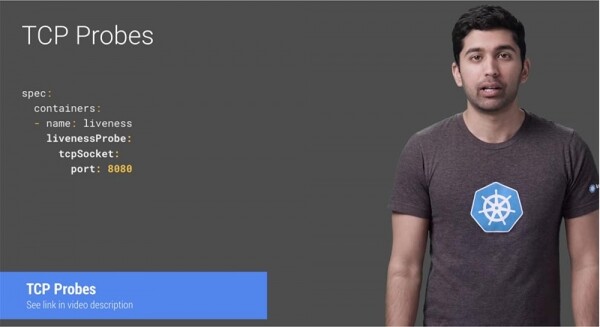
Последният механизъм за проверка е TCP теста. Kubernetes ще се опита да установи TCP връзка на зададения порт. Ако това успее, контейнерът се счита за здрав, а ако не – за нежизнеспособен. Този метод може да е полезен, ако използвате сценарий, при който тестът с HTTP заявка или изпълнението на команда не работят много добре. Например, основните услуги за проверка с TCP ще бъдат gRPC или FTP.
Тестовете могат да бъдат конфигурирани по няколко начина с различни параметри. Можете да укажете колко често да се извършват, какви са праговете за успех и провал, и колко дълго да чакате за отговори. По-подробна информация е изложена в документацията за тестовете Readiness и Liveness. Въпреки това, има един много важен аспект в настройката на теста Liveness – началната настройка на забавянето на теста initialDelaySeconds. Както споменах, неуспешното изпълнение на този тест ще доведе до рестартиране на модула. Следователно, трябва да се уверите, че тестът няма да започне, докато приложението не е готово за работа, иначе то ще започне циклично да се рестартира. Препоръчвам да използвате P99 времето за стартиране или средното време за стартиране на приложението от буфера. Не забравяйте да коригирате това значение, когато времето за стартиране на приложението става все по-бързо или по-бавно.
Повечето специалисти ще потвърдят, че Health Check е задължителна проверка за всяка разпределена система, и Kubernetes не е изключение. Използването на проверка за "здраве" на услугите осигурява надеждно и безотказно функциониране на Kubernetes и не представлява трудност за потребителите.
Продължението ще бъде скоро...
Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
