

Класификация на данни въз основа на съдържание е отворена задача. Традиционните системи за предотвратяване на загуба на данни (DLP) решават този проблем, като извършват пръстови отпечатъци на съответните данни и мониторинг на крайни точки за събиране на отпечатъци. Имайки предвид голямото количество постоянно променящи се ресурси в Facebook, този подход не само че не е мащабируем, но и неефективен за определяне на местоположението на данните. Тази статия е посветена на цялостна система, изградена за откриване на чувствителни семантични типове в Facebook в мащаб и автоматично осигуряване на съхранение на данни и контрол на достъпа.
Описаният тук подход е нашата първа цялостна система за конфиденциалност, която се опитва да реши този проблем, като включва сигналите на данни, машинно обучение и традиционни методи за пръстови отпечатъци за визуализация и класификация на всички данни в Facebook. Описаната система работи в производствена среда, постигаща среден F2 резултат от 0,9+ в различни класове на конфиденциалност при обработка на голямо количество ресурси в десетки хранилища. Представяме превод на публикацията на Facebook в ArXiv за мащабируема класификация на данни за осигуряване на сигурност и конфиденциалност, основана на машинно обучение.
Въведение
Днес организациите събират и съхраняват големи обеми данни в различни формати и места [1], след което данните се използват на много места, понякога се копират или кешират няколко пъти, в резултат на което ценната и конфиденциална бизнес информация се разпростира в множество корпоративни хранилища от данни. Когато от организацията се изисква да изпълни определени правни или регулаторни изисквания, например, да спазва наредби по време на гражданското производство, възниква необходимостта от събиране на данни относно местоположението на необходимите данни. Когато в постановлението за конфиденциалност се посочва, че организацията трябва да маскира всички номера на социално осигуряване (SSN) при предаване на лична информация на неупълномощени субекти, естествената първа стъпка е да се намерят всички SSN в хранилищата на данни на цялата организация. При такива обстоятелства класификацията на данните придобива решаващо значение [1]. Класификационната система ще позволи на организациите автоматично да осигурят спазването на конфиденциалността и политиките за сигурност, като например включване на политика за управление на достъпа и запазване на данните. Facebook предлага система, изградена от нас във Facebook, която използва множество сигнали за данни, мащабируема системна архитектура и машинно обучение за откриване на чувствителни семантични типове данни.
Откритие и класификация на данни — това е тяхното търсене и маркиране по начин, който да позволи бързо и ефективно извличане на съответната информация при необходимост. Сегашният процес е по-скоро ръчен и включва изучаване на съответните закони или регулации, определяне на кои типове информация трябва да се считат за чувствителни и какви са различните нива на чувствителност, след което да се изградят подходящи класове и политику за класификация [1]. След системата за защита от загуба на данни (DLP), данните се отпечатват и се проследяват крайните точки надолу по веригата за получаване на отпечатъци. При работа с хранилище, съдържащо много активи и петабайти данни, такъв подход просто не е мащабируем.
Нашата цел е да изградим система за класификация на данни, която да се мащабира както за устойчиви, така и за неустойчиви потребителски данни, без никакви допълнителни ограничения по тип или формат на данните. Това е смела цел и, разбира се, идва с предизвикателства. Някаква запис на данни може да бъде дълга хиляди символи.
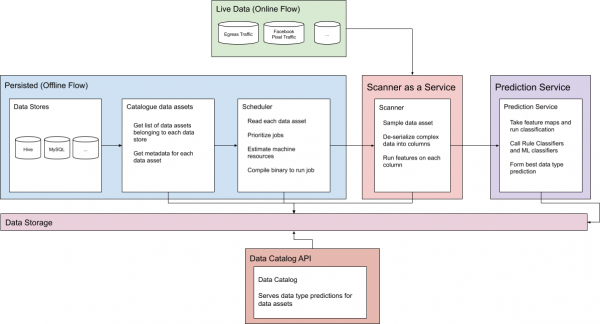
Рис. 1. Поток на онлайн и офлайн прогнозиране
Затова трябва ефективно да я представим, използвайки общ набор от характеристики, които впоследствие могат да бъдат комбинирани и лесно премествани. Тези характеристики трябва не само да осигурят точна класификация, но също така да предоставят гъвкавост и мащабируемост за лесно добавяне и откриване на нови типове данни в бъдеще. На второ място, трябва да се справим с големи автономни таблици. Устойчивите данни могат да се съхраняват в таблици с размери в много петабайта. Това може да доведе до намалена скорост на сканиране. На трето място, трябва да спазваме строга класификация на SLA за неустойчиви данни. Това налага системата да бъде високо ефективна, бърза и точна. Накрая, трябва да осигурим класификация на данните с ниска латентност за неустойчивите данни, за да изпълняваме класификация в реално време, както и за интернет случаи на употреба.
В тази статия се описва как се справихме с гореспоменатите проблеми и се представя бърза и мащабируема система за класификация, която класифицира елементи от данни от всички типове, формати и източници, базирана на общ набор от характеристики. Разширихме системната архитектура и създадохме специален модел за машинно обучение за бърза класификация на офлайн и онлайн данни. Тази статия е организирана по следния начин: в раздел 2 е представен общият дизайн на системата. В раздел 3 се обсъждат частите на системата за машинно обучение. В раздели 4 и 5 се говори за свързаната работа и се описва бъдещето направление на работата.
Архитектура
За да се справим с проблемите на устойчивите данни и онлайн данните в мащаб като Facebook, системата за класификация има два отделни потока, които ще обсъдим подробно.
Устойчиви данни
Първоначално системата трябва да идентифицира множество информационни активи на Facebook. За всяко хранилище се събира основна информация, като например център за данни, който съдържа тези данни, системата с тези данни и активите, разположение в конкретното хранилище на данни. Това формира каталог с метаданни, позволяващ на системата да извлича данни ефективно, без да натоварва клиентите и ресурсите, използвани от други инженери.
Този каталог с метаданни предоставя надежден източник за всички сканирани активи и позволява проследяване на състоянието на различни активи. С помощта на тази информация се определя приоритетът на планирането в зависимост от събраните данни и вътрешната информация от системата, като времето на последното успешно сканиране на актива и времето на създаване, както и предишните изисквания за памет и процесор за този актив, ако той е бил сканиран преди. След това, за всеки ресурс на данни (когато ресурсите станат налични) се извиква задача за действителното сканиране на ресурса.
Всяка задача е компилиран бинарен файл, който извършва Бернулев избор на последните данни, налични за всеки актив. Активът се разделя на отделни колони, където резултатът от класификацията на всяка колона се обработва независимо. Освен това системата сканира всякакви наситени данни в колоните. JSON, масиви, кодирани структури, URL адреси, сериализирани данни base 64 и много други — всичко това се сканира. Това може значително да увеличи времето за изпълнение на сканирането, тъй като една таблица може да съдържа хиляди вложени колони в голям бинарен обект. json.
За всяка избрана редица в актива на данни, системата за класификация извлича плаващи и текстови обекти от съдържанието и свързва всеки обект обратно с колоната, от която е взета. Резултатът от етапа на извличане на обекти е карта на всички обекти за всяка намерена в актива на данни колона.
За какво са нужни признаците?
Понятието за признаците е ключов момент. Вместо признаците float и text можем да предаваме необработени образци на низове, които са извлечени директно от всеки ресурс на данни. Освен това моделите на машинно обучение могат да се обучават директно върху всяка извадка, а не върху стотици изчисления на признаци, които само се опитват да приближат извадката. Има няколко причини за това:
- Конфиденциалността е на първо място: най-важното, понятието за признаците ни позволява да запазваме в паметта само тези образци, които извличаме. Това гарантира, че съхраняваме образците за единствена цел и никога не ги регистрираме с нашите собствени усилия. Това е особено важно за нестабилни данни, тъй като услугата трябва да поддържа определено състояние на класификация, преди да предостави прогноза.
- Памет: някои образци могат да имат дължина в хиляди символи. Съхранението на такива данни и предаването им на различни части от системата без нужда консумира много допълнителни байтове. Два фактора могат да се комбинират с времето, имайки предвид, че има много ресурси на данни с хиляди колони.
- Агрегиране на признаци: чрез признаците, техният набор ясно представя резултатите от всяко сканиране, което позволява на системата да комбинира резултатите от предишни сканирания на един и същ ресурс на данни по удобен начин. Това може да бъде полезно за агрегиране на резултатите от сканирането на един ресурс на данни в няколко пуска.
След това признаците се изпращат в услугата за прогнозиране, където използваме класификация на базата на правила и машинно обучение за прогнозиране на етикетите на данните за всяка колона. Услугата разчита както на класификатори на правила, така и на машинно обучение и избира най-добрата прогноза, предоставена от всеки обект за прогнозиране.
Класификаторите на правила са ръчна хевристика, която използва изчисления и коефициенти за нормализиране на обекта в диапазона от 0 до 100. След като такъв начален резултат се генерира за всеки тип данни и име на колона, свързано с тези данни, което не попада в нито един „списък с ограничения“, класификаторът на правила избира най-високия нормализиран резултат сред всички типове данни.
Поради сложността на класификацията, използването изцяло на ръчни евристики води до ниска точност на класификацията, особено за неструктурирани данни. Поради тази причина разработихме система за машинно обучение, която да работи с класификацията на неструктурирани данни, като потребителско съдържание и адреси. Машинното обучение ни позволи да започнем да се отдалечаваме от ръчната евристика и да прилагаме допълнителни данни за сигналите (например, имена на колони, произход на данни), което значително повиши точността на откритията. По-късно ще се задълбочим в нашата архитектура за машинно обучение.
Услугата за прогнозиране съхранява резултатите за всяка колона заедно с метаданни, свързани с времето и състоянието на сканирането. Всички потребители и зависимости, които разчитат на тези данни, могат да ги извлекат от ежедневно публикуван набор от данни. Този набор агрегира резултатите от всички тези сканирания, или реално време API на каталога с данни. Публикуваните прогнози представляват основата на автоматичното прилагане на политика за поверителност и сигурност.
Накрая, след като служба прогнозиране запише всички данни и всички прогнози бъдат съхранени, нашето API на каталога с данни може да връща всички прогнози за видове данни за ресурса в реално време. Всеки ден системата публикува набор от данни, съдържащ всички последни прогнози за всеки актив.
Несъхранявани данни
Въпреки че описаният по-горе процес е създаден за съхранявани активи, несъхраняваният трафик също се счита за част от данните на организацията и може да бъде важен. Поради тази причина системата предоставя онлайн API за генериране на прогнози за класификация в реално време за всички несъхранявани трафици. Системата за прогнозиране в реално време е широко използвана при класификацията на изходящия трафик и входящия трафик в моделите за машинно обучение и на данни от рекламодатели.
Тук API приема два основни аргумента: ключ за групиране и необработени данни, които трябва да бъдат прогнозирани. Услугата извършва същото извличане на обекти, описано по-горе, и групира обектите заедно по един и същ ключ. Тези характеристики също се поддържат в запазеното кеширане за възстановяване след отказ. За всеки ключ за групиране службата гарантира, че преди извикването на прогнозистката услуга е видяла достатъчно извадки в съответствие с процеса, описан по-горе.
Оптимизация
За сканиране на някои хранилища използваме библиотеки и методи за оптимизиране на четенето от горещо хранилище [2] и гарантираме, че няма сривове от други потребители, получаващи достъп до същото хранилище.
За изключително големи таблици (50 + петабайта), независимо от всички оптимизации и ефективност на паметта, системата работи по сканирането и изчисляването на всичко, преди да свърши паметта. В крайна сметка, сканирането се изчислява напълно в паметта и не се запазва по време на сканирането. Ако големите таблици съдържат хиляди колони с неструктурирани купчини данни, задачата може да се провали поради недостатъчност на ресурси в паметта при извършване на прогнози за цялата таблица. Това ще доведе до намаляване на покритието. За да се борим с това, оптимизирахме системата да използва скоростта на сканиране като посредник в това, колко добре системата се справя с текущото натоварване. Използваме скоростта като прогностичен механизъм, за да видим проблеми с паметта и при проактивното изчисление на картата на обектите. По този начин използваме по-малко данни, отколкото обикновено.
Сигнали от данни
Системата за класификация е добра толкова, колкото добри са сигналите от данните. Тук ще разгледаме всички сигнали, използвани от системата за класификация.
- На базата на съдържанието: разбира се, първият и най-важен сигнал е съдържанието. Извършва се Бернулли проверка за всеки актив от данни, който сканираме и извличаме характеристики на съдържанието на данните. Много от характеристиките произтичат от съдържанието. Може да има всякакво количество плаващи обекти, които представят изчисления за това колко често е наблюдаван определен тип образец. Например, можем да имаме индикатори за количеството електронни писма, видени в извадката, или признаци за това колко усмивки са забелязани в извадката. Тези изчисления на характеристиките могат да се нормализират и агрегират по различни сканирания.
- Произход на данните: важен сигнал, който може да помогне, когато съдържанието се е променило от родителската таблица. Често срещан пример са хешираните данни. Когато данните в дъщерната таблица се хешират, те често идват от родителската таблица, където остават в открит вид. Данните за произхода помагат да се класифицират определени типове данни, когато не могат да бъдат прочетени ясно или са преобразувани от таблицата нагоре по потока.
- Анотации: още един висококачествен сигнал, който помага в идентификацията на неструктурирани данни. Всъщност анотациите и данните за произхода могат да работят заедно, за да разпространят атрибутите между различни активи от данни. Анотациите помагат да се идентифицира източника на неструктурирани данни, докато данните за произхода могат да помогнат да се проследи потока на тези данни в цялото хранилище.
- Инжекция на данни е метод, при който умишлено се въвеждат специални, нечитаеми символи в известни източници с известни типове данни. След това, всеки път, когато сканираме съдържанието с една и съща нечитаема последователност от символи, можем да заключим, че съдържанието произтича от този известен тип данни. Това е още един качествен сигнал за данни, подобен на анотациите. Освен това, откритията на базата на съдържанието помагат за откритие на въведените данни.
Измерване на метрики
Важен компонент е строгата методология за измерване на метрики. Основните метрики за итерации за подобряване на класификацията са точността и отзивът на всяка етикет, като оценката F2 е най-важна.
За да се изчислят тези показатели, е необходима независима методология за маркиране на данни, която не зависи от самата система, но може да се използва за пряко сравнение с нея. По-долу ще опишем как събираме основната истина от Facebook и я използваме за обучение на нашата система за класификация.
Събиране на надеждни данни
Н accumulăm reliable data from each source listed below, into its own table. Each table is responsible for aggregating the latest observed values from that specific source. Each source has a data quality check to ensure that the observed values for each source are of high quality and contain the latest data type labels.
- Конфигурации на платформата за логване: определени полета в таблиците на хнета се запълват с данни, които принадлежат на определен тип. Използването и разпространението на тези данни служи като надежден източник на надеждни данни.
- Ръчно маркиране: разработчиците, поддържащи системата, както и външни маркировчици, са обучени да маркират колоните. Това обикновено работи добре за всички видове данни в хранилището и може да бъде основен източник на надеждност за някои неструктурирани данни, като данни от съобщения или потребителско съдържание.
- Колоните от родителските таблици могат да бъдат обозначавани или анотирани като съдържащи определени данни, и ние можем да проследяваме тези данни в по-ниските таблици.
- Иземване на поточните потоци: поточните потоци в Facebook съдържат данни от определен тип. Използвайки нашия скенер като услужна архитектура, можем да изтегляме потоци с известни типове данни и да ги изпращаме през системата. Системата обещава да не съхранява тези данни.
- Таблици за изборка: големи таблици от хнета, за които е известно, че съдържат целия набор от данни, също могат да се използват като обучаващи данни и да се предават през скенера като услуга. Това е отлично решение за таблици с пълен набор от данни, така че иземването на колона произволно е еквивалентно на избора на целия набор от този тип данни.
- Синтетични данни: можем да използваме дори библиотеки, които генерират данни в реално време. Това работи добре за прости, публично достъпни видове данни, като адреси или GPS.
- Данни стюарди: програмите за поверителност обикновено използват данни стюарди за ръчно прилагане на политики върху части от данните. Това служи като високодостоверен източник на точност.
Обединяваме всеки основен източник на надеждни данни в един корпус с всички тези данни. Най-голямата проблема с достоверността е да се уверим, че тя е представителна за хранилището на данни. В противен случай, класификационните механизми могат да бъдат преобучени. В борбата с това, всички горепосочени източници се използват, за да се осигури баланс при обучението на модели или изчисляването на метрики. Освен това, хората маркировчи равномерно вземат различни колони от хранилището и съответно маркират данните, така че сборът на надеждните стойности да остане безпристрастен.
Непрекъсната интеграция
За да осигурим бърза итерация и подобрение, е важно винаги да измерваме производителността на системата в реално време. Можем да измерваме всяко подобрение в класификацията в сравнение с днешната система, така че тактически можем да насочим данните в бъдещите подобрения. Тук ще разгледаме как системата завършва цикъла на обратната връзка, който се осигурява от надеждни данни.
Когато системата за планиране се сблъска с актив, който има етикет от надежден източник, планираме две задачи. Първата използва нашия производствен скенер и по този начин нашите производствени възможности. Втората задача използва скенера на последната версия с най-новите признаци. Всяка задача записва своя изход в собствена таблица, маркирайки версиите с резултатите от класификацията.
Така сравняваме резултатите от класификацията на релиз кандидат и производствена модел в реално време.
Докато наборите данни сравняват признаците RC и PROD, се логват множество вариации на класификационния модел на ML за услугата за прогнозиране. Най-ново построеният модел на машинно обучение, текущият модел в продукция и всякакви експериментални модели. Същият подход ни позволява да "разрезаваме" различни версии на модела (агностични към нашите класификатори с правила) и да сравняваме метрики в реално време. Така лесно можем да определим кога експеримент с ML е готов за внедряване в продукция.
Всяка нощ признаците RC, изчислени за този ден, се изпращат в обучителния конвейер на ML, където моделът се обучава на последните признаци RC и оценява представянето си в сравнение с надежден набор от данни.
Всяка сутрин моделът завършва обучението си и автоматично се публикува като експериментален. Той автоматично се добавя в списъка на експерименталните.
Някои резултати
Маркират се над 100 различни типа данни с висока точност. Добре структурирани типове, като електронни писма и телефонни номера, се класифицират с оценка f2 над 0,95. Свободни типове данни, като потребителско съдържание и имена, също работят много добре, с F2 резултати над 0,85.
Ежедневно се класифицира голямо количество отделни колони от устойчиви и неустойчиви данни във всички хранилища. Над 500 терабайта се сканират ежедневно в повече от 10 хранилища за данни. Обхватът на повечето от тези хранилища е над 98%.
С времето класификацията стана много ефективна, тъй като задачите за класификация в запазения автономен поток отнемат средно 35 секунди от сканиране на актива до изчисление на прогнози за всяка колона.
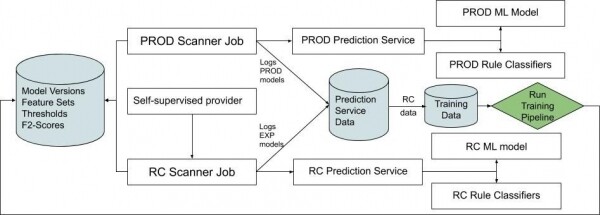
Рис. 2. Диаграма, описваща непрекъснатия поток на интеграция, за да разберем как RC-обектите се генерират и изпращат в модела.
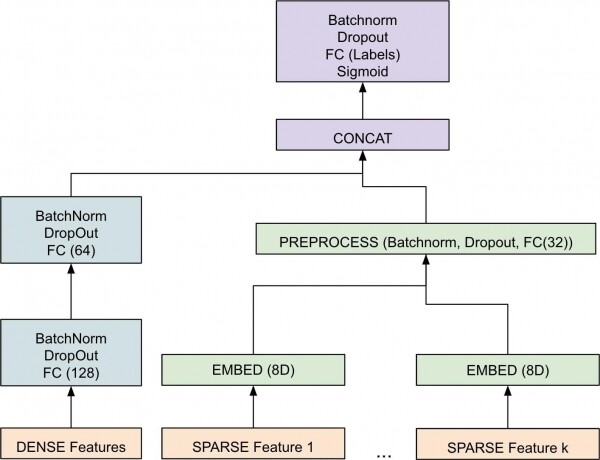
Рис. 3. Високо ниво диаграма на компонента за машинно обучение.
Компонент на системата за машинно обучение
В предишния раздел задълбахме в архитектурата на цялата система, изтъквайки мащаба, оптимизацията и потоковете от данни в автономен и онлайн режим. В този раздел ще разгледаме услугата за прогнозиране и ще опишем системата за машинно обучение, която осигурява работа на службата за прогнозиране.
С повече от 100 типа данни и някои неструктурирани съдържания, като данни от съобщения и потребителско съдържание, използването изцяло на ръчна евристика води до подпараметрична точност на класификацията, особено за неструктурираните данни. Поради тази причина сме разработили и система за машинно обучение, която да се справя с трудностите на неструктурираните данни. Използването на машинно обучение позволява да започнем да се отклоняваме от ръчната евристика и да работим с характеристики и допълнителни сигнали за данни (например, имена на колони, произход на данните) за повишаване на точността.
Реализираната модел изучава векторни представяния [3] над плътни и разредени обекти поотделно. След това те се комбинират, за да формират вектор, който преминава през серия от етапи на пакетна нормализация [4] и нелинейности за получаване на крайния резултат. Крайният резултат е число с плаваща запетая между [0-1] за всеки етикет, указващ вероятността примерът да принадлежи на даден тип чувствителност. Използването на PyTorch за модела ни позволи да напредваме по-бързо, давайки възможност на разработчиците извън екипа бързо да внасят и тестват изменения.
При проектирането на архитектурата беше важно да моделираме разредени (например, текстови) и плътни (например, числови) обекти поотделно заради техните вътрешни различия. За окончателната архитектура също беше важно да се извърши разгръщане на параметрите, за да се намери оптималното значение на скоростта на обучение, размера на пакета и други хиперпараметри. Изборът на оптимизатор също беше важен хиперпараметър. Установихме, че популярният оптимизатор Adamчесто води до пренатоварване, докато моделът с SGD по-стабилен. Имаше допълнителни нюанси, които трябваше да включим директно в модела. Например, статични правила, които гарантираха, че моделът прави детерминирано предсказание, когато характеристиката има определена стойност. Тези статични правила са определени от нашите клиенти. Открихме, че включването им директно в модела е довело до създаване на по-самостоятелна и надеждна архитектура, в контекста на реализацията на етапа на следобработка за обработване на тези специални гранични случаи. Също така, имайте предвид, че по време на обучение тези правила са деактивирани, за да не пречат на тренировъчния процес на градиентното спускане.
Проблеми
Един от проблемите беше събирането на висококачествени достоверни данни. Моделът се нуждае от достоверност за всеки клас, за да може да изучава асоциации между обектите и етикетите. В предишната секция разгледахме методи за събиране на данни както за измерване на системата, така и за обучение на модели. Анализът показа, че такива класове данни, като номера на кредитни карти и банкови сметки, не са особено разпространени в нашето хранилище. Това затруднява събирането на големи количества достоверни данни за обучение на моделите. За да решим този проблем, разработихме процеси за получаване на синтетични достоверни данни за тези класове. Генерираме такива данни за чувствителни типове, включително SSN, номера на кредитни карти и IBAN-номера, за които моделът не е могъл да предсказва преди. Този подход позволява обработката на конфиденциални типове данни без риска от конфиденциалност, свързан с укриването на реални конфиденциални данни.
В допълнение към проблемите с достоверността на данните, съществуват и открити архитектурни проблеми, по които работим, като изолация на промените и ранно спиране. Изолацията на промените е важна, за да се осигури, че при въвеждането на различни изменения в различни части на мрежата, влиянието е изолирано от конкретни класове и не оказва широко влияние върху общата производителност на прогнозите. Подобрението на критериите за ранно спиране също е от решаващо значение, за да можем да спрем тренировъчния процес в стабилна точка за всички класове, а не в точка, където някои класове са прекалено обучени, а други не.
Важността на характеристиката
Когато внедряваме нова характеристика в модела, искаме да знаем нейното общо влияние върху модела. Също така искаме да се уверим, че прогнозите са разбираеми за човека, за да можем точно да разберем кои характеристики се използват за всеки тип данни. Затова разработихме и внедрихме класова важност на характеристиките за модела PyTorch. Обърнете внимание, че това е различно от общата важност на характеристиката, която обикновено се поддържа, защото не ни казва кои характеристики са важни за конкретен клас. Ние измерваме важността на обекта, като изчисляваме увеличението на грешката на прогнозата след преизменение на обекта. Характеристиката е "важна", когато преизменението на стойностите увеличава грешката на модела, тъй като в този случай моделът е разчитал на характеристиката при прогнозиране. Характеристиката е "неважна", когато разбъркването на стойностите й оставя грешката на модела непроменена, тъй като в този случай моделът я е игнорирал.
Важността на характеристиката за всеки клас позволява да направим модела интерпретируем, така че да можем да видим на какво моделът обръща внимание при прогнозиране на етикет. Например, когато анализираме ADDR, ние гарантираме, че свързаната с адреса характеристика, като например AddressLinesCount, заема високо място в таблицата с важността на характеристиките за всеки клас, за да се уверим, че нашата човешка интуиция добре кореспондира с това, което моделът е научил.
Оценка
Важно е да се определи единна метрика за успех. Ние избрахме F2 — баланс между отзивчивост и точност (с малко по-високо тегло върху отзивчивостта). Отзивчивостта е по-важна за случая с конфиденциалност, отколкото точността, тъй като за екипа е изключително важно да не пропусне никакви конфиденциални данни (осигурявайки разумна точност). Фактическите данни за оценка на производителността на нашия модел надхвърлят обхвата на тази статия. Въпреки това, при внимателно настройване, можем да постигнем висок (0,9+) резултат F2 за най-важните чувствителни класове.
Свързана работа
Съществуват много алгоритми за автоматична класификация на неструктурирани документи, използващи различни методи, като шаблонно съответствие, търсене на подобие на документи и различни методи на машинно обучение (байесови, дървета на решения, k-ближайши съседи и много други) [6]. Всеки от тях може да се използва като част от класификацията. Въпреки това, проблемът е в мащабируемостта. Подходът към класификацията в тази статия е насочен към гъвкавост и производителност. Това ни позволява да поддържаме нови класове в бъдеще и да осигурим ниска латентност.
Съществуват и много работи по отпечатването на данни. Например, авторите в [7] описват решение, което се фокусира върху проблема с улавянето на изтичане на конфиденциални данни. Основното предположение е свързано с възможността за отпечатък от данни, за да се съпостави с набор от известни конфиденциални данни. Авторите в [8] описват аналогичен проблем с изтичане на конфиденциалност, но тяхното решение е базирано на конкретна архитектура на Android и се класифицира само когато действията на потребителя водят до изпращане на лична информация или ако в основното приложение има изтичане на лични данни. Ситуацията тук е малко по-различна, тъй като потребителските данни също могат да бъдат силно неструктурирани. Затова ни е необходима по-сложна техника, отколкото отпечатването.
Накрая, за да се справим с липсата на данни за някои видове конфиденциални данни, въведохме синтетични данни. Съществува голям обем литература по аугментация на данни, например, авторите в [9] изследват ролята на инжектирането на шум по време на обучение и наблюдават положителни резултати в контролирано обучение. Нашият подход към конфиденциалността е различен, тъй като въвеждането на шумни данни може да бъде контрапрадуктивно, и вместо това се фокусираме върху висококачествени синтетични данни.
Заключение
В тази статия представяме система, която може да класифицира фрагмент от данни. Това ни позволява да създаваме системи за спазване на политиките за конфиденциалност и сигурност. Показахме, че мащабируемата инфраструктура, непрекъснатата интеграция, машинното обучение и висококачествените данни за автентичността на данните играят ключова роля в успеха на много от нашите инициативи в областта на конфиденциалността.
Има много направления за бъдеща работа. Тя може да включва осигуряване на поддръжка на несхематизирани данни (файлове), класификация не само на типа данни, но и на нивото на чувствителност, както и използването на самоконтролно обучение по време на обучението чрез генериране на точни синтетични примери. Които, от своя страна, ще помогнат на модела да намали загубите до най-голямата стойност. Будещата работа може също да е насочена към работния поток на разследването, където надхвърляме откритията и предоставяме анализ на причините за различни нарушения на конфиденциалността. Това ще помогне в такива случаи като анализ на чувствителността (т.е. дали чувствителността на конфиденциалността на типа данни е висока (например, IP адрес на потребителя) или ниска (например, вътрешен IP на Facebook)).
Библиография
- Дейвид Бен-Давид, Тамар Доменy и Абигейл Тарем. Класификация на корпоративни данни, използваща технологии на семантичната мрежа. В Питър Ф.Ï Пател-Шнайдер, Юе Пан, Паскал Хицлер, Питър Мика, Лей Чанг, Джеф З. Пан, Иън Хорокс и Бирте Глим, редактори, Семантичната мрежа – ISWC 2010, страници 66–81, Берлин, Хайделберг, 2010. Springer Berlin Heidelberg.
- Субраманиан Муралидхар, Уайът Лойд, Сабясячи Рой, Кори Хил, Ърнест Лин, Вейвен Лиу, Сатадру Пан, Шива Шанкар, Вишванат Сивакумар, Линпън Тан и Санжийв Кумар. f4: Топлата система за съхранение на BLOB на Facebook. В 11-та симпозиум на USENIX за проектиране и имплементация на операционни системи (OSDI 14), страници 383–398, Брумфийлд, Колорадо, октомври 2014. USENIX Association.
- Томас Миколов, Иля Сутскевър, Кай Чен, Грег С. Коррадо и Джеф Дийн. Разпределени представяния на думи и фрази и тяхната композиционалност. В C. J. C. Бургес, Л. Ботту, М. Уелинг, З. Гахрамани и К. Q. Уейнбергер, редактори, Напредък в системите за обработка на информация в невронни мрежи 26, страници 3111–3119. Curran Associates, Inc., 2013.
- Сергей Иоффе и Кристиан Сегеди. Нормализация на партиди: Ускоряване на обучението на дълбоки мрежи чрез намаляване на вътрешното отклонение на променливите. В Франсис Бах и Дейвид Блей, редактори, Доклади от 32-рия международен конференции по машинно обучение, том 37 на Доклади на изследвания в машинното обучение, страници 448–456, Лил, Франция, 07–09 юли 2015. PMLR.
- Лео Брейман. Случайни гори. Маш. Обучение., 45(1):5–32, октомври 2001.
- Тхайр Ну Пхю. Преглед на техниките за класификация в анализа на данни.
- X. Шю, D. Яо и E. Бертино. Защита на конфиденциалността при откритие на чувствителни данни. IEEE Транзакции по информационна форензика и сигурност, 10(5):1092–1103, 2015.
- Жъмин Ян, Мин Ян, Юан Джан, Гуофей Гу, Пен Нинг и Сяоянг Уан. Appintent: Анализ на предаване на чувствителни данни в Android за откриване на нарушаване на поверителността. страници 1043–1054, 11 2013.
- Цихе Сие, Циханг Дай, Едуард Х. Хови, Мин-Танг Лuong и Куок В. Ли. Ненадзиравано увеличаване на данни.
Научете повече за това как да получите търсена професия от нулата или да подобрите уменията и заплатата си, преминавайки онлайн курсове SkillFactory:
- (12 месеца)
- (12 седмици)
- (20 седмици)
- (20 седмици)
Още курсове
- (9 месеца)
- (8 месеца)
- (9 месеца)
- (12 месеца)
- (18 месеца)
- (12 месеца)
- (9 месеца)
- (7 месеца)
Източник: habr.com
