

Здравейте.
Реших да споделя моята находка - плод на размисли, опити и грешки.
По същество: това не е никаква находка, разбира се - всичко това трябва да е отдавна известно на тези, които се занимават с приложна статистическа обработка на данни и оптимизация на системи, не задължително именно СУБД.
И: да, те знаят, пишат интересни статии по своите изследвания, (UPD.: в коментарите посочиха много интересен проект: )
От друга страна: на пръв поглед не виждам широко споменаване, разпространение на такъв подход, в интернет, сред ИТ специалисти, DBA.
И така, да преминем към същността.
Да предположим, че имаме задача: да настроим една сервисна система, за обслужване на определена работа.
За тази работа - известно е: каква е тя, в какво се измерва качеството на тази работа и какъв е критерият за измерване на това качество.
Също така да предположим, че е повече или по-малко ясно: как точно се извършва работата в (или с) тази сервисна система.
"По-скоро" - това означава, че има възможност да се подготви (или да се вземе отнякъде) някакъв инструмент, утилита, сервис, с който можем да синтезираме и подадем на системата тестова натовареност, достатъчно адекватна на това, което ще бъде в продукция, при условия, адекватни за работа в продукция.
И, предположим, че е известен набор от регулировъчни параметри на тази сервисна система, с които можем да настройваме системата, по отношение на продуктивността на нейната работа.
И, в какво е проблемът - няма достатъчно пълно разбиране на тази сервисна система, такова, което позволява експертно да настрои тази система за бъдеща натовареност върху тази платформа и да получи нужната продуктивност на работата на системата.
Е, почти винаги така и става.
Какво можем да направим тук.
Първото, което идва на ум: да погледнем в документацията за тази система. Да разберем - какви са допустимите диапазони на стойности на регулировъчните параметри. Например, чрез метода на координатното спускане, да подберем стойности за параметрите на системата в тестове.
Т.е. да зададем на системата някаква конфигурация, под формата на конкретен набор от стойности на нейните настройващи параметри.
Да подадем на нея тестова натовареност, с тази самата утилита, генератор на натовареност.
И да наблюдаваме величината - отговора, или метриката за качеството на работата на системата.
Втората мисъл може да бъде заключението, че - това е много дълго.
То есть, ако настройките са много, ако диапазоните на техните стойности са големи, и ако всеки отделен тест за натоварване отнема много време, тогава: да, всичко това може да отнеме неприемливо много време.
И тук какво може да се разбере и припомни.
Може да се установи, че в набора от значения на настройките на сервизната система - вектор, като последователност от определени стойности.
На всеки такъв вектор, при същите условия (в които този вектор не се засяга), отговаря напълно определена стойност на метриката - показателя за качеството на работата на системата под тестово натоварване.
Т.е.
Нека обозначим вектора на конфигурацията на системата като  , където
 ; където
 е броят на параметрите на конфигурацията на системата, колко от тях има.
И стойността на метриката, която съответства на дадения  нека обозначим като
 , тогава получаваме функция:

И тогава: всичко веднага се свежда до, в моя случай: почти забравените от студентските години алгоритми за търсене на екстремуми на функции.
Добре, но тук възниква организационно-практическият въпрос: кой именно алгоритъм да се използва.
- В смисъл - за да не се налага да кодирам сам твърде много.
- И за да работи, т.е. да намира екстремум (ако такъв съществува), поне по-бързо от координатния спуск.
Първият момент намеква, че трябва да се погледне в посока на определени среди, в които такива алгоритми вече са реализирани и са налични в някаква форма, готова за използване в кода.
Да, знам за python и cran-r
Вторият момент указва, че трябва да се прочетат самите алгоритми, какви са, какви са техните изисквания и особености в работата.
И какво дават, могат да имат полезни странични ефекти-резултати, или директно от самия алгоритъм.
Или могат да се получат от резултатите от работата на алгоритъма.
Тук много зависи от входните условия.
Например, ако по някакви причини е необходимо по-бързо да се получи резултат, то трябва да се разгледат алгоритми за градиентно спускане, да се избере някой от тях.
Или, ако времето не е толкова важно, може например да се използват методи на стохастична оптимизация, например генетичен алгоритъм.
Предлагам да разгледаме работата на такъв подход, по подбора на конфигурацията на системата, с използването на генетичен алгоритъм, в следващата, така да се каже: лабораторна работа.
Изходни:
- Нека да имаме, като сервисна система:
oracle xe 18c - Нека тя обслужва транзакционната активност и целта: да получим възможно най-голям капацитет на СУБД, по транзакции/сек.
- Транзакциите са много различни по характер на работа с данни и контекста на използване.
Приемаме, че това са транзакции, които не обработват голямо количество таблични данни.
В смисъл, че не генерират undo данни повече от redo и не обработват големи проценти редове от големи таблици.
Това са транзакции, които променят един ред в по-голяма таблица, с малко индекси над тази таблица.
При такова разположение: производителността на СУБД при обработка на транзакции ще бъде, с уговорка, определена от качеството на обработка на базата на redo данни.
Уговорката е — ако говорим точно за настройките на СУБД.
Защото, в общия случай, могат да съществуват, например, транзакционни блокировки между SQL сесиите, поради дизайна на потребителската работа с таблични данни и/или табличната модел.
Които, разбира се, ще оказват натиск върху tps метриката и това ще бъде егзогенен, относно СУБД, фактор: ето как е проектирана табличната модел и работата с данните в нея, че възникват блокировки.
Затова, за чистота на експеримента, ще изключим този фактор, по-долу ще уточня как точно.
- Да предположим, за определеност, че 100% от подадените в СУБД SQL команди: са DML команди.
Нека характеристиките на потребителската работа с СУБД: да останат същите в тестовете.
А именно: броят на SQL сесиите, таблични данни, как се работи с тях от SQL сесиите. - СУБД работи в
FORCE LOGGING,ARCHIVELOGрежими. Flashback режимът е изключен, на ниво СУБД. - Redo логовете: разположени в отделна файлова система, на отделен "диск";
Цялата останала физическа част на БД: в друга, отделна файлова система, на отделен "диск":
По-подробно, относно устройството на физическата компонента на лабораторната БД
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Първоначално под тези условия натоварване на СУБД транзакции исках да използвам
Тя има такава забележителна особеност, ще цитирам автора:
В основата на SLOB е "методът SLOB." Методът SLOB има за цел да тества платформи
без приложение на споделяни натоварвания. Невъзможно е да се постигне максимална производителност на хардуера
с код на приложението, който е, например, ограничен от заключване на приложението или дори
споделяне на блокове от Oracle Database. Правилно — съществува разход, когато споделяте данни
в блоковете с данни! Но SLOB — в своята основна настройка — е имунизирана към такова споделяне.
Тази декларация: отговаря, именно така е.
Удобно е да се регулира степента на паралелизъм на SLOB-сесиите, това е ключово -t за стартиране на утилитата runit.sh от състава на SLOB-а
Регулира се процентът DML-команди, в броя на SLOB-сесиите, които изпраща на СУБД, всяка SLOB-сесия, параметър UPDATE_PCT
Отделно и много удобно: SLOB самата, преди и след сесията на натоварването — подготвя statspack или AWR-снимки (каквото е зададено да подготвя).
Въпреки това се оказа, че SLOB не поддържа работа на SLOB-сесии с продължителност под 30 секунди.
Затова, първо написах моя работническо-селски вариант на натоварвател, а след това той така и остана в работа.
Ще уточня за натоварвателя — какво и как прави, за яснота.
По същество натоварвателят изглежда така:
Код на работника
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotracе/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Работниците стартират по следния начин:
Стартиране на работниците
echo "стартиране на теста, продължителност: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "очакване..." >> "$v_logfile"
wait
А таблиците за работниците се подготвят така:
Създаване на таблици
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Т.е. за всеки работник (практически: отделна SQL-сесия в СУБД) се създава отделна таблица, с която работи работникът.
С това се постига отсъствие на транзакционни блокировки между SQL-сесиите на работниците.
Всеки работник: извършва едно и също, със своята таблица, таблиците са еднакви.
Работниците всички — изпълняват работа в течение на едно и също количество време.
И то — достатъчно дълго време, за да се осъществи, например, точно лог-свичинг, и то не само един път.
И съответно възникват с това свързаните разходи и ефекти.
В моя случай — продължителността на работа на работниците е фиксирана на 8 минути.
Парче от статспак-отчет, с описание на работата на СУБД под натоварване.
База данных DB Id Инстанс Inst Num Время старта Релиз RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
2929910313 XE 1 07-Сен-20 23:12 18.0.0.0.0 НЕТ

Имя хоста Платформа CPUs Ядра Сокеты Память (Г)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
billing.izhevsk1 Linux x86 64-бит 2 2 1 15.6

Снимок Snap Id Время снапшота Сессии Курс/Сесс Комментарий
~~~~~~~~ ---------- ------------------ -------- --------- ------------------
Начало сниппета: 1630 07-Сен-20 23:12:27 55 .7
Конец сниппета: 1631 07-Сен-20 23:20:29 62 .6
Прошло: 8.03 (мин) Ср. активных сессий: 8.4
Время БД: 67.31 (мин) Время ЦП БД: 15.01 (мин)

Размеры кэша Начало Конец
~~~~~~~~~~~ ---------- ----------
Буферный кэш: 1,392M Стандартный размер блока: 8K
Общий пул: 288M Журнал кэш: 103,424K

Профиль загрузки За секунду За транзакцию За выполнение За вызов
~~~~~~~~~~~~ ------------------ ----------------- ----------- -----------
Время БД (с): 8.4 0.0 0.00 0.20
Время ЦП БД (с): 1.9 0.0 0.00 0.04
Размер повторной записи: 7,685,765.6 978.4
Логические чтения: 60,447.0 7.7
Изменения блока: 47,167.3 6.0
Физические чтения: 8.3 0.0
Физические записи: 253.4 0.0
Вызовы пользователя: 42.6 0.0
Парсинги: 23.2 0.0
Жесткие парсинги: 1.2 0.0
Объем обработанных МБ: 1.0 0.0
Логины: 0.5 0.0
Выполнения: 15,756.5 2.0
Откаты: 0.0 0.0
Транзакции: 7,855.1
Връщайки се към формулирането на лабораторна работа.
Ще променяме стойностите на следните параметри на лабораторната СУБД при равни условия:
- Размер на журналните групи на БД. диапазон на стойности: [32, 1024] MB;
- Брой журнални групи на БД. диапазон на стойности: [2,32];
log_archive_max_processesдиапазон на стойности: [1,8];commit_loggingдопускат се две стойности:batch|immediate;commit_waitдопускат се две стойности:wait|nowait;log_bufferдиапазон на стойности: [2,128] MB.log_checkpoint_timeoutдиапазон на стойности: [60,1200] секундиdb_writer_processesдиапазон на стойности: [1,4]undo_retentionдиапазон на стойности: [30;300] секундиtransactions_per_rollback_segmentдиапазон на стойности: [1,8]disk_asynch_ioдопускат се две стойности:true|false;filesystemio_optionsдопускат се следните стойности:none|setall|directIO|asynch;db_block_checkingдопускат се следните стойности:OFF|LOW|MEDIUM|FULL;db_block_checksumдопускат се следните стойности:OFF|TYPICAL|FULL;
Човек, който има опит с поддръжка на oracle бази данни, определено вече сега може да каже – какви стойности трябва да се зададат от списъка с параметри и техните допустими стойности, за да се постигне по-голяма производителност на СУБД, за конкретната работа с данни, заявена в приложния код по-горе.
Но.
Смисълът на лабораторната работа е да покаже, че оптимизационният алгоритъм е бърз и относително ефективен.
Остава само да се запознаем с документацията на конфигурируемата система, точно толкова, колкото е нужно за да разберем: какви параметри и в какви диапазони да променяме.
Също така, трябва да се напише код, с който да се реализира работата с конфигурируемата система на избрания оптимизационен алгоритъм.
Така, сега за кода.
По-горе споменах за cran-r, т.е.: всички манипулации с конфигурируемата система са организирани под формата на R-скрипт.
Собствено казано, задачата включва анализ, подбор по стойността на метриката и векторите на състоянието на системата: това е пакетът GA ()
Пакетът в случая не е много подходящ, тъй като очаква задание на вектори (хромозоми, ако използваме терминологията на пакета) под формата на числа с дробна част.
А моят вектор, от стойностите на настройките, включва 14 величини — цели числа и стрингови стойности.
Проблемът лесно се заобикаля, като на стринговите величини се зададат определени числа.
Така, в крайна сметка, основната част на R-скрипта изглежда така:
Викане на GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-сесията завърши" , file=v_logfile, sep="n", append=T)
gam@solution
Тук, с помощта на lower и upper атрибутите на подпрограмата ga се задава, по същество, областта на търсене, в която ще се извършва търсенето на такъв вектор (или вектори), за които ще бъде получено максимално значение на фитнес-функцията.
Подпрограмата ga извършва търсене, максимизирайки фитнес-функцията.
Така, в случая, трябва фитнес-функцията, разпознавайки вектора като набор от стойности за определени параметри на СУБД, да получава метрика от СУБД.
Т.е.: колко, при дадени настройки на СУБД и определена натовареност: СУБД обработва транзакции в секунда.
Т.е., разглеждайки по-дълбоко, е нужно в рамките на фитнес-функцията да се извърши такава многоетапна логика:
- Обработка на входния вектор от числа — преобразуване на стойностите за параметрите на СУБД.
- Опит за създаване на зададено количество redo-групи, с определен размер. При това опитът може да бъде неуспешен.
Съществуващите в СУБД журнални групи, в определено количество и размер, трябва да бъдат премахнати за чистотата на експеримента. - При успешното изпълнение на предходната точка: задаване на база стойности за конфигурационните параметри (отново: може да има неуспех).
- При успешното изпълнение на предходната точка: спиране на СУБД, стартиране на СУБД, за да влязат в сила ново зададените стойности на параметрите. (отново: може да има неуспех).
- При успешното изпълнение на предходната точка: извършване на натоварващ тест. получаване на метрика от СУБД.
- Върнете СУБД в първоначалното й състояние, т.е. премахнете допълнителните журнални групи и върнете оригиналната конфигурация на СУБД.
Код на функцията за фитнес
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Така цялата работа: изпълнява се в функцията за фитнес.
ga-подпрограма, която извършва обработка на вектори, или по-точно казано — хромозоми.
В която най-много ни интересува: селекция на хромозоми с такива гени, при които функцията за фитнес дава големи стойности.
Това е по същество процесът на търсене на оптимален набор хромозоми в N-измерно пространство за търсене.
Много ясно, подробно , с примери на R-код, работа на генетичния алгоритъм.
Отделно ще посоча два технически момента.
Помощните извиквания, от функцията evaluate, например спиране-стартиране, задаване на стойност на параметъра на СУБД, се извършват на базата на cran-r функцията system2
С помощта на която: се извиква вече някакъв bash-скрипт или команда.
Например:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Вторият момент — редът с запазването на конкретната стойност на метриката и съответстващия на нея настройващ вектор, в лог-файла: evaluate cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
Това е важно, тъй като от този масив от данни може да се получи допълнителна информация за това кой от компонентите на настройващия вектор влияе повече или по-малко на стойността на метриката.Тоест: може да се проведе анализ на важността на атрибути.
И така, какво може да се получи.
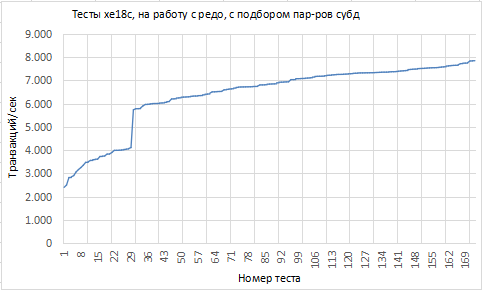
Под формата на графика, ако подредим тестовете по нарастваща метрика, картината е такава:
Някои данни, съответстващи на крайни стойности на метриката:
Тук, на екрана с резултатите, уточнявам: стойностите на настройващия вектор са дадени в термини на кода на функцията за фитнес, а не в термини на номер-списък от параметри/диапазони на стойности на параметри, който формулирах по-горе в текста.
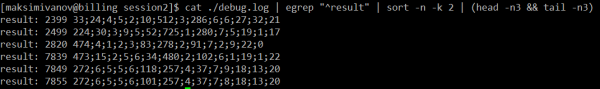
Е, много ли е това, или малко, ~8 хиляди tps: въпросът е отделен.
В рамките на лабораторната работа — не е толкова важна тази цифра, важна е динамиката, как се променя тази стойност.
Динамиката тук е добра.
Очевидно е, че, поне един фактор, значително влияещ на стойността на метриката, ga-алгоритъмът, перебирайки вектори-хромозоми: е покрил.
Очевидно, че поне един фактор, значително влияещ на стойността на метриката, генетичният алгоритъм, разглеждайки вектори-хромозоми: затвори.
Согласно достаочно бодрой динамике значений кривой — есть ещё как минимум един фактор, который, хотя и значительно меньше, но оказует влияние.
Тук помогнете attribute-importance анализ, за да разберем: какви атрибути (в този случай — компоненти на настройния вектор) и колко силно влияят на стойността на метриката.
А от тази информация: да разберем — какви фактори са били засегнати от промените на значимите атрибути.
Изпълни attribute-importance може да се извърши по различни начини.
На мен, за тези цели, ми харесва алгоритъмът randomForest съответстващ на R пакета ()
randomForest, както разбирам работата му на общо и подхода му към оценка на важността на атрибутите в частност, изгражда определена моделна зависимост на отговорната променлива от атрибутите.
В нашия случай отговорната променлива — това е метриката получена от субд, в натоварващи тестове: tps;
А атрибутите са — компонентите на настройния вектор.
Така че randomForest оценива важността на всеки атрибут на модела с две числа: %IncMSE — как наличието/отсъствието на този атрибут в модела променя качеството на MSE на този модел (Mean Squared Error);
И IncNodePurity — това е число, което показва колко качествено, по стойностите на този атрибут, може да бъде разделен наборът от данни с наблюдения, така че в едната част да се окажат данни с определена стойност на обясняваната метрика, а в другата с друга стойност на метриката.
Тоест: колко классифициращ е този атрибут (най-ясното, на руски обяснение по random forest, което видях ).
Работническо-селски R-код, за обработка на набора от данни с резултатите от натоварващите тестове:
x=NULL
v_data_file=paste('tmp/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Може направо на ръка да подберете хиперпараметрите на алгоритъма и, ориентирано по качеството на модела, да изберете модела, който точно извършва предсказанията на валидирания набор от данни.
Може да напишете някаква функция за тази работа (между другото — отново, на някакъв оптимизационен алгоритъм).
Може да използвате R пакета caret, не е от значение.
В крайна сметка, в този случай, получаваме такъв резултат за оценка на степента на важност на атрибутите:
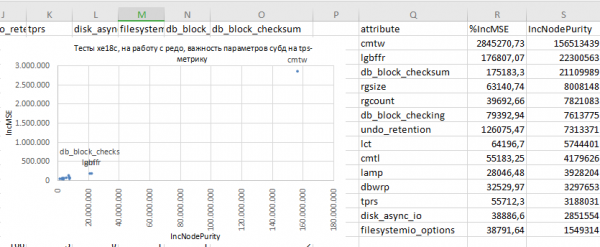
И така, можем да преминем към глобални размисли:
- Получава се, че най-значимият параметър в тези условия на тестване е
commit_wait
Технически, той задава режима на изпълнение на IO операцията за запис на повторни данни от лог буфера на СУБД в текущата журнална група: синхронен или асинхронен.
Стойностnowait, при който получаваме практически вертикален и кратен растеж на метриката TPS: това активира асинхронния режим на IO в повторните групи.
Отделен въпрос е дали е нужно да се прави така в продуктивната база данни. Тук се ограничавам само до констатацията: това е значим фактор. - Логично е, че размерът на лог буфера на СУБД е значим фактор.
Колкото по-малък е размерът на лог буфера, толкова по-малка е буферизиращата му способност, толкова по-често се случват неговите преливания и/или невъзможността да се освободи свободно пространство за нови партиди повторни данни.
А следователно: забавяния, свързани с разпределянето на пространство в лог буфера и/или изтласкването на повторни данни от него в повторните групи.
Тези забавяния, разбира се, трябва да влияят и влияят на пропускателната способност на СУБД за транзакции. - Параметър
db_block_checksum: разбира се, също е ясно — обработката на транзакции води до образуването на dirty блокове в буферния кеш на СУБД.
Които, при включена проверка на контролни суми на данъчните блокове, базата данни е принудена да обработва — изчислява тези контролни суми от тялото на данъчния блок и да ги сравнява с това, което е записано в заглавката на данъчния блок: съвпада/не съвпада.
Такава работа, отново, не може да не забавя обработката на данни, и съответно, параметърът и механизмът, който задава този параметър, се оказват значими.
По същата причина вендорът предлага в документацията за този параметър различни стойности и отбелязва, че да, ще има влияние, но, ето, различни стойности, дори до "изключено" и различно влияние, можете да изберете.
И глобалният извод.
Подходът, в общи линии, се оказва напълно работещ.
Той напълно позволява, на ранните етапи на натоварвателното тестване на някаква сервизна система, да не се задълбочаваме в особеностите на настройката на системата под натоварване за избор на оптимална конфигурация.
Но не изключва напълно — поне на ниво разбиране: "регулировъчни дръжки" и допустимите диапазони на въртене на тези дръжки, системата трябва да знае.
Следващият подход може относително бързо да намери оптималната конфигурация на системата.
И може, в резултат на тестовете, да получите информация относно природата на взаимовръзката между метриката на качеството на работа на системата и стойностите на настройващите параметри на системата.
Какво, разбира се, трябва да допринесе за възникването на именно това дълбоко разбиране на системата, нейното функциониране, поне — под това натоварване.
Практически това означава: разходите за вникване в настраиваемата система спрямо разходите за подготовка на такова тестване на работата на системата.
Поотделно ще отбележа: в този подход — критично важна е степента на адекватност на тестването на системата към условията на работа, които тя ще има в продукционна експлоатация.
Благодаря за вашето внимание, време.
Източник: habr.com
