

Здравейте на всички.
Аз съм сисадмин Linux и се преместих от Русия в Австралия с независима професионална виза през 2015 година, но статията няма да бъде за това как прасенцето да си купи трактор. Такива статии вече има достатъчно (въпреки че, ако проявите интерес — мога да напиша и за това), така че бих искал да разкажа как в работата си в Австралия като linux-ops-инженер бях инициатор на миграцията от една система за мониторинг към друга. Конкретно — от Nagios към Icinga2.
Статията е частично техническа и частично — за комуникацията с хора и проблемите, свързани с различията в културата и методите на работа.
За съжаление, етикетът «code» не подчертава кода на Puppet и yaml, така че трябваше да използвам «plaintext».
Нищо не предвещаваше беда сутринта на 21 декември 2016 година. Както обикновено, четях Хабр като незаписан аноним, в първите полчаса от работния ден, поглъщайки кафе и се натъкнах на .
Тъй като в компанията ми се използваше Nagios, без да мисля дълго, създадох тикет в Redmine и споделих връзката в общия чат, тъй като сметнах, че е важно. Инициативата е наказуема дори в Австралия, така че водещият инженер ми прехвърли този проблем, след като го открих.
Скриншот от Редмайн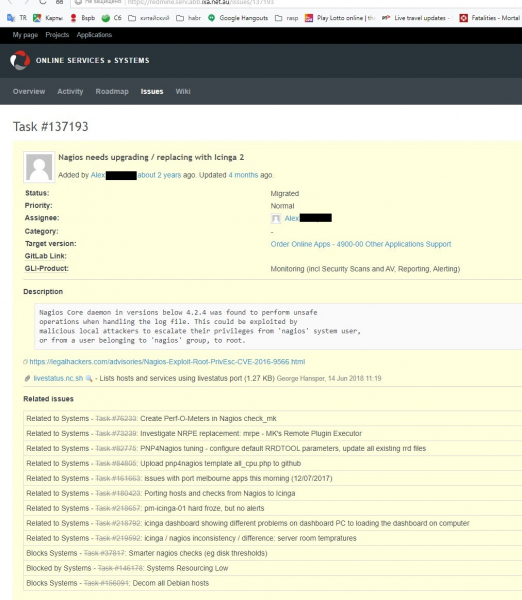
В нашия отдел преди да изразим мнението си, е прието да предложим поне една алтернатива, дори когато изборът е очевиден, така че започнах с гуглене какви системи за мониторинг изобщо са актуални в момента, тъй като в Русия на последното ми място работа имах своя собствена написана система, много примитивна, но все пак напълно функционираща и изпълняваща всички поставени задачи. Python, Политехниката в Санкт Петербург и метрото доминират. Не, метрото е ужасно. Това е лично (11 години работа) и заслужава отделна статия, но не сега.
Няколко думи за правилата за извършване на промени в конфигурацията на инфраструктурата на моето текущо място. Използваме Puppet, Gitlab и принципа Infrastructure as Code, така че:
- Никакие ръчни промени през SSH чрез ръчно изменение на файлове на виртуални машини. За три години работа получих много предупреждения за това, последното — преди седмица и не мисля, че това беше последният път. Наистина — поправи една линия в конфигурацията, рестартирай услугата и виж дали проблема се е решил — 10 секунди. Създай нова клонка в Gitlab, пушни промените, изчакай, докато r10k проработи на Puppetmaster, стартирай Puppet —environment=mybranch и още няколко минути изчакай докато всичко това проработи — минимум 5 минути.
- Всякакви промени се правят чрез създаване на Merge Request в Gitlab и е необходимо получаване на одобрение от най-малко един член на екипа. Сериозните промени, изисквани от тим-лидера, изискват две или три одобрения.
- Всички промени по един или друг начин са текстови (тъй като манифестите на Puppet, скриптовете и данните Hiera са текст), бинарните файлове са крайно не препоръчителни и за одобрение на такива файлове са нужни основателни причини.
И така, вариантите, които разгледах:
- Munin — ако в инфраструктурата има повече от 10 сървъра, администрирането става ад (из . Нямах особено желание да проверявам това, така че повярвах на думата).
- Zabbix — отдавна го наблюдавах, още в Русия, но тогава беше излишен за моите задачи. Тук — трябваше да се откажа поради използването на Puppet като мениджър на конфигурации и Gitlab като система за контрол на версиите. В този момент, доколкото разбрах — Zabbix съхранява цялата конфигурация в база данни, затова беше неясно как да управляваме конфигурацията при текущите условия и как да проследяваме промените.
- Prometheus — което, изглежда, ще достигнем в крайна сметка, съдейки по настроението в отдела, но в този момент не успях да го усвоя и не можах да демонстрирам действителен работещ образец (Proof of Concept), затова се наложи да се откажа.
- Имаше и няколко други варианта, които или изискваха пълна преработка на системата, или бяха в начален стадий / изоставени и по същата причина бяха отхвърлени.
В крайна сметка се спрях на Icinga2 по три причини:
1 — съвместимост с Nrpe (клиентска услуга, която изпълнява проверки по команди от Nagios). Това беше много важно, защото по онова време имахме 135 (в момента през 2019 г. са 165) виртуални машини с много самописани услуги/проверки и преизготвянето на всичко това щеше да бъде истински ад.
2 — всичките конфигурационни файлове са текстови, което позволява лесно редактиране, създаване на merge requests с възможност да се види какво е добавено или премахнато.
3 — това е жив и развиващ се OpenSource проект. Ние много обичаме OpenSource и правим своя принос, като създаваме Pull Requests и Issues за решаване на проблеми.
И така, да започнем, Icinga2.
Първото, с което се сблъскахме — инертността на колегите. Всички бяха свикнали с Nagios/Nadjius (макар че дори тук не можеха да постигнат компромис как да се произнася) и интерфейса на CheckMK. Интерфейсът на Icinga изглежда напълно различно (това беше минус), но предлага възможност за гъвкава настройка на това, което трябва да се вижда, с помощта на филтри по практически всеки параметър (това беше плюс, но аз се борих за него твърде много).
Филтри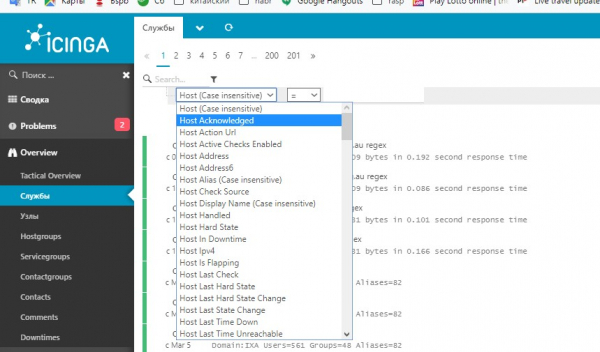
Оценете съотношението на размера на скролл-бара към размера на полето за прокрутка.
Второто — всички бяха свикнали да виждат цялата инфраструктура на един монитор, защото CheckMk позволяваше работа с множество хостове Nagios, но интерфейсът на Icinga не успяваше да го направи (всъщност можеше, но ще кажа по-долу). Алтернативата беше нещо, наречено Thruk, но дизайнът му предизвикваше повръщане у всички членове на екипа, с изключение на един — този, който го предложи (не аз).
На боклука с Thruk — единодушно решение на екипа.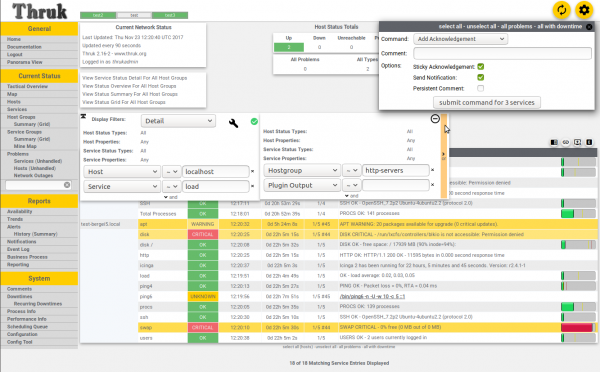
След няколко дни на мозъчна атака предложих идея за клъстерно наблюдение, при която има един мастър хост в production зоната и два подчинени — един в dev/test и един външен хост, разположен при друг провайдер, с цел да наблюдава нашите услуги от гледна точка на клиента или външен наблюдател. Тази конфигурация позволяваше да се виждат всички проблеми в един уеб интерфейс и се оказваше работеща, но Puppet… Проблемът с Puppet беше, че мастър хостът сега трябваше да знае за всички хостове и услуги/проверки в системата и да ги разпределя между зоните (dev-test, staging-prod, ext), но изпращането на промени през Icinga API отнема секунди, докато компилирането на каталога на Puppet за всички услуги за всички хостове — отнема минути. Все още ми вменяват вина за това, въпреки че вече kilka пъти обяснявах как всичко работи и защо всичко отнема толкова дълго.
Трето — куп SnowFlakes (снежинки) — неща, които излизат извън общата система, защото в тях има нещо специално, поради което общите правила не важат. Това се решаваше чрез директна атака — ако има тревоги, но всъщност всичко е наред, значи тук трябва да се копае по-дълбоко и да се разбере защо ми подава аларми, когато не би трябвало. Или напротив — защо Nagios паникьосва, а Icinga — не.
Четвърто — Nagios работеше тук три години преди мен и доверието към него в началото беше по-голямо, отколкото към моята нова хипстърска система, така че всеки път, когато Icinga вдигаше паника — никой не правеше нищо, докато Nagios не се развълнуваше по същия въпрос. Но много рядко Icinga издаваше реални тревоги преди Nagios и смятам, че това е сериозен пропуск, за който ще говоря в секцията "Изводи".
В резултат, въвеждането в експлоатация се проточи повече от 5 месеца (планирано на 28 юни 2018, фактически — 3 декември 2018), основно заради "parity check" — онова нещо, когато имаш няколко услуги в Nagios, за които никой не е чул последните няколко години, но ТОЧНО СЕЙЧАС те, блестящи, издадоха crit без никаква причина и трябваше да обяснявам защо ги няма на моя панел и трябваше да ги добавя в Icinga, за да "parity check is complete" (Всички услуги/проверки в Nagios отговарят на услугите/проверки в Icinga)
Внедряване:
Първото е войната Code срещу Data, типа Puppet Style. Всички данни, абсолютно всички, трябва да бъдат в Hiera и никак иначе. Целият код – във файлове .pp. Променливи, абстракции, функции – всичко е в pp.
В резултат – имаме куп виртуални машини (165 към момента на писане на статията) и 68 уеб приложения, които трябва да се наблюдават за работоспособност и действителност на SSL сертификатите. Но заради исторически проблеми информацията за мониторинг на приложенията се получава от отделен gitlab репозиторий и форматът на данните не се е променял от времето на Puppet 3, което създава допълнителни сложности в конфигурацията.
Puppet код за приложения, пазете очите си
определете профили::услуги::мониторинг::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### АПЛИКАЦИИ ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # добавя уведомления за по подразбиране група (системи) + всяка група, определена в int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Изберете regex за проверка

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '"/"' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Разделете приложение по домейни, ако има две или повече
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Направете IP-адреса масив, ако не е, тъй като askizzy има 2 ip адреса и е масив
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Обединете подразбираща се зона (където приложението е определено) и допълнителни зони, ако съществуват
      $web_ipaddress.each | String $ip_address | {            # За всеки IP (ако имаме много)
        $suffix = length($web_ipaddress) ? {                  # Ако имаме повече от един - добавете IP като суфикс към това име на хост, за да избегнете дублиране на ресурси
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Използването само на последния октет причинява сблъсък между nginx-vip 203.15.70.94 и ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Ако е хост за ext - префиксът става 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Кодът за конфигурация на хостовете и услугите също изглежда ужасно:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # ще бъде активиран, когато напълно преминем на icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Моля, уверете се, че възелът има зададен факт $location (int, pm, ext)')
    }
  }

  file { '"/etc/icinga2/conf.d/"':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet://modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # Това е за инвазията на космически кораби, когато е готова.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Разделяне на списъците по хостгрупи - docker_host/gluster_host/и т.н.
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Разделяне на списъците по хостове
      # Дали този хост е в масива $hosts_has_large_disks? Ако е така, задайте host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Обединяване на vars отделно

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Всички хостове, управлявани от API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Разделяне на API хостовете по зони
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Разделяне на списъците по хостгрупи - docker_host/gluster_host/и т.н.
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Разделяне на списъците по хостове
          # Дали този хост е в масива $hosts_has_large_disks? Ако е така, задайте host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_от_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### КРАЙ НА ХОСТОВЕТЕ ####

####   УСЛУГИ   ####

  $services.each | String $service_group, Hash $s_list |{             # Група услуги и списък на услугите в тази група
    $service_list = $s_list['checks']                                 # Списък на реалните проверки, отделно от настройки на SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # глобални настройки на услуги + настройки на група услуги
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Ако заменим настройката по подразбиране check_timeout, но не nrpe_timeout, направете nrpe_timeout същата като check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # НБ: Icinga автоматично ще преобразува 1m в 60!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # По подразбиране използваме nrpe и всички команди се изпълняват чрез nrpe. Така vars.nrpe_command = $service_name е подразбираща стойност
      # Ако е сървърно Icinga команда - нямаме нужда от 'nrpe_command'
      # но няма вреда да имаме тази променлива и кодът е по-кратък

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Сглобяване на $vars от глобални настройки на услуги, настройки на групата услуги, настройки на тази конкретна проверка и нека не забравяме настройките nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick е необходим навсякъде, в противен случай става "Стойността '' не може да бъде преобразувана в числова"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Присвояване на подразбираща група (системи), ако не са дефинирани други групи

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Това трябва да бъде обединено отделно, защото обединяването му като част от MERGED_DATA презаписва масиви вместо да ги обединява, така че губим някои "присвоява" и "игнорира" стойности

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### КРАЙ НА УСЛУГИТЕ ####

#### ДРУГИ СТАНДАРТНИ НЕЩА ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Обединяване на уведомленията за потребителите с останалите настройки
  $users_oncall = deep_merge($users, $oncall)
  # Магия. Не пипайте.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Все още работя над този код и го подобрявам когато е възможно. Въпреки това, точно този код позволи да се използва прост и ясен синтаксис в Hiera:
Данни
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Всички проверки са разделени на групи, като всяка група има подразбиращи се настройки, определящи къде и колко често да се изпълняват тези проверки, какви уведомления да се изпращат и на кого.
Във всяка проверка може да се променя всяка опция и всичко това в крайна сметка се комбинира с подразбиращите се настройки на всички проверки като цяло. Ето защо в config.pp е написана такава структура — там става сливане на всички подразбиращи се настройки с настройките на групите, а след това и с всяка индивидуална проверка.
Също така, много важно изменение стана възможността за използване на функции в настройки, например, функцията за смяна на порт, адрес и URL за проверка http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Това означава — ако в определението на хоста има променлива http_port — да се използва тя, иначе 443. Например, уеб интерфейсът на jabber работи на 9090, а Unifi — на 7443.
http_vhost означава да се игнорира DNS и да се вземе този адрес.
Ако в хоста е указан uri — да се следва той, иначе да се вземе «\/».
С http_ssl се случи забавна история — този параметър никак не искаше да се изключи по заявка. Дълго време се опитвах да разбера това, докато не ми дойде наум, че в променливата в определението на хоста:
http_ssl: falseВключва се в израза
if(host.vars.http_ssl) { return false } else { return true }като неверно и накрая се оказва
if(false) { return false } else { return true }тоест проверката за ssl е винаги активна. Проблемът се решава със смяна на синтаксиса:
http_ssl: noИзводи:
Плюсове:
- Сега имаме една система за мониторинг, а не две, както беше през последните 7-8 месеца, или една остаряла и уязвима.
- Структурата на данните за хостове / услуги (проверки) сега (по моето мнение) е много по-четима и разбираема. За другите не беше толкова очевидно, затова се наложи да създам няколко страници в местната вики за обяснение как работи всичко и какво къде да се коригира.
- Има възможност за гъвкава настройка на проверките с помощта на променливи и функции, например за проверка http_regexp исканият шаблон, код за връщане, URL и порт могат да се задават в настройките на хоста.
- Има няколко панели (dashboards), за всеки от които може да се определи собствен списък с тревоги и да се управлява всичко това чрез Puppet и merge requests.
Недостатъци:
- Инертност на членовете на екипа — Nagios работеше, работеше и работеше, а това твоята Icinga постоянно глючи и забавя. А как да видя историята? А, блин, тя не се обновява... (Реален проблем — историята на тревогите не се обновява автоматично, само с F5)
- Инертност на системата — когато кликна в web интерфейса на "обнови" (check now) — резултатът зависи от времето на Марс, особено за сложни услуги, които изискват десетки секунди за изпълнение. Подобен резултат е нормално явление.

- Общо взето по полугодишната статистика на работа на двете системи редом, Nagios винаги работеше по-бързо от Icinga и това много ме дразни. Както ми се струва, там нещо са нагукали с таймерите и проверката веднъж на пет минути по фактическа работа става веднъж на 5:30 или нещо подобно.
- Ако перезапусна услугата по всяко време (systemctl restart icinga2) — всички проверки, които по това време са в процес на изпълнение, ще предизвикат тревога critical на екрана и отстрани изглежда, като че всичко е паднало ().
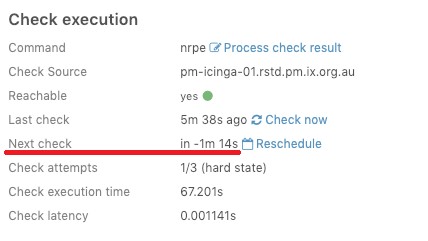
Но като цяло — работи.
Източник: habr.com
