

През 2018 г. в професионалните среди и на тематични конференции, посветени на AI, се появи понятието MLOps, което бързо се утвърди в индустрията и в момента се развива като самостоятелно направление. В перспектива MLOps може да стане една от най-търсените области в ИТ. Какво точно е то и с какво се занимава, ще разберем по-долу.
Какво е MLOps
MLOps (обединение на технологии и процеси на машинно обучение и подходи за внедряване на разработените модели в бизнес процеси) е нов начин за сътрудничество между представители на бизнеса, учени, математици, специалисти в областта на машинното обучение и ИТ инженери при създаване на системи за изкуствен интелект.
С други думи, това е начин за превръщане на методите и технологиите на машинното обучение в полезен инструмент за решаване на бизнес задачи.
Трябва да се разбере, че веригата за продуктивизация започва много преди разработката на модела. Първата стъпка е определянето на бизнес задачата, хипотезите за стойността, която може да бъде извлечена от данните, и бизнес идеята за нейното приложение.
Самото понятие MLOps възникна като аналогия на понятието DevOps, приложимо към модели и технологии на машинното обучение. DevOps е подход за разработка на софтуер, който позволява повишаване на скоростта на внедряване на отделни промени, запазвайки гъвкавостта и надеждността с помощта на редица подходи, между които непрекъсната разработка, разделяне на функциите на независими микросервизи, автоматизирано тестване и внедряване на отделни промени, глобален мониторинг на работоспособността, система за оперативно реагиране на откритите проблеми и др.
DevOps определи жизнения цикъл на софтуера и в общността на специалистите възникна идеята да се използва същата методология, приложима към големи данни. DataOps е опит за адаптиране и разширяване на методологията, вземайки под внимание особеностите на съхранението, предаването и обработката на големи обеми данни в разнообразни и взаимодействащи помежду си платформи.
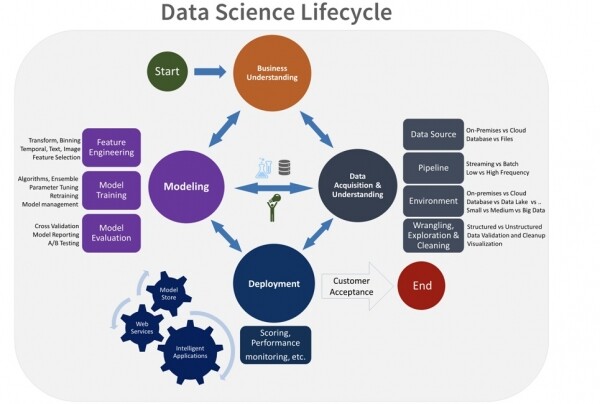
С появата на определена критична маса от модели на машинно обучение, внедрени в бизнес процесите на предприятията, бе забелязано силно сходство между жизнения цикъл на математическите модели на машинно обучение и жизнения цикъл на софтуера. Разликата е само в това, че алгоритмите на моделите се създават чрез инструменти и методи на машинното обучение. Следователно естествено възникна идеята да се приложат и адаптират за моделите на машинно обучение вече познатите подходи за разработка на софтуер. Така в жизнения цикъл на моделите на машинно обучение могат да се обозначат следните ключови етапи:
- определяне на бизнес идея;
- обучение на модела;
- тестиране и внедряване на модела в бизнес процеса;
- експлоатация на модела.
Когато в процеса на експлоатация възникне необходимост да се промени или дообучи моделът с нови данни, цикълът стартира отново — моделът се доработва, тестира се и се деплойва нова версия.
Отстъпление. Защо дообучаване, а не преобучаване? Терминът „преобучаване на модела“ има две значения: сред специалистите той означава дефект на модела, когато моделът добре предсказва, всъщност повтаря предсказвания параметър на обучаващата извадка, но много по-слабо работи на външната извадка от данни. Естествено, такъв модел е брак, тъй като този дефект не позволява да се приложи.
В този жизнен цикъл изглежда логично да се използват DevOps инструменти: автоматизирано тестване, деплоймент и мониторинг, оформяне на изчисленията на моделите под формата на отделни микросервизи. Но има и редица особености, които пречат на пряко прилагане на тези инструменти без допълнителна ML обвивка.
Как да накараме моделите да работят и да носят печалба
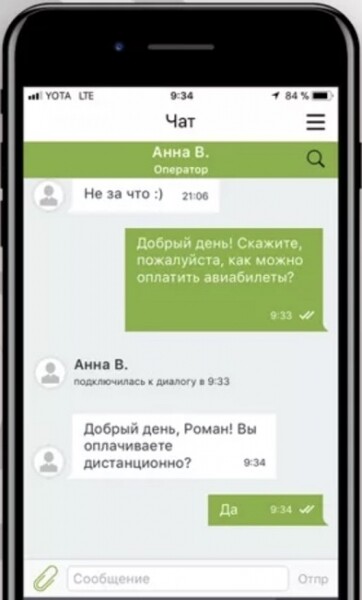
Като пример, за който ще демонстрираме прилагането на подхода MLOps, ще вземем класическата задача за автоматизация на чатовата поддръжка на банков (или друг) продукт. Обикновено бизнес процесът на поддръжка чрез чат изглежда по следния начин: клиентът въвежда съобщение с въпрос в чата и получава отговор от специалист в рамките на предварително определено дърво от диалози. Задачата за автоматизация на такъв чат обикновено се решава чрез експертно определени набори от правила, което е много натоварващо за разработка и поддръжка. Ефективността на такава автоматизация, в зависимост от сложността на задачата, може да варира между 20–30%. Естествено, възниква идеята, че по-изгодно е внедряването на модул за изкуствен интелект — модел, разработен с помощта на машинно обучение, който:
- може да обработва без участието на оператор по-голямо количество запитвания (в зависимост от темата, в някои случаи ефективността може да достигне 70–80%);
- по-добре се адаптира към нестандартни формулировки в диалога — умеят да определят намерението, истинското желание на потребителя по неясно формулирано запитване;
- умее да определя, когато отговорът на модела е адекватен, а когато има съмнения относно "съзнателността" на този отговор и трябва да се зададе допълнителен уточняващ въпрос или да се прехвърли на оператор;
- може да бъде дообучен автоматизирано (вместо група разработчици, които постоянно адаптират и коригират сценарии на отговори, моделът се дообучава от специалист по Data Science, използвайки съответните библиотеки за машинно обучение).
Как да накараме такъв напреднал модел да работи?
Както и при решаването на всяка друга задача, преди да разработим такъв модул, е необходимо да определим бизнес процеса и формално да опишем конкретната задача, която ще решаваме с помощта на метода на машинното обучение. Тук започва процесът на operacionalization, обозначен с абревиатурата Ops.
Следващата стъпка, специалистът по Data Science, в сътрудничество с инженера по данни, проверява наличността и достатъчността на данните и хипотезата на бизнеса относно жизнеспособността на бизнес идеята, разработвайки прототип на модела и проверявайки реалната му ефективност. Само след потвърждение от бизнеса може да започне преходът от разработка на модела към интегрирането му в системи, които изпълняват конкретен бизнес процес. Цялостното планиране на внедряването, дълбокото разбиране на всеки етап, как моделът ще се използва и какъв икономически ефект ще донесе, е основополагающ момент в процесите на внедряване на подходите MLOps в технологичния ландшафт на компанията.
С развитието на технологиите за изкуствен интелект лавинообразно нараства броят и разнообразието от задачи, които могат да бъдат решени с помощта на машинно обучение. Всеки такъв бизнес процес представлява икономия за компанията чрез автоматизация на труда на служителите на масови позиции (кол център, проверка и сортиране на документи и т.н.), разширяване на клиентската база чрез добавяне на нови привлекателни и удобни функции, спестяване на средства чрез оптимално използване и преразпределение на ресурсите и много други. В крайна сметка, всеки процес е насочен към създаване на стойност и, следователно, трябва да носи определен икономически ефект. Тук е много важно ясно да се формулира бизнес идеята и да се изчисли предполагаемата печалба от внедряването на модела в общата структура на създаване на стойност на компанията. Понякога се случва внедряването на модела да не се оправдае, а времето, което специалистите по машинно обучение инвестират, да струва много повече от работното място на оператора, който изпълнява тези задачи. Именно затова такива случаи е необходимо да се опитваме да идентифицираме на ранен етап от създаването на системите за изкуствен интелект.
Следователно, печалбите от модела започват да се реализират само когато по време на MLOps правилно е формулирана бизнес задачата, зададени са приоритети и в ранните етапи на разработката е формулиран процесът на внедряване на модела в системата.
Нов процес – нови предизвикателства
Изчерпателен отговор на принципния въпрос на бизнеса относно приложимостта на ML моделите за решаване на задачи, общият въпрос за доверието в ИИ — това е един от основните предизвикателства в процеса на развитие и внедряване на подходите MLOps. Първоначално бизнесът е скептично настроен към внедряването на машинно обучение в процесите — трудно е да се разчита на модели в области, в които преди това обикновено работеха хора. За бизнеса програмите изглеждат като „черна кутия“, чиято релевантност на отговорите още трябва да бъде доказана. Освен това в банковия сектор, в бизнеса на операторите на връзки и други области съществуват строги изисквания от страна на държавните регулатори. Всички системи и алгоритми, внедрени в банковите процеси, подлежат на одит. За да се реши този проблем и да се докаже на бизнеса и регулаторите обосноваността и коректността на отговорите на изкуствения интелект, заедно с модела се внедряват средства за мониторинг. Освен това съществува процедура за независима валидация, която е задължителна за регулаторните модели и отговаря на изискванията на ЦБ. Независима експертна група провежда одит на резултатите, получени от модела, като взема предвид входните данни.
Второто предизвикателство — оценка и оценка на моделните рискове при внедряване на модела на машинно обучение. Ако дори човек не може с 100% увереност да отговори на въпроса дали роклята беше бяла или синя, то и изкуственият интелект има право на грешка. Също така трябва да се вземе предвид, че с времето данните могат да се променят и моделите трябва да бъдат дообучавани, за да предоставят достатъчно точни резултати. За да не пострада бизнес процесът, е необходимо да се управляват моделните рискове и да се проследява работата на модела, редовно го дообучавайки с нови данни.
Но след първата фаза на недоверие започва да се проявява обратният ефект. Колкото повече модели успешно се внедряват в процесите, толкова повече у бизнеса расте апетитът за използване на изкуствения интелект — намират се нови и нови задачи, които могат да бъдат решени с методи на машинното обучение. Всяка задача стартира цял процес, който изисква различни компетенции:
- данни инженери подготвят и обработват данни;
- данни учени прилагат инструменти на машинното обучение и разработват модел;
- IT внедрява модела в системата;
- ML инженерът определя как да вгради този модел коректно в процеса, какви IT инструменти да се използват в зависимост от изискванията за режима на прилагане на модела, като се вземат предвид потока на запитвания, времето за отговор и т.н.
- ML архитектът проектира как физически може да се реализира софтуерният продукт в индустриалната система.
Целият цикъл изисква голямо количество високо квалифицирани специалисти. На определен етап от развитието и степента на проникване на ML моделите в бизнес процесите, се оказва, че линейното увеличаване на броя на специалистите пропорционално на растежа на броя на задачите става скъпо и неефективно. Затова възниква въпросът за автоматизация на процеса MLOps — определяне на няколко стандартни класове задачи за машинно обучение, разработване на типов конвейер за обработка на данни и допълнителна тренировка на модели. В идеалната картина за решаване на такива задачи са необходими специалисти, които по един и същи начин владеят компетентностите на пресечната точка между Big Data, Data Science, DevOps и IT. Следователно, най-голямата проблема в индустрията на Data Science и най-голямото предизвикателство при организирането на процесите MLOps е липсата на такава компетентност на наличния пазар за подготовка на кадри. Специалистите, отговарящи на тези изисквания, в момента са единични на пазара на труда и са ценени като злато.
По въпроса за компетенциите
В теорията всички задачи на MLOps могат да се решават с класическите инструменти на DevOps и да не се прибягва до специализирано разширение на ролевата модел. Както вече споменахме по-горе, дата учен трябва да бъде не само математик и специалист по аналитика на данни, но и гуру на целия конвейер — на него легне разработването на архитектура, програмирането на модели на няколко езика в зависимост от архитектурата, подготовката на витрина за данни и деплоймента на самото приложение. Все пак, създаването на технологичния интерфейс, реализиран в целия процес MLOps, заема до 80% от трудозатратата, което означава, че квалифицираният математик, който е качествен Data Scientist, ще посвети само 20% от времето си на специалността си. Затова разграничаващите роли на специалистите, извършващи процеса на внедряване на модели за машинно обучение, става жизненоважно.
Степента на която трябва да се разграничават ролите зависи от мащабите на предприятието. Едно е, когато в стартапа има един специалист, който е всичко – инженер, архитект и DevOps. Съвсем друга е ситуацията, когато в голямо предприятие всички процеси по разработка на модели са съсредоточени в ръцете на няколко висококвалифицирани специалисти по Data Science, докато програмист или специалист по бази данни – по-разпространена и по-малко скъпа компетенция на пазара на труда – може да поеме голяма част от рутинните задачи.
Така че, къде точно минава границата в избора на специалисти за осигуряване на процеса на MLOps и как е организиран процесът на операционализация на разработените модели, директно влияе на скоростта и качеството на разработваните модели, производителността на екипа и микроклимата в него.
Какво вече е направено от нашия екип
Неотдавна започнахме да изграждаме структурата на компетенциите и процесите на MLOps. Но вече сега в етап на тестиране на MVP са нашите проекти за управление на жизнения цикъл на модели и за прилагане на модели като услуга.
Също така определихме оптималната за голямо предприятие структура на компетенциите и организационната структура на взаимодействие между всички участници в процеса. Организирани са Agile екипи, които решават задачи за целия спектър бизнес поръчители, както и е установен процес на взаимодействие с проектни екипи за създаване на платформи, инфраструктура, която е основата на изграждането на MLOps.
Въпроси за бъдещето
MLOps е развиваща се област, която страда от липса на компетенции и в бъдеще ще набере инерция. А засега е най-добре да започнем от практиките на DevOps. Основната цел на MLOps е по-ефективното използване на ML модели за решаване на бизнес задачи. Но с това възникват много въпроси:
- Как да се съкрати времето за внедряване на модели в производството?
- Как да се намалят бюрократичните препятствия между екипите с различни компетенции и да се повиши нацелеността на сътрудничеството?
- Как да се проследяват моделите, да се управляват версиите и да се организира ефективен мониторинг?
- Как да се създаде наистина цикличен жизнен цикъл за съвременен ML модел?
- Как да се стандартизира процесът на машинно обучение?
Отговорите на тези въпроси и ще разберете колко бързо MLOps ще реализира своя потенциал.
Източник: habr.com
