

В тази статия ще говоря за ситуация, която наскоро се случи с един от сървърите на нашето облачно VPS, поставяйки ме в затруднено положение за няколко часа. Занимавам се с конфигуриране и отстраняване на проблеми със сървъри Linux от около 15 години, но този случай съвсем не попада в моята практика—направих няколко неверни предположения и се почувствах леко обезсърчен, преди да успея да определя причината за проблема и да я разреша.
Преамбула
Експлоатираме облак със среден размер, който изграждаме на базата на стандартни сървъри с конфигурация — 32 ядра, 256 GB RAM и NVMe устройство PCI-E Intel P4500 с капацитет от 4TB. Харесва ни тази конфигурация, тъй като ни позволява да не се притесняваме за недостатъчно IO, осигурявайки правилно ограничение на нивото на типовете инстанции (виртуални машини). Понеже NVMe Intel има впечатляваща производителност, можем едновременно да осигурим както пълно предаване на IOPS на машините, така и резервно копие на хранилището на сървъра за резервни копия без никакво IOWAIT.
Ние сме от онези старици, които не използват хиперконвергентни SDN и други модерни, стилни неща за съхранение на томове на VM, смятайки, че колкото по-проста е системата, толкова по-лесно е да се отстраняват проблеми в условията на "главният гуру е отишъл в планината". В крайна сметка, съхраняваме томовете на VM в QCOW2 формат в XFS или EXT4, разположени върху LVM2.
Използването на QCOW2 е наложено и от продукта, който използваме за оркестрация — Apache CloudStack.
За да извършваме резервно копие, правим полен образ на тома, като моментна снимка на LVM2 (да, знаем, че моментните снимки на LVM2 са бавни, но Intel P4500 ни спасява и тук). Правим lvmcreate -s .. и с помощта на dd изпращаме резервната копия на отдалечен сървър с хранилище ZFS. Тук сме малко прогресивни — все пак ZFS може да съхранява данни в компресиран вид, и можем да ги възстановяваме бързо с помощта на DD или да извличаме отделни томове на VM с помощта на mount -o loop ....
Разбира се, можем да правим и непълен образ на тома LVM2, и да монтираме файловата система в режим
ROи копирайте сами изображения QCOW2, обаче, се сблъсквахме с това, че XFS от това ставаше проблемен, и то не веднага, а непредсказуемо. Много не обичаме, когато хостовете-хипервизори "залепват" изведнъж през уикендите, през нощта или на празници заради грешки, които не е ясно кога ще се случат. Затова за XFS не използваме монтиране на снимки в режимROза извличане на обеми, а просто копираме целия том LVM2.
Скоростта на резервно копиране на сървър за резервни копия се определя в нашия случай от производителността на сървъра за резервни копия, която е около 600-800 MB/s за несжимаеми данни, а по-нататъшният ограничител е канал 10Gbit/s, чрез който сървърът за резервни копия е свързан с клъстера.
При това на един сървър за резервни копия едновременно се качват резервни копия от 8 сървъри хипервизора. По този начин, дисковата и мрежовата подсистеми на сървъра за резервни копия, като по-бавни, не позволяват да претоварим дисковите подсистеми на хостовете-хипервизори, тъй като просто не могат да обработят, да кажем, 8 GB/s, които без усилия могат да дадат хостовете-хипервизори.
По-гореописаният процес на копиране е много важен за по-нататъшното разказване, включително и детайлите – използването на бърз носител Intel P4500, използването на NFS и вероятно използването на ZFS.
История за резервното копиране
На всеки узел-хипервизор имаме малък раздел SWAP с размер 8 GB, а самият узел-хипервизор "развиваме" с помощта на DD от стандартния образ. За системния том на сървърите използваме 2xSATA SSD RAID1 или 2xSAS HDD RAID1 на хардуерен контролер LSI или HP. В общи линии, изобщо не ни пука какво има вътре, тъй като системният том работи в режим "почти readonly", освен SWAP. А тъй като имаме много RAM на сървъра и тя е свободна на 30-40%, не мислим за SWAP.
Процесът на създаване на резервно копие. Задачата изглежда по следния начин:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Обърнете внимание на ionice -c3, всъщност тази функция за устройства NVMe е напълно безполезна, тъй като планиращият IO за тях е зададен като:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Въпреки това, имаме редица остарели узли с обикновени SSD RAID-ове, за тях това е актуално, така че преминава AS IS. В общи линии, това е просто интересен фрагмент код, който обяснява безполезността на ionice в случай на такава конфигурация.
Обърнете внимание на флага iflag=direct за DD. Използваме direct IO, за да избегнем излишни замествания на буферите IO при четене. Въпреки това, oflag=direct не го правим, тъй като сме срещали проблеми с производителността на ZFS при неговото използване.
Тази схема я използваме успешно от няколко години без проблеми.
И тук започна всичко… Открихме, че за един от възлите резервното копиране е спряло да се извършва, а предишното е било изпълнено с ужасен IOWAIT от 50%. При опитите да разберем защо не се извършва копирането, се сблъскахме с феномена:
Групата обем "images" не е намеренаЗапочнахме да мислим за "края на Intel P4500", но преди да изключим сървъра за смяна на диска, беше необходимо все пак да извършим резервно копиране. Поправихме LVM2, възстановявайки метаданните от резервното копие на LVM2:
vgcfgrestore imagesСтартирахме резервното копиране и видяхме следната ситуация:
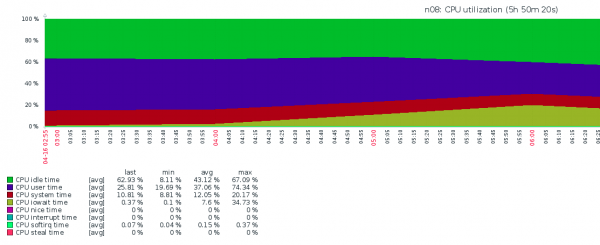
Отново много се натъжихме — беше ясно, че не можем да живеем по този начин, тъй като всички VPS-ки ще страдат, а следователно и ние. Какво се случваше, беше напълно неясно — iostat показваше мизерни IOPS и изключително висок IOWAIT. Нямаше идеи, освен "да заменим NVMe", но настъпи прозрение навреме.
Разбор на ситуацията стъпка по стъпка
Исторически дневник. Няколко дни по-рано беше необходимо да се създаде голям VPS с 128 GB RAM на този сървър. Паметта изглеждаше достатъчна, но за всеки случай добавихме още 32 GB за swap раздела. VPS беше създаден, успешно изпълни задачата си и инцидентът бе забравен, а SWAP разделът остана.
Характеристики на конфигурацията. За всички сървъри в облака параметърът vm.swappiness беше зададен с подразбираща се стойност 60. А SWAP беше създаден на SAS HDD RAID1.
Какво се случваше (по мнение на редакцията). При резервното копиране DD даваше много данни за запис, които се съхраняваха в RAM буферите, преди да бъдат записани в NFS. Ядрото на системата, ръководейки се от политиката swappiness, мигаше много страници памет от VPS в областта на swap, която се намираше на бавния том HDD RAID1. Това водеше до значително увеличаване на IOWAIT, но не за сметка на IO NVMe, а за сметка на IO HDD RAID1.
Как беше разрешен проблемът. SWAP разделът от 32 GB беше изключен. Това отне 16 часа, а как и защо се изключва SWAP толкова бавно може да се прочете отделно. Бяха променени параметрите swappiness на стойност равна на 5 в целия облак.
Как е можело това да се случиПърво, ако SWAP беше на SSD RAID или NVMe устройство, второ, ако нямаше NVMe устройство, а имаше по-бавно устройство, което не генерираше толкова обем данни — по ирония, проблемът се появи, защото NVMe е твърде бърз.
След това всичко започна да работи както преди — с нулево IOWAIT.
Източник: habr.com
