

Искам да споделя с вас своята първа успешна опитност по възстановяване на пълната работоспособност на базата данни Postgres. Запознах се със СУБД Postgres преди половин година, преди това нямах опит в администрирането на бази данни.
Работя като полуна DevOps инженер в голяма ИТ компания. Нашата компания се занимава с разработка на софтуер за високо натоварени услуги, а аз отговарям за работоспособността, поддръжката и деплоя. Поставиха ми стандартна задача: да актуализирам приложението на един сървър. Приложението е написано на Django, по време на актуализацията се изпълняват миграции (промяна на структурата на базата данни), и преди този процес правим пълен дамп на базата данни чрез стандартната програма pg_dump, за всеки случай.
По време на правенето на дампа възникна неочаквана грешка (версия Postgres – 9.5):
pg_dump: Oumping the contents of table “ws_log_smevlog” failed: PQgetResult() failed.
pg_dump: Error message from server: ERROR: invalid page in block 4123007 of relatton base/16490/21396989
pg_dump: The command was: COPY public.ws_log_smevlog [...]
pg_dunp: [parallel archtver] a worker process dled unexpectedly
Грешка «invalid page in block» означава проблеми на ниво файлови системи, което е много лошо. На различни форуми предлагат да направите FULL VACUUM с опцията zero_damaged_pages за решаване на този проблем. Какво да кажем, ще опитаме…
Подготовка за възстановяване
ВНИМАНИЕ! Задължително направете резервно копие на Postgres преди всяка опит за възстановяване на базата данни. Ако имате виртуална машина, спрете базата данни и направете снимка. Ако нямате възможност да направите снимка, спрете базата и копирайте съдържанието на директорията на Postgres (включително wal файловете) на сигурно място. Най-важното в нашата работа е да не навредим. Прочетете .
Тъй като по принцип базата ми работеше, ограничих се до обикновен дамп на базата данни, но изключих таблицата с повредените данни (опция -T, —exclude-table=TABLE в pg_dump).
Сървърът беше физически, не беше възможно да се направи снимка. Бекъпът е направен, продължаваме нататък.
Проверка на файловата система
Преди да опитате да възстановите базата данни, трябва да се уверите, че всичко е наред с файловата система. И в случай на грешки, да ги поправите, защото в противен случай може да направите само по-лошо.
В моя случай файловата система с базата данни беше примонтирована в «/srv» и типът беше ext4.
Спираме базата данни: systemctl stop postgresql@9.5-main.service и проверяваме, че файловата система не се използва и може да бъде демонтирана с команда lsof:
lsof +D /srv
Трябваше също да спра базата данни redis, тъй като също я използваше «/srv». След това я демонтирах /srv (umount).
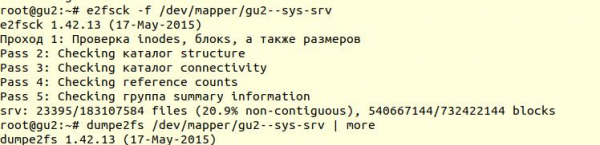
Проверка на файловата система беше извършена с помощта на утилита e2fsck с ключа -f (Force checking even if filesystem is marked clean):
След това с помощта на утилита dumpe2fs (sudo dumpe2fs /dev/mapper/gu2-sys-srv | grep checked) може да се уверим, че проверката действително е направена:
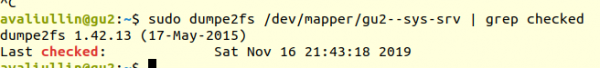
e2fsck казва, че проблеми на нивото на файловата система ext4 не са намерени, а това означава, че можем да продължим опитите да възстановим базата данни, а именно да се върнем към vacuum full (разбира се, е необходимо да монтираме файловата система обратно и да стартираме базата данни).
Ако имате физически сървър, задължително проверете състоянието на дисковете (чрез smartctl -a /dev/XXX) или на RAID контролера, за да се уверите, че проблемът не е на хардуерно ниво. В моя случай RAID беше 'железен', затова помолих местния администратор да провери състоянието на RAID (сървърът беше на няколко стотин километра от мен). Той каза, че няма грешки, а това означава, че можем да започнем възстановяването.
Опит 1: zero_damaged_pages
Свързваме се с базата чрез psql с акаунт, който има права на суперпотребител. Нужен ни е именно суперпотребител, тъй като само той може да променя опцията zero_damaged_pages . В моя случай това е postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Опция zero_damaged_pages нужна е, за да игнорираме грешките при четене (от сайта postgrespro):
При откриване на повреден заглавен блок Postgres Pro обикновено съобщава за грешка и прекъсва текущата транзакция. Ако параметърът zero_damaged_pages е включен, вместо това системата издава предупреждение, нулира повредената страница в паметта и продължава обработката. Това поведение унищожава данни, а именно всички редове в повредената страница.
Включваме опцията и опитваме да направим full vacuum на таблицата:
VACUUM FULL VERBOSE 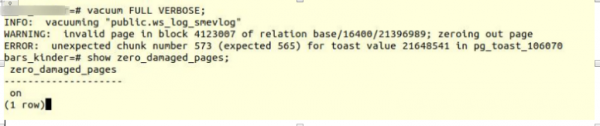
За съжаление, неуспех.
Сблъскваме се с аналогична грешка:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– механизъм за съхранение на "дълги данни" в Postgres, ако те не се побират в една страница (по подразбиране 8кб).
Опит 2: reindex
Първият съвет от Google не помогна. След няколко минути търсене намерих втория съвет – да направя reindex повредената таблица. Видях този съвет на много места, но не ми вдъхваше доверие. Нека направим reindex:
reindex table ws_log_smevlog 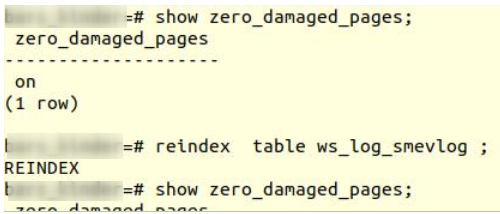
reindex завершен без проблеми.
Въпреки това, това не помогна, VACUUM FULL системата се затвори с подобна грешка. Тъй като бях свикнал с неуспехите, започнах да търся съвети в интернет и попаднах на доста интересна .
Опит 3: SELECT, LIMIT, OFFSET
В горната статия предлагаха да разгледам таблицата ред по ред и да премахна проблемните данни. Първо трябваше да прегледам всички редове:
for ((i=0; i/dev/null || echo $i; doneВ моя случай таблицата съдържаше 1 628 991 реда! В идеалния случай трябваше да се погрижа за , но това е тема за отделно обсъждане. Беше събота, стартирах тази команда в tmux и отидох да спя:
for ((i=0; i/dev/null || echo $i; doneНа сутринта реших да проверя как стоят нещата. Към моя изненада открих, че за 20 часа бяха сканирани само 2% от данните! Не исках да чакам 50 дни. Още един провал.
Но не се отказах. Интересуваше ме защо сканирането отнемаше толкова време. От документацията (отново на postgrespro) разбрах:
OFFSET указва да се пропуснат указаното количество редове, преди да започне да извежда редовете.
Ако са указани и OFFSET, и LIMIT, първо системата пропуска редовете OFFSET, а след това започва да брои редовете за ограничението LIMIT.Прилагането на LIMIT е важно да се използва и клаузата ORDER BY, за да се извеждат редовете в определен ред. В противен случай ще се връщат непредсказуеми подмножества от редовете.
Очевидно, че написаната по-горе команда беше грешна: на първо място, нямаше order by, резултатът можеше да е грешен. На второ място, Postgres първо трябваше да сканира и пропусне OFFSET-редовете, и с увеличаването на OFFSET производителността щеше да намалява още повече.
Опит 4: да направя дамп в текстов формат
След това ми хрумна, изглеждаща гениална идея: да направя дамп в текстов формат и да анализирам последния записан ред.
Но първо, да се запознаем със структурата на таблицата ws_log_smevlog:
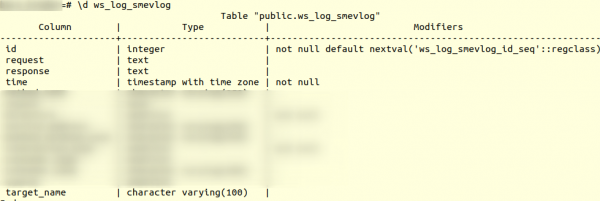
В нашия случай имаме колона "id", която съдържаше уникален идентификатор (сметчик) на реда. Планът беше такъв:
- Започвам да правя дамп в текстов формат (като sql-команди)
- В определен момент времени извлечение дампа было прервано из-за ошибки, но текстовый файл все равно сохранился бы на диске.
- Смотрим в конец текстового файла, таким образом мы находим идентификатор (id) последней строки, которая была извлечена успешно.
Я начал извлечение дампа в текстовом формате:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpИзвлечение дампа, как и ожидалось, прервалось с той же самой ошибкой:
pg_dump: Сообщение об ошибке от сервера: ERROR: недопустимая страница в блоке 4123007 базовой таблицы/16490/21396989 Далее через tail я посмотрел конец дампа (tail -5 ./my_dump.dump) и обнаружил, что дамп прервался на строке с id 186 525. "Значит, проблема в строке с id 186 526, она повреждена, её и нужно удалить!" - подумал я. Но, сделав запрос к базе данных:
«select * from ws_log_smevlog where id=186529оказалось, что с этой строкой все в порядке... Строки с индексами 186 530 — 186 540 также работали без проблем. Очередная "гениальная идея" провалилась. Позже я понял, почему так произошло: при удалении или изменении данных в таблице, они не удаляются физически, а помечаются как "мертвые кортежи", далее приходит autovacuum и помечает эти строки удаленными и разрешает использовать их повторно. Для понимания, если данные в таблице изменяются и включен autovacuum, то они не хранятся последовательно.
Попытка 5: SELECT, FROM, WHERE id=
Неудачи делают нас сильнее. Никогда не стоит сдаваться, нужно идти до конца и верить в себя и свои возможности. Поэтому я решил попробовать ещё один вариант: просто просмотреть все записи в базе данных по одному. Зная структуру моей таблицы (см. выше), у нас есть поле id, которое является уникальным (первичным ключом). В таблице у нас 1 628 991 строка и id они идут по порядку, а это значит, что мы можем просто перебирать их по одному:
for ((i=1; i/dev/null || echo $i; doneЕсли кто не понимает, команда работает следующим образом: построчно просматривает таблицу и отправляет stdout в /dev/null, но если команда SELECT проваливается, то выводится текст ошибки (stderr отправляется в консоль) и выводится строка, содержащая ошибку (благодаря ||, который означает, что у select возникли проблемы (код возврата команды не 0)).
Мне повезло, у меня были созданы индексы по полю id:
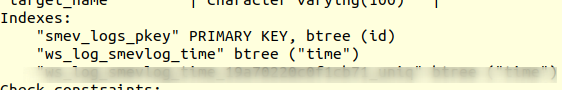
И това означава, че намирането на реда с необходимия id не трябва да отнема много време. В теорията трябва да сработи. Какво да кажем, стартираме командата в tmux и отиваме да спим.
На сутринта открих, че са прегледани около 90 000 записа, което представлява малко над 5%. Отличен резултат в сравнение с предишния метод (2%)! Но не ми се чакаха 20 дни...
Опит 6: SELECT, FROM, WHERE id >= и id <
На клиента беше предоставен отличен сървър за БД: двуядрен Intel Xeon E5-2697 v2, в нашето разположение имаше цели 48 потока! Натоварването на сървъра беше средно, без особени проблеми можехме да вземем около 20 потока. Оперативната памет също беше достатъчно: цели 384 гигабайта!
Така че командата трябваше да бъде разпаралелизирана:
for ((i=1; i/dev/null || echo $i; doneТук можеше да се напише красив и елегантен скрипт, но избрах най-бързия начин за разпаралелизиране: ръчно да разделя диапазона 0-1628991 на интервали от по 100 000 записа и да стартирам отделно 16 команди от вида:
for ((i=N; i/dev/null || echo $i; doneНо това не е всичко. По принцип, свързването с базата данни също отнема известно време и системни ресурси. Свързването на 1 628 991 не изглеждаше много разумно, съгласете се. Затова нека при едно свързване да извлечем 1000 реда вместо един. В крайна сметка командата се трансформира в това:
for ((i=N; i=$i and id/dev/null || echo $i; doneОтваряме 16 прозореца в сесия tmux и стартираме командите:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
След един ден получих първите резултати! Тоест (стойностите XXX и ZZZ вече не са запазени):
ERROR:  липсва част номер 0 за toast значение 37837571 в pg_toast_106070
829000
ERROR:  липсва част номер 0 за toast значение XXX в pg_toast_106070
829000
ERROR:  липсва част номер 0 за toast значение ZZZ в pg_toast_106070
146000
Това означава, че имаме три реда, които съдържат грешка. ID на първия и втория проблемен запис се намираха между 829 000 и 830 000, а ID на третия – между 146 000 и 147 000. След това трябваше просто да намерим точното значение на ID на проблемните записи. За целта преглеждаме нашия диапазон с проблемни записи с стъпка 1 и идентифицираме ID:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Щастлив край
Намерихме проблемните редове. Влизаме в базата през psql и опитваме да ги изтрием:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
За мое учудване, записите се изтриха без никакви проблеми дори без опция zero_damaged_pages.
След това се свързах с базата, направих VACUUM FULL (мисля, че не беше необходимо), и накрая успешно направих бекъп с помощта на pg_dump. Дампът се получи без никакви грешки! Проблемът беше решен по такъв глупав начин. Радостта беше безкрайна, след толкова неуспехи успях да намеря решение!
Благодарности и заключение
Това беше моят първи опит за възстановяване на реална база данни Postgres. Този опит ще запомня за дълго.
И накрая, искам да благодаря на компанията PostgresPro за преведената документация на български език и за , които много помогнаха по време на анализа на проблема.
Източник: habr.com
