

Нашата компания от 2008 година се занимава основно с управление на инфраструктури и 24/7 техническа поддръжка на уеб проекти: имаме над 400 клиенти, което представлява около 15% от електронната търговия в Русия. Съответно, поддръжката е с много разнообразна архитектура. Ако нещо се срива, ние сме задължени да го поправим в рамките на 15 минути. Но за да разберем, че е настъпила авария, трябва да наблюдаваме проекта и да реагираме на инцидентите. А как да го направим?
Смятам, че в организацията на правилна система за мониторинг се появява проблем. Ако нямаше проблеми, то моето изказване щеше да се състои в един единствен тезис: „Моля, инсталирайте Prometheus + Grafana и приставки 1, 2, 3“. За съжаление, вече не работи по този начин. И основният проблем е, че всички продължават да вярват в нещо, което е съществувало през 2008 година, от гледна точка на софтуерните компоненти.
Относно организацията на системата за мониторинг, ще рискувам да кажа, че... проекти с грамотно наблюдение не съществуват. И ситуацията е толкова лоша, че ако нещо се срине, съществува риск това да остане незабелязано — всички са уверени, че „всичко се наблюдава“.
Може би всичко се наблюдава. Но как?
Всички ние сме се сблъсквали с история, подобна на следната: работи някакъв DevOps, някакъв администратор, идва при тях екипът на разработчиците и казва — „изпуснахме версия, сега наблюдавай“. Какво да наблюдаваш? Как работи това?
Добре. Наблюдаваме по стародавен начин. А то вече се променя, и се оказва, че наблюдаваш услуга A, която стана услуга B, която взаимодейства с услуга C. Но екипът на разработчиците ти казва: „Инсталирай софтуер, той трябва да наблюдава всичко!“
Какво се е променило? — Всичко се е променило!
2008 година. Всичко е прекрасно.
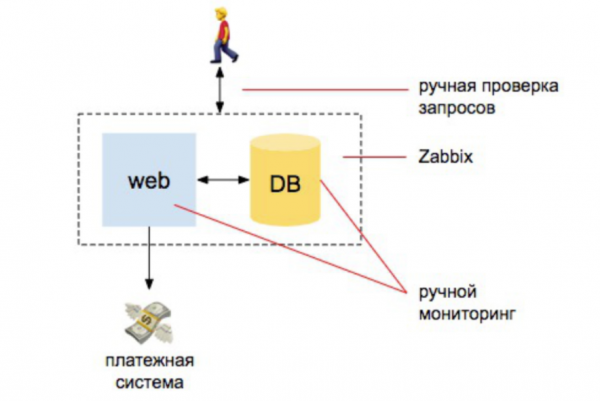
Има двама разработчици, един сървър, един сървър за БД. От тук всичко тръгва. Имаме някаква информация, поставяме Zabbix, Nagios, Cacti. И след това поставяме разбираеми аларми за CPU, за работа на дискове, за пространство на дисковете. Още правим няколко ръчни проверки, че сайтът отговаря, че поръчките идват в базата данни. И всичко – сме повече или по-малко защитени.
Ако сравним обема работа, който администраторът е вършил за осигуряване на мониторинг в миналото, 98% от нея е била автоматизирана: човекът, който се занимава с мониторинг, трябва да разбере как да инсталира Zabbix, как да го конфигурира и да настрои алерти. А 2% — за външни проверки: дали сайтът отговаря и прави заявки към базата данни, дали новите поръчки пристигат.
2010 година. Натоварването расте
Започваме да мащабираме уеб сайтовете, добавяме търсачка. Искаме да сме сигурни, че каталогът съдържа всички продукти. И че търсенето на продукти работи. Че базата данни работи, че поръчки се правят, че сайтът отговаря външно и реагира с два сървъри и потребителят не е изхвърлян от сайта, докато се балансира на друг сървър и т.н. Съществата стават все повече.
Въпреки това, съществото, свързано с инфраструктурата, все още остава най-голямото в съзнанието на мениджъра. Все още в съзнанието циркулира идеята, че човекът, който се занимава с мониторинг, е този, който ще инсталира Zabbix и ще може да го конфигурира.
Но в същото време се появяват задачи за провеждане на външни проверки, за създаване на набор от скриптове за заявки на търсачката, набор от скриптове за проверка на това, че търсенето се променя в процеса на индексиране, набор от скриптове, които проверяват, че на услугата за доставка се предават стоки и т.н. и т.н.
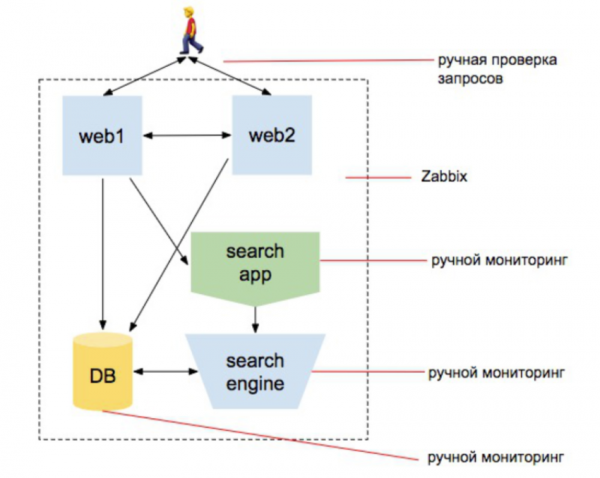
Обърнете внимание: три пъти написах "набор от скриптове". Тоест отговорният за мониторинга вече не е само този, който инсталира Zabbix. Това е човекът, който започва да кодира. Но в съзнанията на екипа все още нищо не се променя.
Но светът се променя, ставайки все по-сложен. Добавят се слой на виртуализация, няколко нови системи. Те започват да взаимодействат помежду си. Кой каза "пуха микросервизите?" Но всеки сервис все още изглежда като сайт поотделно. Можем да се свържем с него и да разберем, че той предоставя необходимата информация и работи сам по себе си. И ако си администратор, който постоянно се занимава с проект, който се развива 5-7-10 години, тези знания се натрупват: появява се ново ниво — осъзнаваш го, появява се още едно ниво — осъзнаваш го...
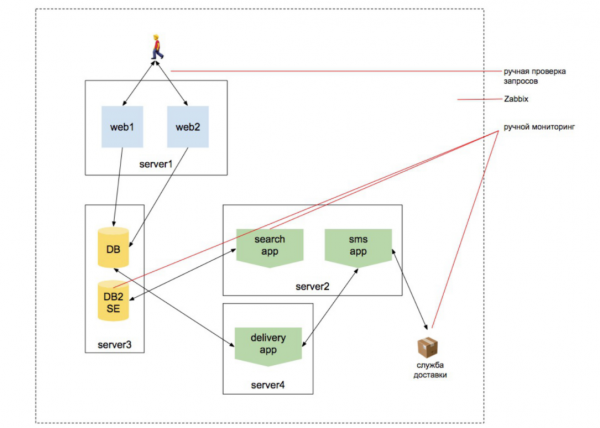
Но рядко някой поддържа проект 10 години.
Резюме на мониторинг специалист
Представете си, че сте в нов стартап, който веднага е наел 20 разработчици, написали са 15 микросервиса, а вие сте администратор, който чува: „Създайте CI/CD. Моля“. Вие изграждате CI/CD и изведнъж чувате: „Трудно ни е да работим с продуктивната среда в „куб“, без да разбираме как ще функционира приложението там. Направете ни песочница в същия „куб“.
Вие създавате песочницата в този куб. Веднага ви казват: „Искаме stage база данни, която да се обновява всеки ден от продуктивната среда, за да разберем, че това работи на база данни, но в същото време да не развалим продуктивната база данни.“
Вие живеете в всичко това. Остават 2 седмици до релиза, и ви казват: „Сега трябва да го мониторираме…“ Т.е. да мониторирате кластерната инфраструктура, да мониторирате микросервисната архитектура, да мониторирате работата с външните услуги…
А колегите изваждат от главите си обичайната схема и казват: „Тук всичко е ясно! Поставете програма, която да го мониторират“. Да-да: Prometheus + Grafana + плугини.
И добавят: „Имаш две седмици, направи така, че всичко да е надеждно.“
В множество проекти, които виждаме, за мониторинг се отделя един човек. Представете си, че искаме да наемем човек за 2 седмици, който да се занимава с мониторинг, и правим резюме за него. Какви умения трябва да притежава този човек – като вземем предвид всичкото казано по-горе?
- Той трябва да разбира мониторинга и спецификата на работа с хардуерната инфраструктура.
- Той трябва да познава спецификата на мониторинга на Kubernetes (всички искат в „куб“, защото могат да се абстрахират от всичко, да се скрият, защото администратора ще се справи с останалото) – само по себе си, неговата инфраструктура и да разбира как да мониторира приложенията вътре.
- Той трябва да разбира, че услугите комуникират по специални начини и да знае спецификите на взаимодействието между услугите. Възможно е да видите проект, където част от услугите комуникират синхронно, защото иначе не може. Например, бекендът работи по REST, по gRPC към услугата за каталог, получава списък с продукти и го връща обратно. Тук не може да се чака. А с други услуги работи асинхронно. Предава поръчката на куриерската служба, изпраща имейл и т.н.
Вие, вероятно, вече сте се загубили от всичко това? А администраторът, който трябва да го следи, се е загубил още повече. - Той трябва да умея да планира и да планира правилно, тъй като работите стават все повече и повече.
- Той следователно трябва да създаде стратегия от създадения сервис, за да разбере как точно да го наблюдава. Нужно е да има разбиране за архитектурата на проекта и неговото развитие + разбиране на технологиите, които се използват в разработката.
Да си припомним напълно нормален случай: част от сервисите са на PHP, част от сервисите на Go, част от сервисите на JS. Те работят помежду си. Оттук идва терминът "микросервис": отделните системи станаха толкова много, че разработчиците не могат да разберат проекта в цялост. Една част от екипа пише сервисите на JS, които работят сами по себе си и не знаят как функционира остатъчната система. Друга част пише сервисите на Python и не се надавят на това как работят другите сервисови, те са изолирани в своята област. Третата част пише сервисите на PHP или нещо друго.
Всички тези 20 души са разделени на 15 сервисa и има само един администратор, който трябва да разбере всичко това. Стоп! Току-що разделихме системата на 15 микросервиза, защото 20 души не могат да разбират цялата система.
Но все пак трябва някак да се наблюдава...
Какъв е крайният резултат? В крайна сметка има един човек, който разбира всичко, което не може да разбере цял екип от разработчици и в същото време той още трябва да знае и може това, което посочихме по-горе — хардуерна инфраструктура, инфраструктура Kubernetes и т.н.
Какво да кажем... Хюстън, имаме проблем.
Наблюдението на съвременен софтуерен проект е самостоятелен софтуерен проект.
От фалшивата увереност, че наблюдението е софтуер, идва нашата вяра в чудеса. А чудесата, за съжаление, не съществуват. Не може да инсталирате Zabbix и да очаквате всичко да заработи. Няма смисъл да инсталирате Grafana и да се надявате, че всичко ще бъде наред. Голямата част от времето ще отиде за организиране на проверки на работата на сервисите и техните взаимодействия помежду си, проверки как работят външните системи. Всъщност 90% от времето ще отиде не за писане на скриптове, а за разработка на софтуер. И с това трябва да се занимава екип, който разбира работата на проекта.
Ако в тази ситуация един човек бъде натоварен с наблюдението, ще се случи беда. Както се случва навсякъде.
Например, има няколко сервиза, които комуникират помежду си през Kafka. Получи се поръчка, изпратихме съобщение за поръчката в Kafka. Има сервиз, който слуша информацията за поръчката и организира доставката на стоките. Има и сервиз, който слуша информацията за поръчката и изпраща имейл на потребителя. А след това се появява още много сервизи и започваме да се объркваме.
А ако отдаде това на администратора и разработчиците на етап, когато остава кратко време до пускането, човекът ще трябва да разбере целия този протокол. Т.е. проект от подобен мащаб отнема значително време, и в разработването на системата това трябва да бъде предвидено.
Но много често, особено в стартапите, виждаме как мониторингът се отлага за по-късно. „Сега ще направим Proof of Concept, ще го стартираме, нека да пада – готови сме да жертваме. А после всичко това ще следим“. Когато (или ако) проектът започне да носи пари, бизнесът иска да добави още функции — защото вече започна да работи, значи трябва да се добавя още! А вие се намирате в момент, в който първо трябва да следите всичко преди, което отнема не 1% от времето, а значително повече. И между другото, за мониторинга ще ви трябват разработчици, а е по-лесно да ги пуснете да работят по нови функции. В резултат на това се пишат нови функции, всичко се натрупва и вие попадайте в безкраен deadlock.
Как да мониторим проект от самото начало и какво да правим, ако сте получили проект, който трябва да мониторите, а не знаете откъде да започнете?
На първо място, трябва да планирате.
Личен отстъп: много често започват с мониторинг на инфраструктурата. Например, имаме Kubernetes. Нека да започнем с инсталиране на Prometheus с Grafana, да инсталираме плъгини за мониторинг на "кубчето". Не само разработчиците, но и администраторите имат тъжната практика: „Ще инсталираме този плъгин, а плъгинът вероятно знае как да го направи“. Хората обичат да започват с прости и разбираеми неща, а не с важни действия. И мониторингът на инфраструктурата е просто.
Преди всичко решете какво и как искате да наблюдавате, а след това подберете инструмент, защото другите хора не могат да мислят вместо вас. А и трябва ли? Другите хора мислеха за себе си, за универсалната система — или изобщо не мислеха, когато писаха този плъгин. И фактът, че този плъгин има 5000 потребители, не означава, че носи някаква полза. Може би вие ще бъдете 5001-ият просто защото преди вас вече е имало 5000 души.
Ако сте започнали да наблюдавате инфраструктурата и бекендът на вашето приложение е спрял да отговаря, всички потребители ще загубят връзка с мобилното приложение. Ще възникне грешка. Хората ще дойдат и ще кажат "Приложението не работи, какво правите тук?" — "Ние наблюдаваме." — "Как наблюдавате, ако не виждате, че приложението не работи?!"
- Смятам, че наблюдението трябва да започне именно от входната точка на потребителя. Ако потребителят не вижда, че приложението работи — всичко, това е провал. И системата за наблюдение трябва да предупреди за това на първо място.
- И едва след това можем да наблюдаваме инфраструктурата. Или да го направим паралелно. С инфраструктурата е по-лесно — тук накрая можем просто да инсталираме zabbix.
- И сега трябва да погледнем в корените на приложението, за да разберем къде какво не работи.
Основната ми мисъл е, че наблюдението трябва да протича паралелно с процеса на разработка. Ако отклоните екипа за наблюдение за други задачи (създаване на CI/CD, тестова среда, реорганизация на инфраструктурата), наблюдението ще започне да изостава и вие, може би, никога повече няма да настигнете разработката (или рано или късно ще се наложи да я спрете).
Всичко по нива
Ето как виждам организацията на системата за наблюдение.
1) Ниво на приложението:
- наблюдение на бизнес логиката на приложението;
- наблюдение на health метрики на услугите;
- интеграционно наблюдение.
2) Ниво на инфраструктурата:
- наблюдение на ниво оркестрация;
- наблюдение на системния софтуер;
- наблюдение на ниво "хардуер".
3) Отново ниво на приложението — но вече като инженерно решение:
- събиране и наблюдение на журналите на приложението;
- APM;
- tracing.
4) Алармиране:
- организация на системата за уведомления;
- организация на системата за дежурства;
- организация на "база знания" и работен процес за обработка на инциденти.
Важно: достигаме до алертинга не след, а веднага! Не е нужно да стартирате мониторинг и «по някакъв начин след това» да измисляте на кого ще се изпращат алертите. В крайна сметка, каква е целта на мониторинга: да разберем къде в системата нещо не работи правилно и да уведомим нужните хора. Ако това се остави за накрая, нужните хора ще разберат, че нещо не е наред, само след обаждане «при нас нищо не работи».
Ниво на приложението — мониторинг на бизнес логиката
Тук става въпрос за проверки на самия факт, че приложението работи за потребителя.
Това ниво трябва да бъде реализирано на етапа на разработка. Например, имаме условен Prometheus: той се свързва със сървър, който извършва проверките, извиква endpoint и endpoint извършва проверка на API.
Когато често искат да се мониторира главната страница, за да се уверят, че сайтът работи, програмистите предоставят ръка, която може да бъде активирана всеки път, когато трябва да се уверим, че API работи. А в същото време програмистите пишат /api/test/helloworld.
Единственият начин да се уверите, че всичко работи? — Не!
- Създаването на такива проверки — по същество задача на разработчиците. Unit тестовете трябва да пишат програмистите, които пишат кода. Защото, ако го оставите на администратора «Човек, ето ти списък с протоколи на API на всичките 25 функции, моля, мониторирай всичко!» — няма да се получи нищо.
- Ако направите print “hello world”, никой никога няма да разбере, че API трябва да работи и наистина работи. Всяка промяна в API трябва да води до промяна в проверките.
- Ако вече имате такъв проблем – спрете функциите и назначете разработчици, които да напишат тези проверки, или се примирете с загубите, приемете, че нищо не се проверява и ще се срива.
Технически съвети:
- Задължително организирайте външен сървър за извършване на проверки — трябва да сте сигурни, че проектът ви е достъпен за външния свят.
- Организирайте проверка на целия API протокол, а не само на отделни endpoints.
- Създайте prometheus-endpoint с резултатите от проверките.
Ниво на приложението — мониторинг на health метриките
Сега става въпрос за външни health метрики на услугите.
Решихме, че ще наблюдаваме всички "ръчки" на приложението чрез външни проверки, които инициираме от външна система за мониторинг. Но това са именно "ръчките", които "вижда" потребителят. Ние искаме да сме сигурни, че самите услуги работят. Тук историята е по-добра: в K8s има health-checks, за да може поне самият "кубик" да се увери, че услугата работи. Но половината от проверките, които съм виждал, са просто print "hello world". Т.е. той извиква един път след деплоя, получава отговор, че всичко е наред — и толкова. А при услугата, ако чрез rest API предоставя своя API, има огромно количество входни точки на същия този API, който също трябва да се наблюдава, защото искаме да знаем, че работи. И ние го наблюдаваме вътре.
Как технически да се реализира това: всяка услуга предоставя endpoint за текущото си състояние, а в графиките на Grafana (или всяко друго приложение) виждаме статуса на всички услуги.
- Всяка промяна в API трябва да води след себе си промени в проверките.
- Създавайте нова услуга веднага с health-метрики.
- Администраторът може да се обърне към разработчиците и да поиска "допишете ми няколко функции, за да разбера всичко и да добавя информация за това в моята система за мониторинг". Но разработчиците обикновено отговарят "Две седмици преди релиза не смятаме да добавяме каквото и да е".
Нека ръководителите на разработката знаят, че ще има такива загуби, нека и началниците на мениджърите знаят. Защото, когато всичко се срине, някой все пак ще се обади и ще изисква да се мониторира "постоянно падащата услуга" (с) - Между другото, отделете разработчици за писане на плъгини за Grafana — това ще бъде добра помощ за администраторите.
Ниво на приложението — Интеграционно мониторинг
Интеграционният мониторинг се фокусира върху наблюдението на комуникацията между критични за бизнеса системи.
Например, има 15 услуги, които комуникират помежду си. Това не са вече отделни сайтове. Т.е. не можем да извикаме услугата сама по себе си, да получим /helloworld и да разберем, че услугата работи. Защото уеб услугата за обработка на поръчки трябва да изпрати информация за поръчката в шина — от шината служба за работа с склада трябва да получи това съобщение и да работи с него по-нататък. А услугата за изпращане на имейли трябва да обработи това по някакъв начин, и т.н.
Следователно, не можем да разберем, опипвайки все отделни услуги, как всичко това работи. Защото имаме една шина, през която всичко комуникира и взаимодейства.
Така че, този етап трябва да обозначава етапа на тестване на услугите при взаимодействие с други услуги. Невъзможно е, само наблюдавайки брокера на съобщения, да организираме мониторинг на комуникацията. Ако има услуга, която предоставя данни, и услуга, която ги приема, при наблюдение на брокера ще видим само данните, които преминават насам-натам. Дори да успеем да наблюдаваме взаимодействието на тези данни вътре — че един продуцент публикува данни, някой ги чете, този поток продължава да върви в Kafka — все пак това не ще ни даде информация, ако едната услуга е изпратила съобщение в една версия, а другата услуга не е очаквала тази версия и я е пропуснала. Няма да разберем за това, тъй като услугите ще ни кажат, че всичко работи.
Как препоръчвам да proceed-нете:
- За синхронна комуникация: endpoint-ът изпълнява заявки към свързаните услуги. Т.е. взимаме този endpoint, задействаме скрипт вътре в услугата, който обикаля всички точки и казва 'мога да задействам там, и там, мога да задействам…'
- За асинхронна комуникация: входящите съобщения — endpoint-ът проверява шината за наличието на тестови съобщения и издава статус на обработката.
- За асинхронна комуникация: изходящите съобщения — endpoint-ът изпраща тестови съобщения на шината.
Как обикновено се случва: имаме услуга, която изпраща данни в шината. Пристигаме в тази услуга и искаме да ни разкаже за индивидуалното си здравословно състояние. И ако услугата трябва да произведе някакво съобщение на някъде (WebApp), тя ще произведе това тестово съобщение. А ако извикваме услугата от страна на OrderProcessing, първо тя публикува онова, което може да публикува независимо, а ако има някакви зависими неща — тя чете от шината набор от тестови съобщения, разбира какво може да обработи, съобщава за това и, ако е необходимо, ги публикува по-нататък, и за това казва — всичко е наред, аз съм на линия.
Много често чуваме въпросът "как можем да тестваме това на реални данни?" Например, става въпрос за същата услуга за поръчки. Поръчката изпраща съобщения до склада, където се отписват стоките: не можем да тестваме това на реални данни, защото "продуктите ми ще бъдат отписани!" Решението: в началния етап планирайте всичките тези тестове. Имате unit тестове, които правят mock. Направете го на по-дълбоко ниво, където ще премине каналът на комуникация, който няма да навреди на бизнеса.
Ниво на инфраструктурата
Мониторингът на инфраструктурата - това, което отдавна се счита за самия мониторинг.
- Мониторингът на инфраструктурата може и трябва да бъде стартиран като отделен процес.
- Не трябва да започвате с мониторинга на инфраструктурата в работещ проект, дори и да искате много. Това е болка за всички девопси. "Първо ще мониторя кластера, след това инфраструктурата" - т.е. първо ще мониторира онова, което е отдолу, а в приложението няма да се засяга. Защото приложението е неразбираема работа за девопса. То му е предадено и той не разбира как работи. А инфраструктурата я разбира и започва с нея. Но не - винаги трябва да се мониторира приложението.
- Не прекалявайте с количеството уведомления. Като се има предвид сложността на съвременните системи, алармите идват постоянно, и с този поток от аларми трябва да се живее по някакъв начин. Човекът on-call, поглеждайки поредицата от сто аларми, ще реши "не искам да мисля за това". Алармите трябва да уведомяват само за критични неща.
Ниво на приложението като бизнес единица
Ключови моменти:
- ELK. Това е индустриален стандарт. Ако по някаква причина не агрегирате логовете, спешно започнете да го правите.
- APM. Външни APM като начин бързо да затворите мониторинга на приложението (NewRelic, BlackFire, Datadog). Можете временно да внедрите този инструмент, за да разберете какво се случва.
- Tracing. В десетки микросервизи трябва да трейсвате всичко, защото заявката вече не живее сама по себе си. Доколкото е сложно да се добави по-късно, е по-добре веднага да планирате tracing в разработката - това е работа и инструмент на разработчиците. Ако още не сте внедрили - внедрете! Вижте Jaeger/Zipkin.
Алармиране
- Организиране на система за известяване: при мониторинг на множество неща трябва да има единна система за разпространение на известията. Може да се използва Grafana. На Запад всички използват PagerDuty. Известията трябва да бъдат ясни (например, откъде идват…). И е желателно да се контролира дали известията изобщо стигат.
- Организиране на система за дежурства: алармите не трябва да идват до всички (иначе ще реагират на golямата група или никой няма да реагира). Oncall трябва да бъдат и разработчиците: задължително определете зоните на отговорност, направете ясна инструкция и запишете в нея на кого точно да се обаждат в понеделник и сряда, а на кого — във вторник и петък (иначе няма да се обадят дори в случай на голяма беда — ще се страхуват да събудят, да притеснят: хората изобщо не обичат да звънят и будят другите, особено през нощта). И обяснете, че искането за помощ — не е признак на некомпетентност ("аз моля за помощ — значи съм лош работник"), насърчавайте исканията за помощ.
- Организация на "базата знания" и работния поток за обработка на инциденти: за всеки сериозен инцидент трябва да бъде насрочен постмортем, като временна мярка трябва да бъдат фиксирани действията, които ще решат инцидента. И завеждайте практика, че повтарящите се аларми — това е грях; те трябва да бъдат поправени в кода или инфраструктурната работа.
Технологичен стек
Нека си представим, че стекът е следният:
- събиране на данни — Prometheus + Grafana;
- анализ на логовете — ELK;
- за APM или Tracing — Jaeger (Zipkin).

Изборът на варианти не е критичен. Защото, ако от самото начало разберете как да мониторите системата и опишете план, след това вече започвате да избирате инструменти според вашите изисквания. Въпросът е какво сте избрали да мониторите в началото. Защото, възможно е инструментът, който сте избрали в началото — изобщо да не отговаря на вашите изисквания.
Няколко технически момента, които виждам навсякъде напоследък:
Prometheus се вкарва вътре в Kubernetes — кой го измисли?! Ако клъстерът ви падне, какво ще правите? Ако имате сложен клъстер, вътре трябва да работи определена система за мониторинг, а отвън — друга, която ще събира данни от клъстера.
Вътре в клъстера събираме логове и всичко останало. Но системата за мониторинг трябва да бъде извън. Много често в клъстера, където има Prometheus, който е инсталиран вътре, има и системи, които правят външни проверки на работата на сайта. А ако вашите връзки към външния свят са паднали и приложението не работи? Получава се, че вътре всичко е наред, но на потребителите от това не им е по-лесно.
Изводи
- Разработката на мониторинг не е инсталирането на утилити, а разработването на софтуерен продукт. 98% от днешния мониторинг е кодиране. Кодиране в услугите, кодиране на външни проверки, проверки на външни услуги и всичко-всичко-всичко.
- Не пестете времето на разработчиците за мониторинг: това може да отнеме до 30% от тяхната работа, но си струва.
- Девопс, не се притеснявайте, че не можете да мониторите нещо, защото някои неща изискват съвсем различен начин на мислене. Вие не сте били програмист, а работата по мониторинга е именно тяхна работа.
- Ако проектът вече работи и не е мониторингован (а сте мениджър) — отделете ресурси за мониторинг.
- Ако продуктът вече е в продукция, а вие сте девопс, на когото му казали „настройте мониторинга“ — опитайте се да обясните на ръководството това, за което говоря.
Това е разширена версия на доклада на конференцията Saint Highload++.
Ако ви интересуват моите идеи и размисли по it и свързани теми, можете да 🙂
Източник: habr.com
