

Предистория
Имаме търговски автомати с наша собствена разработка. Вътре са Raspberry Pi и малко свързване на отделна платка. Свързани са монетен приемник, банкнотен приемник, банков терминал... Управлява всичко самописна програма. Цялата история на работата се записва в журнал на флашка (MicroSD), която след това се предава чрез интернет (с помощта на USB модем) на сървър, където се съхранява в база данни. Информацията за продажбите се качва в 1С, има и простичък уеб интерфейс за мониторинг и т.н.
Тоест, журналът е жизненоважен – за отчет (там са приходите, продажбите и т.н.), мониторинг (всевъзможни аварии и други извънредни обстоятелства); това, можем да кажем, е всичката информация, която имаме за този автомат.
Проблема
Флашките се оказват много ненадеждни устройства. Те с завидна редовност излизат от строя. Това води до простои на автоматите, а също така (ако по какви-то причини журналът не може да бъде предаден онлайн) до загуби на данни.
Това не е първият опит с флашки, преди това имаше друг проект с повече от сто устройства, където журналът се съхраняваше на USB флашки, там също имаше проблеми с надеждността, понякога броят на излезлите от строя за месец се измерваше в десетки. Ходихме с различни флашки, включително и брандирани с SLC памет, да, някои модели са по-надеждни от други, но смяната на флашките не реши проблема коренно.
Внимание! Дълго четиво! Ако не ви интересува „защо“, а само „как“, можете веднага да отидете статията.
Решение
Първото, което ми идва наум: да се откажем от MicroSD, да поставим например SSD и да се зареждаме от него. Теоретично е възможно, вероятно, но е относително скъпо и не така надеждно (добавя се адаптер USB-SATA; статистиката за откази при бюджетни SSD също не радва).
USB HDD също не изглежда особено привлекателно решение.
Затова стигнахме до такъв вариант: да оставим зареждането от MicroSD, но да ги използваме в режим само за четене, а журналът на работа (и друга уникална информация за конкретното устройство – серийн номер, калибрации на сензорите и т.н.) да се съхранява някъде другаде.
Темата за read-only файлова система за Raspberry Pi вече е изследвана отвсякъде, няма да спирам на детайлите по изпълнението в тази статия (но ако има интерес – може би ще напиша мини-статия по тази тема). Единият момент, който искам да подчертая: както от личен опит, така и от отзиви на тези, които вече са внедрили, има предимства в надеждността. Да, напълно да се избегнат повреди не е възможно, но е напълно реално да се намали честотата им значително. Също така картите стават унифицирани, което значително улеснява замяната за обслужващия персонал.
Хардуерната част
С избора на тип памет нямаше особени съмнения – NOR Flash.
Аргументи:
- простo свързване (най-често шина SPI, опитът с която вече е наличен, така че „железни“ проблеми не се очакват);
- весела цена;
- стандартен протокол на работа (реализацията вече е налична в ядрото на Linux, при желание може да се вземе трета страна, които също присъстват, или дори да се напише своя, тъй като всичко е просто);
- надеждност и ресурс:
от типичен даташит: данните се съхраняват 20 години, 100000 цикъла изтриване за всеки блок;
от външни източници: изключително нисък BER, предполага се, че няма нужда от кодове за корекция на грешки (в някои проучвания се разглежда ECC за NOR, но обикновено там става въпрос за MLC NOR, случва се и такова).
Нека да преценим изискванията към обема и ресурса.
Искам да се гарантира, че данните ще се запазват в продължение на няколко дни. Това е необходимо, за да не се загуби историята на продажбите в случай на проблеми с връзката. Ще се ориентираме на 5 дни, през които (дори с оглед на почивните дни и празниците) можем да решим проблема.
В момента на ден се натрупват около 100kb дневник (3-4 хиляди записа), но постепенно това число нараства – увеличава се детайлността, добавят се нови събития. Плюс понякога има изблици (някой датчик започва да спами с фалшиви сработвания, например). Ще сметнем на 10 хиляди записа по 100 байта – мегабайт на ден.
Общо излиза 5Mb чисти (добре сжимаеми) данни. Към тях още (груба преценка) 1Mb служебни данни.
Така че ни трябва чип с 8Mb, ако не се използва компресия, или 4Mb, ако се използва. Напълно реалистични цифри за този тип памет.
Що се отнася до ресурса: ако планираме, че паметта изцяло ще се презаписва не по-често от веднъж на 5 дни, то за 10 години експлоатация получаваме по-малко от хиляда цикъла презапис.
Напомням, производителят обещава сто хиляди.
Няколко думи за NOR срещу NAND
Днес, разбира се, NAND паметта е много по-популярна, но за този проект не бих я използвал: за разлика от NOR, NAND задължително изисква използването на кодове за корекция на грешки, таблици с повредени блокове и т.н., а и пиновете на NAND чиповете обикновено са много повече.
Като недостатъци на NOR можем да посочим:
- малък обем (и съответно, висока цена за мегабайт);
- ниска скорост на обмен (до голяма степен заради използвания последователен интерфейс, обикновено SPI или I2C);
- бавен erase (в зависимост от размера на блока, отнема от части от секундата до няколко секунди).
По принцип, няма нищо критично за нас, така че продължаваме.
Ако ви интересуват детайлите, избрана е чипа (впрочем, това не е съществено, на пазара има много аналози, съвместими по разпиновка и команда; дори ако решим да поставим чип от друг производител и/или с друг обем, всичко ще работи без промяна на кода).
Използвам вграден в ядрото на Linux драйвер, на Raspberry благодарение на поддръжката на device tree overlay всичко е много просто — трябва да поставите компилирания overlay в /boot/overlays и да модифицирате малко /boot/config.txt.
Пример dts файл
Честно казано, не съм сигурен, че е написано без грешки, но работи.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
И още една редица в config.txt
dtoverlay=at25:spimaxfrequency=50000000Описание на самото свързване на чипа към Raspberry Pi пропускам. От една страна, не съм специалист по електроника, от друга — тук всичко е банално дори за мен: чипът има само 8 пина, от които ни трябват земя, захранване, SPI (CS, SI, SO, SCK); нивата съвпадат с тези на Raspberry Pi, не е необходима допълнителна свързване — просто свържете указаните 6 контакта.
Формулиране на задачата
Както обикновено, формулирането на задачата преминава през няколко итерации и ми се струва, че е време за още една. Нека се спрем, съберем накуп това, което вече е написано, и поясним останалите неясноти.
И така, определихме, че журнала ще се съхранява в SPI NOR Flash.
Какво е NOR Flash за тези, които не знаят
Това е енергонезависима памет, с която можем да правим три операции:
- Четене:
Най-обикновено четене: предаваме адрес и четем толкова байта, колкото ни трябват; - Запис:
Записването в NOR flash изглежда обичайно, но има едно особеност: можете само да променяте 1 на 0, но не обратното. Например, ако в паметта имаме 0x55, след записване на 0x0f там вече ще бъде запазено 0x05. (вж. таблицата малко по-долу); - Изтриване:
Разбира се, трябва да можем да правим и обратно действие — да сменяме 0 на 1; именно затова съществува операцията erase. В отличие от първите две, тя работи не с байтове, а с блокове (минималният erase block в избраната микросхема е 4kb). Erase унищожава целия блок и това е единственият начин да смените 0 на 1. Затова, при работа с флаш памет, често се налага да подравняваме структури от данни на границата на erase block.
Запис в NOR Flash:
Двоични данни
Имаше
01010101
Записахме
00001111
Стана
00000101
Самият журнал представлява последователност от записи с променлива дължина. Типичната дължина на записа е около 30 байта (въпреки че понякога може да се срещнат записи с дължина от няколко килобайта). В този случай работим с тях просто като с набор от байтове, но, ако е интересно, вътре в записите се използва CBOR.
Освен журнала, трябва да съхраняваме някаква "настройваща" информация, както обновяваща се, така и не: определен ID на устройството, калибриране на сензори, флаг "устройството временно е изключено" и др.
Тази информация представлява набор от записи key-value, също се съхранява в CBOR. Тази информация не е много (максимум няколко килобайта) и се обновява не често.
В по-нататъшните случаи ще я наричаме контекст.
Ако си спомним откъде започна тази статия, много е важно да осигурим надеждност на съхранение на данни и, по възможност, безперебойна работа дори в случай на хардуерни повреди/повреждане на данни.
Какви източници на проблеми можем да разгледаме?
- Изключване на захранването по време на операции write/erase. Това е от категорията "против лома нет приёма".
Информация от на stackexchange: при изключване на захранването по време на работа с флаш, както erase (установяване в 1), така и write (установяване в 0) водят до неопределено поведение: данните могат да се запишат, да се запишат частично (например, предадохме 10 байта/80 бита, а успяхме да запишем само 45 бита), не е изключено и част от битовете да е в "междинно" състояние (четенето може да даде както 0, така и 1); - Грешки в самата флаш памет.
BER, макар и много нисък, не може да бъде равен на нула; - Грешки по шината
Данните, предавани по SPI, не са защитени, и могат да възникнат както единични битови грешки, така и грешки в синхронизацията – загуба или вмъкване на битове (което води до масови изкривявания на данните); - Други грешки/неуспехи
Грешки в кода, „глючета“ на Raspberry, намеса на извънземни…
Сформирах изисквания, чието изпълнение, на моето мнение, е необходимо за осигуряване на надеждност:
- записите трябва да попадат в флаш памет веднага, отложеното записване не се разглежда; - ако възникне грешка, тя трябва да бъде открита и обработена възможно най-рано; - системата трябва, ако е възможно, да възстановява работата след грешки.
(пример от живота „как не трябва да бъде“, с който, мисля, всички сме се сблъсквали: след аварийно рестартиране файловата система е „разбита“ и операционната система не се зарежда)
Идеи, подходи, размишления
Когато започнах да се замислям върху тази задача, в главата ми минаваха куп идеи, например:
- да се използва компресия на данни;
- да се използват хитри структури от данни, например да се съхраняват заглавията на записите отделно от самите записи, за да може при грешка в някой запис да се прочетат без проблем останалите;
- да се използват битови полета за контрол на завършеността на записа при изключване на захранването;
- да се съхраняват контролни суми за всичко и всяка;
- да се използва някакъв вид устойчиво на смущения кодиране.
Част от тези идеи бяха използвани, от част беше решено да се откажем. Нека да продължим по ред.
Сжимането на данни
Събитията, които фиксираме в журнала, са достатъчно еднотипни и повтарящи се („хвърлихме монета от 5 лева“, „натиснахме бутона за получаване на рестото“, …). Затова компресията ще се окаже достатъчно ефективна.
Разходите за компресия не са съществени (процесорът ни е достатъчно мощен, дори на първия Pi имаше едно ядро с честота 700MHz, на актуалните модели няколко ядра с честота над гигахерц), скоростта на обмен с хранилището не е висока (няколко мегабайта в секунда), размерът на записите е малък. В общи линии, ако компресията и окаже влияние върху производителността, то само положително (абсолютно некритично, просто констатирам). Плюс, ние нямаме истински embedded, а обикновен Linux — така че реализацията не би трябвало да изисква много усилия (достатъчно е просто да свържете библиотеката и да използвате няколко функции от нея).
Взехме част от лог с работещо устройство (1.7MB, 70 хиляди записа) и първо проверихме за сжимаемост с помощта на наличните на компютъра gzip, lz4, lzop, bzip2, xz, zstd.
- gzip, xz, zstd показаха близки резултати (40KB).
Учудващо беше, че модният xz се представи наравно с gzip или zstd; - lzip с настройките по подразбиране даде малко по-лош резултат;
- lz4 и lzop показаха не особено добър резултат (150KB);
- bzip2 показа изненадващо добър резултат (18KB).
И така, данните се сжимат много добре.
Така че (ако не намерим фатални недостатъци) сжатието ще бъде! Просто защото на същата флашка ще се поберат повече данни.
Нека обсъдим недостатъците.
Проблемът е, че вече се споразумяхме, че всеки запис трябва незабавно да бъде записан на флашката. Обикновено архиваторът събира данни от входящия поток, докато не реши, че е време да запише в изходния. Но ние трябва веднага да получим сжат блок данни и да го запазим в енергийно независима памет.
Виждам три пътя:
- Сжимам всеки запис с помощта на словесно сжатие, вместо да разглеждаме описаните по-горе алгоритми.
Напълно работещ вариант, но не ми харесва. За да се осигури сравнително приемливо ниво на сжатие, речникът трябва да бъде "приготвен" за конкретни данни, всяка промяна ще доведе до катастрофално понижаване на нивото на сжатие. Да, проблемът може да се реши с нова версия на речника, но това е главоболие — трябва да съхраняваме всички версии на речника; във всеки запис трябва да указваме с коя версия на речника е сжат… - Сжимам всеки запис с "класически" алгоритми, но независимо от другите.
Разглежданите алгоритми за компресия не са съобразени да работят с записи от такъв размер (десетина байта), коефициентът на сжатие ще бъде явно под 1 (т.е. увеличаване на обема на данните вместо сжатие); - Правя FLUSH след всеки запис.
В много библиотеки за сжатие има поддръжка на FLUSH. Това е команда (или параметър на процедурата за сжатие), при получаване на която архиваторът формирa сжат поток така, че на основата на него могат да се възстановят всичко неденсжати данни, които вече са били получени. Такъв аналогsyncв файловите системи илиcommitв sql.
Важно е, че последващите операции по компресия ще могат да използват натрупания речник и степента на компресия няма да бъде толкова засегната, както в предишния вариант.
Мисля, че е очевидно, че избрах третия вариант, да спрем на него по-подробно.
Намерен за FLUSH в zlib.
Направих вдъхновен от статията тест, взех 70 хиляди записа от журнал на истинско устройство, при размер на страницата от 60Кб (к размера на страницата ще се върнем по-късно) получих:
Изходни данни
Компресия gzip -9 (без FLUSH)
zlib с Z_PARTIAL_FLUSH
zlib с Z_SYNC_FLUSH
Обем, Кб
1692
40
352
604
На пръв поглед цената, която въвежда FLUSH, изглежда прекалено висока, но всъщност имаме ограничен избор - или да не компресираме изобщо, или да компресираме (и доста ефективно) с FLUSH. Не бива да забравяме, че имаме 70 хиляди записа, излишността, въведена от Z_PARTIAL_FLUSH, е само 4-5 байта на запис. А коефициентът на компресия се оказа почти 5:1, което е повече от отличен резултат.
Може да изглежда изненадващо, но всъщност Z_SYNC_FLUSH е по-ефективният начин за извършване на FLUSH
В случай на използване на Z_SYNC_FLUSH, 4-те последни байта на всеки запис винаги ще бъдат 0x00, 0x00, 0xff, 0xff. А ако те ни са известни - можем да не ги съхраняваме, и така крайният размер се оказва само 324Кб.
В статията, на която се позовавам, има обяснение:
A new type 0 block with empty contents is appended.
A type 0 block with empty contents consists of:
- the three-bit block header;
- 0 to 7 bits equal to zero, to achieve byte alignment;
- the four-byte sequence 00 00 FF FF.
Както не е трудно да се забележи, в последния блок преди тези 4 байта има от 3 до 10 нулеви бита. Обаче практиката показа, че нулевите битове всъщност са минимум 10.
Оказва се, че такива къси блокове данни обикновено (винаги?) се кодира с блок от тип 1 (fixed block), който задължително завършва с 7 нулеви бита, така че общо получаваме 10-17 гарантирано нулеви бита (а останалите ще бъдат нулеви с вероятност около 50%).
И така, на тестовите данни в 100% от случаите пред 0x00, 0x00, 0xff, 0xff има един нулев байт, а в повече от една трета от случаите - два нулеви байта (възможно е причината да е, че използвам бинарен CBOR, а при използването на текстов JSON най-често биха се срещали блокове тип 2 - dynamic block, съответно биха се срещали блокове без допълнителни нулеви байтове преди 0x00, 0x00, 0xff, 0xff).
В крайна сметка на наличните тестови данни може да се побере в по-малко от 250Кб компресирани данни.
Можете да спестите още малко, занимавайки се с жонглиране на битове: в момента игнорираме наличието на няколко нулеви бита в края на блока, няколко бита в началото на блока също не се променят…
Но тук взех решението да спра, иначе с тези темпове бих могъл да стигна до разработването на свой архиватор.
В крайна сметка, от моите тестови данни получих 3-4 байта на запис, коефициентът на компресия се оказа над 6:1. Искрено казвам: не очаквах такъв резултат, според мен всичко, което е над 2:1 — вече е резултат, оправдаващ използването на компресия.
Всичко е отлично, но zlib (deflate) — все пак е архаичен, заслужен и малко старомоден алгоритъм за компресия. Самото това, че като речник се използват последните 32Кб от потока с несжатирани данни, днес изглежда странно (т.е. ако някой блок данни е много подобен на това, което е било в входния поток преди 40Кб, той ще започне да се архивира наново, а не ще се позовава на предходното вхождане). В модерните архиватори размерът на речника по-често се измерва в мегабайти, отколкото в килобайти.
Така че продължаваме нашето мини-изследване на архиваторите.
Следващият, който беше тестван, беше bzip2 (напомням, без FLUSH той показа фантастичен коефициент на компресия, почти 100:1). За съжаление, с FLUSH той показа себе си много зле, размерът на компресираните данни се оказа по-голям, отколкото несжатираният.
Моите предположения за причините за провала
Libbz2 предлага само един вариант за flush, който, изглежда, изчиства речника (аналог на Z_FULL_FLUSH в zlib), не може да се говори за каквато и да е ефективна компресия след това.
И последният, който беше тестван, беше zstd. В зависимост от параметрите, той компресира или на ниво gzip, но много по-бързо, или по-добре от gzip.
За съжаление, с FLUSH и той показа себе си "не много": размерът на компресираните данни достигна около 700Кб.
Аз на страницата на проекта в github, получих отговор, че трябва да се очаква до 10 байта служебни данни на всеки блок с компресирани данни, което е близо до получените резултати, не можем да настигнем deflate.
На това реших да спра експериментите с архиваторите (напомням, xz, lzip, lzo, lz4 не показаха себе си на етапа на тестване без FLUSH, а не реших да разглеждам по-екзотични алгоритми за компресия).
Връщаме се към проблемите с архивирането.
Втората (както се казва, по реда, а не по значението) проблема — компресираните данни представляват един поток, в който постоянно се правят препратки към предишните участъци. Така че, при повреждане на определен участък от компресираните данни, губим не само свързания с него блок некомпресирани данни, но и всички последващи.
Има подходи за решаване на този проблем:
- Да предупреждаваме за появата на проблема — да добавяме в компресираните данни излишък, който ще позволи определяне и коригиране на грешките; за това ще говорим по-късно;
- Да минимизираме последствията в случай на възникване на проблема.
Вече споменахме, че можем да компресираме всеки блок данни независимо, при което проблемът ще изчезне сам по себе си (повреждането на данните в един блок ще доведе до загуба на данни само в този блок). Обаче, това е крайният случай, при който компресията на данни ще бъде неефективна. Обратната крайност: да използваме всичките 4Мб от нашия чип като един архив, което ще ни даде отлично компресиране, но катастрофални последствия в случай на повреждане на данни.
Да, нуждаем се от компромис от гледна точка на надеждността. Но трябва да помним, че разработваме формат на съхранение на данни за енергийно независима памет с изключително нисък BER и деклариран срок на съхранение на данни от 20 години.
В процеса на експерименти открих, че по-изразителни загуби на нивото на компресия започват на блокове компресирани данни с размер под 10Кб.
По-рано беше споменато, че използваната памет има странична организация, не виждам причини, поради които не трябва да се използва съвпадение "една страница — един блок компресирани данни".
Тоест минималният разумен размер на страницата е 16Кб (с резерва за служебна информация). Въпреки това, толкова малкият размер на страницата налага съществени ограничения на максималния размер на записа.
Макар че в момента не предвиждам записи, по-големи от един килобайт в компресирано състояние, реших да използвам страници с размер 32Кб (в крайна сметка получаваме 128 страници на чипа).
Резюме:
- Данните съхраняваме компресирани с помощта на zlib (deflate);
- За всяка записваме Z_SYNC_FLUSH;
- На всеки компресиран запис отрязваме крайни байтове (например, 0x00, 0x00, 0xff, 0xff); в заглавието посочваме колко байта сме отрязали;
- Данните се съхраняват на страници по 32Кб; вътре в страницата текат единен поток от компресирани данни; компресията на всяка страница започва отначало.
И преди да завършим със компресията, бих искал да подчертая, че получаваме само няколко байта на запис с компресирани данни, затова е изключително важно да не увеличаваме служебната информация, всеки байт е важен тук.
Съхраняване на заглавията на данните
Тъй като имаме записи с променлива дължина, трябва по някакъв начин да определим местоположението/границите на записите.
Знам три подхода:
- Всички записи се съхраняват в непрекъснат поток, първо идва заглавието на записа, което съдържа дължината, а след това самият запис.
В този вариант както заглавията, така и данните могат да имат променлива дължина.
По същество получаваме едносвързан списък, който се използва широко; - Заглавията и самите записи се съхраняват в отделни потоци.
Използвайки заглавия с постоянна дължина, постигаме това, че повреждането на едно заглавие не влияе на останалите.
Такъв подход се използва, например, в много файлови системи; - Записите се съхраняват в непрекъснат поток, границата на записа се определя по някакъв маркер (символ/последователност от символи, които са забранени в блоковете с данни). Ако в записа се среща маркер, ние го заменяме с някаква последователност (екранираме го).
Такъв подход се използва, например, в протокола PPP.
Ще илюстрирам.
Вариант 1:
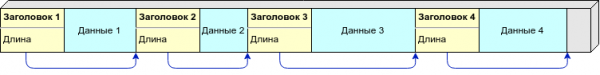
Тук всичко е много просто: знаейки дължината на записа, можем да изчислим адреса на следващото заглавие. Така преминаваме през заглавията, докато не срещнем област, запълнена с 0xff (свободна област) или края на страницата.
Вариант 2:
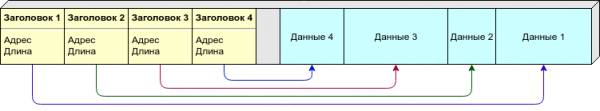
Поради променливата дължина на записа не можем предварително да кажем колко много записи (а следователно и заглавия) ще ни трябват на страницата. Можем да разпределим заглавията и самите данни на различни страници, но предпочитам друг подход: както заглавията, така и данните да са на една и съща страница, но заглавията (с постоянен размер) да са в началото на страницата, а данните (с променлива дължина) да са в края. Веднага щом се „срещнат“ (свободното място не е достатъчно за нов запис) — считаме, че тази страница е запълнена.
Опция 3:

Тук няма нужда да съхраняваме в заглавието дължината или друга информация за разположението на данните, достатъчни са маркери, означаващи границите на записите. Обаче данните трябва да се обработват при запис и четене.
Като маркер бих използвал 0xff (с който е запълнена страницата след изтриване), така че свободната област определено няма да се трактува като данни.
Сравнителна таблица:
Вариант 1
Вариант 2
Вариант 3
Устойчивост на грешки
—
+
+
Компактност
+
—
+
Сложност на реализиране
*
**
**
Вариант 1 има фатален недостатък: при повреждане на някой от заглавията, цялата последваща верига се разрушава. Останалите варианти позволяват възстановяване на част от данните дори при масови повреждания.
Но тук е уместно да припомним, че решихме да съхраняваме данните в компресиран вид, така че все пак губим всички данни на страницата след „непоправим“ запис, така че макар в таблицата да стои минус, ние не го вземаме предвид.
Компактност:
- в първия вариант трябва да съхраняваме в заглавието само дължината; ако използваме цели переменни дължини, в повечето случаи можем да се съберем с един байт;
- във втория вариант трябва да съхраняваме началния адрес и дължината; записът трябва да бъде постоянен размер, оценявам го на 4 байта на запис (две байта за отместване и два байта за дължина);
- на третия вариант му е достатъчен само един символ за обозначаване на началото на записа, плюс самият запис поради екраниране ще нарасне с 1-2%. В общата си стойност има приблизителен паритет с първия вариант.
Първоначално разглеждах втория вариант като основен (и дори написах реализация). Отказах се от него само когато окончателно реших да използвам компресия.
Възможно е някой ден все пак да използвам подобен вариант. Например, ако ми се наложи да се занимавам със съхраняване на данни за кораб, курсирующ между Земята и Марс — съвсем различни изисквания за надеждност, космическо излъчване …
А що се отнася до третия вариант: поставих му две звезди за сложността на реализиране просто защото не обичам да се занимавам с екраниране, промяна на дължината в процеса и т.н. Да, възможно е да съм предвзет, но кодът се пише от мен — защо да се натоварвам с нещо, което не ми харесва.
Резюме: избираме вариант на съхранение под формата на вериги „заглавие с дължина — данни с променлива дължина“ заради ефективността и простотата на реализиране.
Използването на битови полета за контрол на успешността на записите
Вече не помня откъде черпих идеята, но всичко изглежда горе-долу така:
За всеки запис отделяме няколко бита за съхранение на флагове.
Както споменахме по-рано, след erase всички битове са запълнени с 1, и можем да променяме 1 на 0, но не и обратното. Така че за „флаг не е зададен“ използваме 1, а за „флаг е зададен“ — 0.
Ето как може да изглежда записът на променлива дължина във flash:
- Задаваме флага “записването на дължината започна”;
- Записваме дължината;
- Задаваме флага “записването на данните започна”;
- Записваме данните;
- Задаваме флага “записването приключи”.
Освен това, ще имаме флаг “възникна грешка”, общо 4 битови флага.
В този случай имаме две стабилни състояния “1111” — записването не е започнало и “1000” — записването е преминало успешно; при неочаквано прекъсване на процеса на запис ще получим междинни състояния, които после можем да открием и обработим.
Подходът е интересен, но той защитава само от внезапно спиране на захранването и подобни проблеми, което, разбира се, е важно, но това не е единствената (и дори не основна) причина за възможни сривове.
Резюме: Продължаваме напред в търсене на добро решение.
Контролни суми
Контролни сумите също дават възможност да се уверим (с достатъчна вероятност), че четем точно това, което е трябвало да бъде записано. И, за разлика от разгледаните по-горе битови полета, те работят постоянно.
Ако разгледаме списъка с потенциални източници на проблеми, за които говорихме по-горе, то контролна сума е способна да разпознае грешка независимо от нейния произход. (с изключение на злонамерени извънземни — те могат да фалшифицират и контролна сума).
Така че, ако нашата цел е да проверим, че данните са цели, контролните суми са отлична идея.
Изборът на алгоритъм за изчисляване на контролна сума не предизвика въпроси — CRC. От една страна, математическите свойства позволяват да се хващат 100% от определени типове грешки, от друга страна — при случайни данни като цяло този алгоритъм показва вероятността за колизии незначително по-голяма от теоретичния предел.  . Нека това не е най-бързият алгоритъм, не винаги с минимален брой колизии, но той има едно много важно качество: в срещнатите от мен тестове не попаднах на модели, на които да се провали явно. Стабилността е основното качество в този случай.
Пример за обширно изследване: , (линкове към narod.ru, извинете).
Въпреки това, задачата с избора на контролна сума не е завършена, CRC е цяло семейство контролни суми. Трябва да се определи дължината и след това да се избере полином.
Изборът на дължината на контролната сума не е толкова прост въпрос, колкото изглежда на пръв поглед.
Нека илюстрирам:
Нека имаме вероятност за грешка във всеки байт  и идеалната контролна сума, да изчислим средния брой грешки на един милион записи:
Данни, байт
Контролна сума, байт
Недоставени грешки
Лъжливи открития на грешки
Общо неправилни срабатывания
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Изглежда, че всичко е просто — избери дължината на контролната сума в зависимост от дължината на защитените данни, с минимум неправилни срабатывания — и работата е свършена.
Обаче, с кратки контролни суми възниква проблем: те, макар и добре да откриват единични битови грешки, могат с доста голяма вероятност да приемат за верни напълно случайни данни. В Хабре вече имаше статия, описваща .
Затова, за да направим случайното съвпадение на контролни суми практически невъзможно, трябва да използваме контролни суми с дължина 32 бита и повече (за дължини над 64 бита обикновено се използват криптографски хеш-функции).
Въпреки че по-рано писах, че трябва да спестяваме пространство с всички сили, все пак ще използваме 32-битова контролна сума (16 бита е малко, вероятността за колизия е над 0.01%; а 24 бита, както се казва, не са нито тук, нито там).
Тук може да възникне възражение: заради това ли спестявахме всеки байт при избора на компресия, за да сега отдаваме веднага 4 байта? Не е ли по-добре да не компресираме и да не добавяме контролна сума? Разбира се, че не, отсъствието на компресия не означава, че проверката на целостта не е необходима.
По избор на полином няма да изобретяваме велосипеда, а ще вземем популярния сега CRC-32C.
Този код открива 6 битови грешки в пакети до 22 байта (вероятно, най-честият случай за нас), 4 битови грешки в пакети до 655 байта (също често срещан случай за нас), 2 или всяко нечетно число битови грешки в пакети с всякаква разумна дължина.
Ако някой се интересува от детайли
за CRC.
на — вероятно, главният специалист по CRC в света.
В има , предлагащ малко по-добри параметри за актуалните за нас дължини на пакети, но не смятам разликата за съществена и се чувствам достатъчно компетентен, за да избера персонализиран код вместо стандартния и добре проучен.
Освен това, тъй като данните ни са компресирани, възниква въпросът: да се изчисли контролна сума на компресираните или некопресираните данни?
Аргументи "за" изчисляването на контролна сума на некопресираните данни:
- в крайна сметка трябва да проверим целостта на съхранението на данните — така проверяваме директно (при което ще се проверят и възможни грешки в реализацията на компресията/декомпресията, повреждания, причинени от повредена памет и т.н.);
- алгоритъмът deflate в zlib има достатъчно зряла реализация и не трябва да се проваля при "погрешни" входни данни. Освен това, той често е в състояние сам да открива грешки в входния поток, намалявайки общата вероятност за незабелязване на грешка (извърших тест с инвертиране на единичен бит в кратко записа, zlib откри грешката в около една трета от случаите).
Аргументи "против" изчисляването на контролна сума на некопресираните данни:
- CRC е "направен" именно за малкото битови грешки, характерни за флеш паметта (битова грешка в компресирания поток може да доведе до масово изменение на изходния поток, в който, чисто теоретично, можем да "уловим" колизия);
- не ми харесва особено идеята да предавам на декомпресора потенциално повредени данни, , как ще реагира.
В този проект реших да се отклоня от общоприетата практика за съхраняване на контролна сума на некопресираните данни.
Резюме: използваме CRC-32C, контролната сума се изчислява от данните в формата, в която те се записват във флеш (след компресия).
Излишък
Използването на излишно кодиране, разбира се, не позволява да се изключи загубата на данни, но може значително (често в много порядки) да намали вероятността от необратима загуба на данни.
Можем да използваме различни видове излишности, за да коригираме грешки.
Кодовете на Хamming могат да коригират единични битови грешки, кодовете на Reed-Solomon символни, няколко копия на данни в комбинация с контролните суми или кодиране като RAID-6 могат да помогнат за възстановяване на данни дори при масови повреди.
В началото бях настроен за широко използване на устойчиво на смущения кодиране, но после разбрах, че първо трябва да имаме представа от какви грешки искаме да се защитим, а след това да изберем кодиране.
По-рано говорихме, че грешките трябва да бъдат откривани възможно най-рано. В кои моменти можем да се сблъскаме с грешки?
- Недовършена запис (поради някаква причина, захранването е спряло по време на записа, Raspberry е замръзнал, …)
За съжаление, в случай на подобна грешка остава само да игнорираме невалидните записи и да считаме данните за загубени; - Грешки при запис (поради някаква причина в флаш паметта е записано нещо различно от това, което е било записвано)
Тези грешки можем да открием веднага, ако направим контролно четене веднага след запис; - Изкривяване на данни в паметта по време на съхранение;
- Грешки при четене
За поправка е достатъчно, в случай на несъответствие на контролната сума, да повторим четенето няколко пъти.
Тоест само грешки от трети тип (спонтанна повреда на данни при съхранение) не могат да бъдат поправени без устойчиво на смущения кодиране. Смятам, че подобни грешки все пак са крайно маловероятни.
Резюме: Решено е да се откаже от излишното кодиране, но, ако експлоатацията покаже неправилността на това решение, ще се върнем към разглеждане на въпроса (с вече натрупана статистика за сбои, която ще позволи да изберем оптималния вид кодиране).
Други
Разбира се, форматът на статията не позволява да обоснова всеки бит във формата (и вече ми свършиха силите), затова накратко ще пробяга през някои моменти, които не са били разгледани преди.
- Решено е да се правят всички страници "равноправни"
Тоест няма да има специални страници с метаданни, отделни потоци и т.н., вместо това единен поток, който презаписва всички страници последователно.
Това осигурява равномерно износване на страниците, липса на единна точка на отказ и просто е приятно; - Задължително е да се предвиди версия на формата.
Формат без номер на версия в заглавието е зло!
Достатъчно е да добавите в заглавието на страницата поле с някакъв Magic Number (сигнатура), което ще указва използваната версия на формата (не мисля, че в практиката ще има дори десет).; - Да се използва за записи (които са много) заглавие с променлива дължина, опитвайки се за повечето случаи да направите дължината 1 байт;
- За кодиране на дължината на заглавието и дължината на отрязаната част от стиснатия запис да се използват двоични кодове с променлива дължина.
Много помогна на Хаффман кодове. Буквално за няколко минути успяхме да подберем нужните кодове с променлива дължина.
Описание на формата за съхранение на данни
Ред на байтовете
Поли, размерът на които надвишава един байт, се съхраняват в big-endian формат (network byte order), тоест 0x1234 се записва като 0x12, 0x34.
Разделяне на страници
Цялата флаш памет е разделена на страници с равен размер.
Размерът на страницата по подразбиране е 32Кб, но не повече от 1/4 от общия размер на микросхемата памет (за микросхема с 4Мб излиза 128 страници).
Всяка страница съхранява данни независимо от другите (тоест данните на една страница не сочат към данните на друга страница).
Всички страници са номерирани в естествен порядък (в ред на нарастващи адреси), започвайки с номер 0 (нулевата страница започва с адрес 0, първата — с 32Кб, втората — с 64Кб и т.н.)
Микросхемата памет се използва като цикличен буфер (ring buffer), тоест първо записа отива в страницата с номер 0, после с номер 1, …, когато запълним последната страница, започва нов цикъл и записът продължава от нулевата страница.
Вътре в страницата
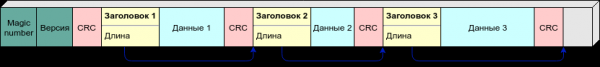
В началото на страницата се съхранява 4-байтов заглавен запис на страницата, след това контрольна сума на заглавието (CRC-32C), след което се съхраняват записи във формата 'заглавие, данни, контрольна сума'.
Заглавието на страницата (на схемата е мръсно-зелено) се състои от:
- дву байтово поле Magic Number (тоест — признак на версията на формата)
за текущата версия на формата той се счита за0xed00 ⊕ номер на страница; - двухбайтния брояч "Версия на страницата" (номер на цикъл на презапис на паметта).
Записите на страницата се съхраняват в компресирана форма (използва се алгоритъмът deflate). Всички записи на една страница се компресират в един поток (използва се общ речник), за всяка нова страница компресирането започва отначало. Тоест за декомпресиране на всякакъв запис са нужни всички предишни записи от тази страница (и само от нея).
Всеки запис ще бъде компресиран с флага Z_SYNC_FLUSH, като в края на компресирания поток остават 4 байта 0x00, 0x00, 0xff, 0xff, предшествани, възможно, от още един или два нулеви байта.
Тази последователност (дължина 4, 5 или 6 байта) я отхвърляме при записването във флаш памет.
Заглавието на записа представлява 1, 2 или 3 байта, които съхраняват:
- един бит (T), означаващ тип на записа: 0 — контекст, 1 — журнал;
- полето с променлива дължина (S) от 1 до 7 бита, определящо дължината на заглавката и "опашката", която трябва да бъде добавена към записа за разархивиране;
- дължината на записа (L).
Таблица на стойностите на S:
S
Дължина на заглавката, байт
Отхвърля се при запис, байт
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Опитах се да илюстрирам, не знам колко наглядно се получи:
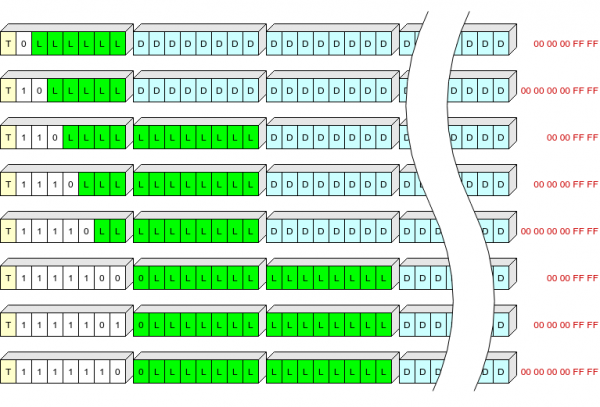
Жълтото тук обозначава полето T, бялото — полето S, зеленото L (дължина на компресираните данни в байтове), синьото — компресираните данни, червеното — крайни байтове на компресираните данни, които не се записват във флаш памет.
Така че заглавията на записите с най-разпространена дължина (до 63+5 байта в компресиран вид) можем да запишем с един байт.
След всеки запис се съхранява контролна сума CRC-32C, за която като начална стойност (init) се използва инвертираното значение на предишната контролна сума.
CRC притежава свойството "продължителност", действа (плюс-минус инвертиране на битове в процеса) следната формула:  .
Тоест фактически изчисляваме CRC на всички предишни байтове на заглавията и данните на тази страница.
Непосредствено след контролната сума следва заглавието на следващия запис.
Заглавието е конструктирано така, че първият му байт да е винаги различен от 0x00 и 0xff (ако вместо първия байт на заглавието срещнем 0xff, то значи това е незадействана област; 0x00 сигнализира за грешка).
Примерни алгоритми
Четене от флаш памет
Всяко четене става с проверка на контролната сума.
Ако контрольната сума не съвпада, четенето се повтаря няколко пъти в надежда да се прочетат верните данни.
(това има смисъл, Linux не кешира четенето от NOR Flash, проверено)
Запис в флаш памет
Записваме данни.
Четем ги.
Ако прочетените данни не съвпадат със записаните, запълваме областта с нули и сигнализираме за грешка.
Подготовка на новия чип за работа
За инициализация в първата (точно нулевата) страницa се записва заглавие с версия 1.
След това в тази страница се запазва началния контекст (съдържа UUID на устройството и дефолтни настройки).
Всичко, флаш паметта готова за работа.
Зареждане на устройството
При зареждане се четат първите 8 байта от всяка страница (заглавие + CRC), страниците с неизвестен Magic Number или неверен CRC се игнорират.
От „правилните“ страници се избират страниците с максимална версия, от тях се взима страницата, която има най-висок номер.
Чете се първата запис, проверява се коректността на CRC, наличието на флага „контекст“. Ако всичко е наред, тази страница се счита за текуща. Ако не е, връщаме се на предишната, докато не намерим „жива“ страница.
На намерената страница четем всички записи, тези с флага „контекст“ прилагаме.
Запазваме речника zlib (ще е нужен за дописване в тази страница).
Всичко, зареждането приключи, контекстът е възстановен, можем да работим.
Добавяне на запис в журнала
Сжатамe записа с правилния речник, посочвайки Z_SYNC_FLUSH. Виждаме, дали компресираният запис се побира в текущата страница.
Ако не се побира (или на страницата е имало грешки CRC) — започваме нова страница (виж по-долу).
Записваме записа и CRC. Ако е настъпила грешка — започваме нова страница.
Нова страница
Избираме свободна страница с минимален номер (свободна считаме страницата с неправилна контролна сума в заглавието или с версия под текущата). Ако такива страници няма, избираме страницата с минимален номер от тези, които имат версия равна на текущата.
Правим избраната страница erase. Сверяваме съдържанието с 0xff. Ако нещо не е наред, вземаме следващата свободна страница и т.н.
На изтритата страница записваме заглавие, с първия запис текущото състояние на контекста, следващата — незаписан запис от журнала (ако има такъв).
Приложимост на формата
Според мен, това е приличен формат за съхранение на всякакви по-сносими сжимаеми потоци информация (прост текст, JSON, MessagePack, CBOR, възможно и protobuf) в NOR Flash.
Разбира се, форматът е „настроен“ за SLC NOR Flash.
Не трябва да се използва с носители с висок BER, например NAND или MLC NOR. (има ли изобщо такава памет в продажба? Случвало ми се е да срещам споменавания само в работи по кодовете за корекция).
Още повече, не трябва да се използва с устройства, които имат свой FTL: USB флаш, SD, MicroSD и др. (за такава памет направих формат с размер на страница 512 байта, подпис на началото на всяка страница и уникални номера на записи — понякога от „глюкнала“ флашка успявах с последователно четене да възстановя всички данни).
В зависимост от задачите форматът може да се използва без промени на флашки от 128Кбит (16Кб) до 1Гбит (128Мб). При желание може да се използва и на чипове с по-голям обем, само, вероятно, трябва да се коригира размерът на страницата. (Но тук вече застава въпросът за икономическата целесъобразност, цената на NOR Flash с голям обем не радва.).
Ако форматът е изглеждал интересен на някого и той желае да го използва в открит проект — пишете, ще се опитам да намеря време, да прегледам кода и да го публикувам на github.
Заключение
Както виждаме, в крайна сметка форматът се оказа прост и дори скучен..
В статията е трудно да се отрази еволюцията на гледната ми точка, но повярвайте: първоначално исках да създам нещо сложно, неубиваемо, способно да оцелее дори след ядрена експлозия в непосредствена близост. Въпреки това, разумът (надявам се) все пак победи и постепенно приоритетите се преместиха към простота и компактност.
Може ли да се получи така, че да съм сбъркал? Да, разбира се. Напълно е възможно да се окаже, например, че сме закупили партида некачествени чипове. Или по друга причина оборудването да не оправдае очакванията за надеждност.
Има ли план за този случай? Мисля, че след прочитането на статията не се съмнявате, че планът е налице. И дори не един.
Ако погледнем малко по-сериозно, форматът е разработен едновременно и като работен вариант, и като „пробен балон“.
В момента всичко на масата работи нормално, буквално на няколко дни ще бъде разположено решението. (приблизително) на стотици устройства, ще видим какво ще стане в «бойни» условия (също така се надявам, че форматът позволява да се откриват надеждно грешки; така ще можем да съберем пълна статистика). След няколко месеца ще могат да се направят изводи (и ако не сме късметлии — и по-рано).
Ако след използването се открият сериозни проблеми и са необходими подобрения, ще пиша за това.
Литература
Не исках да съставям дълъг списък с използвани работи, накрая Google е на разположение на всеки.
Тук реших да оставя списък с находки, които ми се сториха особено интересни, обаче постепенно те преминаха в текста на статията, и в списъка остана само една точка:
- Утилита от автора zlib. Умее да показва съдържанието на архиви deflate/zlib/gzip в разбираем вид. Ако трябва да се запознаете с вътрешната структура на формата deflate (или gzip) — настоятелно препоръчвам.
Източник: habr.com
