

Прим. прев.: Адаптация на Kubernetes в GitLab се смята за един от двата основни фактора, които допринасят за растежа на компанията. Въпреки това, до неотдавна инфраструктурата на онлайн услугата GitLab.com беше изградена на виртуални машини, а миграцията ѝ към K8s започна преди около година и все още не е завършена. С радост представяме превод на неотдавнашна статия на SRE инженера на GitLab относно това как се осъществява и какви изводи правят инженерите, участващи в проекта.
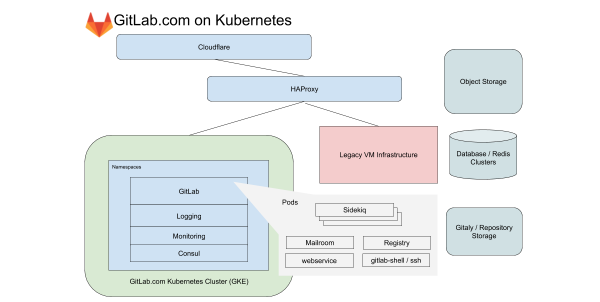
От около година нашето инфраструктурно подразделение се занимава с миграция на всичките услуги, работещи на GitLab.com, в Kubernetes. През това време се сблъскахме с проблеми, свързани не само с преместването на услугите в Kubernetes, но и с управлението на хибриден deployment по време на прехода. За ценните уроци, които получихме, ще се говори в тази статия.
От самото начало GitLab.com неговите сървъри работеха в облака на виртуални машини. Тези виртуални машини се управляват от Chef, а тяхното инсталиране става чрез нашия . в случай, че е необходимо обновление на приложението, се състои в простото обновление на парка сървъри по координиран последователен начин чрез CI pipeline. Този метод – макар и бавен и малко – гарантира, че GitLab.com прилага същите методи за инсталиране и конфигуриране, които използват потребителите на автономните (self-managed) инсталации на GitLab, които използват нашите Linux пакети.
Използваме този метод, тъй като е изключително важно да усетим всички печали и радости, с които се сблъскват обикновените членове на общността, когато инсталират и конфигурират своите копия на GitLab. Този подход работи добре в течение на известно време, но когато броят на проектите в GitLab надхвърли 10 милиона, осъзнахме, че той вече не отговаря на нашите нужди за мащабиране и разполагане.
Първи стъпки към Kubernetes и облачно-нативен GitLab
През 2017 г. беше създаден проект за подготовката на GitLab за внедряване в облака, както и за да предоставим на потребителите възможността да инсталират GitLab в Kubernetes клъстери. Тогава знаехме, че преминаването на GitLab в Kubernetes ще увеличи възможностите за мащабиране на SaaS платформата, ще опрости внедряванията и ще подобри ефективността на използването на компютърните ресурси. В същото време много от функциите на нашето приложение зависяха от монтирани NFS дялове, което забавяше прехода от виртуални машини.
Стремежът към облачно родни и Kubernetes позволи на нашите инженери да планират прехода, в хода на който се отказахме от някои зависимости на приложението от мрежови хранилища, продължавайки да разработваме нови функции. Откакто започнахме да планираме миграцията през лятото на 2019 г., много от тези ограничения бяха преодолени, а процесът на прехвърляне на GitLab.com на Kubernetes вече върви с пълна сила!
Особеностите на работата на GitLab.com в Kubernetes
За GitLab.com използваме единен регионален GKE клъстер, който обработва целия трафик на приложението. За да минимизираме сложността (вече мудрена) на миграцията, се фокусираме върху услуги, които не зависят от локални хранилища или NFS. GitLab.com предимно използва монолитна кодова база на Rails и насочваме трафика в зависимост от характеристиките на работната натовареност към различни крайни точки, изолирани в собствените си пулове от възли.
В случай на фронтенда тези типове се делят на заявки към web, API, Git SSH/HTTPS и Registry. В случай на бекенда разделяме job-овете в опашките по различни характеристики в зависимост от , които ни позволяват да установим целеви показатели за нивото на обслужване (Service-Level Objectives, SLOs) за различни натоварвания.
Всички тези услуги на GitLab.com са настроени с помощта на немодифициран Helm граф на GitLab. Конфигурацията се извършва в субграфи, които могат да бъдат по избор включени, докато постепенно прехвърляме услугите в клъстера. Дори с решението да не включваме в миграцията някои от нашите stateful услуги, като Redis, Postgres, GitLab Pages и Gitaly, използването на Kubernetes позволява радикално да се намали броят на VM, управлявани от Chef в момента.
Прозрачност и управление на конфигурацията в Kubernetes
Всички настройки се управляват от самия GitLab. За целта се използват три конфигурационни проекта на база Terraform и Helm. Стремим се навсякъде, където е възможно, да използваме самия GitLab за стартиране на GitLab, но за експлоатационни задачи имаме функционираща отделна инсталация на GitLab. Тя е необходима, за да не зависим от наличността на GitLab.com при извършване на разгръщания и актуализации на GitLab.com.
Въпреки че нашите пайплайни за кластера Kubernetes работят на отделна инсталация на GitLab, репозиториевете на кода имат огледала, публично достъпни на следните адреси:
- — конфигурационна обвивка на GitLab.com за Helm-чарта на GitLab;
- — съдържа конфигурации за услуги, които не са свързани директно с приложението на GitLab. В тях влизат конфигурации за водене на логове и мониторинг на кластерите, а също и за интегрирани инструменти като PlantUML;
- — конфигурация на Terraform за Kubernetes и стара (legacy) VM-инфраструктура. Тук се настройват всички ресурси, необходими за стартиране на кластер, включително самия кластер, пулове на възли, служебни акаунти, резервации на IP адреси.

Когато се извършват промени, се показва публично с линк към подробен diff, който SRE анализира преди въвеждането на промените в клъстера.
За SRE линкът води към подробен diff в инсталацията на GitLab, която се използва за експлоатация и достъпът до която е ограничен. Това позволява на служителите и общността без достъп до експлоатационния проект (който е отворен само за SRE) да преглеждат предложените промени в конфигурацията. Комбинирайки публичен екземпляр на GitLab за код с затворен екземпляр за CI пайплайни, запазваме единен работен процес, докато в същото време гарантираме независимост от GitLab.com при актуализациите на конфигурацията.
Какво установихме по време на миграцията
В процеса на преместването бе натрупан опит, който прилагаме в нови миграции и разгръщания в Kubernetes.
1. Ръст на разходите заради трафика между зоните на достъпност
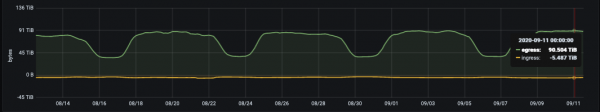
Ежедневна egress статистика (байтове на ден) за парка на Git хранилищата на GitLab.com
Google разделяе своята мрежа на региони. Те от своя страна се делят на зони на достъп (AZ). Git хостингът е свързан с големи обеми данни, затова е важно да контролираме мрежовия egress. В случай на вътрешен трафик, egress е безплатен само ако остава в рамките на една зона на достъп. Към момента на написването на тази статия предоставяме около 100 Тб данни в обикновен работен ден (и това е само за Git репозиторите). Услугите, които в нашата стара топология, основана на VM, бяха на едни и същи виртуални машини, сега работят в различни pod'ове Kubernetes. Това означава, че част от трафика, който преди беше локален за VM, може потенциално да излиза извън зоните на достъп.
Регионалните клъстери GKE позволяват обхващане на няколко зони на достъп за резервиране. Разглеждаме възможността за услуги, които генерират големи обеми трафик. Това ще намали разходите за egress, запазвайки резервирането на ниво клъстер.
2. Ограничения, искания за ресурси и мащабиране
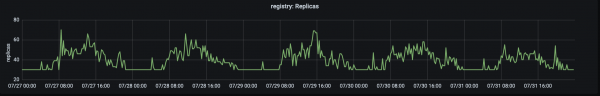
Броят на репликите, обработващи production трафика на registry.gitlab.com. Трафикът достига своя пик около 15:00 UTC.
Нашата история с миграцията започна през август 2019 г., когато преместихме първата услуга - реестър на контейнери GitLab (GitLab Container Registry) - в Kubernetes. Тази критично важна услуга с висок трафик беше идеална за първата миграция, тъй като представлява stateless приложение с малко външни зависимости. Първият проблем, с който се сблъскахме, беше голямото количество изгонени pod'ове поради недостиг на памет на възлите. Заради това ни се наложи да променим исканията и ограниченията.
Беше установено, че в случай на приложение, което използва памет с времето, ниските стойности за исканията (предварително резервиращи памет за всеки pod) в комбинация с "щедър" твърд лимит за използване водят до наситеност (saturation) на възлите и високото ниво на изгонвания. За да се справим с този проблем, беше . Това облекчи натиска върху възлите и осигури жизнен цикъл на подовете, който не оказваше прекалено високо налягане върху възела. Сега започваме миграции с щедри (и почти еднакви) стойности на заявките и лимитите, коригирайки ги при необходимост.
3. Метрики и логове
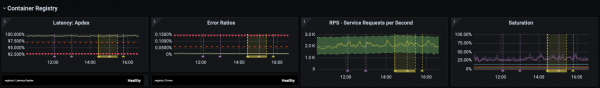
Инфраструктурното подразделение се фокусира върху закъсненията, процента на грешките и насищането с установените (SLO), свързани с .
През изминалата година едно от ключовите събития в инфраструктурното подразделение беше подобрението в мониторинга и работата с SLO. SLO ни позволиха да задаваме цели за отделни услуги, които внимателно наблюдавахме по време на миграцията. Но дори с такова подобрено наблюдение не винаги е възможно веднага да се видят проблемите, използвайки метрики и алерти. Например, когато се фокусираме върху закъсненията и процента на грешките, ние не обхващаме напълно всички сценарии на използване на услугата, която преминава миграция.
Тази проблематика бе открита почти веднага след прехвърлянето на част от работните натоварвания в клъстера. Особено остро тя се прояви, когато трябваше да проверим функции, при които броят на заявките е малък, но за които има много специфични конфигурационни зависимости. Един от ключовите уроци след миграцията беше необходимостта да вземем предвид при мониторинга не само метриките, но и логовете и "дългия опашка" (става въпрос за на графиката — бел. ред.) грешки. Сега за всяка миграция включваме подробен списък на заявките за логовете (log queries) и планираме ясни процедури за откат, които в случай на проблеми могат да се предават от една смяна на друга.
Паралелното обслужване на едни и същи заявки на старата VM инфраструктура и новата, базирана на Kubernetes, представляваше уникално предизвикателство. За разлика от миграцията тип lift-and-shift (бързо прехвърляне на приложения "както са" в новата инфраструктура; повече информация можете да намерите, например, — забележка на преводача), паралелелната работа на „стари“ VM и Kubernetes изисква средствата за мониторинг да бъдат съвместими и да могат да съединяват метрики в един вид. Важно е, че използваме същите табла и запитвания към логовете, за да постигнем последователна наблюдаемост по време на преходния период.
4. Пренасочване на трафика към новия клъстер
За GitLab.com част от сървърите е заделена за . Канареният парк обслужва нашите вътрешни проекти и може също така . Но на първо място той е предназначен да проверява промените, направени в инфраструктурата и приложението. Първият преместен сервиз започна с приемането на ограничен обем вътрешен трафик, и продължаваме да използваме този метод, за да сме сигурни в спазването на SLO преди да насочим целия трафик към клъстера.
В случай на миграция това означава, че първо в Kubernetes се насочват запитванията към вътрешни проекти, а след това постепенно пренасочваме остатъчния трафик към клъстера, променяйки теглото за бекенда чрез HAProxy. В процеса на прехода от VM към Kubernetes стана ясно, че е много изгодно да разполага с лесен начин за пренасочване на трафика между старите и новите инфраструктури и съответно да се държи старата инфраструктура готова за обратно повикване в първите няколко дни след миграцията.
5. Резервни капацитети на pod-овете и тяхното използване
Почти веднага беше установен следният проблем: pod-овете за услугата Registry стартираха бързо, но стартирането на pod-овете за Sidekiq отнемаше до . Продължителното стартиране на pod-овете за Sidekiq стана проблем, когато започнахме миграцията на работните натоварвания на worker-ите в Kubernetes, които трябва да обработват job-ове бързо и да се мащабират бързо.
В този случай урокът беше, че въпреки че Horizontal Pod Autoscaler (HPA) в Kubernetes добре се справя с увеличаването на трафика, е важно да се вземат предвид характеристиките на работните натоварвания и да се заделят резервни капацитети на pod-овете (особено при неравномерно разпределение на търсенето). В нашия случай имаше внезапен ръст на job-ове, което водеше до стремително мащабиране, което доведе до насищане на ресурсите на CPU преди да успеем да мащабираме пулът от узли.
Винаги има изкушение да се изцеди колкото се може повече от клъстера, но ние, след като първоначално се сблъскахме с проблеми с производителността, сега започваме с щедър бюджет за pod и го намаляваме по-късно, внимателно следейки SLO. Стартирането на pod-овете за услугата Sidekiq значително се ускори и сега средно отнема около 40 секунди. печели както GitLab.com, така и нашите потребители на self-managed инсталации, които работят с официалния Helm chart на GitLab.
Заключение
След прехвърлянето на всяка услуга, ние се радвахме на предимствата от използването на Kubernetes в производствена среда: по-бързо и по-сигурно внедряване на приложения, мащабиране и по-ефективно разпределение на ресурсите. А предимствата от миграцията надхвърлят самата услуга GitLab.com. От всяко подобрение на официалния Helm chart печелят и неговите потребители.
Надявам се, че ви хареса историята за нашите приключения с миграцията в Kubernetes. Ние продължаваме да прехвърляме все нови услуги в клъстера. Допълнителна информация можете да намерите в следните публикации:
- «»;
- «»;
- .
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «»;
- «».
Източник: habr.com
