

Известно, че компетентността на CTO се проверява само по време на втория му мандат. Защото е едно да работиш няколко години в компания, да еволюираш с нея и, оставайки в същия културен контекст, постепенно да получаваш повече отговорности. И съвсем друго — да влезеш веднага в позиция на технически директор в компания с множество наследствени проблеми, старателно заметени под килима.
В това отношение опитът на Леон Файер, който той сподели на , не е точно уникален, но умножен по стажа и броя на различните роли, които е успял да изиграе за 20 години, е изключително полезен. Под кат има времева линия на събитията за 90 дни и много истории, над които е приятно да се усмихваш, когато се случват на някой друг, но с които не е толкова забавно да се сблъскваш лично.
Леон разказва много колоритно на руски, така че ако имате 35-40 минути, препоръчвам да гледате видеото. Текстовата версия за спестяване на време е по-долу.
Първата версия на доклада беше добре структурирано описание на работата с хора и процеси, съдържащо полезни препоръки. Но тя не предаваше всички изненади, с които се сблъсквах по пътя. Затова промених формата и изложих проблемите, с които се сблъсках в новата компания, като дух от кутия, и методите за решаването им в хронологичен ред.
Месец преди
Както много добри истории, тази започна с алкохол. Седяхме с познати в бара, и както подобава в средите на айти специалистите, всеки споделяше своите проблеми. Един от тях току-що беше сменила работата си и разказваше за проблемите си с технологии, хора и екипа. Колкото повече слушах, толкова повече разбирах, че той просто трябва да наеме мен, защото точно с такива проблеми се занимавам през последните 15 години. И му казах, и на следващия ден се срещнахме вече в работна обстановка. Компанията се наричаше Teaching Strategies.
Teaching Strategies е лидер на пазара на учебни програми за много ранна възраст — от раждането до три години. Традиционната „на хартия“ компания е на около 40 години, а цифровата SaaS версия на платформата е на 10. Сравнително скоро започна процесът на адаптиране на цифровата технология към стандартите на компанията. „Новата“ версия стартира през 2017 г. и беше почти като старата, но работеше по-зле.
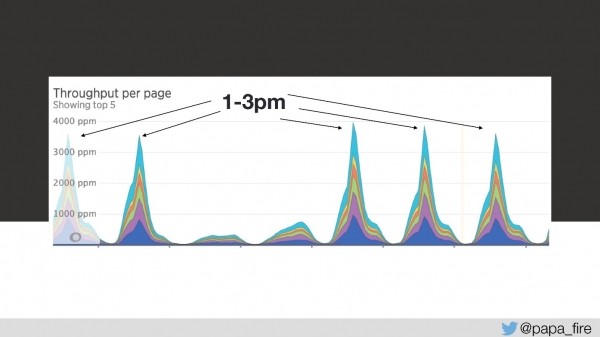
Най-интерсното е, че трафикът на тази компания е много предсказуем — от ден на ден, от година на година може много ясно да се предвиди колко хора ще дойдат и кога. Например, между 13 и 15 часа всички деца в детските градини заспиват, а учителите започват да въвеждат информация. И така се случва всеки ден, освен през уикендите, защото почти никой не работи в почивните дни.
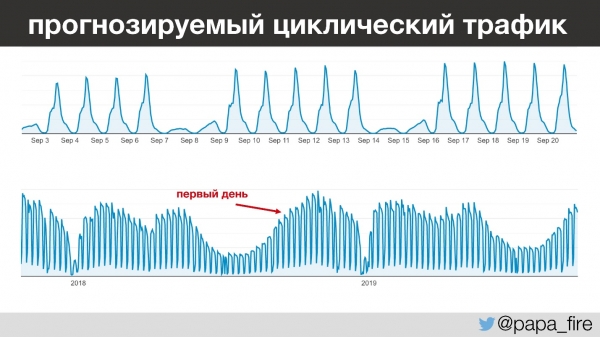
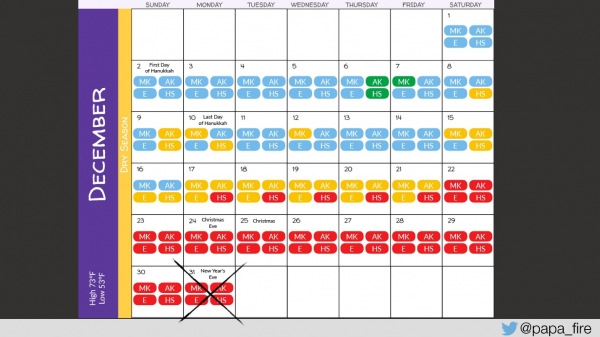
Наблюдавайки малко напред, бих отбелязал, че започнах работата си в период на най-голям годишен трафик, което е интересно по различни причини.
Платформата, която излежда имаше само 2 години, притежаваше своеобразен стек: ColdFusion & SQL Server 2008. ColdFusion, ако не знаете, а вероятно не знаете, — е нещо като enterprise PHP, който излезе в средата на 90-те години, и оттогава не съм чувал за него. В платформата имаше също: Ruby, MySQL, PostgreSQL, Java, Go, Python. Но основният монолит работеше на ColdFusion и SQL Server.
Проблеми
Колкото повече говорих с служителите на компанията за работата и за проблемите, с които се сблъскват, толкова повече разбирах, че проблемите не са само технически по характер. Добре, технологията е стара — и сме работили с неща каквито и да било, но имаше проблеми с екипа и с процесите, и компанията започваше да разбира това.
Традиционно технолозите им сядаха в ъгъла и се занимаваха със своя работа. Но все повече и повече бизнес започваше да минава именно през цифровата версия. Затова в компанията през последната година преди началото на моята работа се появиха нови: съвет на директорите, CTO, CPO и QA директор. Тоест компанията започна да инвестира в технологичната сфера.
Следите от тежкото наследство не бяха само в системите. В компанията имаше legacy процеси, legacy хора, legacy култура. Всичко това трябваше да бъде променено. Помислих си, че определено няма да е скучно и реших да опитам.
Два дни преди
Два дни преди началото на новата работа, пристигнах в офиса, попълних последните документи, запознах се с екипа и открих, че екипът по това време се бори с проблем. Той се заключаваше в това, че средното време за зареждане на страниците беше скочило до 4 секунди, тоест два пъти.
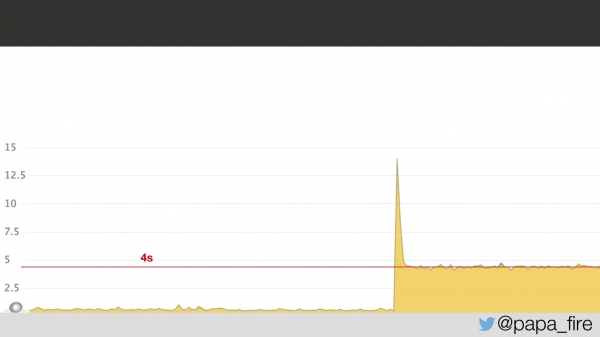
Съдя по графика, явно нещо се е случило, а непонятно какво. Оказа се, че проблемът беше в network latency в дата центъра: 5 ms latency в дата центъра се преобразуваха в 2 секунди за потребителите. Защо така се е случило, не знаех, но във всеки случай стана ясно, че проблемът е в дата центъра.
Ден първи
Изминаха два дни и в първия си работен ден установих, че проблемът не е изчезнал.
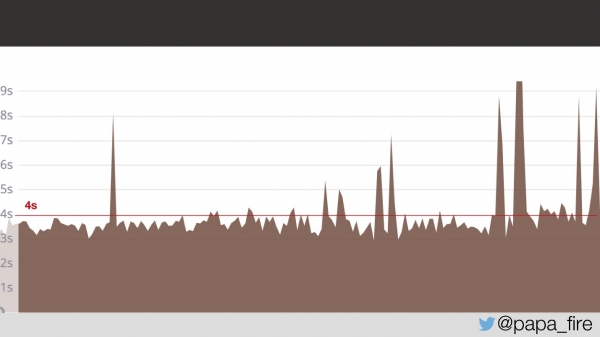
Два дни на потребителите страницата се зареждаше средно за 4 секунди. Питам дали са намерили в какво е проблемът.
— Да, открихме билет.
— И?
— Ами, те все още не ни отговориха.
Тук разбрах, че всичко, което ми бяха казвали до момента, е само малък връх на айсберга, с който трябва да се борим.
Има една добра цитата, която много подхожда за този случай:
«Понякога за да се промени технологията, трябва да се промени организацията».
Но тъй като започнах работа в най-забързаното време на годината, трябваше да разгледам и двата варианта за решаване на проблема: бърз и дългосрочен. И да започна с онова, което е критично в момента.
Трети ден
И така, зареждането трае 4 секунди, а от 13 до 15 са най-големите пикове.
На третия ден в този интервал скоростта на зареждане изглеждаше така:
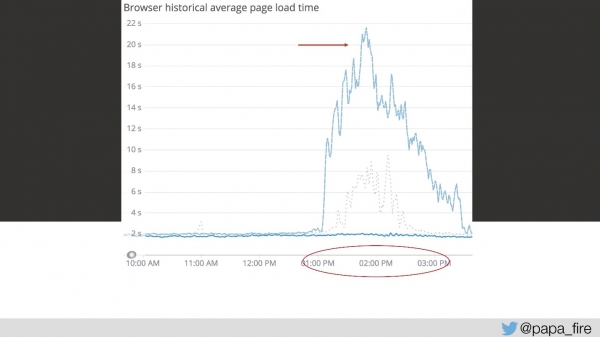
От моя гледна точка всичко изобщо не работеше. От гледна точка на всички останали работеше малко по-бавно от обикновено. Но просто така не става — това е сериозен проблем.
Опитвах се да убедя екипа, на което те ми отговаряха, че просто трябва да имаме повече сървъри. Това, разбира се, е решение на проблема, но далеч не винаги е единственото и най-ефективното. Попитах защо сървърите не са достатъчни, какъв е обемът на трафика. Екстраполирах данните и установих, че имаме около 150 заявки в секунда, което принципно попада в разумните граници.
Но не бива да забравяме, че преди да получим правилния отговор, трябва да зададем правилния въпрос. Следващият ми въпрос беше: колко front-end сървъра имаме. Отговорът ме "малко обърка" — имахме 17 front-end сървъра!
— Боя се да питам, 150 разделено на 17, ще се получи около 8? Искате да кажете, че всеки сървър пропуска по 8 заявки в секунда и ако утре има 160 заявки в секунда, ще ни трябват още 2 сървъра?
Разбира се, не ни трябваха допълнителни сървъри. Решението се намираше в самия код, и то на повърхността:
var currentClass = classes.getCurrentClass();
return currentClass;
Имаше функция getCurrentClass(), защото всичко на сайта работи в контекста на клас — правилно. И на тази функция на всяка страница се получаваха 200+ заявки.
По този начин решението беше много просто, дори не беше нужно да се пренаписва нищо: просто не запитвайте една и съща информация повторно.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Много се зарадвах, защото реших, че на третия ден намерих основния проблем. Каква наивност, това беше само един от многото проблеми.
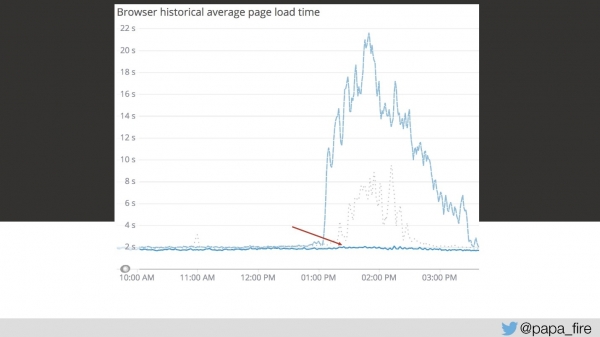
Но решението на този първи проблем свали графика много по-ниско.
В същото време работихме и по други оптимизации. Имаше много неща, които можеха да се поправят. Например, на третия ден открих, че в системата всъщност имаше кеш (първоначално си помислих, че всички заявки идват директно от базата данни). Когато мисля за кеш, си представям стандартни Redis или Memcached. Но само аз така мислех, тъй като в тази система за кеширане се използваха MongoDB и SQL Server — същият от който току-що бяха прочетени данните.
Ден десети
Първата седмица се занимавах с проблеми, които трябваше да се решат веднага. Някъде около втората седмица за първи път дойдох на стендъп, за да се срещна с екипа и да видя какво се случва и как върви целият процес.
Отново се откриха интересни неща. Екипът се състоеше от: 18 разработчици; 8 тестера; 3 мениджъра; 2 архитекта. И всички те участваха в общите ритуали, т.е. повече от 30 човек идваха на стендъп всяка сутрин и разказваха какво са правили. Ясно е, че срещата не отнемаше 5 или 15 минути. Никой никого не слушаше, защото всички работят по различни системи. В такъв вид 2-3 тикета за час на grooming session вече бяха добър резултат.
Първото, което направихме, беше да разделим екипа на няколко по линия на продуктите. За различни секции и системи выделихме отделни екипи, които включваха разработчици, тестери, продакт мениджъри и бизнес анализатори.
В резултат получихме:
- Съкратени стендъпи и срещи.
- Предметни знания за продукта.
- Чувство за собственост. Когато преди хората постоянно се сменяха между системите, те знаеха, че вероятно работата с техните бъгове ще се наложи на някой друг, но не на тях самите.
- Сътрудничество между групите. Може да не се казва, че QA и програмистите преди това не общуваха много, продакт правеше собствените си работи и т.н. Сега те разполагаха с обща точка на отговорност.
Основно се фокусирахме върху ефективността, производителността и качеството — точно тези проблеми се опитвахме да решим чрез трансформацията на екипа.
Ден единадесети
В процеса на промяна на структурата на екипа открих как се изчисляват ИсторияТочки. 1 SP беше равен на един ден, а всяка тикетна заявка съдържаше SP и за разработка, и за QA, т.е. поне 2 SP.
Как го открих?
Намерихме бъг: в един от отчетите, където се въвеждат дата на начало и край на периода, за който е необходим отчет, не се взема предвид последният ден. Тоест някъде в заявката стоеше не <=, а просто <. Казаха ми, че това е три Story Points, т.е. 3 дни.
След това ние:
- Преразгледахме системата за оценка на Story Points. Сега поправянето на малки бъгове, които могат бързо да преминат през системата, достига по-бързо до потребителя.
- Започнахме да обединяваме свързани тикети за разработка и тестване. Преди всеки тикет, всеки бъг беше затворена екосистема, непривързана към нищо друго. Промяната на три бутона на една страница можеше да бъде три различни тикета с три различни QA процеса вместо едно автоматизирано тестване на страницата.
- Започнахме да работим с разработчиците по подхода за оценка на трудозатрат. Три дни за смяна на един бутон — това не е смешно.
Ден двадесети
Към средата на първия месец ситуацията леко се стабилизира, вникнах в основните процеси и вече започнах да гледам напред и да мисля за дългосрочни решения.
Дългосрочни цели:
- Управлявана платформа. Стотици заявки на всяка страница — това не е сериозно.
- Предсказуеми тенденции. Имаше периодични пикове на трафика, които на пръв поглед не съвпадаха с другите метрики — трябваше да разбера защо се случва и да се науча да предсказвам.
- Разширяване на платформата. Бизнесът постоянно расте, идват все повече потребители, трафикът се увеличава.
В миналото често се говореше: „Да напишем всичко на [язык/фреймворк], всичко ще заработи по-добре!“
В повечето случаи това не сработва, добре е, ако пренаписаното изобщо заработи. Затова ни трябваше да създадем roadmap — конкретна стратегия, илюстрираща стъпка по стъпка как ще бъдат постигнати бизнес целите (какво ще правим и защо), която:
- отражава мисията и целите на проекта;
- приоритизира основните цели;
- съдържа график на постиженията им.
Преди това никой не е разговарял с екипа за целите на промените. За целта са необходими правилни показатели за успех. За първи път в историята на компанията поставихме KPI за техническия екип, като тези показатели са свързани с организационните.
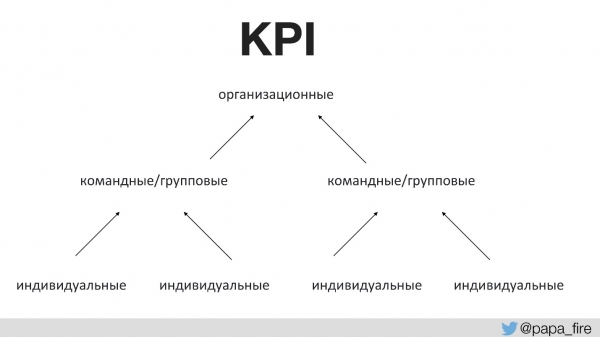
Тоест организационните KPI се подкрепят от екипите, а екипните KPI - от индивидите. В противен случай, ако технологичните KPI не съвпадат с организационните, всеки ще търси полза за себе си.
Например, един от организационните KPI е увеличаването на пазарния дял чрез нови продукти.
Какво може да подкрепи целта за повече нови продукти?
- На първо място, искаме да отделяме повече време за разработка на нови продукти, вместо да поправяме дефекти. Това е логично решение, което лесно може да се измери.
- На второ място, искаме да подкрепим увеличаването на обема на транзакциите, защото колкото по-голям е пазарният дял, толкова повече потребители и съответно трафик.
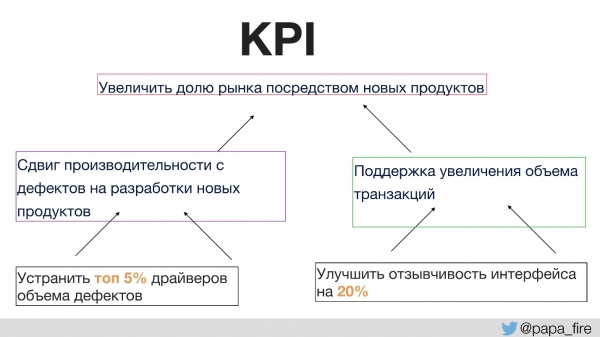
Така индивидуалните KPI, които могат да се изпълняват в групата, например, ще се фокусират на основните източници на дефекти. Ако се съсредоточим именно в тази секция, можем да направим така, че дефектите да намалят значително, и отново да увеличим времето за разработка на нови продукти и за подкрепа на организационните KPI.
По този начин всяко решение, включително пренаписването на код, трябва да подкрепя конкретни цели, които компанията ни е поставила (растеж на организацията, нови функции, наемане на персонал).
По време на този процес се появи интересен аспект, който стана новина не само за техническия екип, но и за компанията: всички тикети трябва да бъдат насочени към минимум един KPI. Тоест, ако продуктът казва, че иска да създаде нова функция, първият въпрос трябва да бъде: "Кой KPI подкрепя тази функция?" Ако няма такъв, съжалявам — изглежда, това е ненужна функция.
Ден тридесети
В края на месеца открих още един нюанс — никой от моя Ops екип никога не е виждал договорите, които сключваме с клиентите. Можете да попитате, защо е важно да се виждат договорите.
- На първо място, защото в договорите са описани SLA.
- На второ място, SLA са различни. Всеки клиент има свои изисквания, а търговският отдел подписва без да гледа.
Още един интересен нюанс - в договора с един от най-големите клиенти е записано, че всички версии на софтуера, които платформата поддържа, трябва да бъдат n-1, тоест не най-новата версия, а предишната.
Ясно е колко далеч бяхме от n-1, когато платформата беше на ColdFusion и SQL Server версия 2008, който спря да се поддържа изцяло през юли.
Ден четиридесети и пет
Някъде около средата на втория месец имаше достатъчно време, за да седна и да направя valuestreamсопоставяне изцяло за целия процес. Това са необходимите стъпки, които трябва да се предприемат, от създаването на продукта до доставката му на клиента, като трябва да ги опишем възможно най-подробно.
Разбиваш процеса на малки парчета и гледаш какво отнема твърде много време, какво може да се оптимизира, подобри и т.н. Например, колко време отнема заявка от продукта, преминаване през grooming, когато стигне до тикета, който разработчикът може да вземе, QA и т.н. Гледаш толкова подробно на всяка отделна стъпка и помисляш какво може да се оптимизира.
Докато правих това, две неща ми се набиха на очи:
- висок процент на връщане на тикети от QA обратно на разработчиците;
- проверката на pull request-ите отнемаше твърде много време.
Проблемът беше, че това бяха изводи от рода на: изглежда, че отнема много време, но не сме сигурни колко точно.
„Не може да се подобри това, което не може да се измери.“
Как да обосновем колко сериозен е проблемът? Заради него ли се губят дни или часове?
За да измерим това, добавихме няколко стъпки в процеса на Jira: „готов за разработка“ и „готов за QA“, за да измерваме колко време всеки тикет изчаква и колко пъти се връща на определена стъпка.
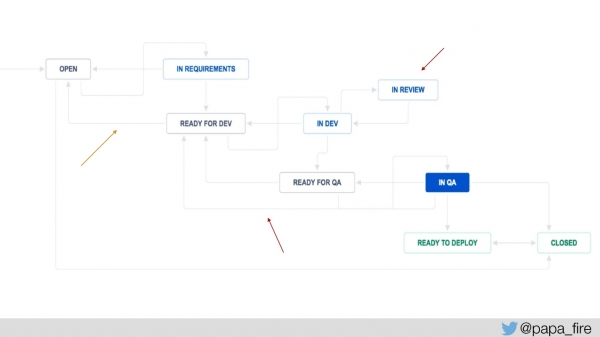
Също така добавихме „в преглед“, за да знаем колко средно тикетите прекарват на преглед, и от това да изхождаме. Имахме системни метрики, сега добавихме нови метрики и започнахме да измерваме:
- Ефективността на процеса: продуктивността и планирано/доставено.
- Качеството на процеса: брой дефекти, дефекти от QA.
Това наистина помага да се разбере какво върви добре и какво не.
Ден петдесети
Всичко това, разбира се, е хубаво и интересно, но към края на втория месец се случи нещо, което принципно беше предсказуемо, макар че не очаквах такъв мащаб. Хората започнаха да напускат, защото се смени ръководството. На върха дойдоха нови хора, които започнаха да променят всичко, а старите беше нужно да напуснат. А в обикновено в компания, която съществува няколко години, всички са приятели и всички се познават.
Това беше очаквано, но мащабът на напусканията беше неочакван. Например, в една седмица двама тимлида подадоха заявления за напускане по свое желание. Затова трябваше не само да забравя другите проблеми, но и да се фокусирам върху създаването на екип. Това е дългосрочен и труден проблем, но беше необходимо да се занимавам с него, защото исках да запазя хората, които останаха (или повечето от тях). Трябваше да реагирам на това, че хората напуснаха, за да поддържам морала в екипа.
Теоретично това е добре: идва нов човек, който има пълен карт-бланш, за да оценява уменията на екипа и да замести кадрите. В действителност обаче не може просто да се доведат нови хора по много причини. Винаги е необходим баланс.
- Между старото и новото. Трябва да запазим старите хора, които могат да се променят и да поддържат мисията. Но в същото време е нужно да внесем нова кръв, за което ще поговорим малко по-късно.
- Опит. Много говорих с добри джуниори, които бяха запалени и искаха да работят при нас. Но не можех да ги взема, защото имаше недостатъчно сеньори, които да поддържат джуниорите и да бъдат ментори за тях. Първо трябваше да наберем ръководството и едва след това младите.
- Тоест, кнута и пряника.
Нямам добър отговор на въпроса, кой баланс е правилен, как да бъде поддържан, колко хора да оставим и колко да натискаме. Това е изцяло индивидуален процес.
Ден петдесет и първи
Започнах да наблюдавам екипа, за да разбера, кои хора имам, и отново си припомних:
„Повечето проблеми са проблеми с хората“.
Открих, че в екипа, както сред разработчиците, така и сред операцийците, има три основни проблема:
- Удовлетвореност от текущото положение.
- Липса на отговорност — защото никой никога не е свързвал резултатите от работата на изпълнителите с влиянието върху бизнеса.
- Страх от промени.
Промените винаги изваждат от зоната на комфорт, и колкото по-млади са хората, толкова повече не харесват промените, защото не разбират защо и как. Най-честият отговор, който съм чувал, е: „Ние никога не сме правили така“. Достигало се е до абсолютен абсурд — дори най-малките промени не минаваха без протест от някой. И не е важно колко са свързани промените с тяхната работа, хората казваха: „Не, защо? Това няма да сработи“.
Но не можеш да станеш по-добър, без да промениш нещо.
Имах абсолютно абсурден разговор с колега, разказвах му за своите идеи за оптимизация, а той ми каза:
— А, не видя ли какво имахме миналата година!
— И какво?
— Сега е много по-добре, отколкото беше.
— Значи, не може ли да бъде още по-добре?
— А защо?
Добър въпрос — защо? Как будто, ако сега е по-добре, отколкото беше, значи всичко е достатъчно добре. Това води до липса на отговорност, което е напълно нормално. Както казах, техническият екип беше малко настрана. В компанията смятаха, че трябва да бъдат, но никой никога не е поставял стандарти. В техническата поддръжка никога не са виждали SLA, поради което за екипа беше напълно „приемливо“ (и това ме изненада най-много):
- 12 секунди зареждане;
- 5-10 минути престой при всяко издание;
- отстраняването на критични проблеми отнема дни и седмици;
- липса на дежурство 24х7 / on-call.
Никой никога не е опитвал да пита защо не можем да направим това по-добре, и никой никога не е разбирал, че така не трябва да бъде.
Като бонус, имаше и друг проблем: липса на опит. Старшите напуснаха, а оставеният млад екип се развиваше в предишния режим и беше отровен от него.
Към всичко това хората се страхуваха и да се провалят, да изглеждат некомпетентни. Това се изразява в това, че, първо, под никакви обстоятелства не искат помощ. Колко пъти сме разговаряли в група и индивидуално, и аз казвах: „Задайте въпрос, ако не знаете как да направите нещо“. Уверен съм в себе си и знам, че мога да реша всеки проблем, но това ще отнеме време. Затова, ако мога да попитам някого, който знае как да го реши за 10 минути, ще попитам. Колкото по-малко опит имаш, толкова повече се страхуваш да питаш, защото мислиш, че ще те сметнат за некомпетентен.
Тази страх да зададеш въпрос се проявява по интересни начини. Например, питаш: «Как вървят нещата с тази задача?» — «Остана още няколко часа, вече завършвам». На следващия ден отново питаш, получаваш отговор, че всичко е наред, но се е появила една проблемка, определено ще бъде готово до края на деня. Преминава още един ден, и докато не го притиснеш до стената и не го накараш да говори с някого, всичко продължава по същия начин. На човека му е трудно да реши задачата сам, той мисли, че ако сам не я реши, това ще бъде голям провал.
Затова разработчиците надценяват оценките. Това беше истински анекдот, когато обсъждахме определена задача, предоставиха ми такава цифра, че много се изненадах. На което ми казаха, че в оценките разработчикът включва и времето, през което тикетът ще се връща от QA, защото там ще намерят грешки, времето, което ще отнеме PR, и времето, докато хората, които трябва да го прегледат, са заети — тоест всичко, което може да се включи.
На второ място, хората, които се страхуват да изглеждат неконкурентоспособни, прекалено анализират. Когато кажеш какво точно трябва да се направи, започва: «Не, а какво, ако тук помислим?» В това отношение нашата компания не е уникална, това е стандартен проблем за младите.
В отговор въведох следните практики:
- Правило за 30 минути. Ако в рамките на половин час не можете да решите проблема, помолете някого за помощ. Това работи с променлив успех, защото хората все пак не просят, но поне процесът е започнал.
- Изключете всичко, освен същността, при оценяване на сроковете за изпълнение на задачата, тоест да се счита само времето, което ще отнеме написването на кода.
- Непрекъснато обучение за онези, които прекалено анализират. Това е просто постоянна работа с хора.
Ден шестдесет
Докато се занимавах с всичко това, дойде време да се разбера с бюджета. Разбира се, намерих много интересно в това, къде харчим парите. Например, имахме цяла стелаж в отделен дата център, на който стоеше един FTP сървър, който се използваше от един клиент. Оказа се, че «… ние се преместихме, а той остана, не го сменихме». Това беше преди 2 години.
Особен интерес представлява сметката за облачните услуги. Убеден съм, че основната причина за високата сметка е, че разработчиците, които за първи път имат неограничен достъп до сървърите, не знаят как да управляват тези ресурси. Не им е нужно да питат: „Дайте ми, моля, тестов сървър“ — те могат сами да вземат. Освен това, разработчиците винаги искат да изградят такава страхотна система, че Facebook и Netflix да завидят.
Но разработчиците нямат опит в закупуването на сървъри и не знаят как да определят нужния размер на сървърите, защото досега не им е било необходимо. И обикновено не разбирай разликата между scalability и performance.
Резултати от инвентаризацията:
- Излезли от един дата център.
- Разтрогнали договора с 3 лог-сервиза. Защото имахме 5 — всеки разработчик, който започваше да експериментира, вземаше нов.
- Изключили 7 AWS системи. Отново, мъртвите проекти не бяха спирани, те продължаваха да работят.
- Намалили разходите за софтуер с 6 пъти.
Ден седемдесет и пети
Времето минаваше и след два с половина месеца трябваше да се срещна с управителния съвет. Нашият съвет не е по-добър или по-лош от другите, той, както всички други, иска да знае всичко. Хората инвестират пари и искат да разберат доколко това, което правим, отговаря на поставените KPI.
Съветът на директорите получава много информация всеки месец: брой потребители, техният растеж, какви услуги използват и как, производителност и продуктивност, и накрая, средна скорост на зареждане на страницата.
Проблемът е, че смятам, че средната стойност е чисто зло. Но е много трудно да обясня това на съвета на директорите. Те са свикнали да работят с агрегирани числа, а не, например, с разпространение на времето за зареждане в секунди.
Свързано с това имаше интересни моменти. Например, казах, че трябва да разделим трафика между отделни уеб сървъри в зависимост от типа съдържание.
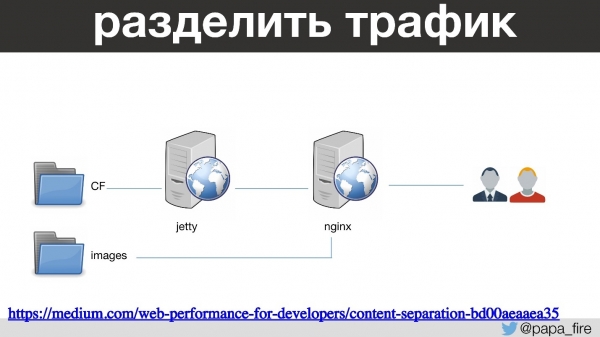
Тоест ColdFusion преминава през Jetty и nginx, като стартира страниците. А изображенията, JS и CSS се обработват през отделен nginx с техните конфигурации. Това е доста стандартна практика, за която споменах преди няколко години. В резултат на това изображенията се зареждат много по-бързо и … средната скорост на зареждане се увеличи с 200 мс.
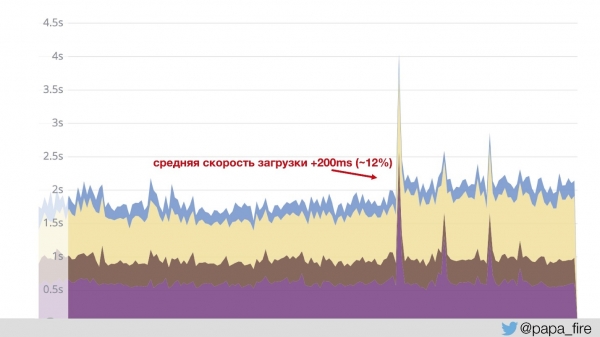
Това стана, защото графикът се изгражда на база данни, които идват с Jetty. Тоест бързото съдържание не влиза в сметката — средната стойност се увеличи. Разбирахме това и се засмяхме, но как да обясним на борда на директорите защо сме направили нещо и е станало по-зле с 12%?
Ден осемдесет и пет
Към края на третия месец осъзнах, че за едно нещо не бях изцяло подготвен — времето. За всичко, за което говорих, е необходимо време.
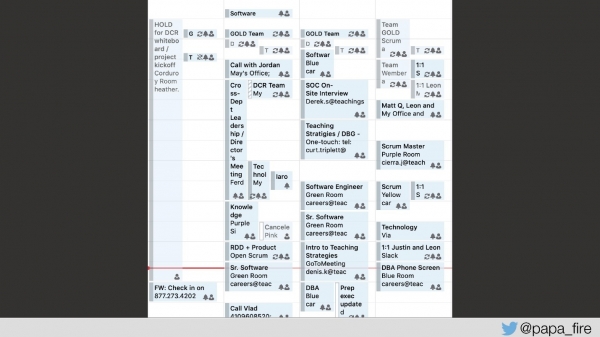
Това е моят истински календар за седмицата — просто работна седмица, не много натоварена. Няма достатъчно време за всичко. Затова, отново, трябва да наемем хора, които да помогнат с проблемите.
Заключение
Това не е всичко. В тази история дори не съм стигнал до това как работихме с продукта и се опитвахме да настроим обща вълна, или как интегрирахме техническата поддръжка, или как решавахме други технически проблеми. Например, случайно научих, че по най-големите таблици в базата данни не използваме ПОСЛЕДОВАТЕЛНОСТ. Имаме самостоятелна функция nextID, и тя не се използва в транзакция.
Имаше и милион подобни неща, за които може да се говори дълго. Но най-важното, за което си заслужава да се говори, е културата.
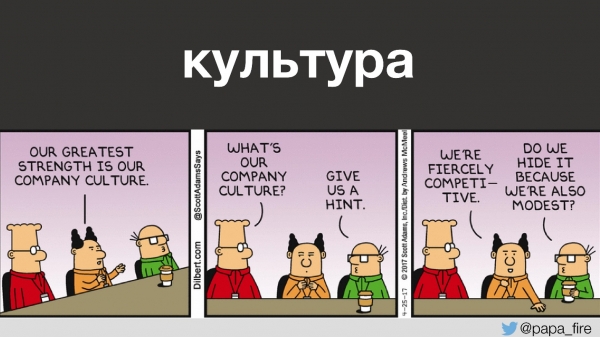
Точно културата или нейното отсъствие води до всички останали проблеми. Опитваме се да изградим култура, в която хората:
- не се страхуват от неуспехи;
- учат от грешките;
- сътрудничат с други екипи;
- проявяват инициатива;
- поемат отговорност;
- приветстват резултата като цел;
- празнуват успеха.
С това всичко останало ще дойде.
Леон Файер , и на .
По отношение на legacy има две стратегии: с всички сили да избягваме работа с него или смело да преодоляваме свързаните трудности. Ние c прилагаме втория подход, променяйки процесите и подходите. Присъединете се към нас в , и , и ще внедряваме заедно културата DevOps.
Източник: habr.com
