

Оминаха онези дни, когато не трябваше да се притеснявате за оптимизацията на производителността на базите данни. Времето не стои на място. Всеки нов предприемач в сферата на високите технологии иска да създаде следващия Facebook, стремейки се да събира всички данни, до които може да се докосне. Тези данни са необходими на бизнеса за по-качествено обучение на модели, които помагат за печелене. В такива условия на програмистите им е необходимо да създават API, които да позволяват бърза и надеждна работа с огромни обеми информация.
Ако от известно време се занимавате с проектиране на сървърни части на приложения или бази данни, вероятно сте писали код за изпълнение на запитвания с разбивка на страници. Например — такова:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Така ли е?
Но ако разбивката на страниците е извършена по този начин, с сожаление трябва да отбележа, че сте го направили не по най-ефективния начин.
Искате ли да ми възразите? . , и вече прилагат техниките, за които искам да говоря днес.
Назовете поне един разработчик на бекенди, който никога не е използвал OFFSET и LIMIT за изпълнение на запитвания с разбивка на страници. В MVP (Minimum Viable Product, минимален жизнеспособен продукт) и в проекти, където се използват малки обеми данни, този подход е напълно приложим. Той, така да се каже, "просто работи".
Но ако е нужно да се изградят надеждни и ефективни системи от нулата, е добре предварително да се погрижите за ефективността на изпълнението на запитванията към базите данни, използвани в такива системи.
Днес ще говорим за проблемите, свързани с широко използваните (жалко, че е така) реализации на механизмите за изпълнение на запитвания с разбивка на страници и за това как да постигнем висока производителност при изпълнението на подобни запитвания.
Какво не е наред с OFFSET и LIMIT?
Както вече беше казано, OFFSET и LIMIT отлично се представят в проекти, в които не е нужно да работите с големи обеми данни.
Проблемът възниква, когато базата данни нараства до такива размери, че спира да се побира в паметта на сървъра. Но в същото време при работа с тази база данни е необходимо да се използват запитвания с разбивка на страници.
За да се прояви този проблем, е необходимо да възникне ситуация, в която СУБД прибягва до неефективна операция за пълно сканиране на таблицата (Full Table Scan) при изпълнението на всяко запитване с разбивка на страници (в същото време могат да се извършват операции по добавяне и изтриване на данни, а остарелите данни не ни трябват!).
Какво е «пълно сканиране на таблицата» (или «последователно преглеждане на таблицата», Sequential Scan)? Това е операция, при която СУБД последователно прочита всеки ред на таблицата, т.е. данните в нея, и ги проверява за съответствие с зададеното условие. Известно е, че този тип сканиране на таблици е най-бавен. Фактът е, че при изпълнението му се извършват много операции за вход/изход, които ангажират дисковата подсистема на сървъра. Ситуацията се влошава от закъсненията, свързани с работата с данни, съхранявани на дисковете, и че прехвърлянето на данни от диска в паметта е ресурсно интензивна операция.
Например, имате записи за 100000000 потребители и изпълнявате запитване с конструкция OFFSET 50000000. Това означава, че СУБД ще трябва да зареди всички тези записи (а те дори не ни трябват!) и да ги постави в паметта, а след това да вземе, да кажем, 20 резултата, за които е уведомено в LIMIT.
Да кажем, че това може да изглежда така: «изберете редове от 50000 до 50020 от 100000». Тоест, системата за изпълнение на запитването ще трябва първо да зареди 50000 реда. Виждате ли колко много ненужна работа ще трябва да свърши?
Ако не вярвате — погледнете примера, който създадох, използвайки възможностите на .
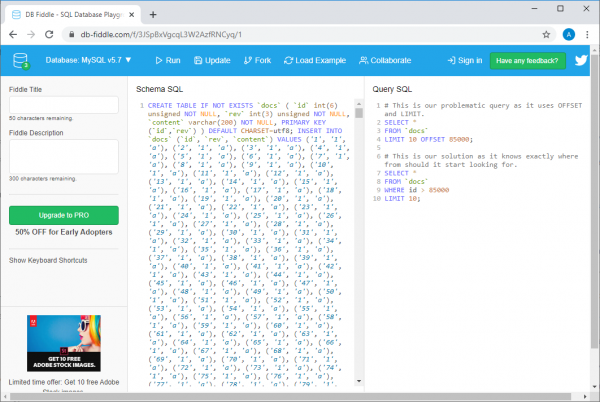
Пример на db-fiddle.com
Там, отляво, в полето Schema SQL, има код, който извършва вставка в базата данни на 100000 реда, а отдясно, в полето Query SQL, са показани два запитвания. Първото, бавно, изглежда така:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
А второто, което представлява ефективно решение на същата задача, е:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
За да изпълните тези запитвания, е достатъчно да натиснете бутона Run в горната част на страницата. След като го направим, ще сравним информацията за времето за изпълнение на заявките. Оказва се, че времето за изпълнение на неефективна заявка отнема поне 30 пъти повече време, отколкото за изпълнението на втората (от изпълнение на изпълнение, това време може да варира; например, системата може да съобщи, че за първата заявка е отнело 37 мс, а за втората — 1 мс).
Ако данните станат още повече, всичко ще изглежда още по-зле (за да се уверите в това, погледнете моя с 10 милиона реда).
Това, което току-що обсъдихме, трябва да ви даде представа за това как всъщност се обработват заявките към базите данни.
Имайте предвид, че колкото по-висока е стойността, OFFSET толкова по-дълго ще отнеме изпълнението на заявката.
Какво е най-добре да се използва вместо комбинацията OFFSET и LIMIT?
Вместо комбинацията OFFSET и LIMIT е по-добре да се използва конструкция, построена по следната схема:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Това е изпълнение на заявка с разбивка на страници, основана на курсор (Cursor based pagination).
Вместо да държите локално текущите OFFSET и LIMIT и да ги предавате с всяка заявка, трябва да запомните последния получен първичен ключ (обикновено това е ID) и LIMIT, в резултат на което ще получавате заявки, приличащи на горепосочената.
Защо? Фактът, че ясно посочвате идентификатора на последния прочетен ред, уведомява вашата СУБД къде да започне търсенето на нужните данни. Освен това, благодарение на използването на ключа, търсенето ще се извършва ефективно, без системата да се разсейва от редовете извън посочения диапазон.
Нека да погледнем следващото сравнение на производителността на различни заявки. Ето неефективната заявка.
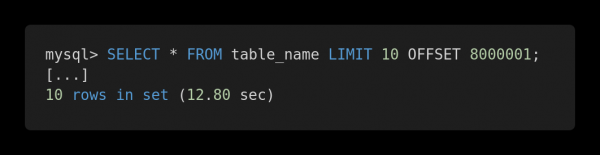
Бавно запитване
А ето и оптимизираната версия на тази заявка.
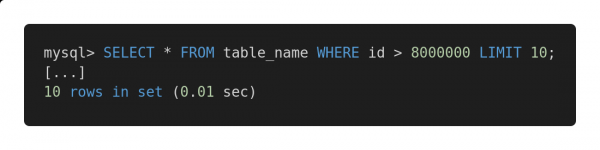
Бърза заявка
И двете заявки връщат точно същия обем данни. Но за изпълнението на първата отнема 12,80 секунди, а за втората — 0,01 секунда. Чувствате ли разликата?
Потенциални проблеми
За да се осигури ефективното функциониране на предложените методи за изпълнение на заявки, е необходимо в таблицата да присъства колона (или колони), съдържащи уникални, последователно разположени индекси, като например цяло числено идентификационно число. В някои специфични случаи това може да определи успеха на прилагането на подобни заявки за увеличаване на скоростта на работа с базата данни.
Естествено, когато конструирате заявки, трябва да вземете предвид особеностите на архитектурата на таблиците и да изберете тези механизми, които най-добре ще се представят на наличните таблици. Например, ако е необходимо да се работи с големи обеми свързани данни, може да ви бъде интересна статия.
Ако пред нас стои проблемът с отсъствието на първичен ключ, например, ако имаме таблица с много-колона отношение, традиционният подход, който предвижда използването на OFFSET и LIMIT, определено ще ни подхожда. Но използването му може да доведе до изпълнение на потенциално бавни заявки. В такива случаи бих препоръчал да се използва първичен ключ с автоинкремент, дори ако той е необходим само за организиране на изпълнението на заявки с разбивки на страници.
Ако ви интересува тази тема — , и — няколко полезни материала.
Итог
Основният извод, който можем да направим, е, че винаги, независимо от размера на базите данни, трябва да се анализира скоростта на изпълнение на заявките. В наши дни мащабируемостта на решенията е изключително важна и ако от самото начало на работата по някаква система бъде проектирано всичко правилно, това в бъдеще може да спести на разработчика много проблеми.
Как анализирате и оптимизирате заявките към базите данни?
Източник: habr.com
