

LINQ навлезе в .NET като нов мощен език за манипулация с данни. LINQ to SQL като част от него позволява удобно взаимодействие с бази данни с помощта на например Entity Framework. Въпреки това, често прилагане на LINQ, разработчиците забравят да проверят какви SQL заявки ще генерира queryable provider, в случая — Entity Framework.
Нека да разгледаме два основни момента на примера.
За целта в SQL Server ще създадем база данни Test и в нея ще създадем две таблици с помощта на следния заявка:
Създаване на таблици
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Сега ще запълним таблицата Ref с помощта на изпълнението на следния скрипт:
Запълване на таблицата Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
По аналогичен начин ще запълним таблицата Customer с помощта на следния скрипт:
Запълване на таблицата Customer
ИЗПОЛЗВАЙ [ТЕСТ]
ГО

ОПРЕДЕЛИ @ind INT=1;
ОПРЕДЕЛИ @ind_ref INT=1;

ДОКАТО(@ind<=12000000)
НАЧАЛО
	АКО(@ind%3=0) НАСТРОЙ @ind_ref=1;
	ИНОЧЕ АКО (@ind%5=0) НАСТРОЙ @ind_ref=2;
	ИНОЧЕ АКО (@ind%7=0) НАСТРОЙ @ind_ref=3;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=4;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=5;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=6;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=7;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=8;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=9;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=10;
	ИНОЧЕ АКО (@ind=0) НАСТРОЙ @ind_ref=11;
	ИНОЧЕ НАСТРОЙ @ind_ref=@ind90000;

	ВЪВЕДИ В [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 ИЗБЕРИ
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	НАСТРОЙ @ind=@ind+1;
КРАЙ
ГО
Така получихме две таблици, в едната от които има над 1 милион реда данни, а в другата — над 10 милиона реда данни.
Сега в Visual Studio е необходимо да създадете тестов проект Visual C# Console App (.NET Framework):
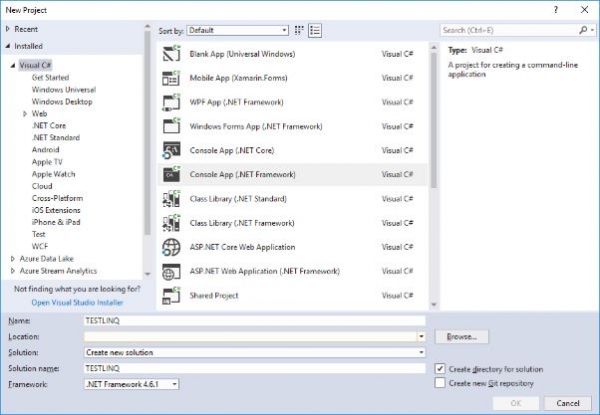
След това е необходимо да добавите библиотека за Entity Framework за взаимодействие с базата данни.
За да го добавим, щракваме с десния бутон на проекта и от контекстното меню избираме Управление на NuGet пакети:
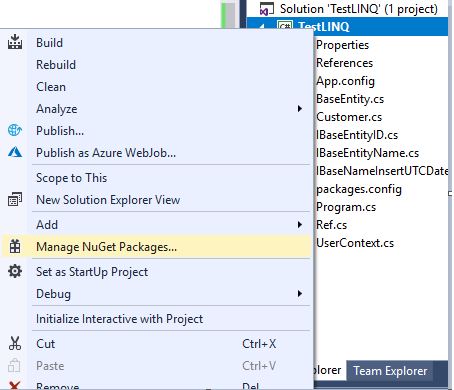
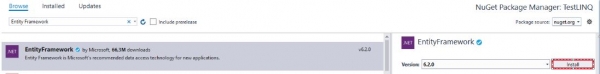
След това в появилото се прозорче за управление на NuGet пакетите във полето за търсене въвеждаме думата „Entity Framework“ и избираме пакета Entity Framework и го инсталираме:
След това във файла App.config, след затварящия таг configSections, трябва да добавим следния блок:
В connectionString трябва да въведем стринга за свързване.
Сега ще създадем в отделни файлове 3 интерфейса:
- Имплементация на интерфейса IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Имплементация на интерфейса IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Имплементация на интерфейса IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
И в отделен файл ще създадем основния клас BaseEntity за нашите две същности, който ще включва общите полета:
Имплементация на основния клас BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
След това в отделни файлове ще създадем нашите две същности:
- Имплементация на класа Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Имплементация на класа Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Сега ще създадем в отделен файл контекста UserContext:
Имплементация на класа UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
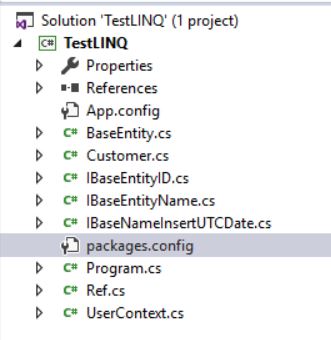
Получихме готово решение за провеждане на тестове по оптимизация с LINQ to SQL през EF за MS SQL Server:
Сега в файла Program.cs ще въведем следния код:
Файл Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
След това ще стартираме нашия проект.
В края на изпълнението на конзолата ще се изведе:
Генерирана SQL заявка
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Т.е. в общи линии, LINQ заявката е генерирала вполне приемлив SQL заявка за MS SQL Server.
Сега ще променим условието И на ИЛИ в LINQ заявката:
LINQ-запитване
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
И отново ще стартираме нашето приложение.
Изпълнението ще завърши с грешка, свързана с превишаване на времето за изпълнение на командата от 30 секунди:
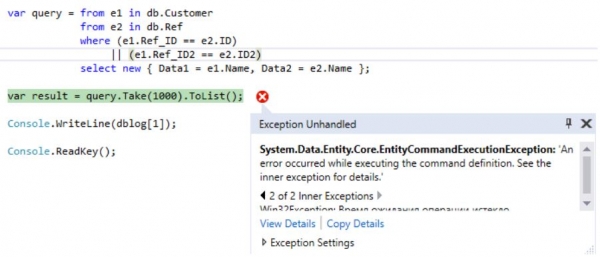
Ако видим коя заявка е била генерирана от LINQ:
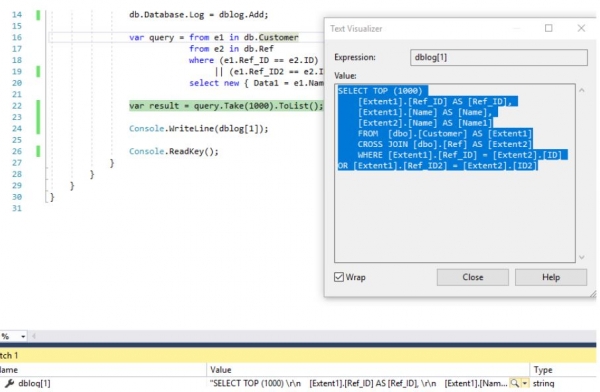
, можем да се уверим, че избора се извършва чрез декартово произведение на две множества (таблици):
Генерирана SQL заявка
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Нека пре напишем LINQ заявката по следния начин:
Оптимизирана LINQ заявка
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Тогава ще получим следният SQL заявка:
SQL-запитване
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
За съжаление, в LINQ заявките условието за свързване може да бъде само одно, затова е възможно да се направи еквивалентно запитване чрез два записа по всяко условие, последвани от обединение с Union за премахване на дубликати между редовете.
Да, запитванията в общия случай ще се окажат нееквивалентни с оглед на факта, че могат да бъдат върнати пълни дубликати на редовете. Въпреки това, в реалния живот пълните дублиращи редове не са необходими и се опитват да се отърват от тях.
Сега да сравним плановете за изпълнение на тези две запитвания:
- за CROSS JOIN средното време за изпълнение е 195 секунди:

- за INNER JOIN-UNION средното време за изпълнение е по-малко от 24 секунди:

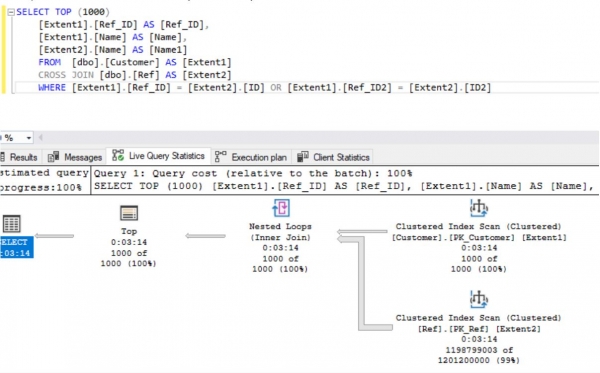
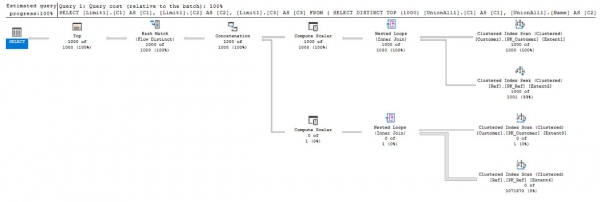
Както можем да видим от резултатите, за две таблици с милиони записи оптимизираното LINQ запитване работи значително по-бързо от неоптимизираното.
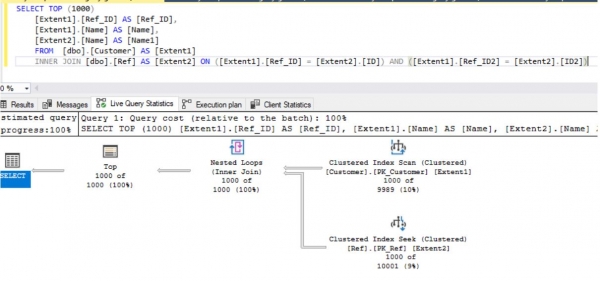
За варианта с И в условията на LINQ запитването от вида:
LINQ-запитване
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
почти винаги ще бъде генериран правилен SQL запитване, което ще се изпълнява средно около 1 секунда:
Също така, за манипулации LINQ to Objects вместо запитването от вида:
LINQ запитване (1-ви вариант)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
може да се използва запитване от вида:
LINQ запитване (2-ри вариант)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
където:
Определяне на два масива
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, а типът Para се определя по следния начин:
Определение на типа Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Така, ние разгледахме някои аспекти на оптимизацията на LINQ запитвания към MS SQL Server.
За съжаление, дори опитните и водещи .NET разработчици забравят, че е необходимо да разбират какво правят зад кулисите тези инструкции, които използват. В противен случай те стават конфигуриращи и могат да закладат бомба със забавено действие в бъдеще, както при мащабиране на софтуерното решение, така и при незначителни изменения на външните условия на средата.
Също така беше направен малък преглед и .
Изходните файлове за теста - самият проект, създаването на таблици в базата данни TEST, както и попълването с данни на тези таблици се намира .
Също така в този репозиторий в папката Plans се намират плановете за изпълнение на заявки с условия ИЛИ.
Източник: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish