

Тази статия е превод на моя статия в Medium — , която се оказа доста популярна, вероятно заради простотата си. Затова реших да я напиша на български и да я допълня, за да помогна на обикновения човек, който не е специалист по данни, да разбере какво е хранилище за данни (DW) и какво е Data Lake, и как те съжителстват заедно.
Защо реших да пиша за Data Lake? Работя с данни и аналитика повече от 10 години и в момента работя с големи данни в Amazon Alexa AI в Кеймбридж, който е в Бостън, въпреки че живея във Виктория, на остров Ванкувър, и често посещавам Бостън, Сиатъл и Ванкувър, а понякога дори говоря на конференции в Москва. Също така, от време на време пиша, но основно на английски и вече съм написал , а също така имам нужда да споделям тенденции в аналитиката от Северна Америка и понякога пиша в .
Винаги съм работил с хранилища за данни и от 2015 година активно работя с Amazon Web Services, а изобщо съм се насочил към облачна аналитика (AWS, Azure, GCP). Наблюдавал съм еволюцията на аналитичните решения от 2007 г. насам и дори съм работил за вендора на хранилища за данни Teradata и внедрявал решения в Сбербанк, тогава се появи Big Data с Hadoop. Всички започнаха да говорят, че ерата на хранилищата е приключила и сега всички са на Hadoop, след което започнаха да говорят за Data Lake, отново, че ето, хранилищата за данни явно приключиха. Но за щастие (може би за някого и за нещастие, който е печелил много пари от настройката на Hadoop), хранилищата за данни не изчезнаха.
В тази статия ще разгледаме какво е Data Lake. Статията е насочена към хора с малко или никакво опит с хранилища за данни.
На снимката е Бледското езеро, това е едно от любимите ми езера, макар че съм бил там само веднъж, но го запомних за цял живот. Но ще говорим за друг тип езеро — Data Lake. Вероятно много от вас вече са чували за този термин, но още едно определение никому не би навредило.
Първо, ето най-популярните определения за Data Lake:
«файлово хранилище на всички типове необработени данни, достъпни за анализ от всеки в организацията» — Мартин Фаулър.
«Ако смятате, че езерото от данни е бутилка с вода — пречистена, опакована и разфасована за удобно използване, то езерото от данни е огромен резервуар с вода в естествения ѝ вид. Потребителите могат да черпят вода за себе си, да се гмуркат на дълбочина, да изследват» — Джеймс Диксън.
Сега вече знаем, че езерото от данни е свързано с анализа, то ни позволява да съхраняваме големи обеми данни в първоначалния им вид и имаме необходимия и удобен достъп до данните.
Често обичам да опряснявам нещата, ако мога да обясня сложен термин с прости думи, значи за себе си съм разбрал как работи и за какво е нужно. Например, един път разглеждах iPhone в галерията с снимки и осъзнах, че това е истинско езеро от данни, дори направих слайд за конференции:
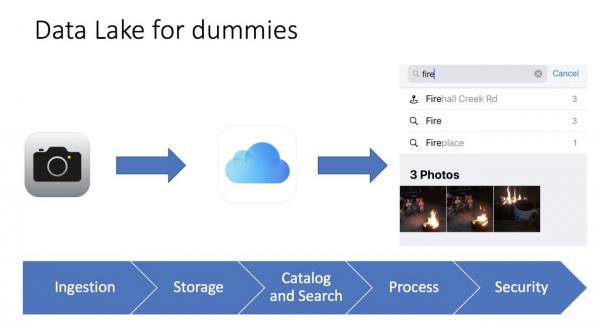
Всичко е много просто. Правим снимка с телефона, снимката се запазва на телефона и може да бъде записана в iCloud (облачна файлова система). Освен това телефонът събира метаданни на снимката: какво е изображено, гео-маркировка, време. В резултат можем да използваме удобния интерфейс на iPhone, за да намерим нашата снимка и дори виждаме показатели, например, когато търся снимки с думата огън (fire), намирам 3 снимки с изображение на лагерен огън. За мен това е като инструмент за бизнес анализ, който работи много бързо и прецизно.
И разбира се, не можем да забравим за сигурността (авторизация и удостоверяване), иначе нашите данни могат лесно да попаднат в открит достъп. Има много новини за големи корпорации и стартъпи, чиито данни попаднаха в открит достъп поради небрежност на разработчиците и неспазване на прости правила.
Даже една толкова проста картинка ни помага да си представим какво е езеро от данни, какви са разликите му от традиционно хранилище на данни и неговите основни елементи:
- Зареждане на данни (Ingestion) — ключов компонент на езерото от данни. Данните могат да попаднат в хранилището по два начина — на партиди (batch) и поток (streaming).
- Файлово хранилище (Storage) — основен компонент на Езерото от Данни. Необходимо е хранилището да бъде лесно мащабируемо, изключително надеждно и с ниска цена. Например, в AWS това е S3.
- Каталог и Търсене (Catalog and Search) — за да избегнем Блатото на Данните (това е, когато събираме всички данни на едно място и след това не можем да работим с тях), трябва да създадем слой с метаданни за класификация на данните, така че потребителите лесно да могат да намерят необходимите данни за анализ. Освен това, могат да се използват допълнителни решения за търсене, като например ElasticSearch. Търсенето помага на потребителя да открива необходимите данни чрез удобни интерфейси.
- Обработка (Process) — тази стъпка отговаря за обработката и трансформацията на данните. Можем да трансформираме данните, да променяме техните структури, да ги почистваме и много повече.
- Сигурност (Security) — важно е да отделим време за проектиране на сигурността на решението. Например, криптиране на данни по време на съхранение, обработка и предаване. Важно е да се използват методи за автентикация и авторизация. Накратко, необходим е инструмент за одит.
От практическа гледна точка, можем да характеризираме езерото от данни с три атрибута:
- Събирайте и съхранявайте всичко — езерото от данни съдържа всички данни, както сурови необработени данни за всеки период от време, така и обработени/почистени данни.
- Дълбок анализ — езерото от данни позволява на потребителите да изследват и анализират данните.
- Гъвкав достъп — езерото от данни осигурява гъвкав достъп до различни данни и различни сценарии.
Сега можем да говорим за разликата между хранилище на данни и езеро от данни. Обикновено хората питат:
- А какво ще кажете за хранилището на данни?
- Заместваме ли хранилището на данни с езеро от данни или го разширяваме?
- Може ли все пак да се мине без езеро от данни?
Накратко, няма категоричен отговор. Всичко зависи от конкретната ситуация, уменията на екипа и бюджета. Например, миграцията на хранилища на данни на Oracle в AWS и създаването на езеро от данни от дъщерната компания на Амазон — Woot — .
От друга страна, доставчикът Snowflake твърди, че вече не трябва да се притеснявате за езерото от данни, тъй като тяхната платформа за данни (до 2020 г. това беше хранилище на данни) ви позволява да комбинирате както езерото от данни, така и хранилището на данни. Работил съм малко със Snowflake, и наистина това е уникален продукт, който може да бъде така. Цената е друг въпрос.
В заключение, моето лично мнение е, че все още имаме нужда от хранилище на данни като основен източник на данни за нашата отчетност, а всичко, което не се побира, съхраняваме в езерото от данни. Цялата роля на аналитиката е да предостави удобен достъп за бизнеса, за да взима решения. Каквото и да кажем, бизнес потребителите работят по-ефективно с хранилище на данни, отколкото с езеро от данни; например, в Amazon имаме Redshift (аналитично хранилище на данни) и Redshift Spectrum/Athena (SQL интерфейс за езеро от данни в S3, базиран на Hive/Presto). Същото важи и за другите съвременни аналитични хранилища за данни.
Нека разгледаме типичната архитектура на хранилище на данни:
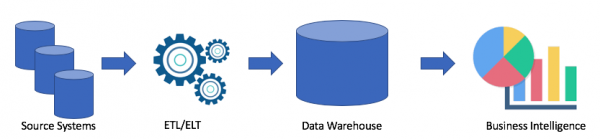
Това е класическо решение. Имаме източникови системи, и чрез ETL/ELT копираме данните в аналитичното хранилище на данни и свързваме към решение за Business Intelligence (мой любим инструмент е Tableau, а вашият?).
Такова решение има следните недостатъци:
- ETL/ELT операциите изискват време и ресурси.
- Обикновено паметта за съхранение на данни в аналитичното хранилище на данни не е евтина (например Redshift, BigQuery, Teradata), тъй като трябва да купим целия клъстер.
- Бизнес потребителите имат достъп до прочистени и често агрегирани данни и нямат възможност да получат сурови данни.
Разбира се, всичко зависи от вашия случай. Ако нямате проблеми с вашето хранилище на данни, то не ви трябва езеро от данни. Но когато се появят проблеми с недостиг на пространство, мощности или цената е от ключово значение, можете да разгледате варианти с езеро от данни. Именно затова, езерото от данни е много популярно. Ето един пример за архитектура на езеро от данни:
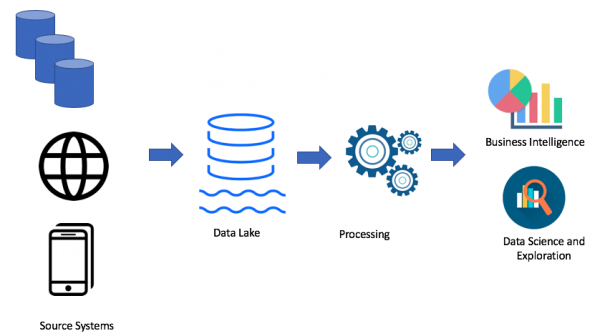
Използвайки подхода на езертата от данни, ние зареждаме сурови данни в нашето езеро от данни (пакетно или стрийминг), след което обработваме данните при необходимост. Езерото от данни позволява на бизнес потребителите да създават свои собствени трансформации на данни (ETL/ELT) или да анализират данните в решенията за Business Intelligence (ако имат необходимия драйвер).
Целта на всяко аналитично решение е да служи на бизнес потребителите. Затова винаги трябва да работим от изискванията на бизнеса. (В Amazon това е един от принципите — работим обратно).
Работейки както с хранилището на данни, така и с езерото на данни, можем да сравним и двете решения:
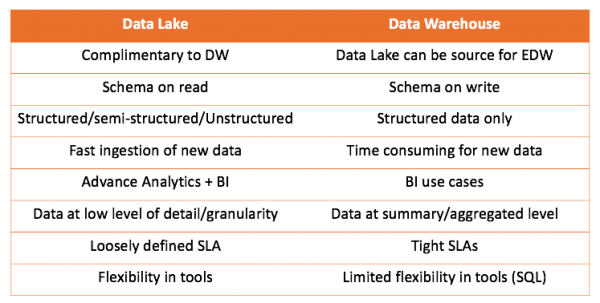
Основният извод, който може да се направи, е, че хранилището на данни не конкурира с езерото от данни, а по-скоро го допълва. Но вие сами решавате какво подхожда за вашия случай. Винаги е интересно да опитате сами и да извлечете правилните изводи.
Бих искал също така да разкажа за един от случаите, когато започнах да използвам подхода на езерото от данни. Всичко беше доста банално, опитах се да използвам инструмент за ELT (имахме Matillion ETL) и Amazon Redshift, моето решение работеше, но не отговаряше на изискванията.
Необходимо беше да взема уеб логове, да ги трансформирам и агрегира, за да предоставя данни за два случая:
- Маркетинговият екип искаше да анализира активността на ботове за SEO
- IT искаше да следи метриките по работата на сайтовете
Много прост, много прости логове. Ето един пример:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Един файл тежеше 1-4 мегабайта.
Но имаше едно предизвикателство. Имахме 7 домейна по целия свят и на ден се създаваха 7000 файла. Това не е много голям обем, само 50 гигабайта. Но размерът на нашия Redshift кластер също беше малък (4 нода). Зареждането по традиционния начин на един файл отнемаше около минута. Тоест, задачата не можеше да бъде решена директно. И това беше случай, в който реших да използвам подхода на езерото от данни. Решението изглеждаше приблизително така:
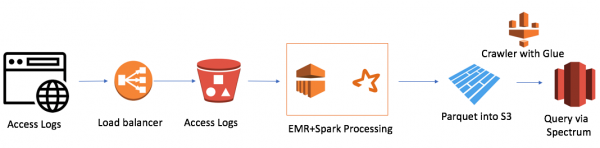
То е доста просто (искам да подчертая, че предимството на работата в облака е простотата). Използвах:
- AWS Elastic Map Reduce (Hadoop) като изчислителна мощност
- AWS S3 като файлова хранилище с възможност за шифроване на данни и ограничаване на достъпа
- Spark като InMemory изчислителна мощност и PySpark за логика и трансформация на данни
- Parquet като резултат от работата на Spark
- AWS Glue Crawler като сборщик на метаданни за нови данни и партиции
- Redshift Spectrum като SQL интерфейс към езерото от данни за съществуващите потребители на Redshift
Най-малкият кластер EMR+Spark обработваше всичките пачки файлове за 30 минути. Има и други случаи за AWS, особено много свързани с Alexa, където данните са наистина много.
Съвсем наскоро разбрах един от недостатъците на езерото с данни – GDPR. Проблемът е, че когато клиент поиска да ги изтрие, а данните са в един от файловете, не можем да използваме Data Manipulation Language и операция DELETE както в база данни.
Надявам се, че статията изясни разликата между хранилище с данни и езеро с данни. Ако беше интересно, мога да преведа още свои статии или статии на професионалисти, които чета. Мога също така да разкажа за решенията, с които работя, и тяхната архитектура.
Източник: habr.com
