

Класическият въпрос, с който разработчик идва при своя DBA или собственик на бизнес — към консултант по PostgreSQL, почти винаги звучи еднакво: „Защо заявките отнемат толкова дълго време в базата данни?“
Традиционен набор от причини:
- неефективен алгоритъм
когато решите да направите JOIN на няколко CTE с десетки хиляди записи - неактуална статистика
ако фактическото разпределение на данните в таблицата вече значително се различава от събраната ANALYZE при последния път - „задръстване“ по ресурси
и вече нямате достатъчни компютърни мощности CPU, постоянно се увеличава обемът на паметта или дискът не успява да отговори на всички „желания“ на БД - блокировки от конкурентни процеси
И ако блокировките са достатъчно сложни за улавяне и анализ, то за всичко останало ни е необходим само планът на запитването, който може да се получи с помощта на (по-добре, разбира се, веднага EXPLAIN (ANALYZE, BUFFERS) …) или .
Но, както е посочено в същата документация,
„Разбирането на плана е изкуство, и за да го овладеете, е необходимо определено познание, …“
Но можете да се справите и без него, ако използвате подходящ инструмент!
Как изглежда обикновено планът на запитването? Нещо такова:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
или така:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Но четенето на плана текстово „от листа“ — е много трудно и неочевидно:
- в възела се извежда сумата по ресурсите на поддеревото
тоест, за да разберете колко време е отнело изпълнението на конкретен възел, или колко точно четенето от таблицата е изобщо извлекло данни от диска — трябва да извадите едно от друго - времето на възел е необходимо умножавайте на loops
да, изваждането все още не е най-сложната операция, която трябва да се извърши „в ума“ — тъй като времето за изпълнение е средно за едно изпълнение на възел, а те могат да бъдат стотици - ну, и всичко това заедно пречи да се отговори на основния въпрос — така кой е „най-слабата връзка“?
Когато се опитахме да обясним всичко това на няколко стотин от нашите разработчици, разбрахме, че отстрани изглежда приблизително така:
А, следователно, ни трябва…
Инструмент
В него сме се опитали да съберем всички ключови механики, които помагат по плана и запитването да разберем „кой е вината и какво да правим“. А също така част от опита си да споделим с общността.
Запознайте се и ползвайте —
Яснотата на плановете
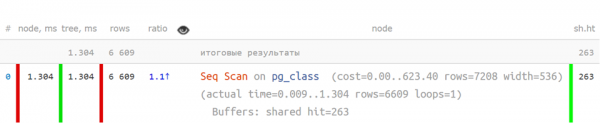
Дали е лесно да разберете плана, когато той изглежда така?
Seq Scan on pg_class (actual time=0.009..1.304 rows=6609 loops=1)
  Buffers: shared hit=263
Planning Time: 0.108 ms
Execution Time: 1.800 ms
Не много.
Но така, в съкратен вид, когато ключовите показатели са отделени — вече е много по-разбираемо:
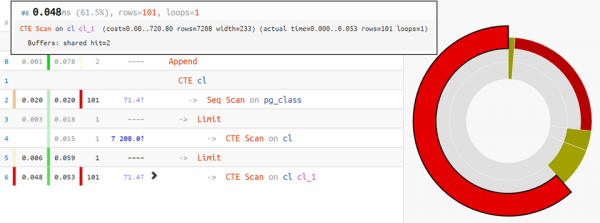
Но ако планът е по-сложен — на помощ ще дойде piechart на разпределението на времето по възлите:
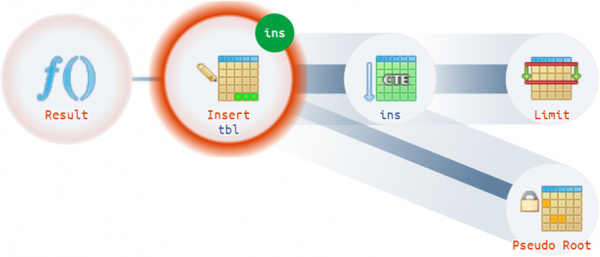
Ну, а за най-сложните варианти на помощ бърза диаграмата на изпълнението:
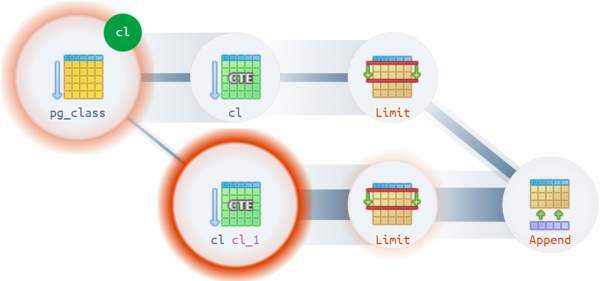
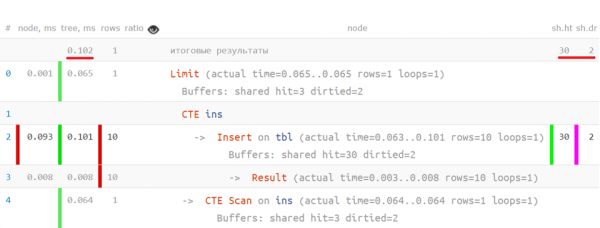
Например, има достатъчно нетривиални ситуации, когато планът може да има повече от един действителен корен:
Структурни подсказки
Ну, а ако цялата структура на плана и неговите слаби места вече са разложени и видими — защо да не ги осветим на разработчика и не обясним „с човешки език“?
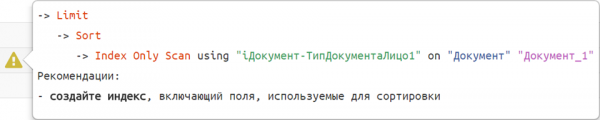 Така че шаблони за препоръки сме събрали вече няколко десетки.
Редовният профайлер на запита
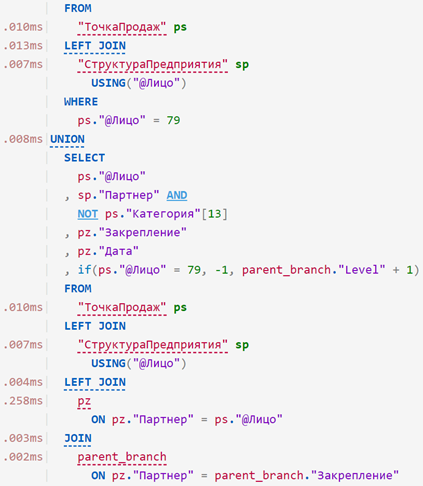
Сега, ако наложим анализирания план върху изходния запит, можем да видим колко време е изразходвано за всеки отделен оператор — приблизително така:
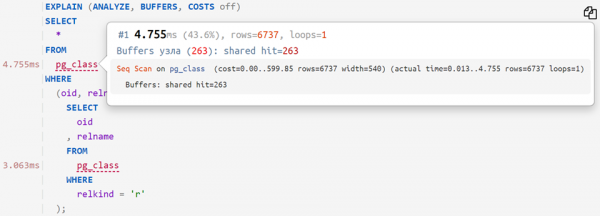
… или дори така:
Замяна на параметрите в запита
Ако сте „прикачили“ към плана не само запита, но и неговите параметри от DETAIL-стринга на лога, можете да го копирате допълнително в един от вариантите:
- с замяна на стойностите в запита
за непосредствено изпълнение на собствената си база и по-нататъшно профилиранеSELECT 'const', 'param'::text; - с замяна на стойностите чрез PREPARE/EXECUTE
за еймулация на работата на планиращия, когато параметричната част може да бъде игнорирана — например, при работа на секционирани таблициDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Архив на плановете
Вмъквайте, анализирайте, споделяйте с колеги! Плановете ще останат в архива и ще можете да се върнете към тях по-късно:
Но ако не искате планът ви да бъде видян от други, не забравяйте да отбележите опцията "не публикувай в архива".
В следващите статии ще говоря за трудностите и решенията, които възникват при анализа на плана.
Източник: habr.com
