

Първият прототип на обектните хранилища светът видя през 1996 година. Десет години по-късно Amazon Web Services ще стартира Amazon S3 и светът ще започне постепенно да полудява от плоското адресно пространство. Благодарение на работата с метаданни и способността си да се мащабира без да забавя производителността, обектните хранилища бързо станаха стандарт за повечето услуги за съхранение на данни в облака и не само. Друга важна характеристика е отличната им пригодност за съхранение на архиви и подобни рядко използвани файлове. Всички, свързани със съхранението на данни, радостно приветстваха новата технология.
Но обществените слухове бяха пълни с предположения, че обектните хранилища са само за големи облаци, а ако не желаете решения от проклетите капиталисти, ще е много трудно да създадете собствено. За разгръщането на собствен облак вече е написано много, но информацията за създаването на така наречените S3-съвместими решения е малко.
Затова днес ще разгледаме какви варианти има „Как при възрастните, а не CEPH и с малко повече усилия“, ще разгръщаме един от тях, а за да проверим дали всичко работи, ще използваме Veeam Backup & Replication. В него е заявена поддръжка на работа с S3-съвместими хранилища и точно това изявление ще проверим.
А какво правят другите?
Предлагам да започнем с малък преглед на пазара и вариантите за обектни хранилища. Общоприетият лидер и стандарт е Amazon S3. Два най-близки преследвачи са Microsoft Azure Blob Storage и IBM Cloud Object Storage.
Наистина ли е всичко? Наистина ли няма други конкуренти? Разбира се, че конкуренти има, но някои следват своя маршрут, като Google Cloud или Oracle Cloud Object Storage, с непълна поддръжка на S3 API. Някои използват стари версии на API, като Baidu Cloud. А някои, като Hitachi Cloud, изискват прилагането на специфична логика, което неизбежно ще доведе до свои трудности. Във всеки случай, всички се сравняват с Amazon, който може да се счита за индустриален стандарт.
В on-premise решенията изборът е значително по-голям, така че нека определим важните критерии за нас. В принципе, достатъчни са само два: поддръжка на S3 API и използване на v4 подписване. Искрено казано, нас като бъдещи клиенти ни интересуват единствено интерфейсите за взаимодействие, а вътрешната структура на самото хранилище не ни вълнува толкова.
Под тези прости условия подхождат много решения. Например, класическите корпоративни тежки решения:
- DellEMC ECS
- NetApp S3 StorageGrid
- Nutanix Buckets
- Pure Storage FlashBlade и StorReduce
- Huawei FusionStorage
Има ниша изцяло софтуерни решения, работещи от кутията:
- Red Hat Ceph
- SUSE Enterprise Storage
- Cloudian
И дори любителите на прецизността след сглобяване не са пренебрегнати:
- CEPH в чист вид
- Minio (Linux версия, защото по Windows версията има много въпроси)
Списъкът далеч не е изчерпателен и може да бъде обсъден в коментарите. Просто не забравяйте да проверите производителността на системата преди внедряване, освен съвместимостта на API. Последното, от което се нуждаете, е загуба на терабайти данни заради закъснели заявки. Не се колебайте да провеждате натоварващи тестове. Всъщност, всякакъв софтуер, работещ с големи обеми данни, има поне отчети за съвместимост. В случая с Veeam има за взаимно тестване, която позволява да заявим с увереност пълната съвместимост на нашите продукти с конкретно оборудване. Това вече е двустранна работа, не винаги бърза, но ние постоянно разширяваме тестуваните решения.
Създаваме нашия стенд
Искам да споделя малко за избора на опитното поле.
Първо, исках да намеря вариант, който веднага да работи от кутията. Или поне с максимална вероятност да заработи без нужда от излишни усилия. Танците с бубно и ровичкането в конзолата през нощта – това е много увлекателно, но понякога искаш да работи веднага. Освен това, общата надеждност на такива решения е обикновено по-висока. Да, в нас изчезна духът на авантюризма, спрахме да вдигаме прозорци на любимите жени и т.н.
На първо място, ако трябва да бъдем честни, необходимостта от работа с обектни хранилища възниква при доста големи компании, така че това е именно случай, в който да се насочите към решения от корпоративен клас не само не е срамно, а дори се насърчава. Във всеки случай, все още не знам примери, на които да са уволнили някого за закупуване на подобни решения.
Въз основа на всичко казано дотук, моят избор падна на Dell EMC ECS Community Edition. Това е много интересен проект и смятам за необходимо да ви разкажа за него.
Първото, което идва наум при появата на добавката Community Edition — че това е просто копие на пълноценния ECS с някакви ограничения, които се премахват с покупката на лиценз. Но не е така!
Запомнете:
!!!Community Edition — това е отделен проект, създаден за тестове, и без техническа поддръжка от страна на Dell!!
И не може да бъде превърнат в пълноценен ECS, дори ако много искате.
Нека да разберем
Мнозина смятат, че Dell EMC ECS — едно от най-добрите решения, ако имате нужда от обектно хранилище. Всички проекти под марката ECS, включително търговски и корпоративни, са на . Това е жест на добра воля от Dell. И освен софтуера, който работи на техните брандови машини, има и опенсорс версия, която може да бъде разгръщана в облака, на виртуална машина, в контейнер или на всяко ваше оборудване. Преди да продължим — има дори OVA версия, с която ще се възползваме.
Самият DELL ECS Community Edition — това е мини вариант на пълноценния софтуер, работещ на брандовите сървъри Dell EMC ECS.
Изведох четири основни разлики:
- Няма поддръжка за криптиране. Обидно е, но не е критично.
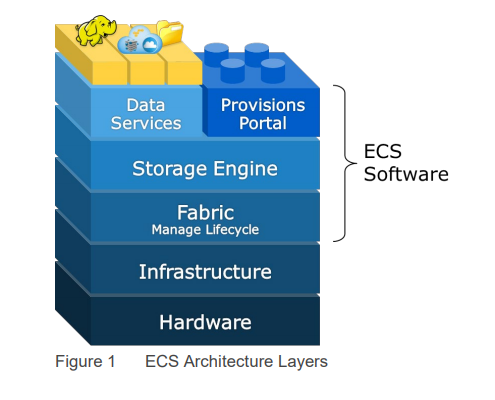
- Отсъства Fabric Layer. Тази функция отговаря за изграждане на клъстери, управление на ресурси, обновления, мониторинг и съхранение на Docker образи. Тук вече е много неудобно, но Dell също може да бъде разбрана.
- Най-неприятното следствие от предишната точка: размерът на нодата не може да бъде разширен след завършване на инсталацията.
- Няма техническа поддръжка. Това е продукт за тестови цели, който не е забранен за употреба в малки инсталации, но да кача петабайти важни данни, лично аз не бих се решил. Но технически никой не може да ви попречи да го направите.
А какво в голямата версия?
Бързо ще преминем през хардуерните решения, за да имаме по-пълна представа за екосистемата.
Не мога да потвърдя или отхвърля твърдението, че DELL ECS е най-доброто on-prem обектно хранилище, но ще се радвам да прочета коментарите ви по темата. Във всеки случай, според версията на Dell EMC уверено влиза в топ 5 на пазара на OBS. Въпреки че cloud-based решенията не се считат, това е отделен разговор.
От техническа гледна точка, ECS е обектно хранилище, осигуряващо достъп до данни чрез облачни хранилищни протоколи. Поддържа AWS S3 и OpenStack Swift. За файлово активни бакети ECS поддържа NFSv3 за експортиране на файлове.
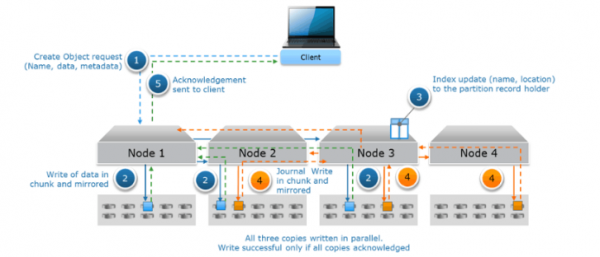
Процесът на запис на информация е доста необичаен, особено в сравнение с класическите системи за блочно съхранение.
- При получаване на нови данни се създава нов обект, който има име, самите данни и метаданни.
- Обектите се разделят на чанкове по 128 MB и всеки чанк се записва едновременно на три ноди.
- Актуализира се файлът с индекс, където са записани идентификаторите и местата за съхранение.
- Актуализира се файлът с логове (лог на записите) и също се записва на три ноди.
- На клиента се изпраща съобщение за успешен запис.
Всички три копия на данните се записват паралелно. Записът се счита за успешен само ако всички три копия са записани успешно.
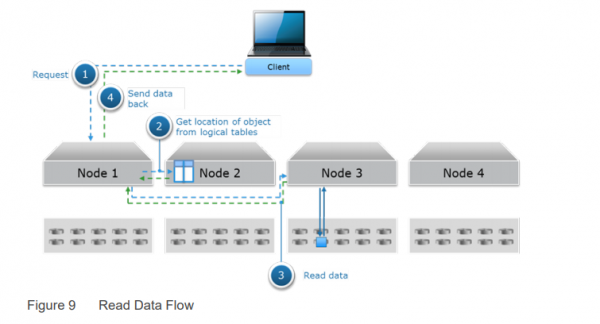
Четенето е по-лесно:
- Клиентът заявява данни.
- В индекса се търси мястото за съхранение на данните.
- Данните се четат от една нода и се изпращат на клиента.
Има доста сървъри, така че нека погледнем най-малкия Dell EMC ECS EX300. Той започва от 60ТB, с възможност да нарасне до 1,5ПB. А по-голямото му братче Dell EMC ECS EX3000 позволява вече да съхранява цели 8,6ПB на стелаж.
Деплой
Технически, Dell ECS CE може да бъде разширен до неограничени размери. Във всеки случай, не намерих явни ограничения. Въпреки това, всичкото мащабиране е удобно да се извършва чрез клониране на първата нода, за която ни трябват:
- 8 vCPU
- 64GB RAM
- 16GB за операционната система
- 1TB директно за съхранение
- Последния релиз на CentOS minimal
Това е опция за случая, когато искате да инсталирате всичко сами от самото начало. За нас тази опция не е актуална, тъй като ще използвам OVA образ за деплой.
Но в какъвто и случай, изискванията са доста сериозни дори за една нода, а ако стриктно следваме буквалния смисъл, такива ноди трябва да са четири.
Разработчиците на ECS CE живеят в реалния свят, и инсталацията преминава успешно дори с една нода, а минималните изисквания са:
- 4 vCPU
- 16 GB RAM
- 16 GB за операционната система
- 104 GB само хранилище
Точно такива ресурси са необходими за разгръщане на OVA образа. Вече е значително по-уместно и реалистично.
Самата инсталационна нода може да се вземе от официалния . Там също има подробна документация за деплойване на всичко в едно, но можете да прочетете и на официалния . Затова няма да се спираме подробно на разгръщането на OVA, там без трикове. Най-важното — не забравяйте преди стартирането да увеличите диска до необходимия обем или да свържете необходимите.
Стартираме машината, отваряме конзолата и използваме най-добрите креденциални данни по подразбиране:
- логин: admin
- парола: ChangeMe
След това пускаме sudo nmtui и настройваме мрежовия интерфейс — IP/маска, DNS и гейт. Имайте предвид, че в CentOS minimal няма net-tools, проверяваме настройките чрез ip addr.
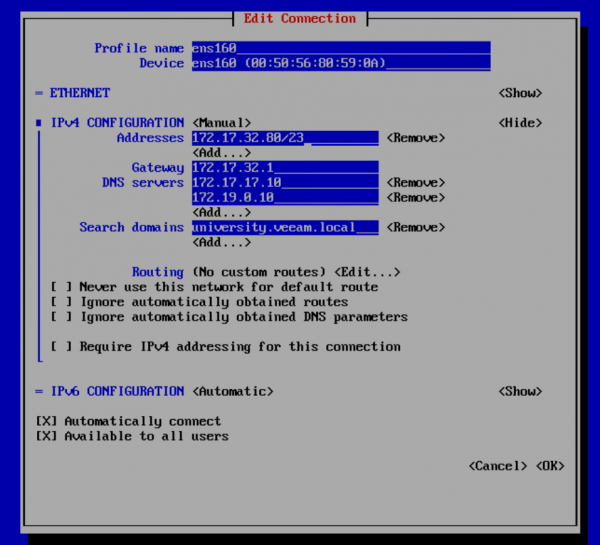
И понеже само смелите завладяват моретата, правим yum update, след което reboot. Всъщност това е доста безопасно, тъй като цялото разгръщане се прави чрез плейбуци, а всички важни пакети на Docker са заключени на текущата версия.
Сега е време да редактираме инсталационния скрипт. Никакви красиви прозорци или псевдо UI — всичко през любимия ви текстов редактор. Чисто технически има два начина: можете да стартирате всяка команда ръчно или веднага да стартирате конфигуратора videploy. Той просто ще отвори конфигурацията в vim и при изход ще стартира проверката. Но съзнателното опростяване на живота не е интересно, така че ще изпълним две команди повече. Въпреки че в това няма никакъв смисъл, предупредих ви =)
И така, правим vim ECS-CommunityEdition/deploy.xml и внасяме оптимално-минимални промени, за да се включи и работи ECS. Списъкът с параметри може да бъде съкратен, но направих нещата така:
- licensed_accepted: true Може и да не се променя, тогава при деплой ще бъдете изрично помолени да го приемете и ще ви покажат сладка фраза. Възможно е дори да е такава пасхалка.

- Разкоментирайте редовете autonames: и custom: Въведете поне едно желано име за нода — hostname ще бъде заменен с него в процеса на инсталация.
- install_node: 192.168.1.1 Посочете реалния IP адрес на нода. В нашия случай посочваме същия, който е в nmtui
- dns_domain: въвеждаме своя домейн.
- dns_servers: вписваме своя dns.
- ntp_servers: може да се укаже произволен. Аз избрах първия, който намерих от пул 0.pool.ntp.org (което стана 91.216.168.42)
- autonaming: custom Ако не коментирате, луната ще се нарече Luna.
- ecs_block_devices:
/dev/sdb
По неизвестна причина тук може да се окаже несъществуващо устройство за блоково съхранение /dev/vda - storage_pools:
members:
192.168.1.1 Тук отново указваме реалния IP на нодата - ecs_block_devices:
/dev/sdb Повторяем операцию вырезания несуществующих устройств.

Всъщност целият файл е много подробно описан в , но кой ли ще го чете в такова бурно време. Там е написано, че минимално достатъчно е да се укажат IP и маска, но при мен в лабораторията този набор не се установяваше добре, и ми се наложи да го разширя до посоченото по-горе.
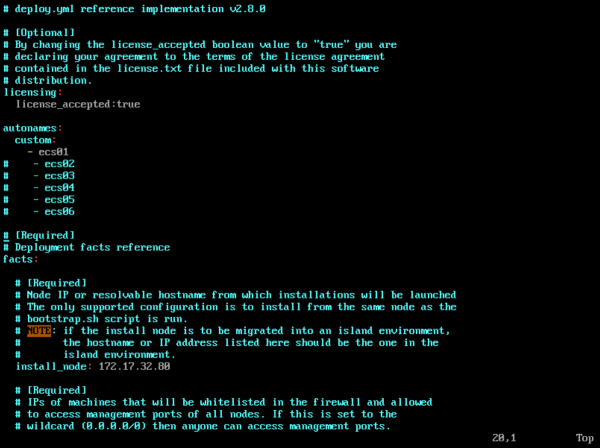
След излизане от редактора, трябва да стартирате update_deploy /home/admin/ECS-CommunityEdition/deploy.yml, и ако всичко е направено правилно, за това ще бъде съобщено явно.
След това все пак ще трябва да стартирате videploy, да изчакате обновлението на околната среда, и можете да стартирате инсталацията с командата ova-step1, а след успешното й изпълнение командата ova-step2. Важно: не спирайте работата на скриптовете с ръка! Някои стъпки могат да отнемат значително време, да се изпълняват не от първия опит и да изглеждат така, сякаш всичко е развалено. Във всеки случай трябва да изчакате завършването на скрипта по естествен начин. В края ще трябва да видите нещо подобно.
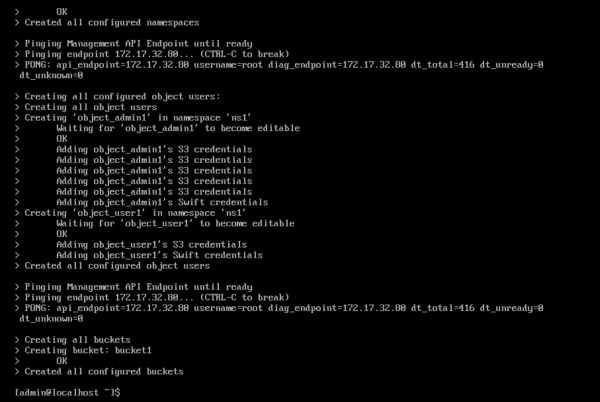
Сега най-накрая можем да отворим WebUI контролния панел на известния ни IP. Ако не сте променяли по време на конфигурацията, то подразбиращата се учетна запись ще бъде root/ChangeMe. Можете дори веднага да ползвате нашето S3-совместимо хранилище. То е достъпно на портове 9020 за HTTP и 9021 за HTTPS. Отново, ако нищо не е променяно, то access_key: object_admin1 и secret_key: ChangeMeChangeMeChangeMeChangeMeChangeMe.
Но да не бързаме и да започнем по ред.
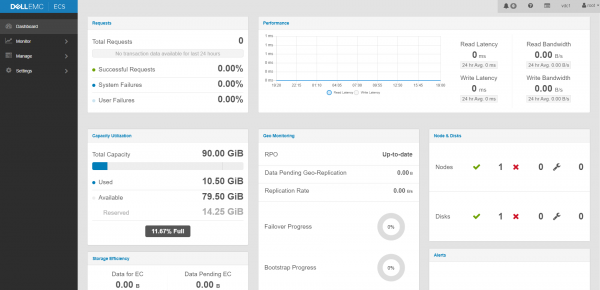
При първото влизане ще бъдете задължени да смените паролата на адекватна, което е абсолютно правилно. Главното табло е изключително разбираемо, затова нека направим нещо по-интересно от обясняването на очевидните метрики. Например, да създадем потребител, който ще използваме за достъп до хранилището. В света на сервис-провайдерите такива наричат тенант. Това става в Manage > Users > New Object User
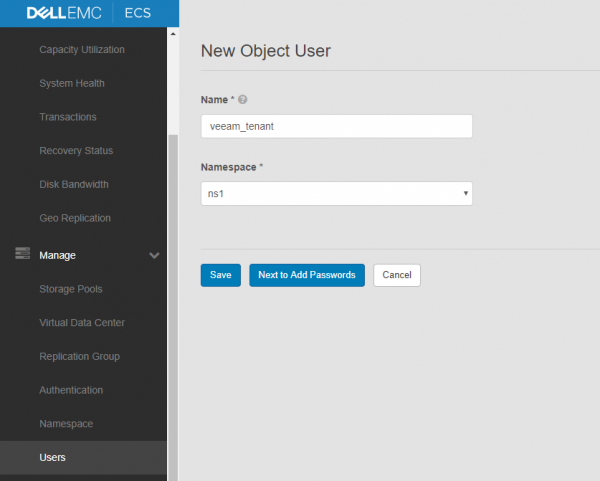
При създаването на потребител ни искат да укажем namespace. Технически, нищо не ни пречи да създадем толкова, колкото ще има потребители. И обратно. Това позволява управление на ресурсите независимо за всеки тенант.
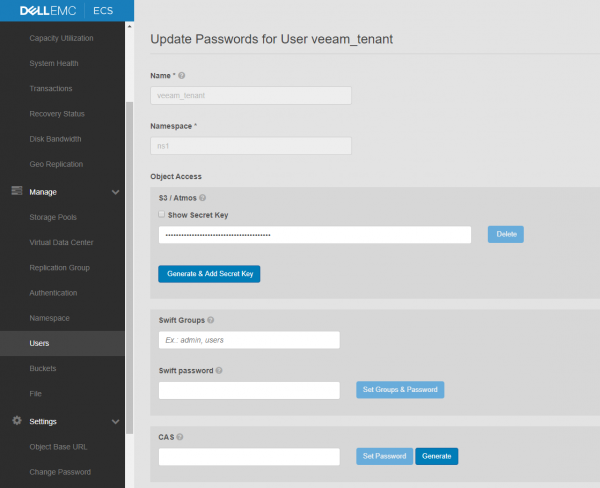
Съответно, избираме нужните ни функции и генерираме потребителски ключове. За мен S3/Atmos е достатъчно. И не забравяйте да запазите ключа 😉
Потребителят е създаден, време е да му отделим и багажник. Преминаваме в Manage > Bucket и попълваме необходимите полета. Тук всичко е просто.
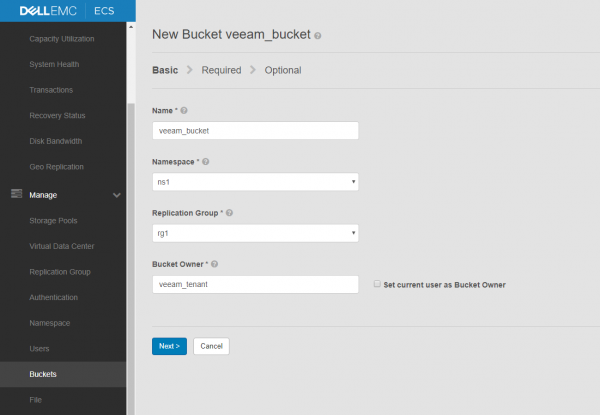
Сега всичко е готово за напълно бойно използване на нашето S3 хранилище.
Настройваме Veeam
Така, както знаем, едно от основните приложения на обектните хранилища е дългосрочното съхранение на информация, която рядко се използва. Идеалният пример е необходимостта от съхранение на резервни копия на отдалечена площадка. В Veeam Backup & Replication тази функция се нарича Capacity Tier.
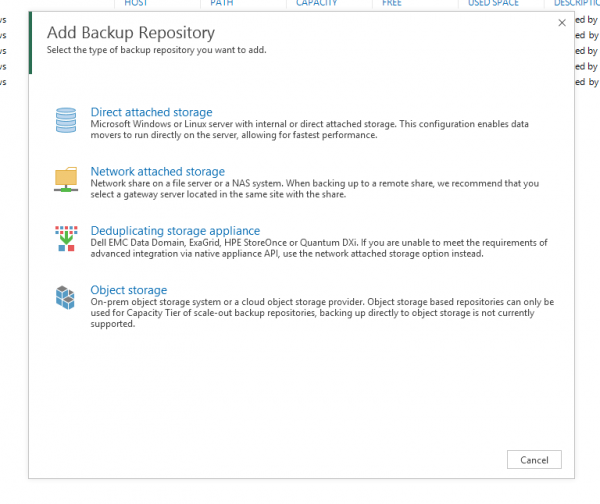
Започваме настройката с добавяне на нашия Dell ECS CE в интерфейса на Veeam. На вкладката Backup Infrastructure стартираме магистралата за добавяне на нов хранилище и избираме опцията Object Storage.
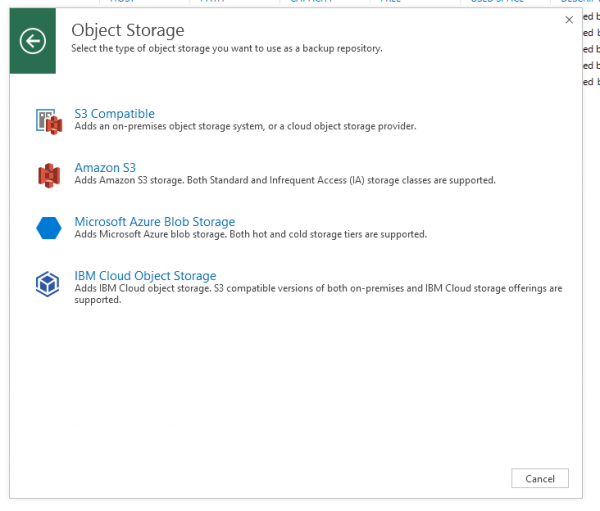
Избираме това, за което всичко е подготвено — S3 Compatible.
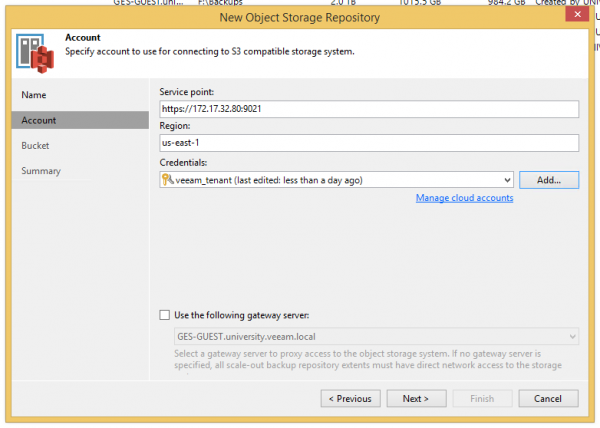
В появилото се прозорче пишем желаното име и преминаваме на стъпка Account. Тук трябва да посочим Service point под формата на , регионът може да остане непроменен и да добавим създадения потребител. Гейт-сървър е необходим, ако вашето хранилище се намира на отдалечена площадка, но това вече е темата на оптимизацията на инфраструктурата и отделна статия, така че тук спокойно можем да пропуснем.
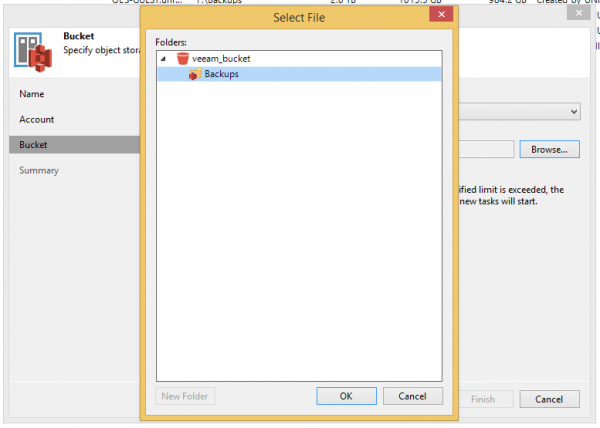
Ако всичко е посочено и настроено правилно, ще изскочи предупреждение за сертификата и след това прозорец с багажника, където можем да създадем папка за нашите файлове.
Преминаваме през визарда до края и се наслаждаваме на резултата.
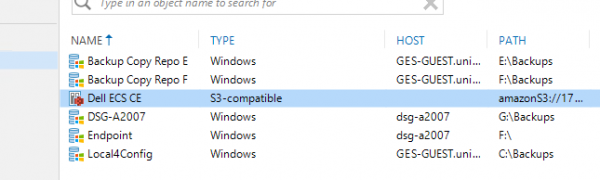
На следващата стъпка трябва или да създадем нов Scale-out Backup Repository, или да добавим нашето S3 към съществуващото — то ще бъде използвано като Capacity Tier за архивно съхранение. В текущото издание няма функции за директно използване на S3-съвместими хранилища като обикновено хранилище. Трябва да се решат твърде много неочевидни проблеми за това, но всичко е възможно.
Влизаме в настройките на хранилището и активираме Capacity Tier. Там всичко е прозрачно, но има интересен нюанс: ако искате всички данни да бъдат изпратени на обектното хранилище в най-кратки срокове, просто задайте 0 дни.
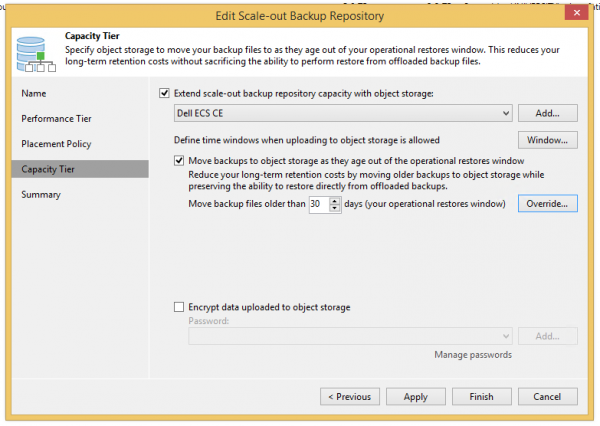
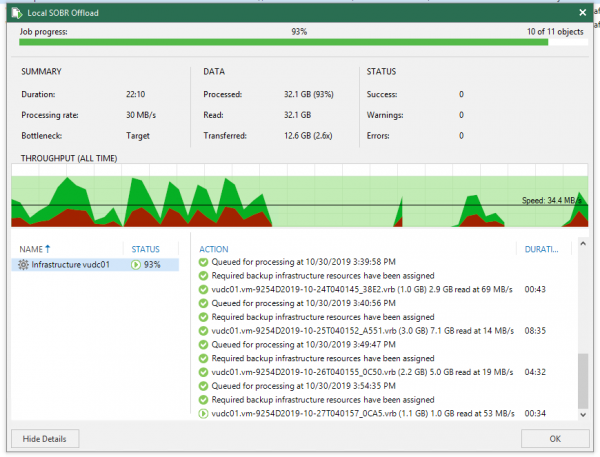
След преминаването на визарда, ако не искате да чакате, можете да натиснете ctrl+ПКМ върху хранилището, да стартирате принудително зададената задача Tiering и да наблюдавате как графиките започват да се движат.
С това засега е всичко. Считам, че се справих с задачата да покажа, че блочните хранилища не са толкова страшни, колкото се смята. Да, решенията и вариантите са множество, но в една статия не може да се обхванат всички. Затова да споделяме опит в коментарите.
Източник: habr.com
