

Разработването на хранилища е дълъг и сериозен процес.
Много зависи от това колко добре е планирана обектната модел и структурата на базата данни от самото начало.
Общопризнатият подход продължава да включва различни варианти на комбиниране на схемата „звезда“ с третата нормална форма. Обикновено следва принципа: изходни данни - 3NF, витрини - звезда. Този подход, доказан с времето и подкрепен от множеството изследвания, е първото (а понякога и единственото), което идва на ума на опитен DWH специалист, когато мисли за това как трябва да изглежда аналитичното хранилище.
От друга страна, бизнесът като цяло и изискванията на клиента в частност бързо се променят, а данните нарастват както „в дълбочина“, така и „в ширина“. И тук се проявява основният недостатък на звезда - ограниченост. гъвкавост.
И ако в тихия и комфортен живот на DWH разработчика внезапно:
- възникне задача „да се направи нещо бързо, а после ще видим“;
- появи се бързо развиващ се проект, с подключвания на нови източници и преработка на бизнес модела минимум веднъж седмично;
- появи се клиент, който не знае как трябва да изглежда системата и какви функции трябва да изпълнява в крайна сметка, но е готов за експерименти и последователно уточняване на желаните резултати с постепенно приближение към тях;
- зададе въпроса проектен мениджър с радостна новина: “А сега имаме аджайл!”.
Или ако просто се интересувате как иначе може да се изградят хранилища - добре дошли под кат!
Какво означава „гъвкавост“
За начало нека да определим какви свойства трябва да притежава системата, за да я наречем „гъвкава“.
Отделно трябва да се уточни, че описаните свойства трябва да се отнасят именно към система, а не към процеса на нейното разработване. Затова, ако сте искали да прочетете за Agile като методология за разработка, е по-добре да се запознаете с други статии. Например, тук, на Хабра, има много интересни материали (както и , така и ).
Това не означава, че процесът на разработка и структурата на хранилището изобщо не са свързани. Всъщност, разработването на хранилище с гъвкава архитектура по Agile принципите трябва да бъде значително по-лесно. В практиката обаче по-често се срещат варианти на разработка по Agile на класическото DWH по Кимбал и DataVault — по водопадния метод, отколкото щастливи съвпадения на гъвкавост в двете й форми на един проект.
И така, какви възможности трябва да притежава гъвкавото хранилище? Можем да обозначим три основни пункта:
- Ранно предоставяне и бързо доработване — това означава, че в идеалния случай първият бизнес резултат (например, първите работещи отчети) трябва да бъде получен възможно най-рано, т.е. още преди да е проектирана и внедрена напълно системата. Освен това всяка следваща доработка също трябва да отнема колкото се може по-малко време.
- Итеративно доработване — това означава, че всяка следваща доработка в идеалния случай не трябва да засяга вече работещата функционалност. Именно този момент често става най-голямото предизвикателство в големи проекти — рано или късно отделните обекти започват да натрупват толкова много зависимости, че става по-лесно да се повтори логиката в копие до тях, отколкото да се добави поле в съществуваща таблица. И ако ви учудва, че анализът на влиянието на доработките върху съществуващите обекти може да отнема повече време, отколкото самата доработка — вероятно все още не сте работили с големи хранилища в банковия сектор или телекома.
- Постоянна адаптация към променящите се изисквания на бизнеса — общата обектна структура трябва да бъде проектирана не само с оглед на възможното разширение, а с разчет, че посоката на това разширение не би могла дори да ви се е сънувала в етапа на проектиране.
И да, съответствието на всички тези изисквания в една система е възможно (разбира се, в определени случаи и с някои уговорки).
По-долу ще разгледам две от най-популярните методологии за гъвкаво проектиране на хранилища — Anchor model и Data Vault. Оставени встрани, таки прекрасни приеми, как например EAV, 6NF(в чистом виде) и всичко, свързано с решения на NoSQL — не защото са по-лоши, и дори не защото в този случай статията щеше да придобие обема на средностатистическа дисертация. Просто всичко това принадлежи на решения от малко друг клас — или на техники, които можете да прилагате в специфични случаи, независимо от общата архитектура на проекта ви (както EAV), или на съвсем различни парадигми за съхранение на информация (като, например, графови бази данни и други варианти на NoSQL).
Проблеми на “класическия” подход и техните решения в гъвкавите методологии
Под “класическия” подход разбирам старата добра звезда (независимо от конкретната реализация на долните слоеве, да ми простят привържениците на Кимбол, Инмон и CDM).
1. Строга кардиналност на връзките
В основата на такъв модел стои ясно разделение на данните на измерения (Dimension) и факти (Fact). И това е, по дяволите, логично — защото анализът на данните в преобладаващото мнозинство случаи се свежда именно до анализа на определени числови показатели (факти) в определени разрези (измерения).
При това връзките между обектите се определят като връзки между таблици по външен ключ. Това изглежда напълно естествено, но веднага води до първото ограничение на гъвкавостта — строго определяне на кардиналността на връзките.
Тоест, на етапа на проектиране на таблиците вие трябва точно да определите за всяка двойка свързани обекти, могат ли да бъдат много към много, или само 1 към много, и “в коя посока”. От това директно зависи в коя от таблиците ще бъде първичният ключ, а в коя — външният. Промяната на това отношение при получаване на нови изисквания с голяма вероятност ще доведе до преработка на базата.
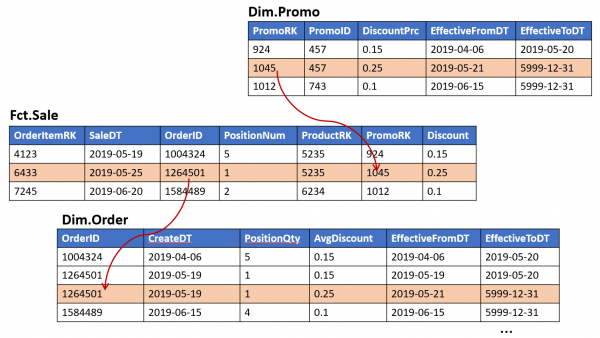
Например, проектирайки обект “касова бележка” вие, основавайки се на пълни заверения от отдела за продажби, сте заложили възможността за действие на една промо-акция върху няколко чекови позиции (но не и обратно):
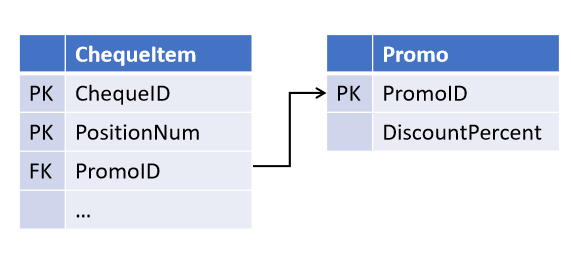
А след известно време, колегите въведоха нова маркетингова стратегия, при която на една и съща позиция могат да действат няколко промо-акции едновременно. И сега трябва да доразработите таблиците, отделяйки връзката в отделен обект.
(Всички производни обекти, в които се извършва джойн чека на промо, вече също се нуждаят от доработка).
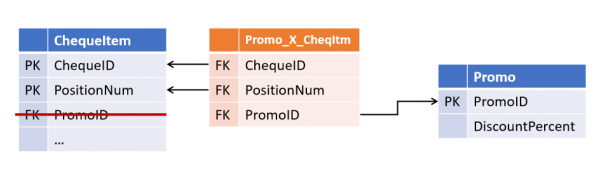
Връзки в Data Vault и Якорен модел
Избягването на такава ситуация се оказа доста просто: не трябва да се вярва на отдела за продажби, за това е достатъчно всички връзки първоначално да се съхраняват в отделни таблици и да се обработват като много-към-много.
Такъв подход беше предложен от Дэн Линстедт като част от парадигмата Data Vault и напълно подкрепен от Ларс Рённбэк в Якорен модел.
В крайна сметка получаваме първата отличителна черта на гъвкавите методики:
Връзките между обектите не се съхраняват в атрибутите на родителските същности, а представляват отделен тип обекти.
В Data Vault такива таблици-връзки се наричат Link, а в Якорен модел — Tie. На пръв поглед те са много сходни, въпреки че различията им не се изчерпват само със самото название (за което ще стане дума по-долу). В двете архитектури таблиците-връзки могат да свързват всякакво количество същности (не задължително 2).
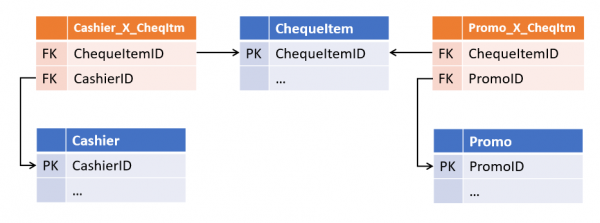
Тази на пръв поглед излишност дава съществена гъвкавост при доработките. Такава структура става толерантна не само към промяната на кардиналностите на съществуващите връзки, но и към добавянето на нови — ако сега на чековата позиция се добави и връзка към касиер, който я е пробил, появата на такава връзка ще бъде просто надстройка над съществуващите таблици без влияние върху каквито и да било съществуващи обекти и процеси.
2. Дублиране на данни
Втората проблема, решавана от гъвкавите архитектури, е по-малко очевидна и е свойствена първо на измеренията от тип SCD2 (бавно променящи се измерения от втори тип), въпреки че не само на тях.
В класическото хранилище измерението обикновено представлява таблица, която съдържа сурогатен ключ (като PK) и набор от бизнес-ключове и атрибути в отделни колони.
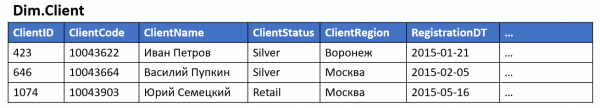
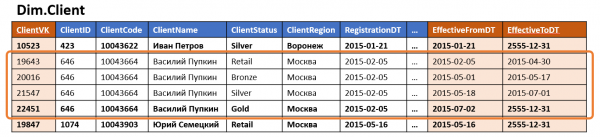
Ако измерението поддържа версияност, към стандартния набор полета се добавят граници на времето на действие на версията, а на един ред в източника се появяват няколко версии в хранилището (по една за всяка промяна на версионните атрибути).
Ако измерението съдържа поне една често променяща се версия на атрибута, броят на версиите на това измерение ще бъде значителен (дори ако останалите атрибути не са версионни или никога не се променят), а ако има няколко такива атрибута — броят на версиите може да нарасне в геометрична прогресия с броя им. Такова измерение може да заема значителен обем дисково пространство, въпреки че голяма част от съхраняваните в него данни са просто дубли на стойности на неизменяеми атрибути от други редове.
При това много често се прилага и денормализация — част от атрибутите умишлено се съхраняват под формата на стойност, а не като препратки към справочник или друго измерение. Този подход ускорява достъпа до данни, намалявайки броя на джойн при достъп до измерението.
Обикновено това води до същата информация се съхранява едновременно на няколко места. Например, информация за региона на пребиваване и принадлежността към категорията клиент може да се съхранява едновременно в измеренията „Клиент“ и фактите „Покупка“, „Доставка“ и „Обаждания в кол-център“, а също така и в таблицата връзка „Клиент — Клиентски мениджър“.
Като цяло описаното по-горе се отнася и за обикновените (неверсионни) измерения, но при версионните може да има различен мащаб: появата на нова версия на обект (особено с обратно действие) води не просто до актуализиране на всички свързани таблици, а до каскадно появяване на нови версии на свързаните обекти — когато Таблица 1 се използва при изграждането на Таблица 2, а Таблица 2 — при изграждането на Таблица 3 и т.н. Дори ако нито един атрибут на Таблица 1 не участва в изграждането на Таблица 3 (а участват други атрибути на Таблица 2, получени от други източници), версионното актуализиране на тази конструкция най-малкото ще доведе до допълнителни разходи, а в максимален случай — до излишни версии в Таблица 3, която тук изобщо не е „по темата“ и нататък по веригата.
3. Нелинейна сложност на доработката
При това всяка нова витрина, изградена на основата на друга, увеличава броя на местата, в които данните могат да „разминат“ при извършване на промени в ETL. Това, от своя страна, води до нарастване на сложността (и продължителността) на всяка следваща доработка.
Ако описаното по-горе се отнася за системи с ETL процеси, които рядко се доработват, животът в такова пространство е възможен — достатъчно е просто да следите новите изменения да се внасят коректно във всички свързани обекти. Обаче, ако доработките се случват често, вероятността случайно да “пропуснете” няколко връзки значително нараства.
Ако вземем предвид, че “версионният” ETL е значително по-сложен от “невърсионния”, избягването на грешки при чести доработки на всичко това става доста сложно.
Съхранение на обекти и атрибути в Data Vault и Anchor Model
Подходът, предлаган от авторите на гъвкавите архитектури, може да се формулира така:
Необходимо е да се отдели това, което се променя, от това, което остава непроменено. Т.е. да се съхраняват ключовете отделно от атрибутите.
При това не бива да се бърка невърсионен атрибут с непроменим: първият не съхранява историята на своите промени, но може да се променя (например, при коригиране на грешка при въвеждане или получаване на нови данни), вторият — никога не се променя.
Мненията относно това, какво точно може да се счита за непроменимо в Data Vault и Якорната модел, се различават.
От гледна точка на архитектурата Data Vault, непроменимото може да се счита всеки набор от ключове — естествени (ЕИК на организацията, код на стоката в източника и т.н.) и сурогатни. При това останалите атрибути могат да бъдат разделени по групи в зависимост от източника и/или честотата на промяна и за всяка група да се води отделна таблица с независим набор от версии.
В парадигмата на Anchor Model непроменимо се счита само сурогатният ключ на ентитета. Всички останали (включително естествените ключове) — просто частен случай на неговите атрибути. При това всички атрибути по подразбиране са независими един от друг, следователно за всеки атрибут трябва да се създаде отделна таблица.
В Data Vault таблиците, съдържащи ключовете на ентитетите, се наричат Хъбове (Hub). Хъбовете винаги съдържат фиксиран набор от полета:
- Естествени ключове на ентитета
- Сурогатен ключ
- Ссылка на източника
- Време на добавяне на записа
Записите в Хъбовете никога не се променят и нямат версии. Външните хъбове много приличат на таблици от тип ID-map, използвани в някои системи за генериране на сурогати, но за сурогати в Data Vault се препоръчва да се използва не цели числови последователности, а хеш на набор от бизнес ключове. Този подход опростява зареждането на връзки и атрибути от източници (не е необходимо да се присъединявате на хъба за получаване на сурогат, просто е достатъчно да се пресметне хеш на естествения ключ), но може да предизвика други проблеми (свързани, например, с колизии, регистър и непечатни символи в стрингови ключове и т.н.), поради което не е общоприет.
Всички останали атрибути на сущностите се съхраняват в специализирани таблици, наречени Сателити (Satellit). Един хъб може да има няколко сателита, които съхраняват различни набори от атрибути.
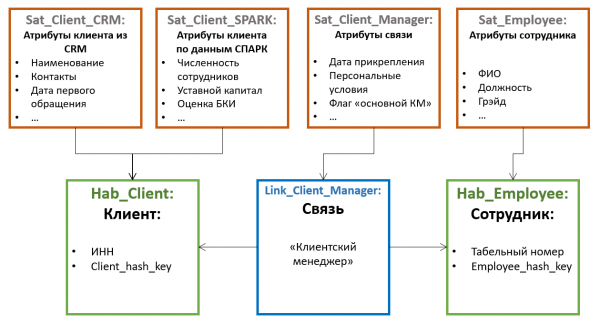
Разпределението на атрибутите по сателитите се извършва по принципа на съвместната промяна — в един сателит могат да се съхраняват невариращи атрибути (например, дата на раждане и СНИЛС за физическо лице), в друг — рядко променящи се вариращи (например, фамилия и номер на паспорт), в трети — често променящи се (например, адрес за доставка, категория, дата на последната поръчка и т.н.). Вариантността се води на ниво индивидуални сателити, а не на самата сущност, затова разпределението на атрибутите е целесъобразно да се извършва така, че пресечението на версиите в един сателит да бъде минимално (което намалява общия брой съхранявани версии).
Също така, за оптимизация на процеса на зареждане на данни, в отделни сателити често се извеждат атрибутите, получени от различни източници.
Сателитите са свързани с Хъба по външен ключ (което отговаря на кардиналността 1-ко-много). Това означава, че множествените стойности на атрибутите (например, няколко контактни телефонни номера на един клиент) се поддържат от тази архитектура „по подразбиране“.
В Якорна модел (Anchor Model) таблиците, които съхраняват ключовете, се наричат Якоря (Anchor). И те съхраняват:
- Само сурогатни ключове
- Ссылка на източника
- Време на добавяне на записа
Натуралните ключове от гледна точка на Якорната Модель се считат за обикновени атрибути. Такъв вариант може да изглежда по-сложен за разбиране, но предоставя много повече пространство за идентификация на обекта.
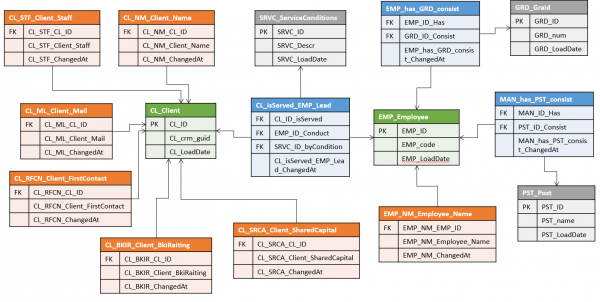
Например, ако данните за една и съща единица могат да постъпват от различни системи, в които се използва собствен естествен ключ. В Data Vault това може да доведе до доста обемисти конструкции от няколко хъба (по един за източник + обединяваща мастер-версия), докато в Якорната модел естественият ключ на всеки източник попада в своя атрибут и може да се използва при зареждане независимо от всички останали.
Но тук се крие един коварен момент: ако в една единица се обединяват атрибути от различни системи, вероятно съществуват някои правила за „свързване“, по които системата трябва да разбира, че записи от различни източници съответстват на един единствен екземпляр на единицата.
В Data Vault Тези правила вероятно ще определят формирането на „сурогатен хъб“ на мастер-единицата и никога няма да влияят на Хъбовете, които съ хранят естествените ключове на източниците и техните оригинални атрибути. Ако в даден момент правилата за свързване се променят (или идва обновление на атрибутите, по които тя се извършва), достатъчно ще е да се преформира сурогатните хъбове.
В В Якорната модел такава единица вероятно ще се съхранява в единствен якор. Това означава, че всички атрибути, независимо от това, от кой източник са получени, ще бъдат свързани с един и същ сурогат. Разделянето на грешно свързани записи и проследяването на актуалността на свързването в такава система може да се окаже значително по-трудно, особено ако правилата са достатъчно сложни и често се променят, а един и същ атрибут може да бъде получен от различни източници (макар че е точно възможно, тъй като всяка версия на атрибута запазва връзка с своя източник).
Във всеки случай, ако в системата ви се предвижда реализирането на функционалност за дедупликация, сливане на записи и други елементи на MDM, е особено важно да се запознаете с аспектите на съхранение на естествените ключове в гъвкави методологии. Вероятно, по-обемистата конструкция на Data Vault изведнъж ще се окаже по-сигурна от гледна точка на грешки при сливането.
Якорната модел също така предвижда допълнителен тип обект, наречен Узел (Knot) , по същество това е специален изроден вид якор, който може да съдържа само един атрибут. Възлите се предполага да се използват за съхранение на плоски справочници (например пол, семейно положение, категория обслужване на клиенти и т.н.). За разлика от Якоря, Възел няма свързани таблици с атрибути, а единственият му атрибут (име) винаги се съхранява в една таблица с ключ. Възлите се свързват с Якорите чрез таблици-свързвания (Tie), по същия начин, по който Якорите се свързват помежду си.
Няма еднозначно мнение относно използването на Възлите. Например, , активно промотиращ приложението на Якорната модел в Русия, счита (небезоснователно), че за никой справочник не може да се твърди със сигурност, че той винаги ще бъде статичен и едноуровнев, поради което за всички обекти е най-добре веднага да се използва пълноценен Якор.
Още едно важно различие между Data Vault и Якорната модел е наличието на атрибути при връзките.:
В Data Vault Връзките са напълно функционални обекти, подобно на Хабовете, и могат да имат собствени атрибути.. В В Якорната модел Връзките се използват само за свързване на Якорите и не могат да имат собствени атрибути.. Това различие води до съществени различия в подходите към моделирането на фактите,, за които ще се говори по-късно.
Съхранение на фактите
До сега говорихме основно за моделиране на измерения. С фактите ситуацията е малко по-малко ясна.
В Data Vault типичен обект за съхранение на факти — Връзка (Link),, в Сателитите на която се събират реални показатели.
Такава подход изглежда интуитивно разбираем. Той дава лесен достъп до анализираните показатели и по своему е подобен на традиционната таблица с факти (като единственото е, че показателите не се съхраняват в самата таблица, а в “съседна”). Но има и подводни камъни: едно от типичните доработки на модела — разширение на ключа на факта — води до необходимостта да се добави нов външен ключ в Link.. А това от своя страна “разрушава” модулността и потенциално води до необходимост от доработки на други обекти.
В В Якорната модел Връзката не може да има собствени атрибути, поради което такъв подход не е приложим — абсолютно всички атрибути и показатели трябва да бъдат свързани с един конкретен Якор. Изводът е прост — за всеки факт също е нужен свой Якор.. За част от това, което сме свикнали да възприемаме като факти, може да изглежда естествено — например, фактът на покупка лесно се свързва с обекта “поръчка” или “касова бележка”, посещението на сайт — с сесия и т.н. Но съществуват и факти, за които е по-трудно да се намери такъв естествен “обект-поддръжка” — например, остатъците от стоките в складовете в началото на всеки ден.
Съответно, проблеми с модулността при разширяването на ключа на факта в Якорен модел не възникват (достатъчно е просто да добавите нова Връзка към съответния Якор), но проектирането на модела за визуализиране на фактите е по-малко ясно и могат да се появят “изкуствени” Якоря, които се отразяват на бизнес обектната структура неочевидно.
Как се постига гъвкавост
Получената конструкция в двата случая съдържа значително повече таблици, отколкото традиционно измерение. Но може да заема значително по-малко дисково пространство при същия набор от версионни атрибути, каквито има и в традиционното измерение. Никаква магия тук, естествено, няма — всичко е въпрос на нормализация. Разпределяйки атрибутите по Сателити (в Data Vault) или по отделни таблици (Якорен модел), ние намаляваме (или напълно елиминираме) дублиране на стойности на одни атрибути, при промяна на други.
За Data Vault получаването на печалба ще зависи от разпределението на атрибутите по Сателитите, а за В Якорната модел — практически е в пряка пропорционалност на средния брой версии на обекта на измерение.
Обаче печалбата по заетото място — важно, но не и основно предимство на отделното съхранение на атрибутите. Заедно с отделното съхранение на връзките, този подход превръща хранилището в модулна конструкция. Това означава, че добавянето както на отделни атрибути, така и на цели нови предметни области в такъв модел изглежда като надстройка върху съществуваща група обекти без тяхната промяна. И точно това прави описаните методологии гъвкави.
Също така напомня на прехода от индивидуално производство към масово — ако в традиционния подход всяка таблица на модела е уникална и изисква индивидуално внимание, то в гъвкавите методологии — това вече е набор от стандартни “детайли”. От една страна, таблиците стават повече, процесите на зареждане и извличане на данни трябва да изглеждат по-сложни. От друга страна — те стават стандартни. А значи, могат да бъдат автоматизирани и управлявани метаданни. Въпросът „как ще подреждаме?”, на който отговорът можеше да заема значителна част от проектантската работа по подобрения, сега просто не съществува (както и въпросът за влиянието на промяната на модела върху работещите процеси).
Това не значи, чеanalytikerите в такава система съвсем не са необходими — все още някой трябва да обработи набор от обекти с атрибути и да разбере откъде и как всичко това да се зарежда. Но обемът на работата, както и вероятността и цената на грешките, значително намаляват. Как на етапа на анализа, така и при разработката на ETL, която в значителна част може да се състои в редактиране на метаданни.
Тъмната страна
Всичко по-горе прави и двата подхода наистина гъвкави, технологични и пригодни за итеративно доразвиване. Разбира се, има и „бочка с дегтя“, за която, мисля, вече подозирате.
Декомпозицията на данни, лежаща в основата на модулността на гъвкавите архитектури, води до увеличаване на броя на таблиците и съответно разходите по джойн при извличане. За да получите просто всички атрибути на измеренията, в класическото хранилище е достатъчен един селект, докато гъвкавата архитектура ще изисква редица джойнове. Въпреки че за отчетите всичките тези джойнове могат да бъдат написани предварително, аналитиците, свикнали да пишат SQL на ръка, ще страдат двойно.
Има няколко факта, които облекчават такова положение:
При работа с големи измерения почти никога не се използват едновременно всички атрибути. Това значи, че джойновете могат да бъдат по-малко, отколкото изглежда при първия поглед на модела. В Data Vault също така може да се вземе предвид предполагаемата честота на съвместно използване при разпределението на атрибутите по сателити. В същото време самите Хъбове или Якорите са нужни преди всичко за генериране и мапинг на сурогатите на етапа на зареждане и рядко се използват в запитвания (особено това важи за Якорите).
Всички джойнве — по ключ. Освен това, по-компактният начин на съхранение на данни намалява разходите за сканиране на таблици, когато е необходимо (например при филтриране по стойност на атрибута). Това може да доведе до ситуация, в която извличането от нормализирана база с много joins е дори по-бързо, отколкото сканирането на едно тежко измерение с много версии на ред.
Например, ето в статията има подробен сравнителен тест на производителността на Якорната модел с извлечение от една таблица.
Много зависи от двигателя. Много съвременни платформи разполагат с вътрешни механизми за оптимизация на joins. Например, MS SQL и Oracle могат да "пропускат" joins към таблици, ако данните им не се използват никъде, освен в други joins и не влияят на крайното извлечение (table/join elimination), а MPP Vertica по , се е показала като отличен двигател за Якорната модел, като се има предвид известна ръчна оптимизация на плана за запитвания. От друга страна, съхраняването на Якорната модел, например, на Click House, който има ограничена поддръжка на join, все още изглежда не много добра идея.
Освен това, за двете архитектури съществуват специални техники, улесняващи достъпа до данните (както от гледна точка на производителността на запитванията, така и за крайните потребители). Например, Point-In-Time таблици в Data Vault или специални таблици функции в Якорната модел.
Общо
Основната същност на разглежданите гъвкави архитектури се състои в модулността на тяхната "конструкция".
Точно това свойство позволява:
- След известна начална подготовка, свързана с разгръщане на метаданни и писане на основни алгоритми за ETL, бързо да се предостави на клиента първият резултат под формата на няколко отчета, съдържащи данни от само няколко обекта източници. Не е необходимо напълно да се замисля (дори на високо ниво) за цялата обектна модель за това.
- Моделът на данни може да започне да работи (и да носи полза) само с 2-3 обекта, а след това да расте постепенно (относно Якорната модел, Николай красиво сравнение с гъбницата).
- Повечето доработки, включително разширение на предметната област и добавяне на нови източници не засягат съществуващата функционалност и не предизвикват опасност от счупване на вече работещо нещо..
- Благодарение на декомпозицията на стандартните елементи, ETL процесите в такива системи изглеждат идентично, тяхното написване подлежи на алгоритмизиране и в крайна сметка автоматизация.
Цената на тази гъвкавост е производителност. Това не означава, че достигането на приемливо представяне на такива модели е невъзможно. Най-често просто може да се изисква повече усилия и внимание към детайлите, за да се постигнат необходимите метрики.
Приложения
Типове сущности Data Vault
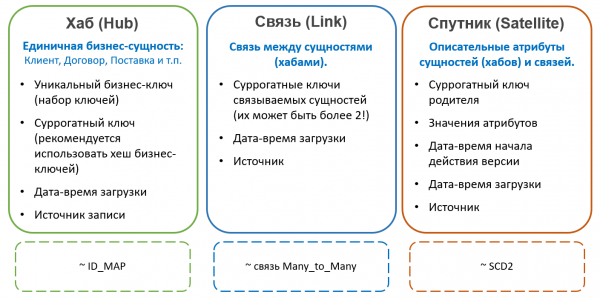
Научете повече за Data Vault:
Типове сущности Anchor Model
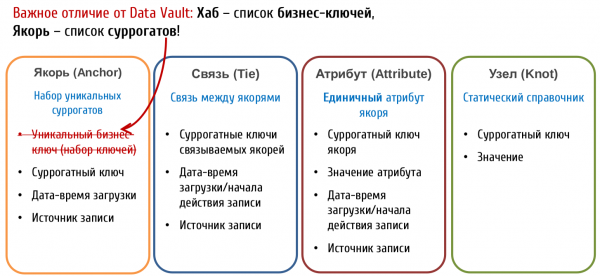
Научете повече за Anchor Model:
Обобщаваща таблица с общите черти и разликите на разглежданите подходи:
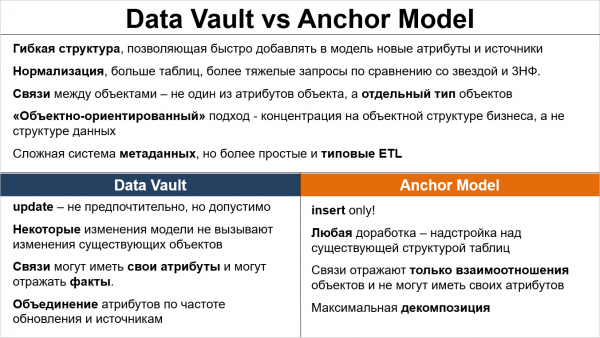
Източник: habr.com
