

Докладът е посветен на практическия въпрос по разработката на оператор в Kubernetes, проектиране на неговата архитектура и основните принципи на функциониране.
В първата част на доклада ще разгледаме:
- какво представлява операторът в Kubernetes и защо е необходим;
- как именно операторът опростява управлението на сложни системи;
- какво може и какво не може да прави операторът.
След това ще преминем към обсъждане на вътрешната структура на оператора. Ще разгледаме архитектурата и функционирането на оператора стъпка по стъпка. Подробно ще анализираме:
- взаимодействието между оператора и Kubernetes;
- какви функции операторът поема, а какво делегира на Kubernetes.
Ще разгледаме управлението на шардовете и репликите на БД в Kubernetes.
След това ще обсъдим въпросите свързани със съхранение на данни:
- как да работим с Persistent Storage от гледна точка на оператора;
- подводните камъни при използването на Local Storage.
В заключителната част на доклада ще разгледаме практически примери за приложение с Amazon или Google Cloud Service. Докладът е основан на примера на разработката и опита на експлоатация на оператора за ClickHouse.
Видео:
Казвам се Владислав Клименко. Днес искам да говоря за нашия опит в разработката и експлоатацията на оператора, а това е специален оператор за управление на кластерни бази данни. На примера на за управление на кластера ClickHouse.
Защо имаме възможност да говорим за оператора и ClickHouse?
- Занимаваме се с поддръжката и развитието на ClickHouse.
- В момента се опитваме постепенно да внесем своя принос в разработката на ClickHouse. И сме втори след Яндекс по обема на направените промени в ClickHouse.
- Опитваме се да правим допълнителни проекти за екосистемата на ClickHouse.
За един от тези проекти бих искал да говоря. Това е относно ClickHouse-operator за Kubernetes.
В доклада си бих искал да засегна две теми:
- Първата тема е как работи нашият оператор за управление на базите данни ClickHouse в Kubernetes.
- Втората тема е как работи всеки оператор, т.е. как взаимодействuje с Kubernetes.
Тези два въпроса ще се пресичат през целия ми доклад.
На кого ще му е интересно да слуша това, което се опитвам да разкажа?
- Най-вече ще бъде интересно на тези, които експлоатират оператори.
- Или на тези, които искат да направят свой, за да разберат как работи отвътре, как операторът взаимодейства с Kubernetes и какви подводни камъни могат да се появят.
За да разберем по-добре това, което ще обсъждаме днес, би било добре да знаем как работи Kubernetes и да имаме основна подготовка по облачните технологии.
Какво е ClickHouse? Това е колоночна база данни, специализирана в онлайн обработка на аналитични запитвания. И е напълно с отворен код.
Важно е да знаем само две неща. Трябва да знаем, че това е база данни, така че всичко, което ще разказвам, ще бъде приложимо практически към всяка база данни. И че СУБД ClickHouse се мащабира много добре, осигурява почти линейна мащабируемост. Следователно, състоянието на клъстера е естествено за ClickHouse. Най-интересно за нас е да обсъдим как да обслужваме клъстера на ClickHouse в Kubernetes.
Защо е необходим там? Защо не можем да продължим да го експлоатираме сами? Отговорите частично са технически, а частично организационни.
- На практика все по-често срещаме ситуация, в която в големите компании почти всички компоненти вече са в Kubernetes. Базите данни остават извън него.
- Все по-често се задава въпросът: „Може ли това да се вмъкне вътре?“. Затова големите компании се опитват да постигнат максимална унификация на управлението, за да могат бързо да управляват своите хранилища за данни.
- Това е особено полезно, когато е необходима максимална възможност за повторимо същото на ново място, т.е. максимална преносимост.
Насколько е просто или сложно? Разбира се, това може да се прави ръчно. Но не е толкова просто, защото се натрупва сложността на управлението на самия Kubernetes, комбинирана със спецификата на ClickHouse. И така, се получава агрегиране.
Всичко това заедно предоставя достатъчно голям набор от технологии, които стават трудни за управление, защото Kubernetes носи своите ежедневни въпроси за експлоатация, а ClickHouse носи своите въпроси за ежедневната експлоатация. Особено, ако имаме няколко ClickHouse инстанции и трябва постоянно да работим с тях.
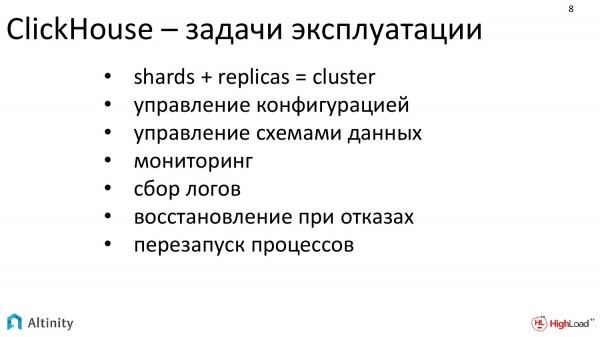
При ClickHouse с динамична конфигурация има достатъчно много въпроси, които създават постоянна натовареност за DevOps:
- Когато искаме да променим нещо в ClickHouse, например, добавим реплика или шард, трябва да проведем управление на конфигурацията.
- След това сменете схемата на данните, защото ClickHouse има специфичен начин на шардирене. Трябва да разположите схемата на данните и конфигурациите.
- Трябва да настроим мониторинга.
- Събиране на логове за нови шардове и нови реплики.
- Да се погрижим за възстановяването.
- И за рестартирането.
Това са рутинни дейности, които много бихме искали да улесним в експлоатацията.
Kubernetes наистина помага в експлоатацията, но само в базовите системни неща.
Kubernetes значително улеснява и автоматизира такива дейности като:
- Възстановяване.
- Рестартиране.
- Управление на системата за съхранение.
Това е добре, това е правилната посока, но той изцяло няма представа как да експлоатира кластер от бази данни.
Искаме повече, искаме цялата база данни да работи в Kubernetes.
Бихме искали да получим нещо като голямо червено бутонче, на което да натиснеш и да се разгръща и поддържа кластер през целия му жизнен цикъл, с ежедневни задачи, които трябва да решаваме. Кластер ClickHouse в Kubernetes.
И ние се опитахме да създадем решение, което да улесни работата. Това е ClickHouse-оператор за Kubernetes от компанията Altinity.
Операторът е програма, чиято основна задача е да управлява други програми, т.е. това е управител.
Той съдържа шаблони на поведение. Може да се нарече кодифицирани знания за предметната област.
Основната му задача е да улесни живота на DevOps и да намали микроуправлението, така че той (DevOps) да мисли в термини на високо ниво, т.е. да не се занимава с микроуправление и да не прави настройките на всички детайли ръчно.
И точно операторът е робот помощник, който се бори с микро задачите и помага на DevOps.
Защо е нужен оператор? Особено добре се справя с два въпроса:
- Когато специалистът, който работи с ClickHouse, няма достатъчно опит, но трябва да експлоатира ClickHouse, операторът улеснява експлоатацията и позволява експлоатацията на кластер ClickHouse с достатъчно сложна конфигурация, без да навлиза в подробности как всичко това работи вътре. Просто му давате задачи на високо ниво и това работи.
- И втора задача, в която той се проявява най-добре, е когато трябва да автоматизира голямо количество типови задачи. Сваля микрозадачите от системните администратори.
Това най-много е нужно на тези, които току-що започват своя път, или на тези, на които им трябва много автоматизация.
В какво се различава подходът, основан на операторите, от другите системи? Има и Helm. Той също помага да се инсталира ClickHouse, можете да нарисувате helm charts, които дори инсталират цял кластер ClickHouse. Кое тогава е различно между оператора и Helm например?
Основното фундаментално отличие е, че Helm е управление на пакети, а операторът върви по-далеч. Това е поддръжка на целия жизнен цикъл. Това не е само инсталация, това са ежедневни задачи, които включват мащабиране, шардове, т.е. всичко, което трябва да се изпълнява в процеса на жизнения цикъл (ако е нужно, и изтриването също) – всичко това решава операторът. Той се опитва да автоматизира и обслужва целия жизнен цикъл на софтуерното решение. В това е неговото основно отличие от другите налични решения.
Това беше въвеждащата част, нека преминем напред.
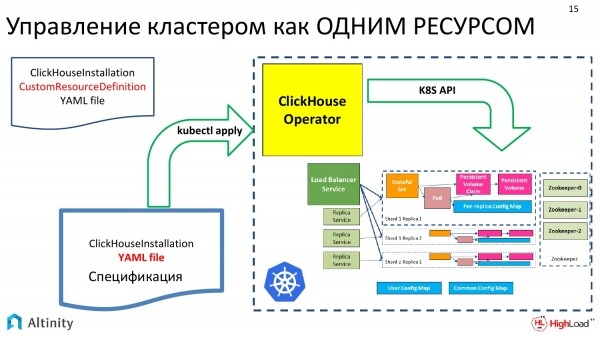
Как изграждаме нашия оператор? Опитваме се да подходяща към въпроса, за да управляваме кластера ClickHouse като един ресурс.
Ето в лявата част на картината имаме входни данни. Това е YAML със спецификация на кластера, който по класически начин се предава в Kubernetes чрез kubectl. Там нашият оператор го улавя и прави своята магия. И на изхода получаваме такава схема. Това е имплементацията на ClickHouse в Kubernetes.
След това ще разгледаме как точно работи операторът, какви типови задачи могат да бъдат решени. Ще обхванем само типови задачи, тъй като имаме ограничено време. И няма да бъде обяснено всичко, което операторът може да решава.
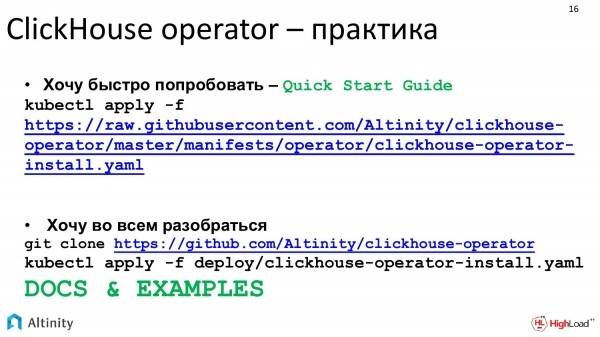
Нека да изхождаме от практиката. Нашият проект е напълно open source, затова може да се види в GitHub как работи. И може да се изхожда от предположението, че ако искате просто да стартирате, можете да започнете с Quick Start Guide.
Ако искате да се запознаете в детайли, ние се опитваме да поддържаме документацията в по-или-мене приемлив вид.
Нека да започнем с практическа задача. Първата задача, с която всички ние искаме да започнем, е да стартираме първия пример по някакъв начин. Как да стартираме ClickHouse с помощта на оператор, дори без да знаем много как работи? Пишем манифест, тъй като цялата комуникация с k8s е чрез манифести.
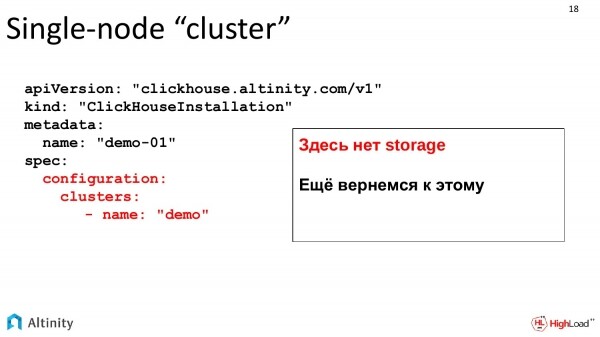
Ето такъв сложен манифест. Това, което е подчертано в червено, е акцентът, върху който трябва да се съсредоточим. Помолихме оператора да създаде клъстер с име demo.
Досега това са основните примери. Storage все още не е описан, но ще се върнем на него по-късно. Досега ще наблюдаваме динамичното развитие на клъстера.
Създадохме този манифест. Предоставяме го на нашия оператор. Той обработи и направи магия.
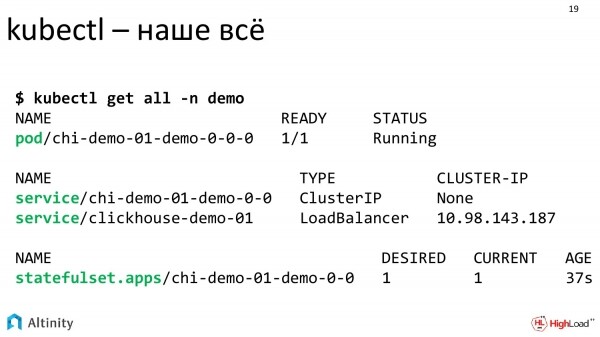
Гледаме в конзолата. Интерес предизвикват три компонента – Pod, два Service-a и StatefulSet.
Операторът обработи и може да видим какво точно е създал.
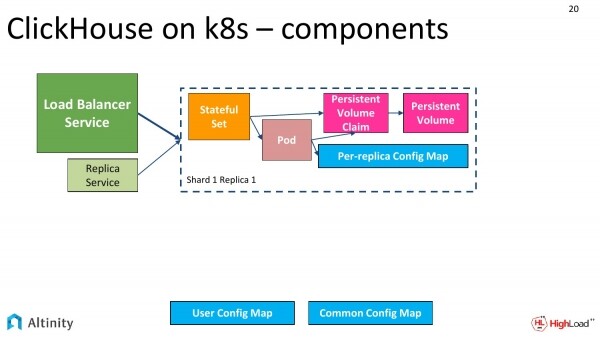
Той създава приблизително такава схема. Имаме StatefulSet, Pod, ConfigMap за всяка реплика, ConfigMap за целия клъстер. Задължително са нужни услуги като точки за влизане в клъстера.
Услугите – това е централен Load Balancer Service и могат да бъдат добавени и за всяка реплика, за всеки шард.
Ето как изглежда нашият основен клъстер. Той е с една единствена нода.
Да продължим напред, ще усложняваме. Трябва да шардим клъстера.
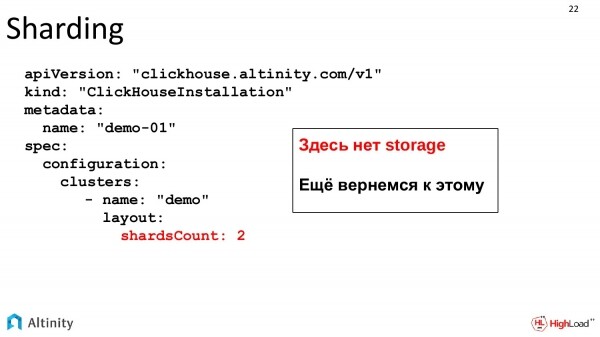
Задачите ни нарастват, започва динамика. Искаме да добавим шард. Наблюдаваме развитието. Променяме спецификацията си, указваме, че искаме два шарда.
Това е същият файл, който динамично се развива с растежа на системата. Storage го няма, storage ще бъде разгледан по-късно, това е отделна тема.
Предоставяме YAML на оператора и виждаме какво се получава.
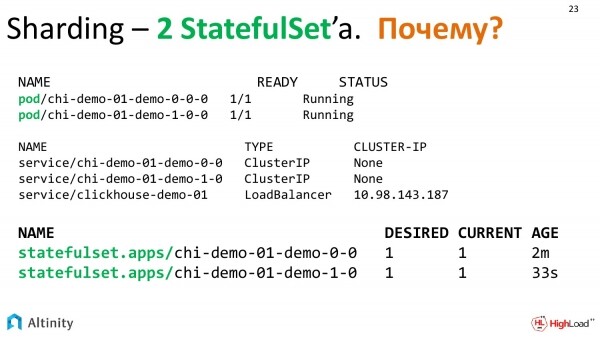
Операторът помисли и създаде следните същности. Имаме вече два Pod, три Service-a и, изненадващо, 2 StatefulSet-а. Защо 2 StatefulSet-а?
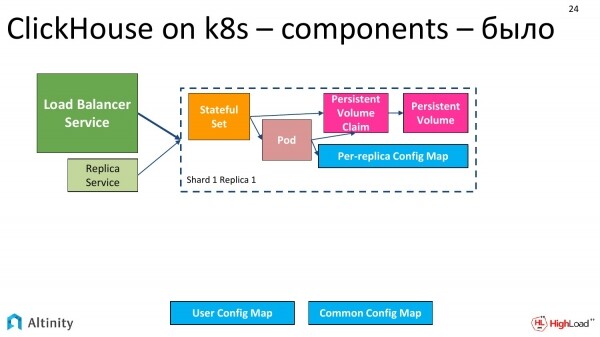
На схемата беше така – това е нашето първоначално състояние, когато имахме един pod.
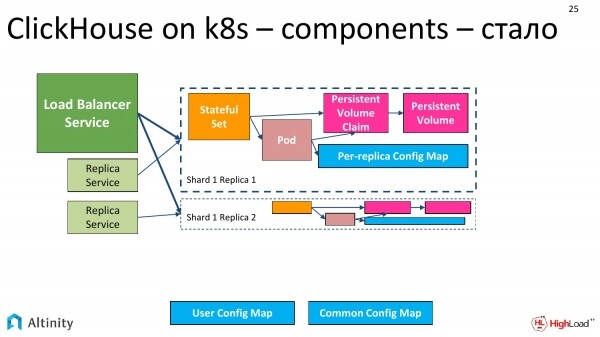
Сега стана така. Досега всичко е просто, то се дублира.
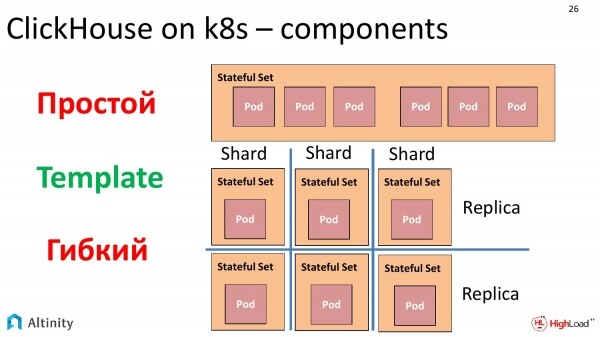
И защо StatefulSet стана два? Тук трябва да се отклоним и да обсъдим как в Kubernetes протича управлението на Pod-овете.
Съществува такъв обект, наречен StatefulSet, който позволява да се направи набор от Pod-ове от шаблон. Ключовият фактор тук е Template. И в един StatefulSet можем да стартираме много Pod-ове по един шаблон. Ключовата фраза тук е „по един шаблон много Pod-ове“.
Имаше голямо изкушение да направим целия клъстер, опакован в един StatefulSet. Това ще работи, в това няма никакви проблеми. Но има един нюанс. Ако искаме да създадем хетерогенен клъстер, т.е. от няколко версии ClickHouse, тук започват въпросите. Да, StatefulSet може да направи rolling update, да, там може да се инсталира нова версия, обяснявайки, че трябва да опитаме не повече от толкова нодов наведнъж.
Но ако екстраполираме задачата и кажем, че искаме да направим напълно хетерогенен клъстер и искаме не просто да сменим стара версия с нова чрез rolling update, а просто искаме да създадем хетерогенен клъстер както по отношение на различни версии на ClickHouse, така и по отношение на различно хранилище. Например, искаме определени реплики да направим на отделни дискове, на бавни, в общи линии, напълно да изградим хетерогенен клъстер. И заради това, че StatefulSet прави стандартизирано решение от един шаблон, няма възможност да го направим.
След известно размишление беше взето решение да направим така. Всяка реплика е в своя StatefulSet. Има някои недостатъци на това решение, но в практиката то напълно инкапсулира операторът. И има куп достойнства. Можем да изграждаме напълно такъв клъстер, какъвто искаме, например абсолютно хетерогенен. Затова в клъстера, в който имаме два шарда с по една реплика, ще имаме 2 StatefulSet и 2 Pod именно защото избрахме такъв подход поради гореизложените причини за възможността да изградим хетерогенен клъстер.
Нека се върнем към практическите задачи. В нашия клъстер трябва да се настройват потребители, т.е. трябва да се извърши някаква конфигурация на ClickHouse в Kubernetes. Операторът предоставя всички възможности за това.
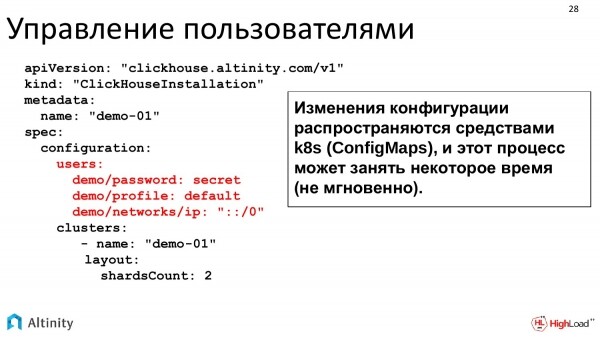
Можем директно в YAML да напишем каквото искаме. Всички конфигурационни опции се мапват директно от този YAML в конфигурации на ClickHouse, които след това се разпространяват по целия клъстер.
Може да пишем и така. Това е за пример. Паролата може да бъде шифрована. Поддържат се абсолютно всички конфигурационни опции на ClickHouse. Тук е само пример.
Конфигурацията по клъстера се разпространява като ConfigMap. В практиката, обновлението на ConfigMap не става мигновено, затова ако клъстерът е голям, процесът на вмъкване на конфигурацията отнема известно време. Но всичко това е много удобно за експлоатация.
Усложняваме задачата. Кластърът се развива. Искаме да репликираме данни. Тоест, вече имаме два шарда с по една реплика, настроени потребители. Растем и искаме да се занимаваме с репликация.
Какво ни трябва за репликация?
Нужен ни е ZooKeeper. В ClickHouse репликацията е изградена с помощта на ZooKeeper. ZooKeeper е необходим, за да имат различните реплики на ClickHouse консенсус относно това, кои данни блокове на кой ClickHouse съществуват.
Може да се използва всякакъв ZooKeeper. Ако в предприятието има външен ZooKeeper, може да се използва. Ако няма, можем да инсталираме от нашето хранилище. Има инсталатор, който улеснява всичко това.
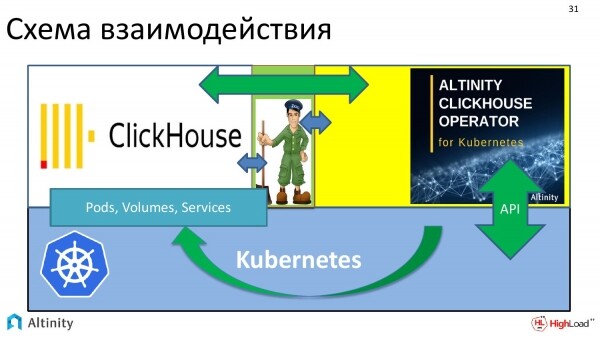
Схемата на взаимодействие на цялата система изглежда така. Имаме Kubernetes като платформа. На него е инструкторът ClickHouse. ZooKeeper го представям тук. Инструкторът взаимодейства както с ClickHouse, така и с ZooKeeper, т.е. взаимодейства.
И всичко това е необходимо, за да може ClickHouse успешно да репликира данните в k8s.
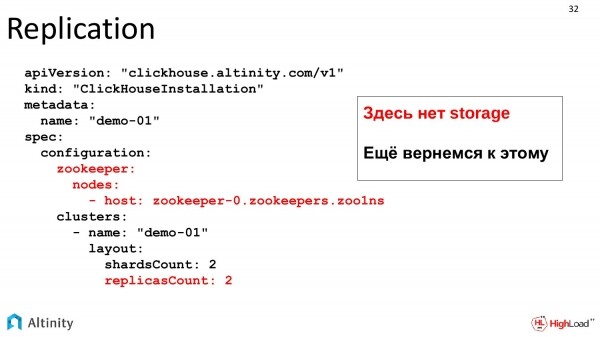
Неизменна е да видим самата задача, как ще изглежда манифестът за репликация.
Добавяме две секции към нашия манифест. Първата е къде да вземем ZooKeeper, който може да бъде вътре в Kubernetes или външен. Това е просто описание. И поръчваме реплики. Тоест, искаме две реплики. В итог сме на изход 4 pod’a. Отново помним за хранилището, което ще се върне малко по-късно. Хранилището – това е отделна песен.
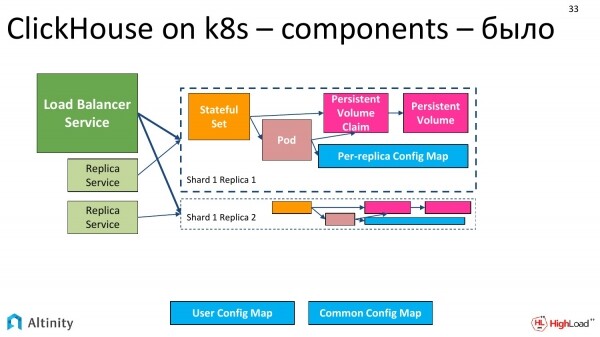
Беше така.
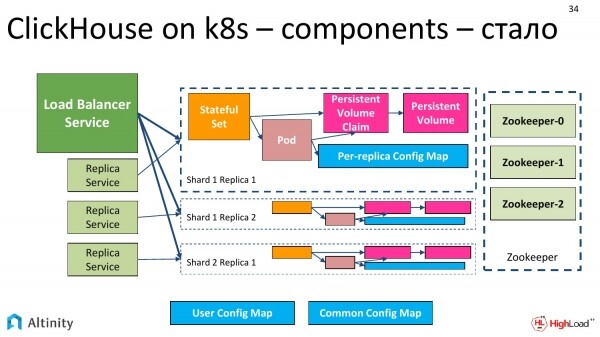
Сега е така. Добавят се реплики. Четвъртата не се събира, вярваме, че те могат да бъдат много. И отстрани се добавя ZooKeeper. Схемите се усложняват.
Настъпи време да добавим следващата задача. Ще добавим Persistent Storage.
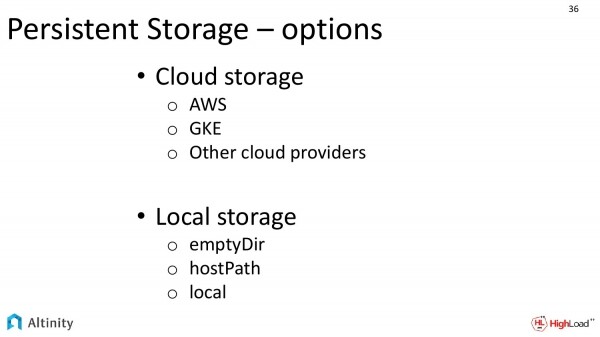 По отношение на Persistent Storage имаме различни варианти на изпълнение.
В случай, че се изпълняваме при облачен доставчик, например, използвайки Amazon, Google, има голямо изкушение да се възползваме от облачното хранилище. Това е много удобно и добре.
Има и втори вариант. Това е за локално хранилище, когато имаме локални дискове на всяка нода. Този вариант е значително по-сложен за изпълнение, но е по-производителен.
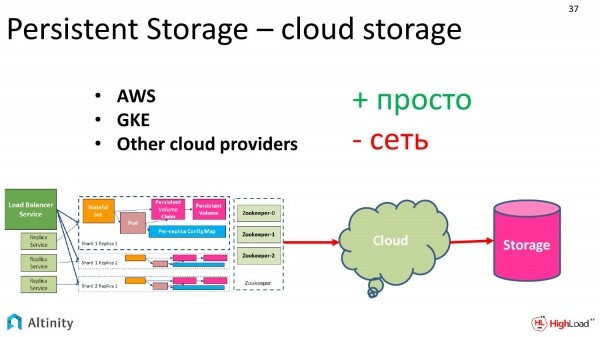
Нека видим какво имаме относно облачното хранилище.
Има предимства. Много лесно е за конфигуриране. Просто поръчваме от облачния доставчик какъвто и да е хранилище с такава капацитет и такъв клас. Класовете са описани от доставчиците сами.
Има недостатък. За някои това не е критичен недостатък. Разбира се, има известни проблеми с производителността. Това е много удобно за работа, надеждно е, но има потенциални спадове в производителността.
Тъй като ClickHouse акцентира точно на производителността, може да се каже, че извлича всичко, което е възможно, затова много клиенти се опитват да извлекат максимума от производителността.
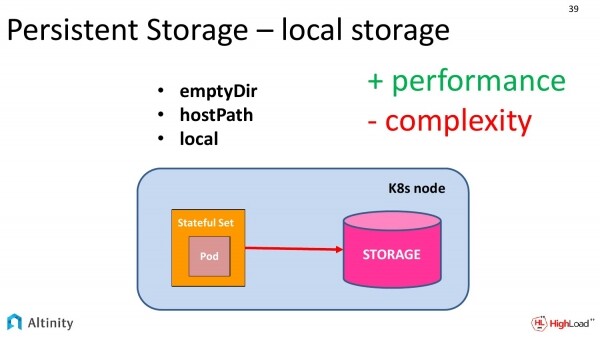
За да извлечем максимум, ни трябва локално хранилище.
Kubernetes предоставя три абстракции за използване на локално хранилище в Kubernetes. Това са:
- EmptyDir
- HostPath.
- Local
Нека разгледаме какво ги различава и какво им е общо.
На първо място, при трите подхода хранилището представлява локални дискове, които се намират на същата физическа k8s нода. Но те имат някои различия.
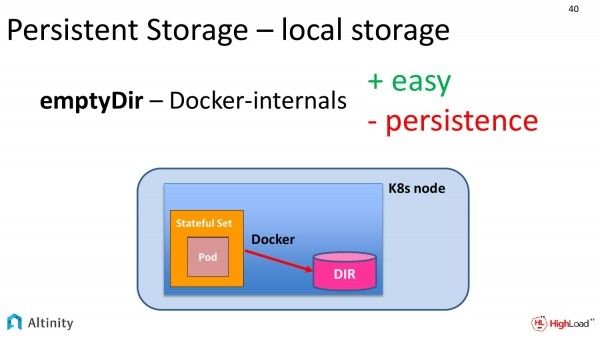
Да започнем с най-простия, т.е. с emptyDir. Какво представлява това на практика? Това е, когато в спецификацията си искаме от контейнеризацията (най-често - Docker) да ни предостави достъп до папка на локалния диск.
На практика Docker създава някъде при себе си временно папка, наричана с дълъг хеш. И предоставя интерфейс за достъп до нея.
Как ще работи това по производителност? Това ще работи със скоростта на локалния диск, т.е. това е напълно достъп до своя диск.
Но този вариант има свой недостатък. Перманентността е в много отношение съмнителна. При първото движение на Docker с контейнерите, перманентността се губи. Ако Kubernetes реши по някаква причина да премести този Pod на друг диск, данните ще бъдат загубени.
Такъв подход е добър за тестове, защото показва нормална скорост, но за нещо сериозно този вариант не е подходящ.
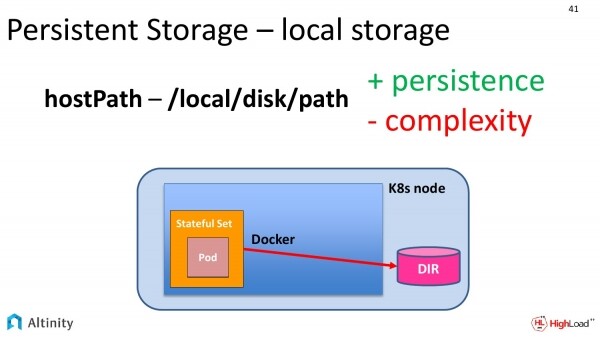
Затова има втори подход. Това е hostPath. Ако разгледате предишната и тази слайда, може да видите само едно различие. Папката е излязла от Docker направо на Kubernetes нодата. Тук е малко по-просто. Пряко вписваме пътя по локалната файлова система, където искаме да съхраняваме данните си.
Има предимства на този метод. Това е истинска перманентност, и то класическа. Данните ще бъдат записани на диска по определен адрес.
Има и недостатъци. Това е сложността на управлението. Нашият Kubernetes може да пожелае да премести Pod на друг физически нод. И тук вече се намесва DevOps. Той трябва да обясни на цялата система, че тези pod'ове могат да се преместват само на такива нодове, на които имаш нещо монтирано по тези пътища, и не повече от един нод едновременно. Това е доста сложно.
Специално за тези цели, ние в оператора си направихме шаблони, за да скрием цялата тази сложност. И можеше просто да се каже: "Искам да имам един инстанс ClickHouse на всяка физическа нода и по такъв път."
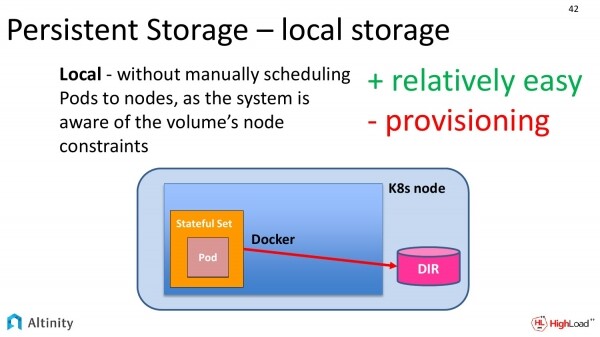
Но тази необходимост не е нужна само на нас, затова джентълмените от самия Kubernetes също разбират, че на хората им се иска достъп до физическите дискове, затова те предоставят третото ниво.
Той се нарича local. Разликата от предишния слайд практичесki няма. Само по-рано трябваше ръчно да се прилага, че тези pod'ове не могат да се преместват от нода на нода, защото трябва да бъдат прикрепени по такъв път към локалния физически диск, а сега всичките тези знания са инкапсулирани в самия Kubernetes. И конфигурирането става много по-лесно.
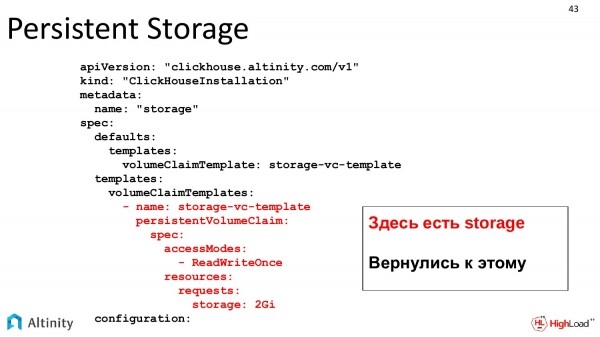
Върнете се към нашата практическа задача. Върнете се към YAML шаблона. Тук имаме истинско хранилище. Върнахме се към това. Задаваме класически VolumeClaim шаблон, както в k8s. И описваме какво хранилище искаме.
След това k8s ще поиска хранилище. Ще ни го предостави в StatefulSet. И в крайна сметка това ще бъде на разположение на ClickHouse.
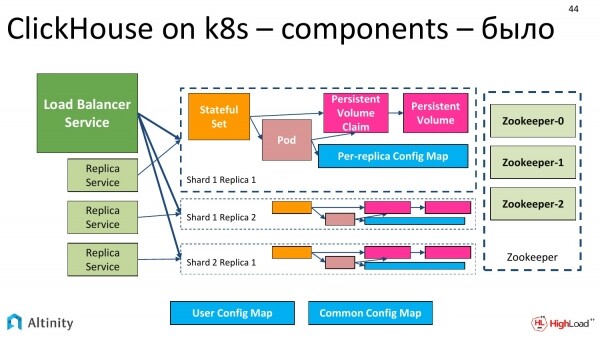
Имахме такава схема. Нашият Persistent Storage беше червен, което неминуемо подсказваше, че трябва да го направим.
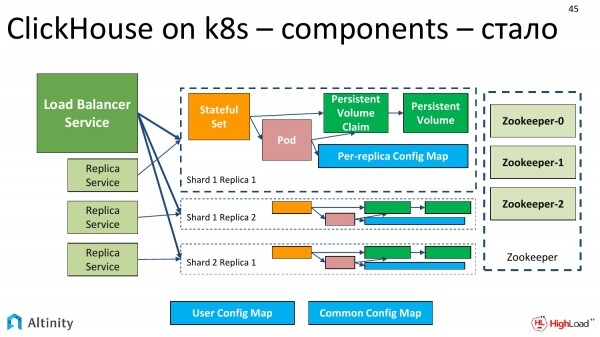
И той става зелен. Сега схемата на кластера ClickHouse on k8s е напълно финализирана. Имаме шардове, реплики, ZooKeeper, имаме истински Persistent, реализиран по такъв или иначе. Схемата вече е напълно функционална.
Ние продължаваме да живеем. Кластерът се развива. И Алексей се старае и пуска нова версия на ClickHouse.
Възниква практическа задача – да тестваме новата версия на ClickHouse на нашия кластер. И естествено, не искаме да го прилагаме целия, искаме да поставим новата версия на едно място в далечния ъгъл, а може би не една нова версия, а веднага две, защото те излизат често.
Какво можем да кажем по този въпрос?
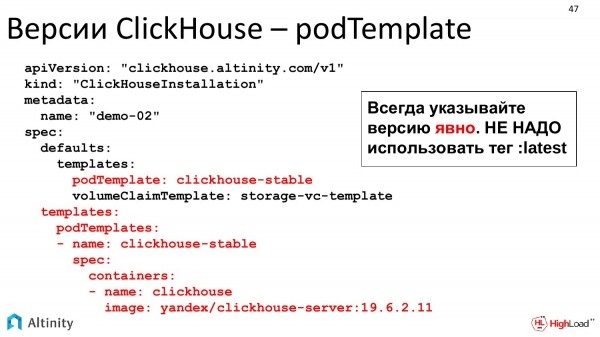
Тук имаме точно такава възможност. Това са шаблоните на pod'овете. Можем да планираме, нашият оператор напълно позволява изграждането на хетерогенен клъстер. Тоест, можем да конфигурираме всичките реплики на купчина, до всяка отделна реплика, в зависимост от коя версия на ClickHouse искаме, коя версия на storage. Можем напълно да конфигурираме клъстера в необходимата ни конфигурация.
Сега ще задълбочим по малко. Досега говорихме за начина, по който работи ClickHouse-операторът в контекста на спецификата на ClickHouse.
Сега бих искал да кажа няколко думи за това как работи всеки оператор, както и за това как взаимодействува с K8s.
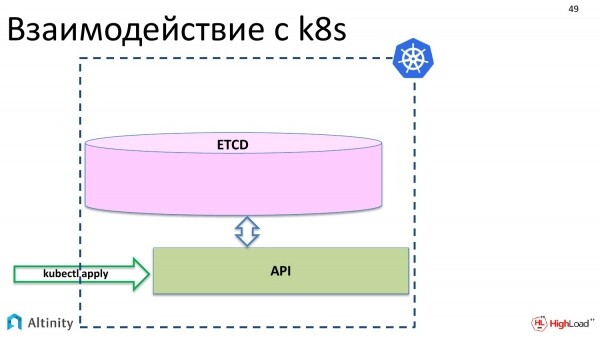
Нека първо разгледаме взаимодействието с K8s. Какво се случва, когато направим kubectl apply? Чрез API в etcd се появяват нашите обекти.
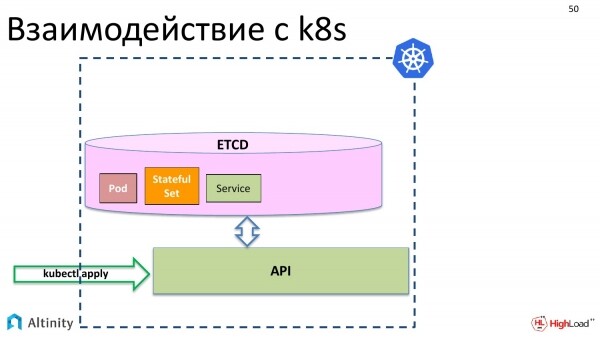
Например, основни обекти на Kubernetes: pod, StatefulSet, service и т.н.
Но физически нищо все още не се случва. Тези обекти трябва да бъдат материализирани в клъстера.
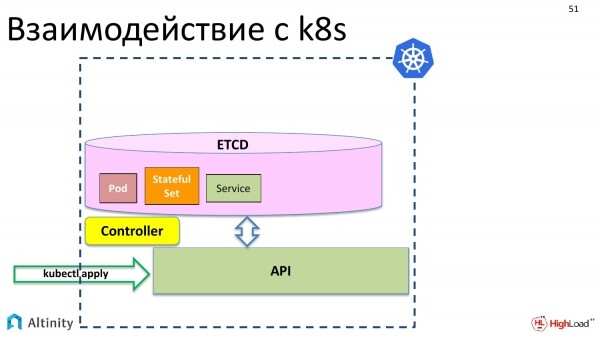
За целта се появява контролер. Контролерът е специален компонент на k8s, който знае как да материализира тези описания. Той знае какво да прави физически. Знае как да стартира контейнери и какво трябва да бъде конфигурирано, за да заработи сървърът.
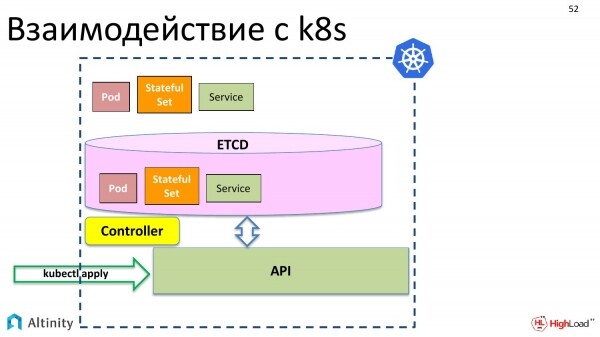
И той материализира нашите обекти в K8s.
Но искаме да оперираме не само с pod-ове и StatefulSet-ове. Искаме да създадем ClickHouseInstallation, т.е. обект от тип ClickHouse, за да го оперираме като цяло. В момента такава възможност няма.
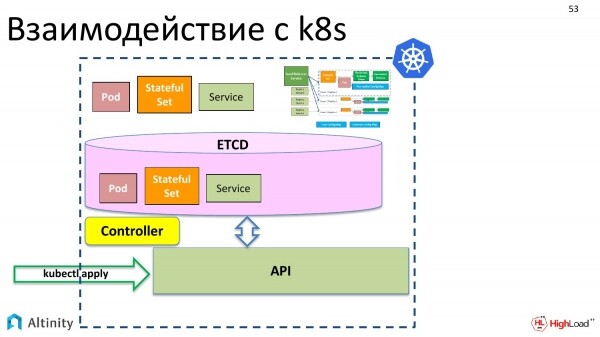
Но K8s има следното приятно нещо. Искаме да имаме сложен обект, в който да се събира нашият клъстер, направен от pod-ове и StatefulSet.
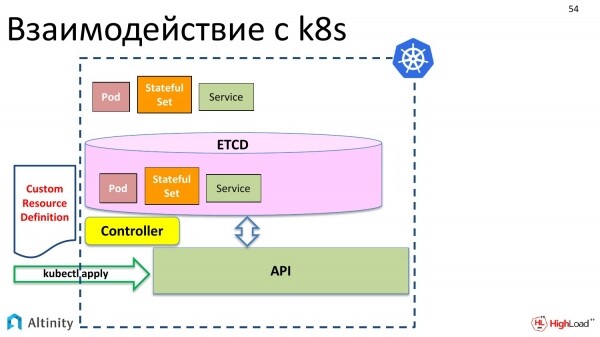
И какво трябва да направим за това? Първо, на сцената излиза Custom Resource Definition. Какво е това? Това е описание за K8s, че ще имаш един допълнителен тип данни, че искаме да добавим кастомизиран ресурс към pod и StatefulSet, който да бъде сложен вътре. Това е описание на структурата на данните.
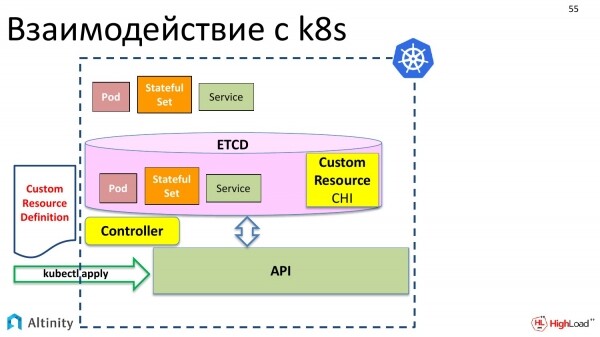
Това също го изпращаме чрез kubectl apply. Kubernetes го прие с радост.
И сега в хранилището, на обекта в etcd, се появява възможност да запишем кастомния ресурс с името ClickHouseInstallation.
Но в момента нищо повече няма да се случи. Тоест, ако създадем YAML файл, който разглеждахме с описание на шардовете, репликите и кажем „kubectl apply“, Kubernetes ще го приеме, ще го запази в etcd и ще каже: „Страхотно, но какво да правя с него, не знам. Как да управлявам ClickHouseInstallation не знам“.
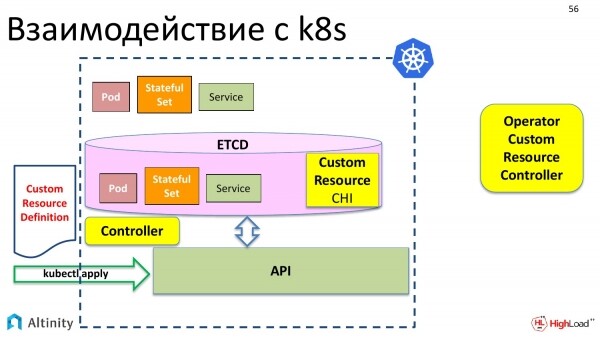
Следователно, ни трябва някой, който да помогне на Kubernetes да управлява новия тип данни. Отляво имаме стандартен контролер на Kubernetes, който работи с вградените типове данни. А отдясно трябва да се появи персонализиран контролер, който знае как да работи с персонализирани типове данни.
И по друг начин той се нарича оператор. Изнесох го извън Kubernetes, защото може да работи и извън K8s. Най-често, разбира се, всички оператори работят в Kubernetes, но нищо не пречи да бъде извън него, затова тук е специално изнесен навън.
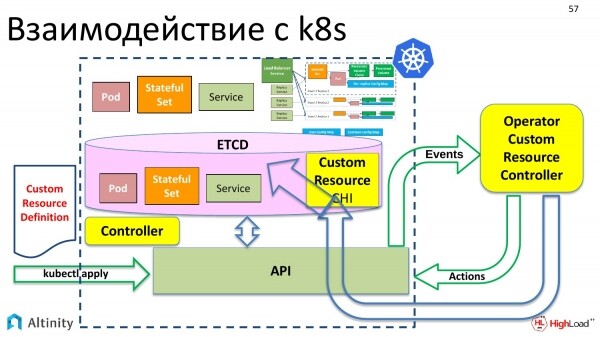
И вече персонализираният контролер, т.е. операторът, взаимодействува с Kubernetes чрез API. Той знае как да взаимодействува с API. И вече знае как от персонализиран ресурс да материализира сложната схема, която искаме да направим. Именно с това се занимава операторът.
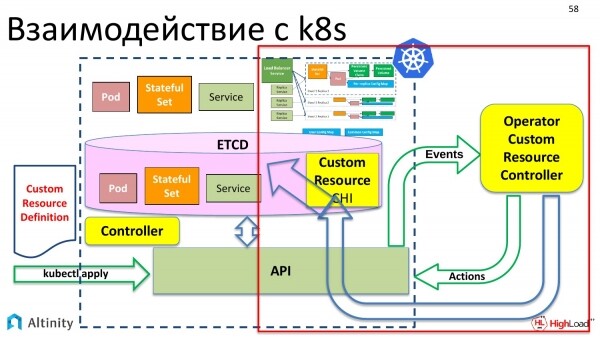
Как работи операторът? Нека се загледаме в дясната част, за да разберем как той го прави. Ще видим как операторът всичко това материализира и как впоследствие става взаимодействието с K8s.
Операторът е програма. Тя е събитийно ориентирана. Операторът чрез Kubernetes API се подписва на събития. В Kubernetes API има точки за достъп, на които може да се абонира за събития. И ако нещо се променя в K8s, Kubernetes изпраща събития на всички желаещи, т.е. който се е абонирал за тази точка на API, той ще получи известия.
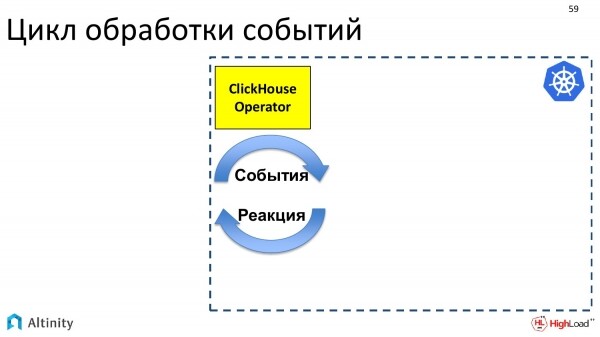
Операторът се абонира за събития и трябва да реагира по някакъв начин. Неговата задача е да реагира на появяващите се събития.
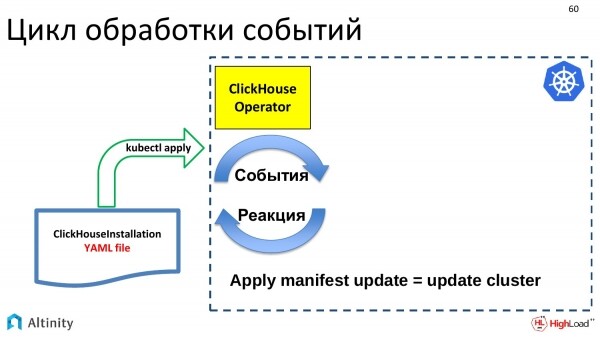
Събитията се генерират от определени актуализации. Пристигна нашият YAML файл с описанието на ClickHouseInstallation. Той чрез kubectl apply отиде в etcd. Там сработи събитие и в крайна сметка това събитие достигна до ClickHouse-оператора. Операторът получи това описание. И той трябва да направи нещо. Ако е получена актуализация на обект ClickHouseInstallation, то трябва да актуализира кластера. И задачата на оператора е да актуализира кластера.
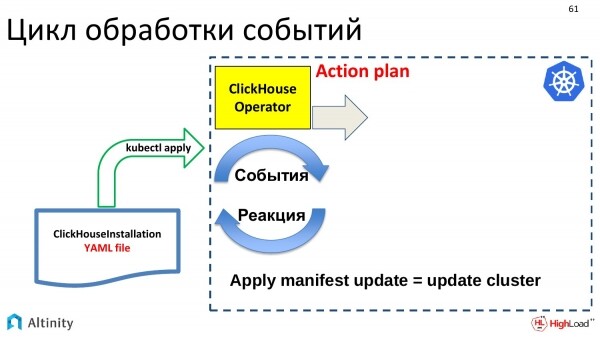
Какво прави той? Първо, трябва да се състави план за действия, какво ще правим с тази актуализация. Актуализациите могат да бъдат много малки, т.е. малки в YAML изпълнение, но могат да предизвикат много големи промени в клъстера. Затова операторът съставя план и след това се придържа към него.
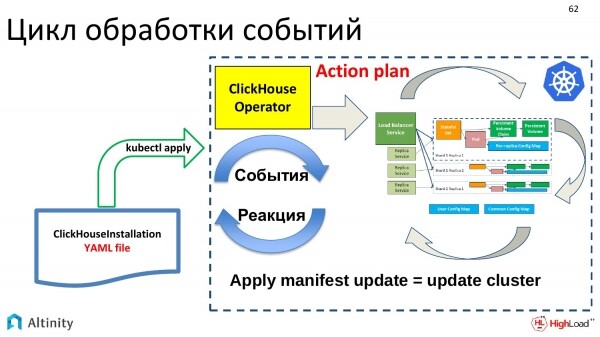
Той започва, съгласно този план, да изгражда тази структура, за да материализира pod’ове, услуги, т.е. да извършва онова, което е основната му задача. Това е като да се изгражда кластер ClickHouse в Kubernetes.
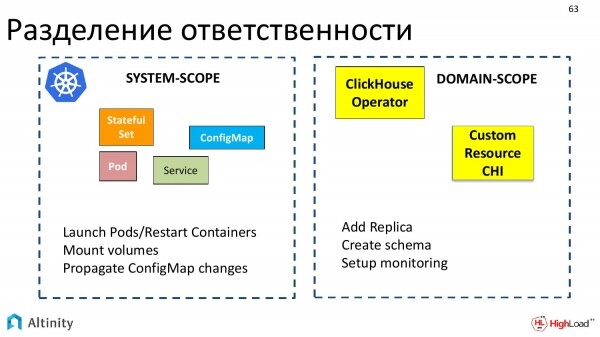
Сега нека се обърнем към нещо интересно. Това е разделението на отговорностите между Kubernetes и оператора, т.е. какво прави Kubernetes, какво прави операторът и как те взаимодействат помежду си.
Kubernetes отговаря за системни неща, т.е. за основния набор от обекти, които могат да се интерпретират като системни. Kubernetes знае как да стартира pod’ове, как да рестартира контейнери, как да инсталира обеми, как да работи с ConfigMap, т.е. всичко, което може да се нарече система.
Операторите действат в определени предметни области. Всеки оператор е създаден за своята предметна област. Ние направихме за ClickHouse.
И операторът взаимодейства точно с термини на предметната област, като например добавяне на реплика, създаване на схема, настройка на мониторинг. Получава се такова разделение.
Нека разгледаме практически пример как това разделение на отговорности се случва, когато извършваме действие за добавяне на реплика.
В оператора идва задача – да добави реплика. Какво прави операторът? Операторът ще изчисли, че трябва да се създаде нов StatefulSet, в който трябва да опише определени шаблони, искания за обеми.
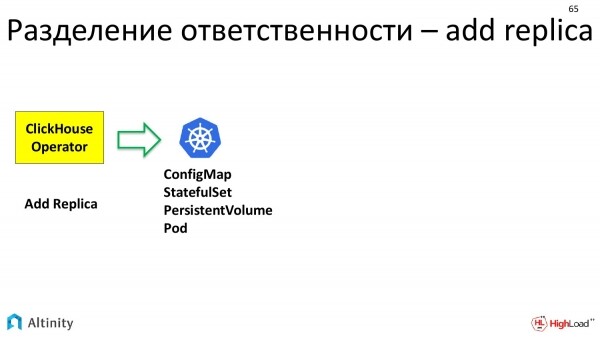
Той всичко това подготвя и преминава по-нататък в K8s. Казва, че му трябва ConfigMap, StatefulSet, Обем. Kubernetes работи с това. Той материализира основните единици, с които оперира.
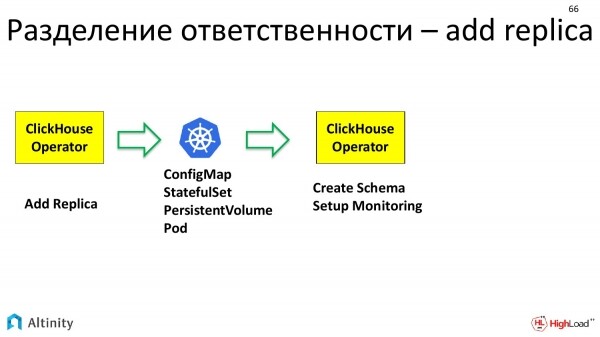
И след това отново влиза в действие ClickHouse-операторът. Той вече има физически pod, върху който може да се работи. И ClickHouse-операторът отново работи с термини на предметната област. Т.е. конкретно ClickHouse, за да включим реплика в клъстера, първо трябва да настроим данните в схемата, която е в този клъстер. А, на второ място, тази реплика трябва да бъде включена в мониторинга, за да бъде добре проследима. Операторът вече това настройва.
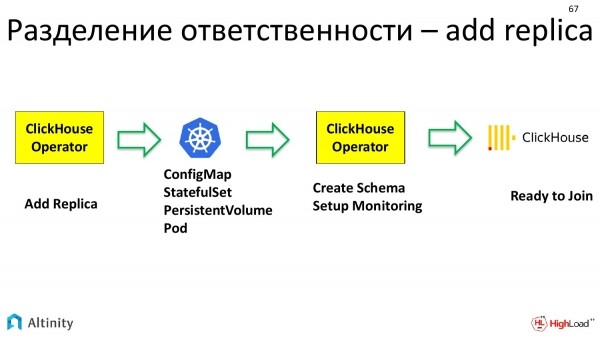
И само по себе ClickHouse, то есть еще одна более высокоуровневая сущность, вступает в дело только после этого. Это уже база данных, которая имеет свой экземпляр и настроенную реплику, готовую к кластеру.
Таким образом, цепочка выполнения и разделения ответственности при добавлении реплики становится довольно длинной.
Продолжаем с нашими практическими задачами. Если кластер уже существует, мы можем выполнить миграцию конфигурации.
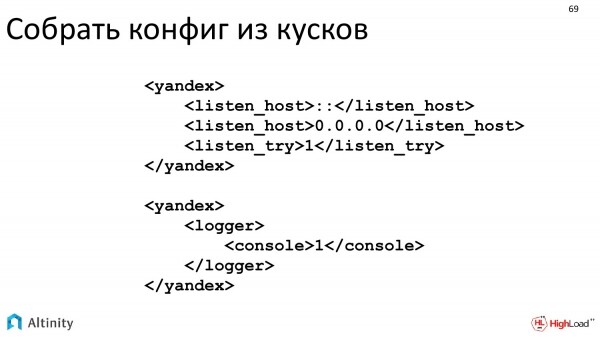
Мы сделали так, что в существующий XML, который понимает ClickHouse, можно передавать данные без изменений.
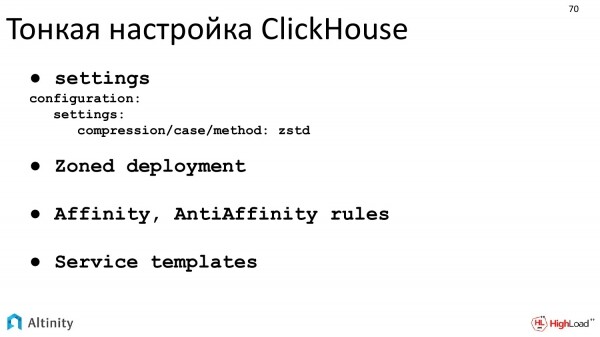
Можно выполнить тонкую настройку ClickHouse. Как раз zoned deployment – это то, о чем я рассказывал при объяснении hostPath и локального хранилища. Это правильное выполнение zoned deployment.
Следующая практическая задача – мониторинг.
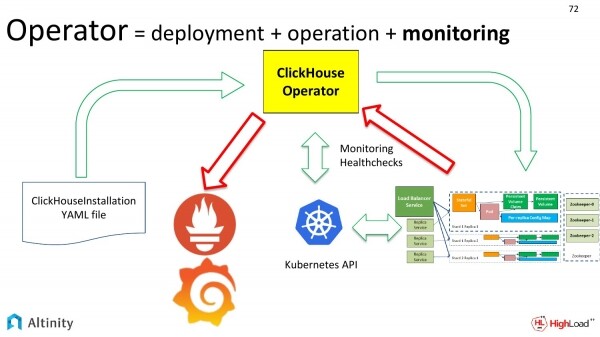
Если наш кластер изменяется, необходимо периодически настраивать мониторинг.
Давайте рассмотрим схему. Зеленые стрелки мы уже обсудили. Теперь давайте посмотрим на красные стрелки. Это способ, как мы хотим мониторить наш кластер. Как метрики из кластера ClickHouse поступают в Prometheus, а затем в Grafana.
В чем заключается сложность с мониторингом? Почему это считается достижением? Сложность заключается именно в динамике. Когда у нас один статический кластер, можно однажды настроить мониторинг и больше не беспокоиться.
Но если у нас много кластеров или постоянно что-то меняется, процесс становится динамическим. Постоянно перенастраивать мониторинг – это трата ресурсов и времени, то есть даже просто лень. Это нужно автоматизировать. Сложность именно в динамике процесса, и оператор хорошо это автоматизирует.
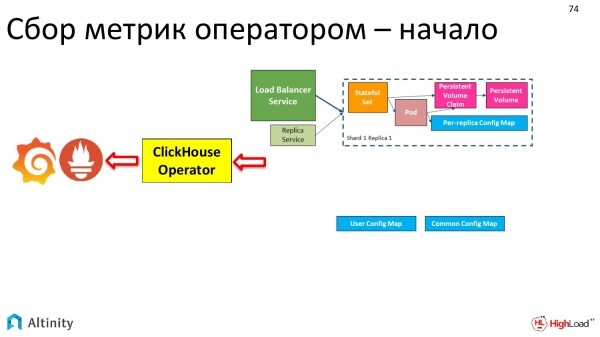
Как развивался наш кластер? Сначала он выглядел так.
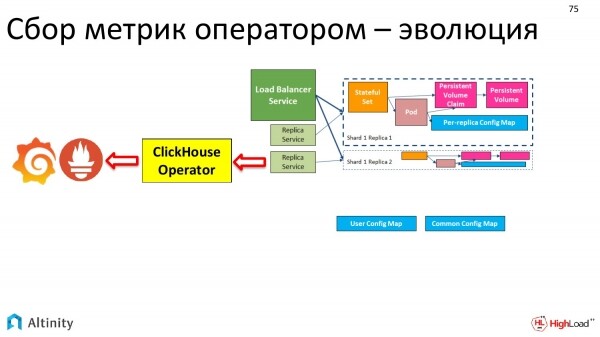
Потом он стал таким.
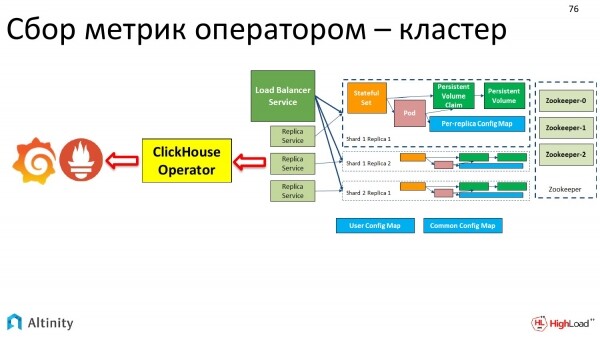
В итоге он стал таким.
А мониторинг автоматически выполняется оператором. Единая точка входа.
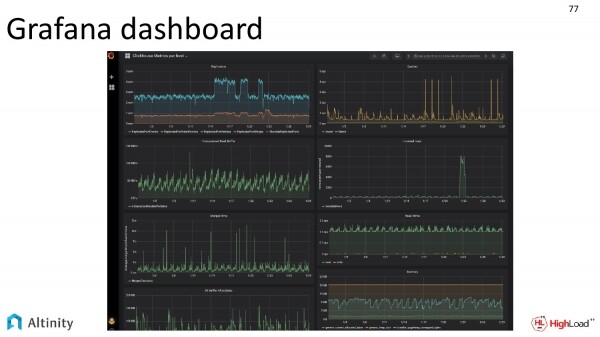
И мы просто смотрим на панель управления Grafana, как внутри нашего кластера кипит жизнь.
Кстати, панель управления Grafana также поставляется с нашим оператором в исходных кодах. Можно подключаться и использовать. Этот скриншот предоставили наши DevOps.
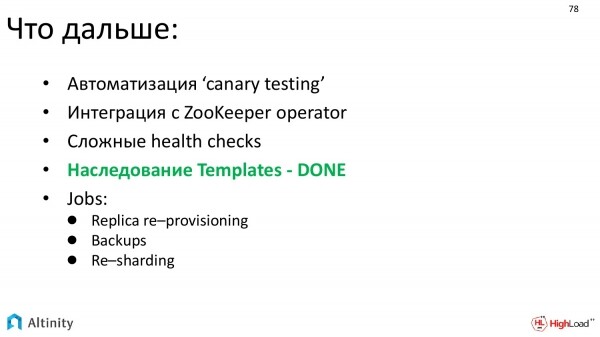
Куда бы мы хотели двигаться дальше? Это:
- Развивать автоматизацию тестирования. Основная задача – автоматизированное тестирование новых версий.
- Също така много искаме да автоматизираме интеграцията с ZooKeeper. И в плановете е да се интегрираме с ZooKeeper-operator. Т.е. за ZooKeeper е написан оператор и е логично, че двата оператора трябва да започнат да се интегрират, за да изградят по-удобно решение.
- Искаме да направим по-сложни проверки на жизнеспособността.
- В зелено съм подчерта за нас наследяването на Templates – ГОТОВО, т.е. с следващия релиз на оператора вече ще имаме наследяване на шаблони. Това е мощен инструмент, който позволява изграждането на сложни конфигурации от парчета.
- И искаме автоматизация на сложни задачи. Основната от тях е Re-sharding.
Нека направим междинни заключения.
Какво получаваме на изхода? И струва ли си да се занимаваме с това, или не? Нужно ли е изобщо да се опитваме да внедрим базата данни в Kubernetes и да приложим оператора като цяло и Alitnity-оператора в частност.
На изхода получаваме:
- Съществено опростяване и автоматизация на конфигурирането, разгръщането, както и поддръжката.
- Незабавно вграден мониторинг.
- И готови за употреба кодифицирани шаблони за сложни ситуации. Вече действието да добавите реплика не е необходимо да се прави ръчно. Това се извършва от оператора.
Остава само последният въпрос. Имаме ли вече база данни в Kubernetes, виртуализация. Какво е производителността на такова решение, особено предвид факта, че ClickHouse е оптимизиран за производителност?
Отговор – всичко е наред! Няма да навлизам в детайли, това е тема на отделен доклад.
Но има такъв проект, наречен TSBS. Каква е основната му задача? Това е тест за бази данни за производителност. Това е опит да се сравнят топло с топло, меко с меко.
Как работи? Генерира се един набор от данни. След това този набор от данни се пуска на един и същ набор от тестове на различни бази данни. И всяка база данни решава една задача така, както умее. И след това можем да сравним резултатите.
Той вече поддържа голямо количество бази данни. Изтъкнах три основни. Това са:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
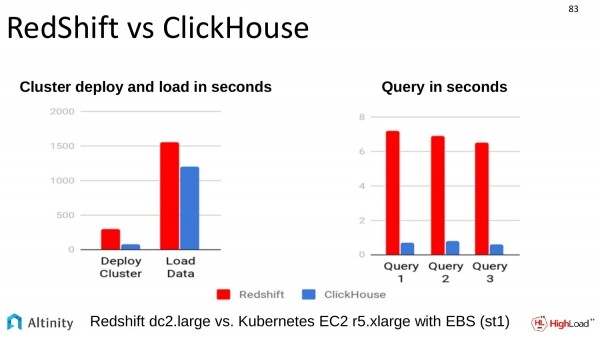
Също така беше направено сравнение с друго подобно решение. Сравнението с RedShift. Сравнението беше извършено на Amazon. ClickHouse също минава добре пред всички в този въпрос.
Какви заключения могат да се направят от това, което разказах?
- DB в Kubernetes е възможно. Най-вероятно, всичко е възможно, но по принцип изглежда, че е възможно. ClickHouse в Kubernetes определено може да бъде постигнато с помощта на нашия оператор.
- Операторът помага да се автоматизират процесите и наистина опростява живота.
- Производителността е нормална.
- И, смятаме, че това може и трябва да се използва.
Open source – присъединете се!
Както казах, операторът е напълно open source продукт, така че ще бъде много добре, ако максимално много хора го използват. Присъединете се! Очакваме ви всички!
Благодаря на всички!
Въпроси
Благодаря за доклада! Аз съм Антон. От компанията SEMrush. Интересува ме какво става с логването. Чувал съм за мониторинга, а за логването нищо не се споменава, ако говорим за целия клъстер. Например, имаме клъстер на хардуер. И ние използваме централизирано логване, стандартни средства събираме информацията в обща база и после оттам извличаме интересните данни.
Добър въпрос, т.е. логването е в списъка todo. Нашият оператор засега не го автоматизира. Той все още се развива, проектът е все още доста млад. Разбираме необходимостта от логване. Това е също много важна тема. И вероятно не по-малко важна от мониторинга. Но първото в списъка за реализация беше мониторинга. Логването ще бъде. Ние, разбира се, се стараем да автоматизираме всички аспекти на жизнеността на клъстера. Затова отговорът е – в момента операторът, за съжаление, не го умее, но това е в плановете, ще го направим. Ако имате желание да се присъедините, моля, подайте pull request.
Здравейте! Благодаря за доклада! Имам стандартен въпрос, свързан с Persistent Volumes. Когато създадем конфигурация с този оператор, как операторът определя на коя нода имаме присъединен диск или папка? Трябва ли предварително да му обясним, че, моля, разположете нашия ClickHouse именно на тези ноди, на които има диск?
Насколкото разбирам, този въпрос е продължение на локалното хранилище, особено частта му за hostPath. Това е като да обясняваме на целия слой, че pod трябва да бъде стартиран точно на такава нода, на която имаме физически свързан диск, монтиран по определен път. Това е цяла секция, която засегнах много повърхностно, тъй като отговорът е доста обширен.
В обобщение, ето изглежда така. Очевидно, трябва да направим provisioning на тези volumes. В момента в локалното хранилище няма динамично provisioning, затова DevOps трябва сами да разделят дисковете, тези volumes. И трябва да обяснят на Kubernetes provisioning, че ще имате Persistent volumes от определен клас, който се намира на такива ноди. След това трябва да се обясни на Kubernetes, че pod-овете, които изискват такъв клас локално хранилище, трябва да се планират само на определени ноди по етикети. За тези цели в оператора има възможност да се назначи някакъв етикет и one per host instance. И ще се получи, че pod-овете ще бъдат маршрутизирани от Kubernetes за стартиране само на ноди, които отговарят на изискванията, етикети, казано по-просто. Администраторите назначават етикети, правят provisioning на дисковете ръчно. И тогава ще може да бъде мащабирано.
И точно третият вариант на локалното помага малко да се облекчи това. Както вече подчертах, това е трудоемка работа по настройката, която накрая помага да се получи максимална производителност.
Имам втори въпрос, свързан с това. Kubernetes е замислен така, че не ни е важно дали ще загубим нода или не. Какво трябва да правим в този случай, ако загубим нода, на която е свързан шард?
Да, Kubernetes първоначално се позиционираше така, че нашите отношения към pod-овете е като към добитък, а тук всеки диск става нещо като домашен любимец. Има такава проблема, че не можем просто да ги изхвърлим. А развитието на Kubernetes върви в посока, че не може напълно да се отнесе философски към него, като към напълно изхвърляеми ресурси.
Сега практическото питане. Какво да правите, ако загубите нода, на която е дискът? Тук задачата се решава на по-високо ниво. В случая с ClickHouse имаме реплики, които работят на по-високо ниво, т.е. на нивото на ClickHouse.
Какво е становището? За това, че данните не се губят, отговаря DevOps. Той трябва правилно да настрои репликацията и да следи за нейното изпълнение. В репликата на нивото на ClickHouse данните трябва да бъдат дублирани. Това не е задачата, която решава операторът. И не е задачата, която решава самият Kubernetes. Това е на нивото на ClickHouse.
Какво да правим, ако сте загубили железен възел? Явно трябва да инсталираме втори, правилно да конфигурираме диска, да поставим етикети. И след това той ще отговаря на изискванията, че Kubernetes може да стартира инстанция на пода на него. Kubernetes ще го стартира. Нямате достатъчно подове, за да отговорят на зададеното количество. Той ще премине през цикъла, който показвах. И на най-високото ниво ClickHouse ще разбере, че имаме реплика, която е празна и върху която трябва да започнем да преливаме данни. Тоест, този процес е още слабо автоматизиран.
Благодаря за доклада! Когато се случват всякакви неприятности, операторът пада и се рестартира, а в този момент постъпват събития, вие как обработвате това?
Какво ще се случи, ако операторът е паднал и се е рестартирал, така ли?
Да. И в този момент постъпват събития.
Задачата, какво да се направи в такъв случай, се разделя частично между оператора и Kubernetes. Kubernetes има възможност да повтори събитието, което се е случило. Той го повтаря. А задачата на оператора е да направи така, че когато бъде извършен възпроизвеждане на логовете на събитията, тези събития да бъдат идемпотентни. И повторното възникване на същото събитие да не счупи нашата система. И нашият оператор се справя с тази задача.
Здравейте! Благодаря за доклада! Дмитрий Завялов, компания Смедова. Планира ли се добавяне на възможност за настройка на оператор с haproxy? Интересува ни някакъв друг балансировщик, освен стандартния, който да е умно и да разбира, че там реално е ClickHouse.
Говорите ли за Ingress?
Да, Ingress да се замени с haproxy. В haproxy можете да зададете топологията на кластера, където са неговите реплики.
Все още не сме мислили по това. Ако ви е необходимо и можете да обясните защо, може да реализираме, особено ако искате да участвате. С удоволствие ще разгледаме варианта. Краткият отговор е – не, в момента нямаме такава функционалност. Благодаря за предложението, ще се запознаем с това. А ако обясните use case и защо е необходимо на практика, например, да създадете проблеми в GitHub, би било прекрасно.
Вече има.
Добре. Ние сме отворени за всякакви предложения. И haproxy е в списъка за работа. Списъкът за работа нараства, а не намалява засега. Но това е хубаво, означава, че продуктът е търсен.
Източник: habr.com
