

Прим. прев.: В тази статия компанията Banzai Cloud споделя пример за употреба на своите специализирани утилити, за да улесни експлоатацията на Kafka в контекста на Kubernetes. Приведените инструкции илюстрират как може да определите оптималния размер на инфраструктурата и да настроите самата Kafka за постигане на необходимата пропускна способност.
Apache Kafka е разпределена стрийминг платформа за изграждане на надеждни, мащабируеми и високопроизводителни поточни системи в реално време. Нейните впечатляващи възможности могат да бъдат разширени с помощта на Kubernetes. За тази цел разработихме и инструмент наречен . Те позволяват стартиране на Kafka в Kubernetes и използване на различните й функции, като прецизна настройка на конфигурацията на брокера, мащабиране на базата на метрики с ребалансировка, rack awareness (осведоменост за хардуерни ресурси), 'меко' (graceful) приспособление на актуализации и т.н.
Опитайте Supertubes в своя кластер:
curl https://getsupertubes.sh | sh и supertubes install -a --no-democluster --kubeconfigИли се свържете с нашето . Също така можете да прочетете за някои от възможностите на Kafka, с обработката на които се занимават Supertubes и Kafka оператор. За тях вече писахме в блога:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Когато решите да разположите кластер Kafka в Kubernetes, вероятно ще се сблъскате с проблема за определяне на оптималния размер на базовата инфраструктура и необходимостта от прецизна настройка на конфигурацията на Kafka, за да отговорите на изискванията за пропускна способност. Максималната производителност на всеки брокер се определя от производителността на основните компоненти на инфраструктурата, като памет, процесор, скорост на диска, пропускна способност на мрежата и др.
Оптималната конфигурация на брокера трябва да бъде такава, че всички елементи на инфраструктурата да се използват на максимума на възможностите си. Въпреки това, в реалността такава настройка е изключително сложна. По-вероятно е потребителите да конфигурират брокерите по начин, който максимизира използването на един или два компонента (диск, памет или процесор). По принцип, брокерът демонстрира максимална производителност, когато конфигурацията му позволява да използва най-бавния компонент „на пълна скорост“. По този начин можем да получим приблизителна представа за натоварването, с което един брокер може да се справи.
Теоретично, ние също можем да оценим броя на брокерите, необходими за работа с определено натоварване. Въпреки това, на практика вариантите за настройка на различните нива са толкова много, че е трудно (ако не и невъзможно) да се оцени потенциалната производителност на дадена конфигурация. С други думи, много е сложно да се планира конфигурация, основаваща се на определена производителност.
За потребителите на Supertubes обикновено прилагаме следния подход: започваме с определена конфигурация (инфраструктура + настройки), след това измерваме производителността й, коригираме настройките на брокера и повторяваме процеса отново. Това продължава, докато потенциалът на най-бавния компонент на инфраструктурата не бъде напълно използван.
По този начин получаваме по-ясна представа за това колко брокери са необходими на клъстера, за да се справи с определено натоварване (бройът на брокерите също зависи от други фактори, като минималния брой на репликите на съобщенията за осигуряване на устойчивост, броя на лидерите на партиции и т.н.). Освен това получаваме представа за какъв инфраструктурен компонент е желателно вертикалното мащабиране.
В тази статия ще разгледаме стъпките, които предприемаме, за да „извлечем всичко“ от най-бавните компоненти в началните конфигурации и да измерим производителността на клъстера Kafka. Високоустойчивата конфигурация изисква поне три работещи брокера (min.insync.replicas=3), разпределени по три различни зони на достъпност. За настройка, мащабиране и мониторинг на инфраструктурата Kubernetes използваме собствената си платформа за управление на контейнери за хибридни облаци — . Тя поддържа on-premise (bare metal, VMware) и пет типа облаци (Alibaba, AWS, Azure, Google, Oracle), както и всякакви комбинации между тях.
Мисли относно инфраструктурата и конфигурацията на кластера Kafka
За примерите, представени по-долу, избрахме AWS като доставчик на облачни услуги и EKS като дистрибуция на Kubernetes. Подобна конфигурация може да бъде реализирана с — дистрибуция на Kubernetes от Banzai Cloud, сертифицирана от CNCF.
Диск
Amazon предлага различни . В основата gp2 и io1 са SSD дискове, но за осигуряване на висока пропускна способност gp2 консумира натрупаните кредити (I/O кредити), затова предпочетохме тип io1, който предлага стабилна висока пропускна способност.
Типове инстанции
Производителността на Kafka зависи силно от кеша на страниците на операционната система, затова ни трябват инстанции с достатъчно количество памет за брокерите (JVM) и кеша на страниците. Инстанцията c5.2xlarge е добро начало, тъй като има 16 Гб памет и Недостатъкът ѝ е, че може да осигурява максимална производителност не повече от 30 минути на всеки 24 часа. Ако работната натовареност изисква максимална производителност за по-дълъг период от време, трябва да разгледате и други типове инстанции. Ние точно такова решение взехме, спирайки се на c5.4xlarge. Тя осигурява максимална пропускна способност от 593,75 Мб/с. Максималната пропускна способност на EBS тома io1 е по-висока от тази на инстанцията c5.4xlarge, затова най-бавният елемент в инфраструктурата очевидно е пропускната способност I/O на този тип инстанция (което също трябва да потвърдят резултатите от нашите стрес тестове).
Мрежа
Пропускната способност на мрежата трябва да е достатъчно голяма в сравнение с производителността на инстанцията VM и диска, в противен случай мрежата става тясно място. В нашия случай мрежовият интерфейс c5.4xlarge поддържа скорост до 10 Гб/с, което е значително по-високо от пропускната способност I/O на инстанцията VM.
Разгръщане на брокерите
Брокерите трябва да се разгръщат (планират в Kubernetes) на отделни възли, за да се избегне конкуренцията с другите процеси за ресурси на процесора, паметта, мрежата и диска.
Версия на Java
Логичният избор е Java 11, тъй като е съвместима с Docker в смисъл, че JVM правилно определя процесорите и паметта, налични в контейнера, в който работи брокерът. Като знаем, че лимитите по процесорите са важни, JVM вътрешно и прозрачно задава броя на GC нишките и нишките на JIT компилатора. Използвахме образ Kafka banzaicloud/kafka:2.13-2.4.0, включващ версия Kafka 2.4.0 (Scala 2.13) на Java 11.
Ако искате да научите повече за Java/JVM на Kubernetes, обърнете внимание на следните наши публикации:
- ;
- .
Настройки на паметта на брокера
Съществуват два ключови аспекта при настройката на паметта на брокера: настройки за JVM и за pod в Kubernetes. Пределът на паметта, зададен за pod, трябва да бъде по-голям от максималния heap size, за да остане място за метапространството на Java, което се намира в собствената памет, и за страничния кеш на операционната система, който Kafka активно използва. В нашите тестове стартирахме брокери Kafka с параметри -Xmx4G -Xms2G, а пределът на паметта за pod беше 10 Gi. Обърнете внимание, че настройките на паметта за JVM могат да се получат автоматично чрез -XX:MaxRAMPercentage и -X:MinRAMPercentage, в зависимост от лимита на паметта за pod.
Настройки на процесора на брокера
По принцип, може да се повиши производителността, като се увеличи паралелизмът чрез увеличаване на броя на нишките, използвани от Kafka. Колкото повече процесори са налични за Kafka, толкова по-добре. В нашия тест започнахме с лимит от 6 процесора и постепенно (чрез итерации) увеличихме броя им до 15. Освен това зададохме num.network.threads=12 в настройките на брокера, за да увеличим броя на нишките, приемащи данни от мрежата и изпращащи ги. Веднага открихме, че брокерите-следователи не могат да получават реплики достатъчно бързо, и увеличихме num.replica.fetchers до 4, за да увеличим скоростта, с която брокерите-следователи репликираха съобщения от лидерите.
Инструмент за генериране на натоварване
Трябва да се уверите, че потенциалът на избрания генератор на натоварване няма да изчерпи, преди клъстерът Kafka (чийто бенчмарк се извършва) да достигне максималното си натоварване. С други думи, необходимо е предварително да се оцени възможностите на инструмента за генериране на натоварване и да се изберат типове инстанции с достатъчно количество процесори и памет. В този случай нашият инструмент ще генерира повече натоварване, отколкото клъстерът Kafka може да обработи. След множество експерименти, спряхме на три инстанции c5.4xlarge, в които беше стартиран генератор.
Бенчмаркинг
Измерването на производителността е итеративен процес, включващ следните етапи:
- настройка на инфраструктурата (клъстера EKS, клъстера Kafka, инструмента за генериране на натоварване, а също и Prometheus и Grafana);
- генериране на натоварване за определен период с цел филтриране на случайни отклонения в събираните показатели за производителност;
- настройка на инфраструктурата и конфигурацията на брокера на базата на наблюдаваните показатели за производителност;
- повтаряне на процеса, докато не се достигне необходимото ниво на производителност на клъстера Kafka. При това то трябва да бъде стабилно възпроизводимо и да демонстрира минимални вариации в производителността.
В следващия раздел са описани стъпките, които бяха извършени в процеса на бенчмарка на тестовия клъстер.
Инструменти
За бързо развъртане на базовата конфигурация, генериране на натоварване и измерване на производителността, бяха използвани следните инструменти:
- за организиране на клъстер EKS от Amazon с (за събиране на метрики на Kafka и инфраструктурата) и (за визуализиране на тези метрики). Ние използвахме интегрираните в услуги, които осигуряват федерално наблюдение, централизирано събиране на логове, сканиране на уязвимости, възстановяване след сривове, корпоративна сигурност и много други.
- — инструмент за натоварочно тестване на клъстера Kafka.
- Панели Grafana за визуализиране на метрики на Kafka и инфраструктурата: , .
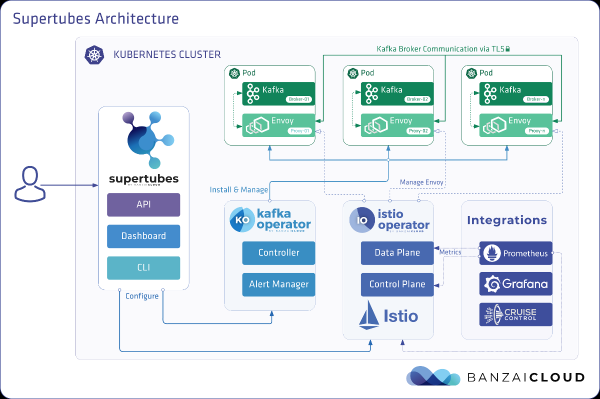
- Supertubes CLI за лесен достъп до конфигурирането на Kafka кластер в Kubernetes. Zookeeper, Kafka оператор, Envoy и множество други компоненти са инсталирани и конфигурирани за стартиране на готов за продукция Kafka кластер в Kubernetes.
- За инсталация supertubes CLI възползвайте се от инструкциите, посочени .
EKS кластер
Подгответе EKS кластер с отделни работни възли c5.4xlarge в различни налични зони за pod-ове с Kafka брокери, както и отделни възли за генератора на натоварване и мониторингова инфраструктура.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonКогато EKS клъстера бъде готов, активирайте интегрираната му — тя ще разиграе Prometheus и Grafana в клъстера.
Системни компоненти на Kafka
Инсталирайте системните компоненти на Kafka (Zookeeper, kafka-operator) в EKS с помощта на supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKafka кластер
По подразбиране в EKS се използват EBS обеми от тип gp2, затова е необходимо да създадете отделен клас за съхранение на базата на обеми io1 за Kafka клъстера:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Задайте параметъра за брокерите min.insync.replicas=3 и разиграйте под-овете на брокерите на възли в три различни налични зони:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Топици
Стартирахме паралелно три инстанции на генератора на натоварване. Всяка от тях записва в своя топик, което означава, че ни трябват три топика:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
За всеки топик факторът на репликация е 3 — минимално препоръчително значение за високодостъпни продукционни системи.
Инструмент за генериране на натоварване
Стартирахме три инстанции на генератора на натоварване (всяка записваше в отделна тема). За pod-овете на генератора на натоварване е необходимо да се определи node affinity, така че те да се планират само на определените за тях възли:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Няколко важни момента, на които да се обърне внимание:
- Генераторът на натоварване генерира съобщения с дължина 512 байта и ги публикува в Kafka на партиди по 500 съобщения.
- Чрез аргумента
-required-acks=allпубликацията се счита за успешна, когато всички синхронизирани реплики на съобщението са получени и потвърдени от брокерите на Kafka. Това означава, че в бенчмарка измервахме не само скоростта на работа на лидерите, получаващи съобщения, но и техните последователи, репликиращи съобщения. Целта на този тест не е да оцени скоростта на четене от потребителите (consumers) на наскоро приети съобщения, които все още остават в страницовия кеш на операционната система, и нейното сравнение със скоростта на четене на съобщения, съхранявани на диска. - Генераторът на натоварване паралелно стартира 20 worker-а (
-workers=20). Всеки worker съдържа 5 producer-а, които съвместно използват връзката на worker-а с кластера Kafka. В крайна сметка всеки генератор има 100 producer-а, и всички те изпращат съобщения в кластера Kafka.
Наблюдение на състоянието на клъстера
По време на стрес теста на кластера Kafka също следяхме за неговото здравословно състояние, за да се уверим, че няма рестартиране на pod-ове, несинхронизирани реплики и максимална пропускна способност с минимални флуктуации:
- Генераторът на натоварване пише стандартна статистика за броя на публикуваните съобщения и нивото на грешки. Процентът на грешките трябва да остане на стойност
0,00%. - , разгръщан от kafka-operator, предоставя табло за мониторинг, на което можем да наблюдаваме състоянието на кластера. За да видите това табло, изпълнете:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Нивото на ISR (брой реплики „в синхрон“) shrink и expansion е равен на 0.
Резултатите от измерванията
3 брокера, размер на съобщенията — 512 байта
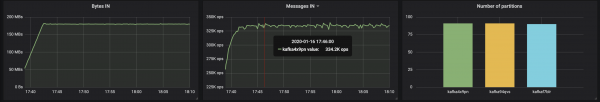
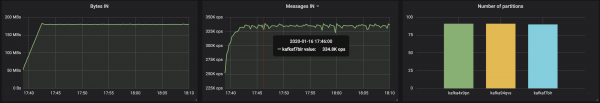
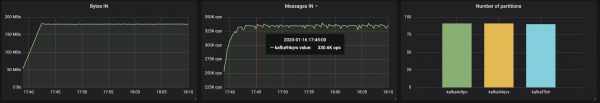
С partition-и, равномерно разпределени на трите брокера, успяхме да постигнем производителност ~500 Мб/с (приблизително 990 хил. съобщения в секунда):
Консумацията на памет от виртуалната машина JVM не надвишава 2 Гб:
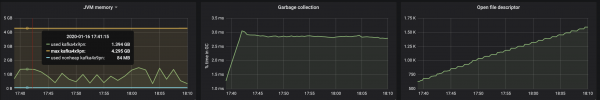
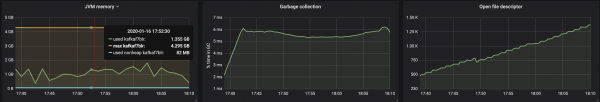
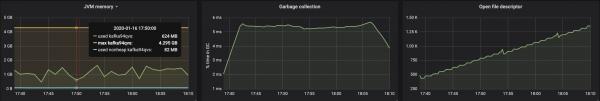
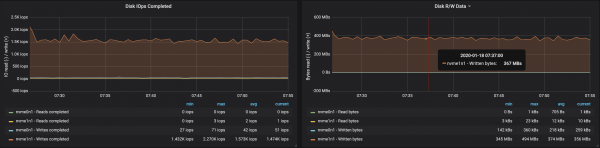
Пропускната способност на диска достига максималната пропускна способност I/O на възела на всички три инстанции, на които работят брокерите:
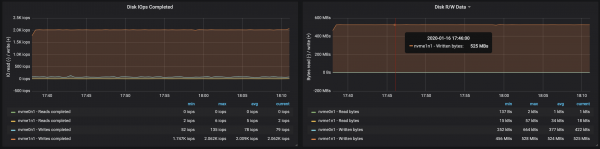
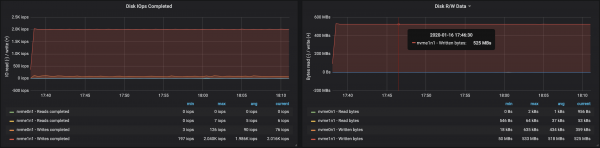
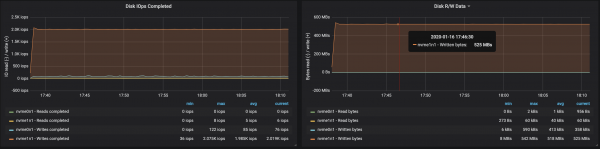
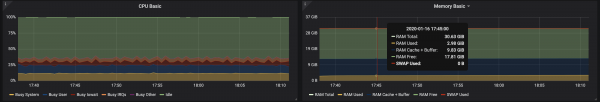
От данните за използването на паметта от възлите следва, че системното буфериране и кеширане заемат ~10-15 Гб:
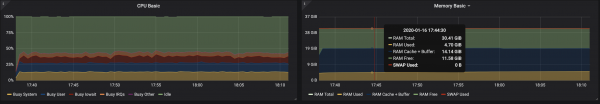
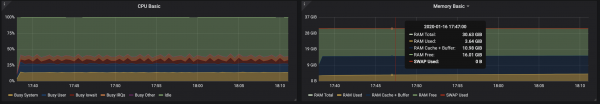
3 брокера, размер на съобщенията — 100 байта
С намаляване на размера на съобщенията пропускната способност пада с около 15-20%: отразява се времето, необходимо за обработка на всяко съобщение. Освен това натоварването на процесора се е удвоило.
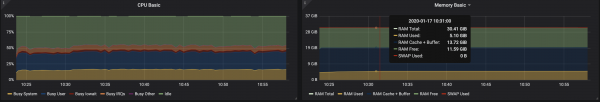
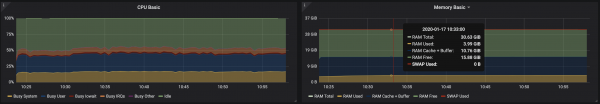
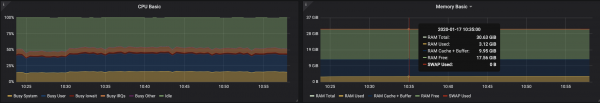
Тъй като на възлите на брокерите все още има неизползвани ядра, производителността може да се повиши чрез промяна на конфигурацията на Kafka. Това е сложно, затова за увеличаване на пропускната способност е по-добре да се работи със съобщения с по-голям размер.
4 брокера, размер на съобщенията — 512 байта
Може лесно да се увеличи производителността на кластера Kafka, просто добавяйки нови брокери и запазвайки баланса на partition-ите (което осигурява равномерно разпределение на натоварването между брокерите). В нашия случай, след добавяне на брокер, пропускната способност на кластера нарасна до ~580 Мб/с (~1,1 млн. съобщения в секунда). Растежът се оказа по-малък от очакваното: предимно това се обяснява с дисбаланса на partition-ите (не всички брокери работят на пиковите си възможности).
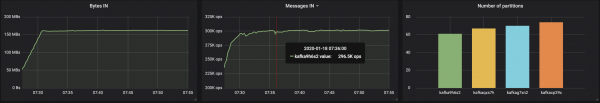
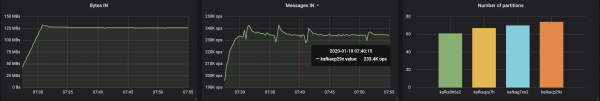
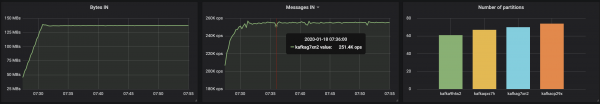
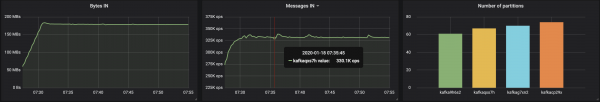
Потреблението на памет от JVM машината остава под 2 Гб:
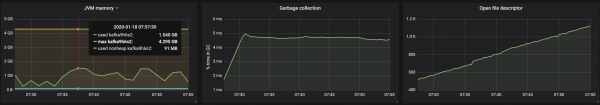
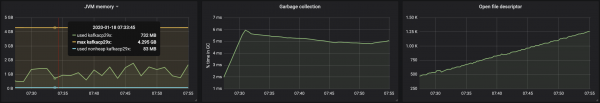
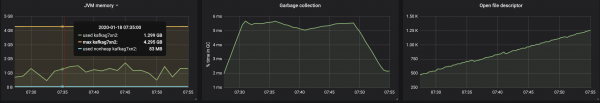
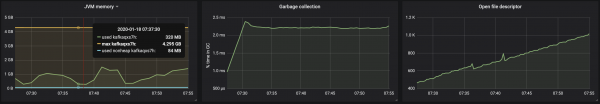
Работата на брокерите с хранилища беше засегната от несъответствието на дяловете:
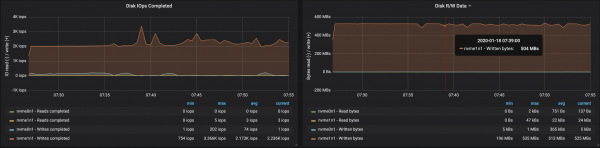
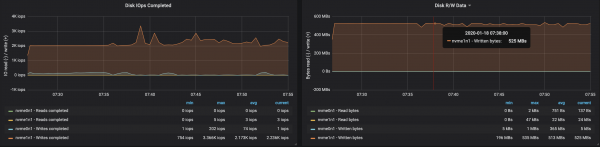
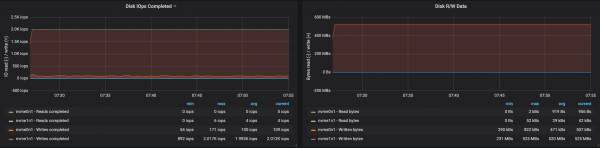
Изводи
Предложеният по-горе итеративен подход може да бъде разширен, за да обхване по-сложни сценарии, включващи стотици потребители, повторно партициониране, накатвани актуализации, рестартиране на подове и т.н. Всичко това ни позволява да оценим пределите на възможностите на Kafka клъстер при различни условия, да идентифицираме тесните места в неговата работа и да намерим начини за справяне с тях.
Разработихме Supertubes за бързо и лесно разгръщане на клъстера, конфигуриране, добавяне/премахване на брокери и теми, реагиране на известия и осигуряване на коректната работа на Kafka в Kubernetes като цяло. Нашата цел е да помогнем да се концентрирате върху основната задача („генериране“ и „консумиране“ на Kafka съобщения), а цялата тежка работа да оставим на Supertubes и Kafka оператора.
Ако се интересувате от технологии и Open Source проекти на Banzai Cloud, абонирайте се за компанията в , или .
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
