

В Sitimobil използваме базата данни MySQL като основно хранилище за постоянни данни. Имаме няколко клъстера на бази данни за различни услуги и цели.
Постоянната наличност на мастера е критичен показател за работоспособността на цялата система и нейните отделни части. Автоматичното възстановяване на клъстера при отказ на мастера значително намалява времето за реакция на инцидента и времето на престой на системата. В тази статия ще разгледам схемата за осигуряване на висока наличност (HA) на MySQL клъстера на базата на и виртуални IP адреси (VIP).
HA решение на база VIP
Първо ще разкажа накратко какво представлява нашата система за съхранение на данни.
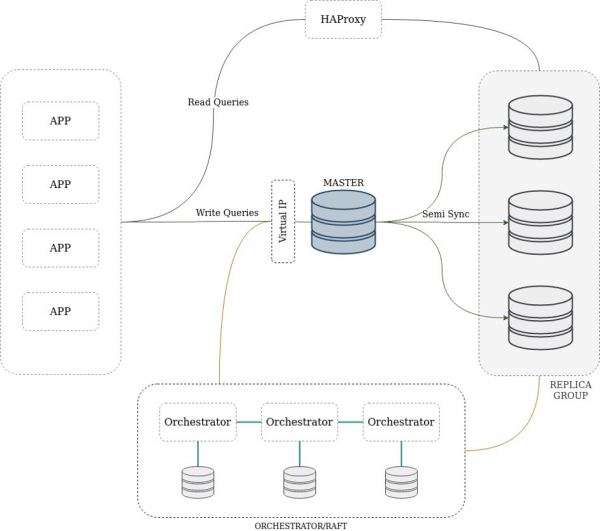
Използваме класическа схема на репликация с един мастер, който е достъпен за запис, и множество реплики, които се използват само за четене. Клъстерът може да съдържа междинен мастер — възел, който е едновременно реплика и мастер за други. Клиентите се свързват с репликите чрез HAProxy, което позволява равномерно разпределение на натоварването и лесно мащабиране. Използването на HAProxy е свързано с исторически причини и в момента сме в процес на миграция към ProxySQL.
Репликацията се извършва в полусинхронен режим на база GTID. Това означава, че поне една реплика трябва да запише транзакцията в журнала, преди тя да бъде призната за успешна. Този режим на репликация осигурява оптимален баланс между производителността и запазването на данните в случай на отказ на главния възел. Основно всички промени се предават от мастера към репликите с помощта на Row Based Replication (RBR), но част от възлите могат да имат mixed binlog format.
Оркестраторът периодично актуализира състоянието на топологията на клъстера, анализира получената информация и в случай на проблеми може да стартира процедурата за автоматично възстановяване. За самата процедура отговаря разработчикът, тъй като тя може да бъде реализирана по различни начини: на база VIP, DNS, с използване на услуги за откриване на услуги (service discovery) или самописни механизми.
Един от простите начини за възстановяване на мастера при отказа му е използването на плаващи VIP адреси.
Какво трябва да знаете за това решение, преди да продължим:
- VIP е IP адрес, който не е свързан с конкретен физически мрежови интерфейс. При повреда на възел или при планирани дейности можем да преместим VIP на друг ресурс с минимално време на простои.
- Освобождаването и предоставянето на виртуален IP адрес са евтини и бързи операции.
- За работа с VIP е необходим достъп до сървъра чрез SSH, или използване на специални утилити, например,
keepalived.
Да разгледаме възможните проблеми с нашия мастер и да видим как трябва да работи механизма за автоматично възстановяване.
Мрежовата свързаност с мастера е загубена, или е възникнал проблем на ниво „желязо“, и сървърът не е достъпен.
- Оркестраторът обновява топологията на кластера, всяка реплика съобщава за недостъпност на мастера. Оркестраторът стартира процеса за избор на реплика, подходяща за нов мастер, и започва възстановяване.
- Опитваме се да премахнем VIP от стария мастер — безуспешно.
- Репликата преминава в ролята на мастер. Топологията се преустройва.
- Добавяме нов мрежови интерфейс с VIP. Тъй като не успяхме да премахнем VIP, в фонов режим стартираме периодично изпращане на заявка gratuitous ARP. Този вид заявка/отговор позволява да се обнови таблицата за съвпадение на IP и MAC адреси на свързаните комутатори, уведомявайки за преместването на нашия VIP. Това минимизира вероятността за
split brainпри връщането на стария мастер. - Всички нови връзки веднага се пренасочват към новия мастер. Старите връзки завършват неуспешно, извършват се повторни обръщения към БД на ниво приложение.
Сървърът работи в нормален режим, е настъпила отказ на ниво СУБД.
Алгоритъмът е аналогичен на предишния случай: обновяване на топологията и стартиране на процеса на възстановяване. Тъй като сървърът е достъпен, успешно освобождаваме VIP на стария мастер, прехвърляме го на новия и изпращаме няколко ARP заявки. Поверителното вършане на стария мастер не трябва да повлияе на преустроения клъстер и работата на приложението.
Други проблеми
Отказ на реплики или междинни мастери не води до автоматични действия и изисква ръчно намесване.
Виртуалният мрежов интерфейс се добавя временно, тоест след рестартиране на сървъра, VIP не се назначава автоматично. Всеки екземпляр на БД по подразбиране се стартира в режим само за четене, orchestrator автоматично премества новия master в режим за запис и опитва да установи само за четене на стария master. Тези действия са насочени към намаляване на вероятността split brain.
При възстановяване могат да възникнат проблеми, които също да бъдат уведомявани чрез UI на orchestrator, освен стандартните средства за мониторинг. Разширихме REST API, добавяйки такава възможност ( в момента е под разглеждане).
Общата схема на HA-решение е представена по-долу.
Избор на нов master
Orchestrator е достатъчно умен и се опитва да избере като нов master според следните критерии:
- отклонение на репликата от master;
- версията на MySQL на master и репликата;
- тип репликация (RBR, SBR или смесена);
- разположение в един или различни дата-центрове;
- наличие
errant GTID— транзакции, които са били изпълнени на репликата и отсъстват на master; - също така се вземат предвид потребителски правила за избор.
Не всяка реплика е идеален кандидат за ролята на master. Например, репликата може да се използва за архивиране на данни или сървърът има по-слаба конфигурация на 'желязото'. Orchestrator разполага с ръчни правила, посредством които е възможно да настроите собствените си предпочитания за избор на кандидат от най-предпочитаните до игнорираните.
Време за реакция и възстановяване
При инцидент е важно да се минимизира времето на престой на системата, затова ще разгледаме параметрите на MySQL, които влияят на изграждането и обновлението на топологията на клъстера от orchestrator:
- — броят на секундите, в които репликата очаква получаване на нови данни или heartbeat сигнал от master, преди връзката да бъде призната за загубена и да се извърши повторно свързване. Колкото по-малко е значението, толкова по-бързо репликата може да определи, че връзката с master е нарушена. Настройваме тази стойност на 5 секунди.
- — броят секунди между опитите за повторно свързване. В случай на мрежови проблеми ниската стойност на този параметър ще позволи бързо повторно свързване и ще предотврати стартирането на процеса на възстановяване на кластера. Препоръчителната стойност е 1 секунда.
MASTER_RETRY_COUNT— максимален брой опити за повторно свързване.MASTER_HEARTBEAT_PERIOD— интервал в секунди, след който мастера изпраща heartbeat сигнал. По подразбиране е равен на половината от стойносттаslave_net_timeout.
Параметри на оркестратора:
DelayMasterPromotionIfSQLThreadNotUpToDate— ако е равен наистинно, ролята на мастера няма да бъде приложена на кандидат репликата, докато SQL потока на репликата не изпълни всички неприложени транзакции от Relay Log. Използваме тази опция, за да не загубим транзакции в условия на изоставащи кандидати.InstancePollSeconds— честота на създаване и обновяване на топологията.RecoveryPollSeconds— честота на анализ на топологията. В случай на открит проблем, възстановяването на топологията се стартира. Това е, равна на 1 секунда.
Всеки възел на кластера се запитва от оркестратора веднъж на InstancePollSeconds секунди. При открит проблем, състоянието на кластера се актуализира принудителноТестовете на HA схемата започнахме с развитието на локален
Тестов стенд
тестов стенд По време на ученията избираме един от методите за емулация на проблема: незабавно изключване на мастера с помощта на
, нежно прекратяване на процеса и спиране на сървъра ( kill -9docker-compose stop), имитиране на проблеми с мрежата с помощта наiptables -j REJECT iptables -j DROP или . Очакваме такива резултати:оркестраторът да открие проблеми с мастера и да обнови топологията не повече от 10 секунди;
- процедурата за възстановяване да стартира автоматично: мрежовата конфигурация да се промени, ролята на мастера да премине на реплика, топологията да се преизгради;
- автоматично ще стартира процедура за възстановяване: ще се промени мрежовата конфигурация, ролята на майстора ще премине към репликата, топологията ще се реконструира;
- новият майстор ще стане достъпен за запис, живите реплики няма да бъдат загубени в процеса на реконструкция;
- данните ще започнат да се записват в новия майстор и да се репликират;
- общото време за възстановяване няма да надвишава 30 секунди.
Както знаете, системата може да се държи по различен начин в тестови и производствени среди поради различна конфигурация на хардуера и мрежата, различия в синтетичното и реалното натоварване и т.н. Затова периодично провеждаме учения при реални условия, проверявайки как се държи системата при загуба на мрежова свързаност или деградация на отделни части. В бъдеще искаме да изградим напълно идентична инфраструктура за двете среди и да автоматизираме нейното тестване.
Изводи
Работоспособността на главния възел на системата за съхранение на данни е една от основните задачи на екипа SRE и експлоатация. Внедряването на оркестратор и HA-решение на базата на VIP позволи да се постигнат следните резултати:
- надеждно откритие на проблеми с топологията на кластера на базата данни;
- автоматично и бързо реагиране на инциденти, свързани с майстора, което намалява времето на простоя на системата.
Въпреки това, решението има своите ограничения и недостатъци:
- мащабироването на HA схемата на различни ЦОД-и ще изисква наличието на единна L2 мрежа между тях;
- преди да назначим VIP на новия майстор, трябва да го освободим от стария. Процесът е последователен, което увеличава времето за възстановяване;
- освобождаването на VIP изисква SSH достъп до сървъра, или друг метод за извикване на отдалечени процедури. Тъй като сървърът или базата данни изпитват проблеми, които предизвикват процеса на възстановяване, не можем да бъдем сигурни, че освобождаването на VIP ще завърши успешно. Това може да доведе до появата на два сървъра с един и същ виртуален IP адрес и до проблем
split brain.
За да избегнем split brain, можем да използваме метода ("Shoot The Other Node In The Head"), който напълно изолира или изключва проблемния възел. Има и други начини за реализиране на висока достъпност на клъстера: комбинация от VIP и DNS, откритие на услуги и прокси-сервиси, синхронна репликация и други методи, които имат свои недостатъци и предимства.
Разказах за нашия подход към изграждането на отказоустойчив кластер MySQL. Той е лесен за внедряване и осигурява приемливо ниво на надеждност при настоящите условия. С развитието на цялата система и инфраструктурата в частност, този подход несъмнено ще еволюира.
Източник: habr.com
