

Тази пролет вече обсъдихме някои основни теми, например, и . Във втората дори обещахме да продължим да изучаваме производителността на различни много-дискови топологии в ZFS. Това е файловата система от следващо поколение, която в момента се внедрява навсякъде: от до .
Е, днес е най-подходящият ден за запознаване с ZFS, любопитни читатели. Само знайте, че по скромната оценка на разработчика на OpenZFS Мэтт Арънс, «това е наистина сложно».
Но преди да стигнем до цифрите — а те ще бъдат, обещавам — по всички опции за осемдискова конфигурация ZFS, трябва да поговорим за това, като как ZFS всъщност съхранява данни на диска.
Zpool, vdev и device
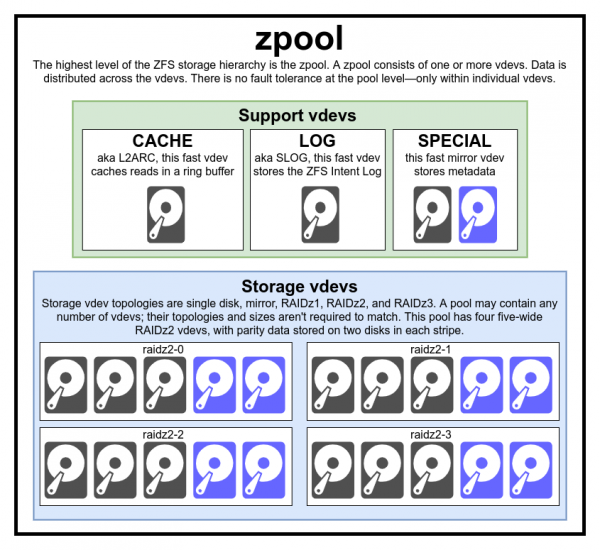
Тази диаграма на целия пул включва три допълнителни vdev, по един от всеки клас, и четири за RAIDz2
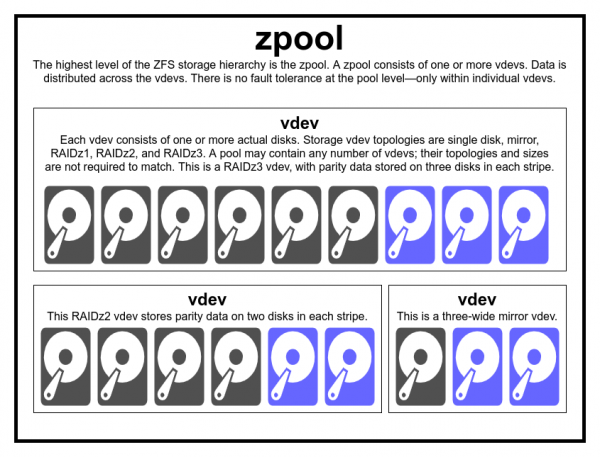
Обикновено няма причина да създавате пул от несъответстващи типове и размери vdev — но ако искате, нищо не ви пречи да го направите
За да разберете наистина файловата система ZFS, трябва да погледнете внимателно нейната действителна структура. Първо, ZFS обединява традиционните нива на управление на томове и файлови системи. Второ, тя използва механизъм на транзакционно копиране при запис. Тези характеристики означават, че системата структурно се различава много от обикновените файлови системи и RAID масиви. Първият набор основни строителни блокове, които трябва да разберете: това е пул за съхранение (zpool), виртуално устройство (vdev) и реално устройство (device).
zpool
Пулът за съхранение zpool — най-висшата структура на ZFS. Всеки пул съдържа едно или повече виртуални устройства. От своя страна, всяко от тях съдържа едно или повече реални устройства (device). Виртуалните пулове са независими блокове. Един физически компютър може да съдържа два или повече отделни пула, но всеки е напълно независим от другите. Пуловете не могат да споделят виртуални устройства.
Излишъкът на ZFS е на ниво виртуални устройства, а не на ниво пулове. На ниво пулове няма абсолютно никакъв излишък — ако някое от устройствата vdev или специално vdev загуби, заедно с него се губи и целият пул.
Съвременните хранилища могат да издържат на загуба на кеш или журнал на виртуално устройство - въпреки че могат да загубят малко количество невалидни данни, ако загубят журнала на vdev по време на спад на захранването или срив на системата.
Има разпространено заблуждение, че «данни в ленти» (страйпове) на ZFS се записват през целия пул. Това не е вярно. Zpool не е просто смешен RAID0, а по-скоро смешен с сложен променлив механизъм на разпределение.
В повечето случаи записите се разпределят между наличните виртуални устройства в зависимост от наличното свободно пространство, така че теоретично всички те ще бъдат запълнени едновременно. В по-късните версии на ZFS се взима предвид текущото използване (утилизацията) на vdev - ако едно виртуално устройство е значително по-натоварено от друго (например, заради натоварването на четене), то временно ще бъде пропуснато за запис, въпреки наличието на най-високото свободно пространство.
Механизмът за определяне на утилизацията, вградени в съвременните методи за разпределение на записите на ZFS, може да намали закъснението и да увеличи пропускателната способност в периоди на необичайно високо натоварване - но това не дава карт-бланш за неволно смесване на бавни HDD и бързи SSD в едно хранилище. Такова неравноправно хранилище все още ще функционира с скоростта на най-бавното устройство, тоест като че ли е напълно съставено от такива устройства.
vdev
Всяко хранилище се състои от едно или повече виртуални устройства (virtual device, vdev). От своя страна, всяко vdev включва едно или повече реални устройства. Повечето виртуални устройства се използват за простото съхранение на данни, но съществуват няколко допълнителни класа vdev, включително CACHE, LOG и SPECIAL. Всеки от тези типове vdev може да има една от пет топологии: единично устройство (single-device), RAIDz1, RAIDz2, RAIDz3 или огледало (mirror).
RAIDz1, RAIDz2 и RAIDz3 са специализирани разновидности на това, което старите наричат RAID с двойна (диагонална) паритет. 1, 2 и 3 се отнасят до броя на блоковете на паритета, предвидени за всяка лента от данни. Вместо отделни дискове за осигуряване на паритет, виртуалните RAIDz устройства разпределят равномерно този паритет между дисковете. RAIDz масив може да загуби толкова дискове, колкото има блокове на паритета; ако загуби още един, ще се повреди и ще вземе със себе си хранилищния пул.
В огледалните виртуални устройства (mirror vdev) всеки блок се съхранява на всяко устройство в vdev. Въпреки че най-разпространените са двойни огледала (two-wide), в огледалото може да има произволен брой устройства – в големи инсталации за повишаване на производителността на четенето и отказоустойчивостта често се използват тройни. Огледалото vdev може да оцелее при всякакъв отказ, стига да работи поне едно устройство в vdev.
Единичните vdev са по същество опасни. Такова виртуално устройство не може да оцелее при никакъв отказ – и ако се използва за хранилище или специален vdev, отказът му ще доведе до унищожаване на целия пул. Бъдете много, много внимателни тук.
Виртуалните устройства CACHE, LOG и SPECIAL могат да бъдат създадени в която и да е от горепосочените топологии – но помнете, че загуба на виртуално устройство SPECIAL означава загуба на пула, затова е силно препоръчително да имате излишна топология.
устройство
Вероятно това е най-лесно разбираемият термин в ZFS – това е буквално блочно устройство за произволен достъп. Помнете, че виртуалните устройства се състоят от отделни устройства, а пулът е съставен от виртуални устройства.
Дискът – магнитен или твърдотелен – е най-разпространеното блочно устройство, което се използва като строителен блок за vdev. Въпреки това, всяко устройство с дескриптор в /dev е подходящо – така че могат да се използват цялостни хардуерни RAID масиви като отделни устройства.
Простият raw файл е едно от най-важните алтернативни блочни устройства, от които може да бъде построен vdev. Тестовите пулове от представляват много удобен начин за проверка на командите на пула и за наблюдение на наличното пространство в пула или виртуалното устройство в дадената топология.
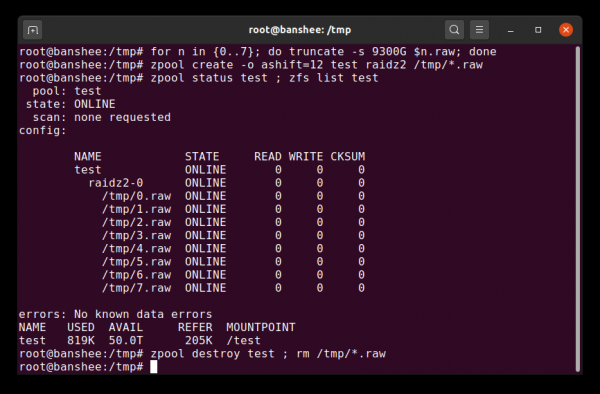
Можете да създадете тестов пул от разредени файлове само за няколко секунди – но не забравяйте после това да изтриете целия пул и неговите компоненти.
Да предположим, че искате да инсталирате сървър с осем диска и планирате да използвате диск по 10 ТБ (~9300 ГиБ) – но не сте сигурни коя топология най-добре отговаря на вашите нужди. В представения по-горе пример ние изграждаме тестов пул от разредени файлове за броени секунди – и сега знаем, че RAIDz2 vdev с осем диска по 10 ТБ осигурява 50 ТиБ полезна капацитет.
Още един специален клас устройства – SPARE (резерви). Устройствата за гореща замяна, за разлика от обикновените устройства, принадлежат на целия пул, а не на едно виртуално устройство. Ако някое vdev в пула се провали, а резервното устройство е свързано към пула и е достъпно, то автоматично ще се свърже с повреденото vdev.
След свързването с повреденото vdev резервното устройство започва да получава копия или реконструкции на данни, които трябва да бъдат на липсващото устройство. В традиционния RAID това се нарича възстановяване (rebuilding), а в ZFS – "възстановяване на излишъка" (resilvering).
Важно е да отбележим, че резервните устройства не заменят трайно провалените устройства. Те са само временно решение за намаляване на времето, през което vdev е в деградация. След като администраторът замени проваленото устройство vdev, започва възстановяване на излишъка на това трайно устройство, а SPARE се отделя от vdev и се връща обратно като резервно за целия пул.
Набори данни, блокове и сектори
Следващият набор от строителни блокове, който трябва да разберем в нашето пътешествие из ZFS, се отнася не толкова до хардуера, а до начина, по който са организирани и съхранявани самите данни. Тук пропускаме няколко нива – като metaslab – за да не затрупваме с детайли, запазвайки разбирането на общата структура.
Набор данни (dataset)
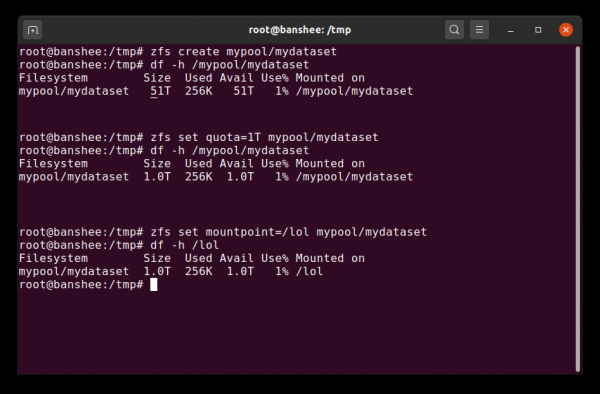
Когато за първи път създадем набор данни, той показва всичкото налично пространство на пула. След това задаваме квота – и променяме точката на монтиране. Магия!
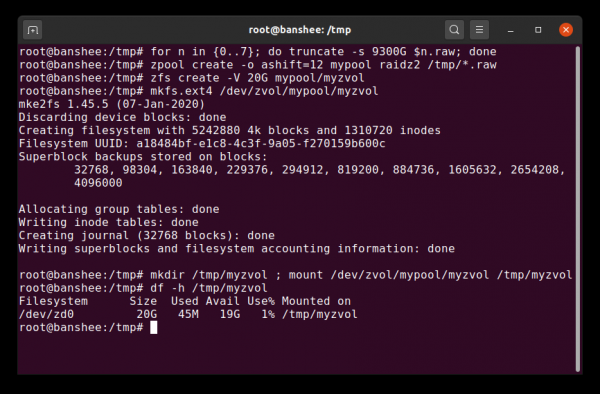
Zvol е просто набор данни, лишен от своя слой файлова система, който заменяме тук с напълно нормална файлова система ext4.
Набор данных ZFS е аналогичен стандартна монтирана файлова система. Както всяка друга файлова система, на пръв поглед той изглежда като "просто още една папка". Но както при обикновените монтирани файлови системи, всеки набор от данни ZFS има свой собствен набор от основни свойства.
На първо място, на набора от данни може да бъде зададена квота. Ако установите zfs set quota=100G poolname/datasetname, няма да можете да запишете в монтираната папка /poolname/datasetname повече от 100 ГиБ.
Забелязахте ли наличието и отсъствието на наклонени черти в началото на всяка редица? Всеки набор от данни има своето място както в йерархията на ZFS, така и в йерархията на системното монтиране. В йерархията на ZFS няма водеща наклонена черта - започвате с името на пула, а след това пътя от един набор от данни до следващия. Например, pool/parent/child за набор от данни с името child под родителския набор от данни parent в пул с креативно име pool.
По подразбиране, точката на монтиране на набора от данни ще бъде равна на неговото име в йерархията на ZFS, със слеш в началото - пул с името pool ще бъде монтиран като /pool, набор от данни parent е монтиран в /pool/parent, а дъщерният набор от данни child е монтиран в /pool/parent/child. Въпреки това, системната точка на монтиране на набора от данни може да бъде променена.
Ако зададем zfs set mountpoint=/lol pool/parent/child, наборът от данни pool/parent/child ще бъде монтиран в системата като /lol.
В допълнение към наборите от данни, трябва да споменем и томовете (zvols). Томът е приблизително аналогичен на набор от данни, с изключение на факта, че не съдържа реална файлова система - това е просто блочно устройство. Можете например да създадете zvol с името mypool/myzvol, след това да го форматирате с файлова система ext4 и след това да монтирате тази файлова система - сега имате файлова система ext4, но с поддръжка на всички функции за сигурност на ZFS! Това може да изглежда глупаво на един компютър, но има много повече смисъл като бекенд при експортиране на iSCSI устройство.
Блокове
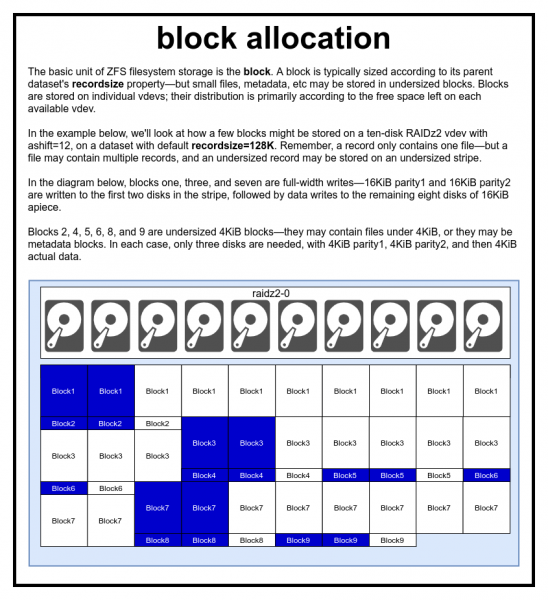
Файлът е представен от един или повече блокове. Всеки блок се съхранява на едно виртуално устройство. Размерът на блока обикновено е равен на параметъра recordsize, но може да бъде намален до 2^ashift, ако съдържа метаданни или малък файл.
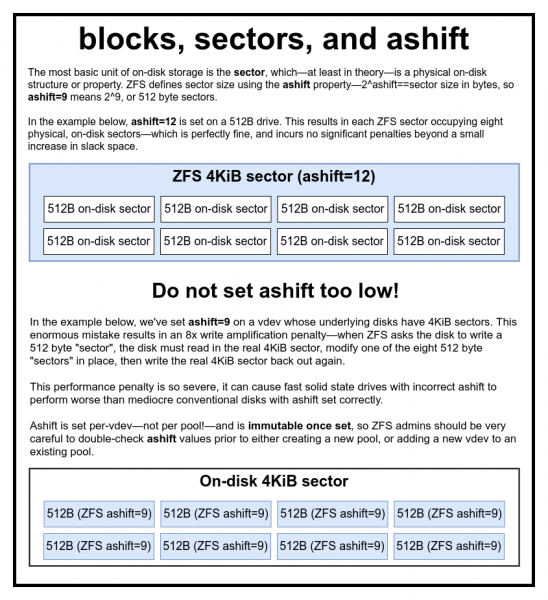
Наистина, наистина не се шегуваме относно огромния спад в производителността, ако зададете твърде малък ashift.
В пул ZFS всички данни, включително метаданни, се съхраняват в блокове. Максималният размер на блока за всеки набор от данни се определя в свойството recordsize (размер на записа). Размерът на записа може да се променя, но това няма да промени размера или разположението на всякакви блокове, които вече са били записани в набора от данни — той важи само за нови блокове при записването им.
Ако не е определено друго, текущият размер на записа по подразбиране е 128 КиБ. Това е вид сложен компромис, в който производителността няма да е идеална, но и не ужасна в повечето случаи. Recordsize може да се зададе на всяка стойност от 4K до 1M (с допълнителни настройки recordsize може да се зададе още по-голям, но това рядко е добра идея).
Всеки блок се отнася само за данни от един файл — не можете да вмъкнете два различни файла в един блок. Всеки файл се състои от един или повече блока, в зависимост от размера. Ако размерът на файла е по-малък от размера на записа, той ще се съхрани в блок с по-малък размер — например, блок с файл от 2 КиБ ще заема само един сектор от 4 КиБ на диска.
Ако файлът е достатъчно голям и изисква няколко блока, всички записи с този файл ще имат размер recordsize — включително последния запис, основната част от който може да се окаже .
При томовете zvol няма свойство recordsize — вместо това имат равно по предназначение свойство volblocksize.
Сектори
Последният, най-базов строителен блок — сектор. Това е най-малката физическа единица, която може да бъде записана или прочетена от основното устройство. През последните десетилетия в повечето дискове се използваха сектори по 512 байта. В последно време повечето дискове са настроени на сектори от 4 КиБ, а в някои — особено SSD — сектори от 8 КиБ или дори повече.
В системата ZFS има свойство, което позволява ръчно да се зададе размерът на сектора. Това свойство ashift. Малко объркващо е, че ashift е степен на две. Например, ashift=9 означава размер на сектора 2^9, или 512 байта.
ZFS изисква информация от операционната система относно всяко блоково устройство, когато то бъде добавено в нов vdev, и теоретично автоматично настройва ashift правилно на базата на тази информация. За съжаление, много дискове лъжат за размера на сектора си, за да запазят съвместимост с Windows XP (която не може да разбира дискове с различен размер на секторите).
Това означава, че администраторът на ZFS силно се препоръчва да знае действителния размер на сектора на своите устройства и да зададе ръчно ashift. Ако бъде зададен прекалено малък ashift, броят на операциите за четене/запис нараства астрономически. Например, записването на 512-байтови "сектори" в действителен сектор от 4 КиБ означава необходимостта да запишете първия "сектор", след това да прочетете сектора 4 КиБ, да го промените с втория 512-байтов "сектор", да го запишете обратно в новия сектор 4 КиБ и така нататък за всяко записване.
В реалния свят такъв такс е валиден за твърдотелни устройства Samsung EVO, за които трябва да се прилага ashift=13, но тези SSD лъжат за размера на сектора си, и затова по подразбиране се задава ashift=9. Ако опитен системен администратор не промени този параметър, то този SSD работи по-бавно като обикновен магнитен HDD.
За сравнение, при прекалено голям размер ashift практически няма такса. Няма реално намаляване на производителността, а увеличението на неизползваното пространство е безкрайно малко (или нула, когато е активирано компресирането). Затова силно препоръчваме дори на тези дискове, които наистина използват 512-байтови сектори, да зададат ashift=12 или дори ashift=13, за да гледат уверено в бъдещето.
Свойството ashift се задава за всяко виртуално устройство vdev, а не за пула, както много погрешно смятат — и не се променя след задаването. Ако случайно объркате ashift при добавянето на нов vdev в пула, то вие необратимо замърсите този пул с устройство с ниска производителност и обикновено няма друг изход, освен да унищожите пула и да започнете отначало. Дори премахването на vdev няма да спаси от неправилно зададените настройки. ashift!
Механизъм за копиране при запис
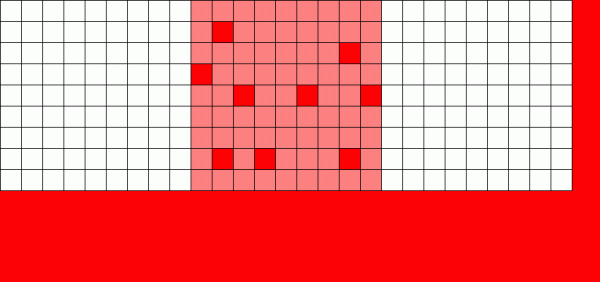
Ако обичайната файлова система трябва да презапише данни — тя променя всеки блок там, където се намира.
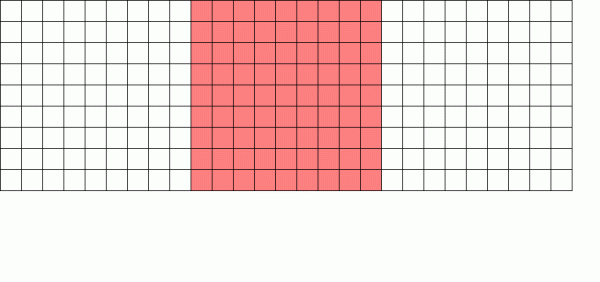
Файловата система с копиране при записване записва нова версия на блока, след което отключва старата версия.
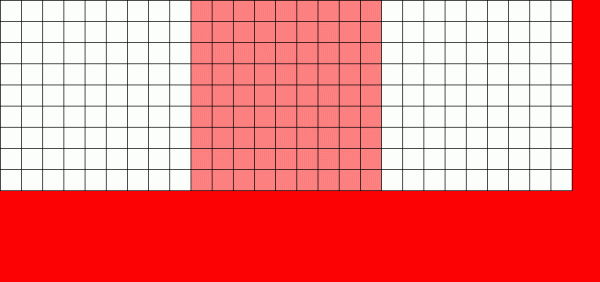
В абстрактен вид, ако игнорираме реалното физическо местоположение на блоковете, нашата „комета от данни“ се опростява до „червей от данни“, който се движи отляво надясно по картата на наличното пространство.
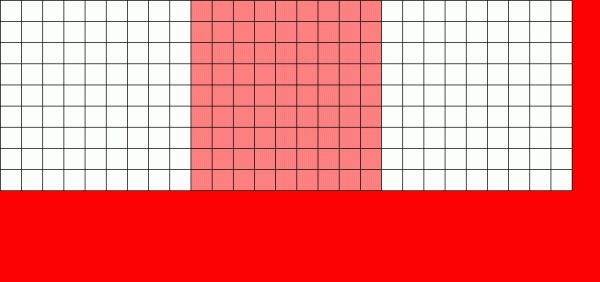
Сега можем да получим добра представа как работят моментните снимки при копиране при записване — всеки блок може да принадлежи на няколко моментни снимки и ще бъде запазен, докато не бъдат унищожени всички свързани моментни снимки.
Механизмът за копиране при записване (Copy on Write, CoW) е основната основа на това, което прави ZFS толкова впечатляваща система. Основната концепция е проста — ако поискате от традиционна файлова система да промени файл, тя ще направи точно това, което сте поискали. Ако поискате от файлова система с копиране при записване да направи същото, тя ще каже „добре“ — но ще ви излъже.
Вместо това файлова система с копиране при записване записва нова версия на изменен блока, след което актуализира метаданните на файла, за да прекъсне връзката със стария блок и да свърже новия блок, който току-що сте записали.
Откъсването на стария блок и свързването на новия става с една операция, така че не може да бъде прекъсната — ако изключите захранването след това, имате нова версия на файла, а ако изключите захранването преди това, имате стара версия. Във всеки случай, конфликтите в файловата система няма да възникнат.
Копирането при записване в ZFS се случва не само на ниво файлова система, но и на ниво управление на дисковете. Това означава, че ZFS не е подложена на пропуск в записа () — феномен, при който лентата успява да запише само частично преди срив на системата, с повреда на масива след перезареждане. Тук лентата се записва атомарно, vdev винаги е последователен, и .
ZIL: журнал на намеренията на ZFS.
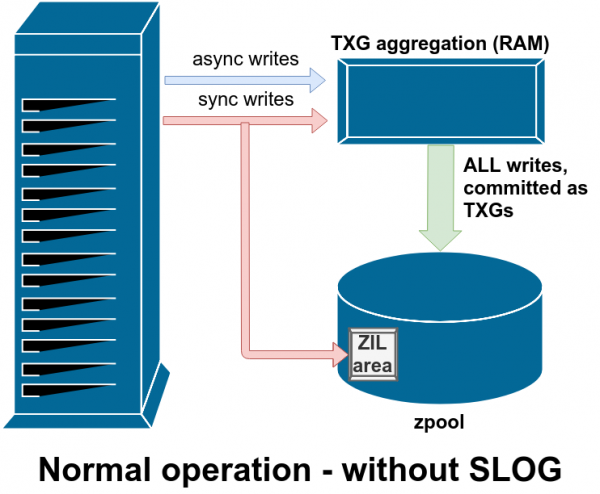
Системата ZFS обработва синхронни записи по специален начин — временно, но незабавно ги запазва в ZIL, преди по-късно да ги запише постоянно заедно с асинхронните записи.
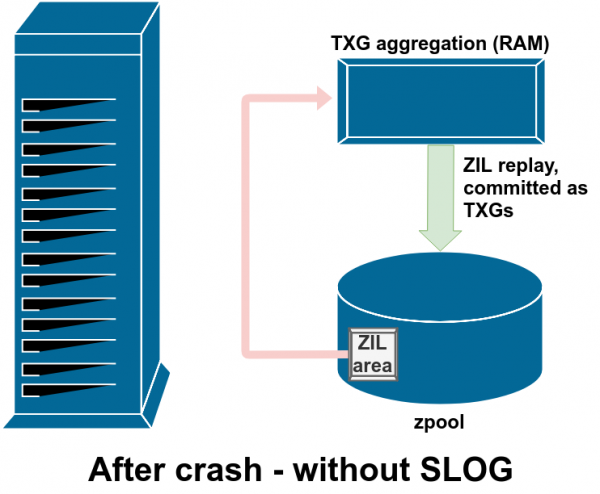
Обикновено данните, записани на ZIL, никога повече не се четат. Но това е възможно след срив на системата.
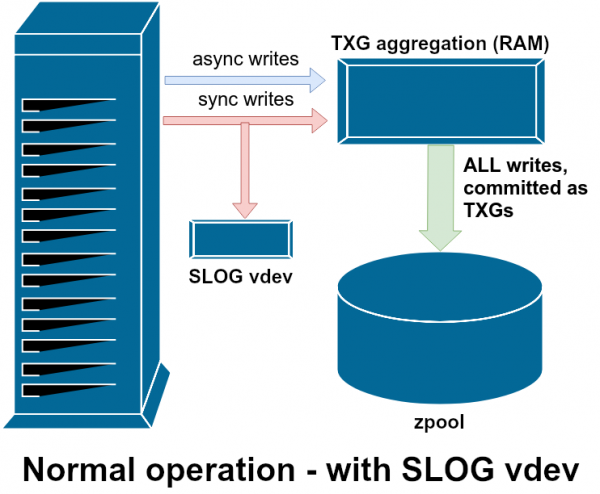
SLOG, или вторично логично устройство, представлява специализирано - и желателно много бързо - vdev, където ZIL може да се съхранява отделно от основното хранилище.
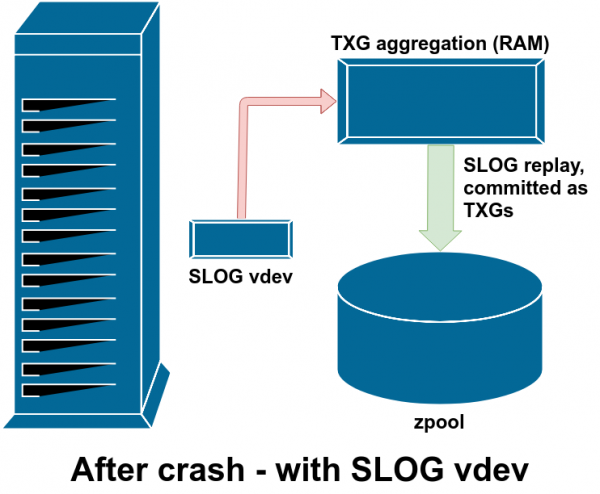
След срив всички замърсени данни в ZIL се възпроизвеждат - в този случай ZIL е на SLOG, така че те се възпроизвеждат точно оттам.
Има две основни категории операции на запис - синхронни (sync) и асинхронни (async). За повечето работни натоварвания, преобладаващото мнозинство от операциите на запис са асинхронни - файловата система позволява да се агрегира и да се предоставят на пакетни основи, намалявайки фрагментацията и значително увеличавайки пропускната способност.
Синхронните записи са съвсем различна работа. Когато приложението иска синхронен запис, то казва на файловата система: «Трябва да запишеш това в енергийно независима памет, моментаа до тогава не мога да направя нищо повече». Затова синхронните записи трябва да бъдат незабавно фиксирани на диска - и ако това увеличава фрагментацията или намалява пропускната способност, така да бъде.
ZFS обработва синхронните записи по различен начин, отколкото обикновените файлови системи - вместо веднага да ги заливат в обичайното хранилище, ZFS ги записва в специална зона за съхранение, наречена журнал на намеренията на ZFS - ZFS Intent Log или ZIL. Хитростта е, че тези записи също остават в паметта, събирайки се заедно с обичайните асинхронни заявки за запис, за да бъдат впоследствие изхвърлени в хранилището като напълно нормални TXG (групи транзакции, Transaction Groups).
В нормален режим на работа ZIL се записва и никога не се чете отново. Когато след няколко мигове записите от ZIL се фиксират в основното хранилище в обичайните TXG от оперативната памет, те се отделят от ZIL. Единственото, когато нещо се чете от ZIL, е при импортиране на пула.
Ако се случи срив на ZFS - срив на операционната система или загуба на електричество - когато в ZIL има данни, тези данни ще бъдат прочетени по време на следващото импортиране на пула (например, при рестартиране на аварийна система). Всичко, което се намира в ZIL, ще бъде прочетено, обединено в TXG групи, фиксирано в основното хранилище и след това отделено от ZIL в процеса на импортиране.
Един от спомагателните класове vdev се нарича LOG или SLOG, вторично устройство LOG. Неговата единствена задача е да предостави на пула отделно и, желателно, много по-бързо устройство vdev с много висока устойчивост на запис за съхранение на ZIL, вместо да съхранява ZIL на основното хранилище vdev. Самият ZIL се държи еднакво независимо от мястото на съхранение, но ако vdev с LOG има много висока производителност на запис, синхронните записи ще се извършват по-бързо.
Добавянето на vdev с LOG в пула не може не може да подобри производителността на асинхронния запис - дори ако принудително извършвате всички записи в ZIL чрез zfs set sync=always, те пак ще бъдат свързани с основното хранилище в TXG по същия начин и с същото темпо, както и без журнал. Единственото пряко подобрение в производителността е закъснението на синхронния запис (тъй като по-голямата скорост на журнала ускорява изпълнението на операциите sync).
Въпреки това, в среда, която вече изисква голям брой синхронни записи, vdev LOG може косвено да ускори асинхронния запис и некешираното четене. Извеждането на записите ZIL в отделен vdev LOG означава по-малка конкуренция за IOPS в основното хранилище, което до известна степен повишава производителността на всички операции с четене и запис.
Снапшоти
Механизмът за копиране при запис също е необходима основа за атомарни моментални снимки ZFS и инкрементална асинхронна репликация. В активна файлова система има дърво с указатели, което отбелязва всички записи с текущите данни - когато направите снапшот, вие просто правите копие на това дърво с указатели.
Когато в активна файлова система се презаписва запис, ZFS първо записва новата версия на блока в неизползваемо пространство. След това откачва старата версия на блока от текущата файлова система. Но ако някой снапшот се отнася до стария блок, той все пак остава непроменен. Старият блок всъщност няма да бъде възстановен като свободно пространство, докато не бъдат унищожени всички снапшоти, които се отнасят до този блок!
Репликация
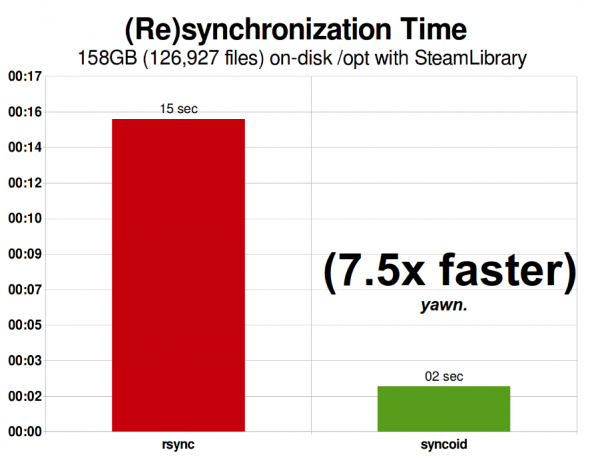
Библиотеката ми в Steam през 2015 година занимаваше 158 ГиБ и включваше 126 927 файла. Това е доста близо до оптималната ситуация за rsync - репликацията на ZFS по мрежата беше "само" с 750% по-бърза.
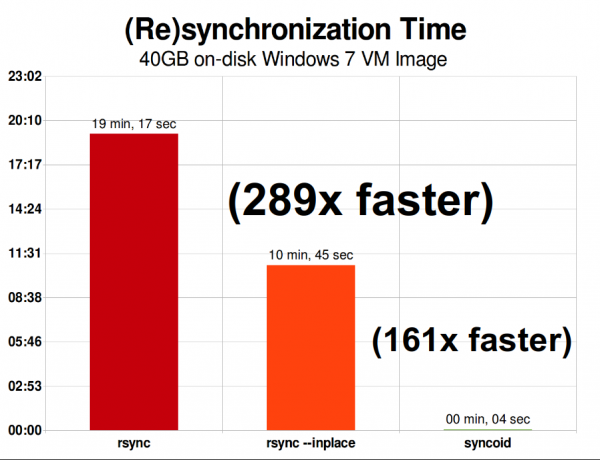
В същата мрежа репликацията на един 40-гигабайтов файл образ на виртуална машина Windows 7 е съвсем друга история. Репликацията ZFS е 289 пъти по-бърза от rsync – или 'само' 161 път по-бърза, ако знаете как да извикате rsync с ключа --inplace.
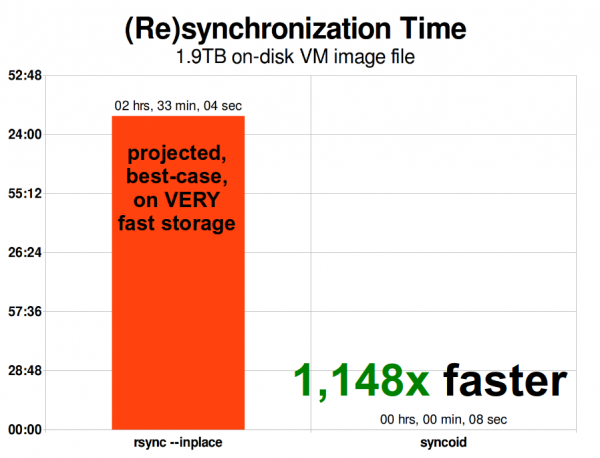
Когато образът на виртуалната машина се мащабира, проблемите с rsync също се мащабират. Размерът от 1,9 ТиБ не е толкова голям за съвременен образ на виртуална машина – но е достатъчно голям, за да е репликацията ZFS 1148 пъти по-бърза от rsync, дори с аргумента rsync --inplace.
След като разберете как работят снапшотите, ще бъде лесно да уловите същността на репликацията. Тъй като снапшотът е просто дърво от указатели към записи, следва, че ако направим zfs send снапшот, ние изпращаме както това дърво, така и всички свързани записи. Когато предаваме този zfs send в zfs receive на целевия обект, той записва както фактическото съдържание на блока, така и дървото от указатели, сочещи към блоковете, в целевия набор от данни.
Ситуацията става още по-интересна на втория zfs send. Сега имаме две системи, всяка от които съдържа poolname/datasetname@1, а вие правите нов снапшот poolname/datasetname@2. Следователно в източния пул имате datasetname@1 и datasetname@2, а в целевия пул все още само първия снапшот. datasetname@1.
Тъй като между източника и целта имаме общ снапшот datasetname@1, можем да направим инкрементален zfs send върху него. Когато информираме системата zfs send -i poolname/datasetname@1 poolname/datasetname@2, тя сравнява двете дървета от указатели. Всички указатели, които съществуват само в @2, очевидно сочат към нови блокове – следователно ще ни е нужно съдържанието на тези блокове.
В отдалечената система обработката на инкременталното send е също толкова проста. Първо записваме всички нови записи, включени в потока send, а след това добавяме указатели за тези блокове. Вуаля, вече имаме @2 в новата система!
Асинхронната инкрементална репликация ZFS е огромно подобрение в сравнение с предишни методи, които не се основават на снапшоти, като rsync. И в двата случая се предават само променените данни – но rsync първо трябва да се прочете да прочете всички данни от двете страни, за да провери сумата и да я сравни. За разлика от това, репликацията ZFS не прочита нищо, освен дърветата от указатели – и всякакви блокове, които не са представени в общия снапшот.
Вградено компресиране
Механизмът за копиране при запис също опростява системата за вградено компресиране. В традиционната файлова система компресията е проблематична — старата версия и новата версия на променените данни се намират в едно и също пространство.
Ако разгледаме фрагмент от данни в средата на файла, който започва живота си като мегабайт нули от 0x00000000 нататък — много лесно може да бъде компресиран до един сектор на диска. Но какво ще се случи, ако заменим този мегабайт нули с мегабайт неконвертируеми данни, като JPEG или псевдослучаен шум? Неочаквано, на този мегабайт данни ще му трябват не един, а 256 сектора по 4 КиБ, а в това място на диска е резервиран само един сектор.
При ZFS няма такъв проблем, тъй като променените записи винаги се записват в неизползвано пространство — оригиналният блок заема само един сектор от 4 КиБ, а новият запис ще заеме 256, но това не е проблем — наскоро промененият фрагмент от „средата“ на файла ще бъде записан в неизползваното пространство независимо от това дали размерът му се е променил или не, така че за ZFS това е напълно нормална ситуация.
Вграденото компресиране на ZFS е изключено по подразбиране и системата предлага включващи алгоритми — в момента сред тях са LZ4, gzip (1-9), LZJB и ZLE.
- LZ4 — това е потоков алгоритъм, предлагащ изключително бързо компресиране и декомпресиране и печалба в производителността за повечето случаи на използване — дори на доста бавни CPU.
- GZIP — уважаван алгоритъм, който всеки потребител на Unix системи познава и обича. Може да бъде реализиран с нива на компресия 1-9, с увеличаване на степента на компресия и използването на CPU при приближаване до ниво 9. Алгоритъмът е подходящ за всички текстови (или други изключително компресируеми) случаи на използване, но в противен случай често предизвиква проблеми с CPU — използвайте го с повишено внимание, особено на по-високите нива.
- LZJB — оригиналният алгоритъм в ZFS. Той е остарял и не трябва да се използва, LZ4 го надминава по всички показатели.
- ZLE — кодиране на нулево ниво, Zero Level Encoding. То не засяга нормалните данни, но компресира големи последователности от нули. Полезно е за напълно неконпресируеми набори от данни (например, JPEG, MP4 или други вече компресирани формати), тъй като игнорира неконпресируемите данни, но компресира неизползваното пространство в финалните записи.
Препоръчваме компресия LZ4 практически за всички варианти на употреба; наказанието за производителност при среща с неконпресируеми данни е много малко, а нарастване производителността за типични данни е значителна. Копирането на образ на виртуална машина за нова инсталация на операционна система Windows (прясно инсталирана ОС, без данни вътре) с compression=lz4 премина на 27% по-бързо, отколкото с compression=none, в .
ARC — адаптивна замяна на кеша
ZFS е единствената известна в момента модерна файлова система, която използва собствен механизъм за кеширане на четене, а не разчита на кеша на страниците на операционната система за съхранение на копия на наскоро прочетени блокове в оперативната памет.
Въпреки че собственото кеш е изпълнено с проблеми — ZFS не може да реагира на нови заявки за разпределение на памет толкова бързо, колкото ядрото, затова ново искане malloc() за разпределение на памет може да се провали, ако изисква оперативна памет, която в момента се заема от ARC. Но има сериозни причини да се използва собственото кеш, поне в момента.
Всички известни съвременни ОС, включително MacOS, Windows, Linux и BSD, при реализирането на кеша на страниците използват алгоритъм LRU (Най-малко наскоро използван). Това е примитивен алгоритъм, който повдига кеширан блок "нагоре в опашката" след всяко четене и изхвърля блокове "надолу в опашката" при необходимост, за да добави нови пропуски в кеша (блокове, които трябваше да бъдат прочетени от диска, а не от кеша) нагоре.
Обикновено алгоритъмът работи добре, но в системи с големи работни набори LRU лесно води до thrashing — изхвърляне на често необходими блокове, за да освободи място за блокове, които никога повече няма да бъдат прочетени от кеша.
— значително по-малко наивен алгоритъм, който може да се разглежда като "тежестен" кеш. След всяко прочитане на кеширан блок той става малко по-тежък и става по-труден за изхвърляне — и дори след изхвърляне блокът се проследява в течение на определен период от време. Блок, който е бил изхвърлен, но след това трябва да бъде прочетен обратно в кеша, ще стане също "тежък".
Крайната цел на всичко това е кеш с много по-висок коефициент на попадение (hit ratio) — съотношението между попаденията в кеша (четене, извършвано от кеша) и промахите (четене от диска). Това е изключително важна статистика — не само, че самите попадения в кеша се обслужват значително по-бързо, но и промахите в кеша могат да бъдат обслужвани по-бързо, тъй като колкото повече попадения в кеша — толкова по-малко паралелни заявки към диска и толкова по-малко забавяне за онези останали промахи, които трябва да се обслужват от диска.
Заключение
След изучаване на основната семантика на ZFS — как работи копирането при запис, както и връзките между хранилищните пулове, виртуалните устройства, блоковете, секторите и файловете, — сме готови да обсъдим реалната производителност с реални числа.
В следващата част ще разгледаме действителната производителност на пуловете с огледални vdev и RAIDz, един спрямо друг, както и в сравнение с традиционните RAID топологии на ядрото на Linux, които проучихме .
Първоначално искахме да разгледаме само основите — самите топологии на ZFS — но след това толкова ще сме готови да говорим за по-напреднали настройки и оптимизиране на ZFS, включително използването на допълнителни типове vdev, като L2ARC, SLOG и Special Allocation.
Източник: habr.com
