

Въведение
 «Трябва да бягаш с всички сили, за да останеш на едно място,
а за да стигнеш някъде, трябва да бягаш поне два пъти по-бързо!»
(с) Алиса в страната на чудесата
Преди известно време ми беше поискано да прочета лекция на аналитиците в нашата компания на тема проектиране на модели на данни, тъй като, прекарали много време по проекти (понякога по няколко години), ние изпускаме от поглед случващото се около нас в света на ИТ технологиите. В нашата компания (така се е случило) в много проекти не се използват NoSQL бази данни (поне за момента), затова в лекцията си отделих малко внимание на тях с примера на HBase и се стараех да насоча изложението на материалите към тези, които никога не са работили с тях. В частност, илюстрирах някои характеристики на проектирането на модел на данни на примера, който прочетох преди няколко години Разглеждайки примерите, сравнявах няколко варианта на решение на една и съща задача, за да предам основните идеи на слушателите.
Наскоро, «от безделие», си зададох въпроса (дългите майски празници в режим на карантина особено предразполагат към това), доколко теоретичните разсъждения ще съответстват на практиката? Всъщност, така се роди идеята за тази статия. Разработчик, който не е за първи ден в работата с NoSQL, може и да не почерпите нещо ново от нея (и затова може направо да пропусне половината статия). Но за аналитиците, които още не са работили плътно с NoSQL, смятам, че ще бъде полезна за придобиване на основни представи за особеностите на проектиране на модели на данни за HBase.
Разбор на примера
На мое мнение, преди да започнете да използвате NoSQL бази данни, е необходимо сериозно да обмислите плюсовете и минусите. Често задачата може да бъде решена и с традиционни релационни СУБД. Затова е по-добре да не се използва NoSQL без основателни причини. Ако все пак е взето решение да се използва NoSQL база данни, трябва да се има предвид, че подходите към проектирането тук са донякъде различни. Особено някои от тях могат да са непознати за онези, които до сега са работили само с релационни СУБД (по мои наблюдения). Така, в релационния свят обикновено започваме с моделиране на предметната област, и след това, при необходимост, извършваме денормализация на модела. В NoSQL обаче веднага трябва да вземем предвид предполагаемите сценарии на работа с данните и първоначално да денормализираме данните. Освен това, има редица други различия, за които ще бъде написано по-долу.
Нека разгледаме следната „синтетична“ задача, с която ще работим по-нататък:
Необходимо е да се проектира структура на съхранение на списък с приятели на потребителите на абстрактна социална мрежа. За опростяване ще приемем, че всички връзки са насочени (както в Instagram, а не в Linkedin). Структурата трябва да позволява ефективно:
- Да отговаря на въпроса, дали потребител А следи потребител Б (шаблон за четене)
- Да позволява добавяне/изтриване на връзки в случай на абониране/отписване на потребител А от потребител Б (шаблон за промяна на данни)
Разбира се, има множество варианти за решаване на задачата. В обикновена релационна БД вероятно просто бихме създали таблица за връзките (възможно типизирана, ако например трябва да се съхранява потребителска група: семейство, работа и т.н., в която влиза този „приятел“), а за оптимизация на скоростта на достъп бихме добавили индекси/партциониране. Вероятно крайното таблица би изглеждала приблизително така:
user_id
friend_id
Вася
Петя
Вася
Оля
тук и по-долу за по-добра представа и разбиране вместо ID ще посочвам имена
В случай с HBase знаем, че:
- ефективно търсене, което не води до пълен скан на таблицата, е възможно изключително по ключ
- Съответно, затова написването на познатите на мнозина SQL заявки към подобни бази е лоша идея; технически, разбира се, можете да изпратите SQL заявка с Join-ове и друга логика в HBase от същата Impala, но колко ефективно ще е това...
Затова сме принудени да използваме ID на потребителя като ключ. Първата мисъл относно "къде и как да съхраним ID на приятелите?" може да бъде идеята за съхранение в колони. Този най-очевиден и "наивен" вариант ще изглежда приблизително така (нека го наречем Вариант 1 (по подразбиране), за да се реферира по-късно):
RowKey
Колони
Вася
1: Петя
2: Оля
3: Даша
Петя
1: Маша
2: Вася
Тук всеки ред съответства на един потребител на мрежата. Колоните имат имена: 1, 2, … — в зависимост от броя на приятелите, а в колоните се съхраняват ID на приятелите. Важно е да се отбележи, че всеки ред ще има различен брой колони. В примера на изображението по-горе един ред има три колони (1, 2 и 3), а вторият – само две (1 и 2) – тук сме се възползвали от две свойства на HBase, които не съществуват в релационните БД:
- възможността динамично да променяме съдържанието на колоните (добавяме приятел -> добавяме колона, изтриваме приятел -> изтриваме колона)
- различен състав на колоните в различни редове
Нека проверим нашата структура относно изискванията на задачата:
- Четене на данни: за да разберем дали Вася следва Оля, трябва да изчетем целия ред по ключ RowKey = "Васия" и да прегледаме стойностите на колоните, докато не "срещнем" Оля в тях. Или да прегледаме стойностите на всички колони, "да не срещнем" Оля и да върнем отговор False;
- Промяна на данни: добавяне на приятел: за подобна задача ще ни е необходимо да изчетем целия ред по ключ RowKey = "Васия", за да преброим общия брой на неговите приятели. Това общо количество приятели ни е необходимо, за да определим номера на колоната, в която да запишем ID на новия приятел.
- Промяна на данни: изтриване на приятел:
- Необходимо е да изчетем целия ред по ключ RowKey = "Васия" и да прегледаме колоните, за да намерим онази, в която е записан изтриваният приятел;
- След това, след изтриването на приятеля, трябва да "изместим" всички данни с една колона, за да избегнем "дупки" в тяхната нумерация.
Сега нека оценим колко производителни ще бъдат данните алгоритми, които трябва да реализираме на страната на "условното приложение", използвайки . Нека обозначим размера на нашата хипотетична социална мрежа като n. Тогава максималният брой приятели на един потребител може да бъде (n-1). Тази (-1) можем да пренебрегнем за нашите цели, тъй като в рамките на използването на О-символиката тя не е съществена.
- Четене на данни: необходимо е да се обработи целият ред и да се прегледат всички негови колони. Следователно, горната оценка на разходите ще бъде приблизително О(n)
- Промяна на данни: добавяне на приятел: за определяне на броя на приятелите е нужно да се прегледат всички колони на реда, след което да се добави нова колона => О(n)
- Промяна на данни: изтриване на приятел:
- По аналогия с добавянето – е необходимо в крайна сметка да се прегледат всички колони => О(n)
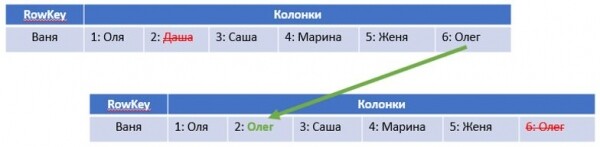
- След изтриването на колоните, трябва да ги 'преместим'. Ако реализираме това 'в прав текст', то в крайна сметка ще са необходими още до (n-1) операции. Но тук и в следващата част ще приложим друг подход, който ще реализира 'псевдопреместване' за фиксиран брой операции – тоест, то ще отнема константно време независимо от n. Това константно време (ако бъдем точни, е О(2)) може да се пренебрегне в сравнение с О(n). Подходът е илюстриран на следната рисунка: просто копираме данните от 'последната' колона в тази, от която трябва да изтрием данни, след което изтриваме последната колона:

В крайна сметка, във всички сценарии получихме асимптотична изчислителна сложност O(n).
Вероятно вече сте забелязали, че почти винаги е необходимо да извлечем цял ред от базата, като в два от трите случая само затова, за да прегледаме всички колони и да изчислим общия брой приятели. Затова, като опит за оптимизация, можем да добавим колона 'count', в която да съхраняваме общия брой приятели на всеки потребител в мрежата. В този случай можем да не извличаме целия ред, за да сметнем общия брой приятели, а просто да прочетем само една колона 'count'. Важно е да не забравяме да актуализираме 'count' при манипулация с данните. По този начин получаваме подобрение Вариант 2 (count):
RowKey
Колони
Вася
1: Петя
2: Оля
3: Даша
count: 3
Петя
1: Маша
2: Вася
count: 2
В сравнение с първия вариант:
- Четене на данни: за получаване на отговор на въпроса 'Чете ли Васил Олга?' нищо не се е променило => О(n)
- Промяна на данни: добавяне на приятел: Оптимизирахме вмъкването на нов приятел, тъй като сега не е необходимо да изчитаме цялата редица и да обхождаме колоните, а можем да получим само стойността на колоната «count» и по този начин веднага да определим номера на колоната за вмъкване на нов приятел. Това води до намаляване на изчислителната сложност до O(1)
- Промяна на данни: изтриване на приятел: При премахване на приятел можем също така да се възползваме от тази колонка, за да намалим броя на операциите на вход-изход при «преместване» на данните наляво с една клетка. Но необходимостта от обхождане на колоните за намиране на тази, която трябва да бъде премахната, все пак остава, затова => O(n)
- От една страна, сега при актуализиране на данните е необходимо всеки път да актуализираме и колоната «count», но това отнема константно време, което в рамките на О-символиката може да бъде пренебрегнато
Общо казано, вариант 2 изглежда малко по-оптимален, но това е по-скоро «еволюция вместо революция». За да направим «революция», ще ни трябва Вариант 3 (col).
Объркваме всичко «с краката нагоре»: присвояваме настоящето име на колоната идентификатор на потребителя! Това, което ще бъде записано в самата колонка, вече не е от съществено значение за нас; нека да бъде число 1 (въобще, от полезно там може да се съхранява, например, група «семейство/приятели/и т.н.»). Този подход може да изненада неподготвения «гражданин», който преди това не е имал опит с NoSQL-бази, но именно той позволява да се използва потенциалът на HBase в задача много по-ефективно:
RowKey
Колони
Вася
Петя: 1
Оля: 1
Даша: 1
Петя
Маша: 1
Вася: 1
Тук получаваме веднага няколко предимства. За да ги разберем, нека анализираме новата структура и оценим изчислителната сложност:
- Четене на данни: за да отговорим на въпроса, подписан ли е Вася на Оля, е достатъчно да прочетем една колонка «Оля»: ако тя съществува, отговорът е True, ако не – False => O(1)
- Промяна на данни: добавяне на приятел: Добавяне на приятел: достатъчно е просто да добавите нова колонка «ID на приятел» => O(1)
- Промяна на данни: изтриване на приятел: достатъчно е просто да премахнете колонка «ID на приятел» => O(1)
Както виждаме, същественото предимство на такъв модел на съхранение е, че във всички необходими ни сценарии се оперира само с една колонка, избягвайки изчитането на цялата редица от базата и още повече, преминаването през всички колони на тази редица. На това бихме могли да спрем, но...
Можете да се замислите и да отидете още малко по-далеч по пътя на оптимизацията на производителността и намаляване на операциите по вход и изход при работа с базата данни. Какво ако съхраняваме цялата информация за връзката директно в самия ключ на реда? Тоест, да направим ключа съставен от вида userID.friendID? В този случай всъщност можем дори да не четем колоните на реда (Опция 4 (ред)):
RowKey
Колони
Васил. Петър
Петя: 1
Васил. Оля
Оля: 1
Васил. Даша
Даша: 1
Петър. Маша
Маша: 1
Петър. Васил
Вася: 1
Очевидно е, че оценката на всички сценарии на манипулации с данни в такава структура ще бъде също О(1), както и в предишния вариант. Разликата с вариант 3 ще бъде вече изцяло в ефективността на операциите по вход и изход в БД.
А последният "панделка". Лесно е да се забележи, че в вариант 4 нашият ключ на реда ще има променлива дължина, което вероятно може да повлияе на производителността (тук си спомняме, че HBase съхранява данни като набор от байтове и редовете в таблиците са сортирани по ключ). Освен това имаме разделител, който в някои сценарии може да се наложи да обработваме. За да изключим това влияние, можем да използваме хешове от userID и friendID, и тъй като и двата хешове ще имат постоянна дължина, можем просто да ги конкатенираме, без разделител. Тогава данните в таблицата ще изглеждат така (Опция 5 (хеш)):
RowKey
Колони
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Петя: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Оля: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Даша: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Маша: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Вася: 1
Очевидно е, че алгоритмичната сложност на работа с такава структура при разглежданите от нас сценарии ще бъде също такава, като при вариант 4 – тоест О(1).
В крайна сметка, нека обобщим всички наши оценки на изчислителната сложност в една таблица:
Добавяне на приятел
Проверка на приятел
Изтриване на приятел
Вариант 1 (по подразбиране)
O(n)
O(n)
O(n)
Опция 2 (броене)
O(1)
O(n)
O(n)
Опция 3 (колона)
O(1)
O(1)
O(1)
Опция 4 (ред)
O(1)
O(1)
O(1)
Опция 5 (хеш)
O(1)
O(1)
O(1)
Както изглежда, варианти 3-5 са най-предпочитани и теоретично осигуряват изпълнението на всички необходими сценарии за манипулация с данни за константно време. В условията на нашата задача няма явно изискване за получаване на списък с всички приятели на потребителя, но в реалната проектна дейност, като добри анализатори, би било добре да "предвидим", че подобна задача може да възникне и "да подстелим слама". Затова моята симпатия е на страната на вариант 3. Но е напълно вероятно, че в реален проект този запитване вече е решено с други средства, така че без общо разбиране на цялата задача е по-добре да не правим окончателни изводи.
Подготовка на експеримента
Искаме да проверим горепосочените теоретични разсъждения на практика – това бе целта на замисъл, който възникна през дългите почивни дни. Необходимо е да оценим скоростта на работа на нашето "условно приложение" във всички описани сценарии за използване на базата, както и нарастването на това време с нарастването на размера на социалната мрежа (n). Целевият параметър, който ни интересува и който ще измерим по време на експеримента, е времето, което "условното приложение" отделя за изпълнение на една "бизнес-операция". Под "бизнес-операция" разбираме едно от следните:
- Добавяне на един нов приятел
- Проверка дали потребител А е приятел на потребител Б
- Изтриване на един приятел
Така, като се вземат предвид зададените в първоначалната постановка изисквания, сценарият за проверка се очертава следния:
- Записване на данни. Генерирайте произволно начална мрежа с размер n. За по-голямо приближаване до "реалния свят" броят на приятелите на всеки потребител е също произволна величина. Измерете времето, за което нашето "условно приложение" ще запише в HBase всички генерирани данни. След това полученото време разделете на общия брой добавени приятели – така ще получим средното време за една "бизнес-операция".
- Четене на данни. Създайте списък с "личности" за всеки потребител, за които трябва да се провери дали потребителят е последовател или не. Дължината на списъка е приблизително равна на броя на приятелите на потребителя, като за половината от проверираните приятели отговорът трябва да бъде "Да", а за другата половина – "Не". Проверяването се извършва така, че отговорите "Да" и "Не" да се редуват (тоест в случаите, когато е необходимо, ще трябва да прегледаме всичките колонки на реда за варианти 1 и 2). Общото време за проверка се дели на броя на проверените приятели, за да се получи средното време за проверка на един субект.
- Изтриване на данни. Изтрийте всички приятели на потребителя. Порядъкът на изтриване е случаен (тоест "разбъркваме" първоначалния списък, използван за записване на данните). Общото време за проверка се дели на броя на изтритите приятели, за да се получи средното време за една проверка.
Сценарите трябва да се изпълнят за всеки от 5-те варианта на модели данни и за различни размери на социалната мрежа, за да видим как времето се променя с нарастването й. В рамките на един n връзки в мрежата и списък с потребители за проверка трябва, разбира се, да бъдат еднакви за всичките 5 варианта.
За по-добро разбиране по-долу давам пример за генерирани данни за n= 5. Написаният "генератор" изходи три речника с ID номера:
- първи – за вмъкване
- втори – за проверка
- трети – за изтриване
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # общо 15 приятели

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # общо 18 проверявани субекта

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # общо 15 приятели
Както може да се забележи, всички ID, по-големи от 10 000 в речника за проверка – това са точно тези, които заведомо ще дадат отговор False. Вмъкването, проверката и изтриването на "приятели" се извършват точно в посочената в речника последователност.
Експериментът беше проведен на лаптоп с Windows 10, където в един докер контейнер беше стартирана база HBase, а в друг – Python с Jupyter Notebook. На Docker бяха предоставени 2 ядра CPU и 2 GB оперативна памет. Цялата логика, както и емуляцията на работата на "условното приложение", така и "обвивката" за генериране на тестови данни и измерване на времето бяха написани на Python. За работа с HBase беше използвана библиотеката , за изчисляване на хешове (MD5) за вариант 5 — hashlib
С оглед на изчислителната мощност на конкретния лаптоп, експериментално беше избран старт за n = 10, 30, …. 170 – когато общото време за работа на целия цикъл на тестване (всички сценарии за всички варианти за всички n) все още беше по-близо до разумното и се вписваше в времето на едно чаепитие (в средно 15 минути).
Тук е необходимо да се направи забележка, че в този експеримент ние преди всичко оценяваме не абсолютните цифри на производителността. Дори относителното сравнение на два различни варианта може да не е напълно коректно. В момента ни интересува именно характерът на изменението на времето в зависимост от n, тъй като с посочената по-горе конфигурация на ‘тестовия стенд’ е много трудно да се получат времеви оценки, ‘очистени’ от влиянието на случайни и други фактори (и такава задача не беше поставена).
Резултат от експеримента
Първият тест – как се променя времето, необходимо за запълване на списъка с приятели. Резултатът – на графиката по-долу.
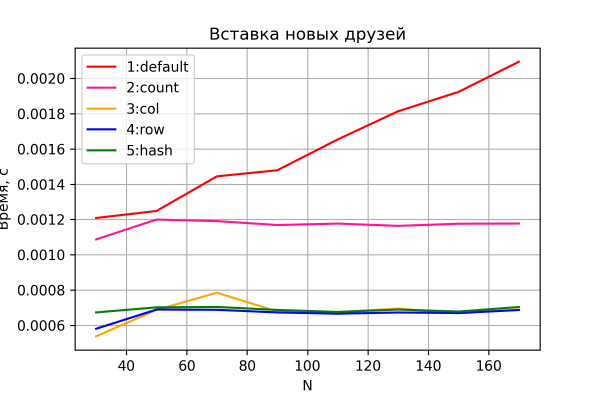
Варианти 3-5 закономерно показват практически константно време за ‘бизнес-операцията’, което не зависи от растежа на размера на мрежата и неотличима разлика в производителността.
Вариант 2 също показва постоянна, но малко по-лоша производителност, при това практически точно 2 пъти по-ниска в сравнение с варианти 3-5. И това не може да не радва, тъй като съответства на теорията – в този вариант броят на операциите за вход-изход в/от HBase е точно 2 пъти повече. Това може да служи като косвено свидетелство, че нашият тестов стенд принципно дава добра точност.
Вариант 1 също закономерно е най-бавен и демонстрира линейно нарастване на времето, необходимо за добавяне на един приятел, спрямо размера на мрежата.
Сега да разгледаме резултатите от втория тест.
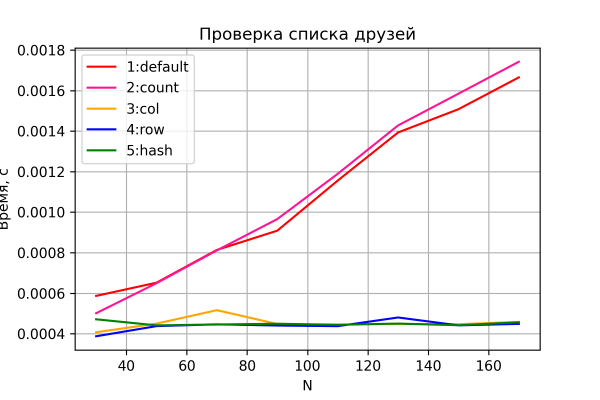
Опциите 3-5 отново функционират очаквано – постоянен времеви ресурс, независим от размера на мрежата. Опциите 1 и 2 демонстрират линейен ръст на времето с увеличаването на размера на мрежата и подобна производителност. Интересно е, че опция 2 е малко по-бавна – вероятно заради необходимостта от четене и обработка на допълнителната колона „count“, което става все по-видимо при нарастване на n. Но все пак ще се въздържа от каквито и да било заключения, тъй като точността на това сравнение е относително ниска. Освен това, съотношенията (коя опция, 1 или 2, е по-бърза) се променяха от стартиране до стартиране (като същевременно запазваха характера на зависимостта и "вървят рамо до рамо").
И последната графика – резултат от тестовете по премахване.
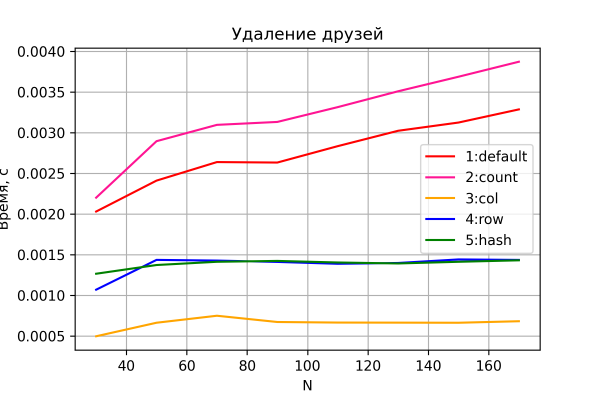
Тук отново без изненади. Опциите 3-5 извършват премахване за постоянен времеви ресурс.
От друга страна, е интересно, че опции 4 и 5, в отличие от предишните сценарии, показват забележимо малко по-лоша производителност в сравнение с опция 3. Вероятно, операцията по премахване на ред е по-скъпа от операцията по премахване на колона, което е логично.
Опции 1 и 2, както се очаква, демонстрират линейен ръст на времето. При това опция 2 е стабилно по-бавна от опция 1 – заради допълнителната операция по вход-изход за „обслужване“ на колоната count.
Общи изводи от експеримента:
- Опции 3-5 демонстрират по-голяма ефективност, тъй като се възползват от предимствата на HBase; в същото време производителността им варира помежду си с константа и не зависи от размера на мрежата.
- Разликата между опции 4 и 5 не беше установена. Но това не означава, че опция 5 не трябва да се използва. Напълно вероятно е използваният сценарий на експеримента, вземайки предвид техническите характеристики на тестовата платформа, да не е позволил нейното откритие.
- Характерът на растежа на времето, необходимо за изпълнение на „бизнес операции“ с данни, изцяло потвърди предишните теоретични изводи за всички опции.
Епилог
Проведените груби експерименти не трябва да се възприемат като абсолютна истина. Съществуват много фактори, които не бяха взети под внимание и които внасят изкривявания в резултатите (особено добре тези флуктуации се виждат на графиките при малък размер на мрежата). Например, скоростта на работа на thrift, който се използва от happybase, обемът и начинът на реализиране на логиката, която написах на Python (не мога да твърдя, че кодът беше написан оптимално и ефективно използваше възможностите на всички компоненти), възможно е особеностите на кеширането на HBase, фоновата активност на Windows 10 на моя лаптоп и т.н. В цялост можем да смятаме, че всички теоретични изводи експериментално показаха своята стойност. Или поне не успяхме да ги опровергаем с такъв 'наскок в лоб'.
В заключение – препоръки за всички, които току-що започват да проектират модели на данни в HBase: абстрахирайте се от предишния опит с релационни бази и помнете „заповедите“:
- При проектиране, тръгваме от задачата и шаблона за манипулиране с данни, а не от модела на предметната област.
- Ефективен достъп (без full table scan) – само по ключ.
- Денормализация.
- Различните редици могат да съдържат различни колони.
- Динамичен състав на колоните.
Източник: habr.com
