

Ако вашата IT инфраструктура расте твърде бързо, рано или късно ще се окажете пред избора – да увеличавате линейно човешките ресурси за нейното поддържане или да започнете автоматизация. До определен момент живеехме в първата парадигма, а след това започна дългият път към Infrastructure-as-Code.
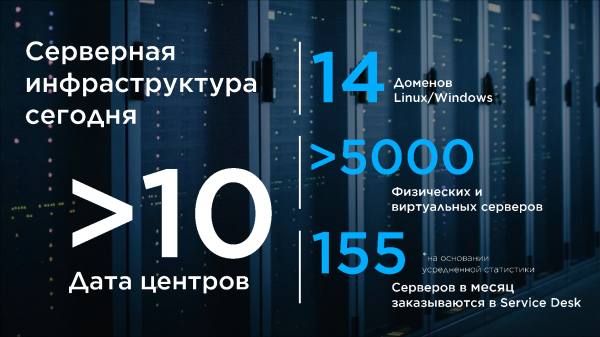
Разбира се, НСПК не е стартап, но такава атмосфера цареше в компанията през първите години от съществуването ѝ, и това бяха много интересни години. Казвам се , над 10 години поддържам Linux инфраструктура с високи изисквания за достъпност. Присъединих се към екипа на НСПК през януари 2016 година и, за съжаление, не бях свидетел на самото начало на съществуването на компанията, но дойдох в етапа на големи промени.
В общи линии можем да кажем, че нашият екип доставя за компанията два продукта. Първият – това е инфраструктурата. Имейлът трябва да работи, DNS да функционира, а контролерите на домейни – да ви допускат до сървъри, които не трябва да падат. IT ландшафтът на компанията е огромен! Това са бизнес и мисия критични системи, а изискванията за достъпност на някои от тях – 99,999. Вторият продукт – самите сървъри, физически и виртуални. Нужно е да следим за съществуващите, а нови да поставяме редовно на клиентите от множество подразделения. В тази статия искам да акцентирам на това, как развихме инфраструктурата, която отговаря за жизнения цикъл сървъри.
Началото на пътя
В началото на пътя стека ни от технологии изглеждаше така:
ОС CentOS 7
Контролери на домейни FreeIPA
Автоматизация — Ansible(+Tower), Cobbler
Всичко това беше разположено в 3 домейна, разпределени на няколко ЦОД-а. В един ЦОД – офисни системи и тестови полигони, в останалите ПРОД.
Създаването на сървъри в某 момент изглеждаше така:
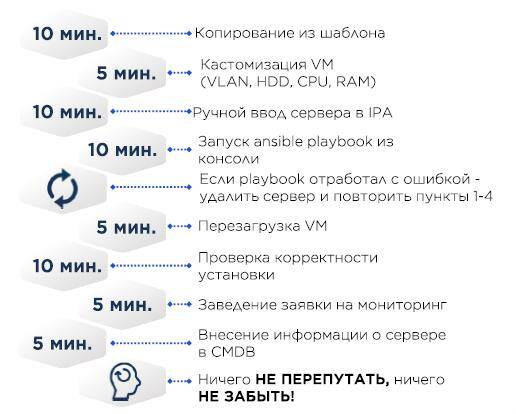
В шаблона на VM CentOS minimal и необходимия минимум, като коректен /etc/resolv.conf, останалото идва чрез Ansible.
CMDB – Excel.
Ако сървърът е физически, вместо копиране на виртуална машина, на него се инсталира ОС с помощта на Cobbler – в конфигурацията на Cobbler се добавят MAC адресите на целевия сървър, сървърът получава IP адрес по DHCP, а след това се инсталира ОС.
В началото дори се опитвахме да правим някакъв конфигурационен мениджмънт в Cobbler. Но с времето това започна да носи проблеми с преносимостта на конфигурациите, както към други ЦОД, така и в Ansible кода за подготовка на VM.
Много от нас възприеха Ansible като удобно разширение на Bash и не пестяха от конструкции, използващи shell, sed. Всъщност, Bashsible. В крайна сметка, ако плейбук по някаква причина не работеше на сървъра, беше по-лесно да се изтрие сървърът, да се коригира плейбукът и да се пусне отново. Нямаше никакво версиониране на скриптовете по същество, нито преносимост на конфигурациите.
Например, искахме да променим някаква конфигурация на всички сървъри:
- Променяме конфигурацията на съществуващите сървъри в логическия сегмент/ЦОД. Понякога не за един ден – изискванията за наличност и законът на големите числа не позволяват да се приложат всички промени наведнъж. А някои промени са потенциално разрушителни и изискват рестартиране на нещо – от услуги до самата ОС.
- Коригираме в Ansible
- Коригираме в Cobbler
- Повторяме N пъти за всеки логически сегмент/ЦОД
За да преминат всички промени гладко, беше необходимо да се вземат предвид множество фактори, а промените се случват постоянно.
- Рефакторинг на ansible кода, конфигурационните файлове
- Промяна на вътрешните най-добри практики
- Промени след разбор на инциденти/аварии
- Изменение на стандартите за сигурност, както вътрешни, така и външни. Например, PCI DSS всяка година се допълва с нови изисквания.
Растеж на инфраструктурата и начало на пътя
Броят на сървърите/логическите домейни/ЦОД нарастваше, а с тях и броят на грешките в конфигурациите. В някакъв момент стигнахме до три направления, в които трябваше да развиваме управлението на конфигурацията:
- Автоматизация. Доколкото е възможно, трябва да избягваме човешкия фактор в повторяемите операции.
- Повторяемост. Управлението на инфраструктурата е много по-лесно, когато тя е предсказуема. Конфигурацията на сървърите и инструментите за тяхната подготовка трябва да бъде навсякъде еднаква. Това е също толкова важно за продуктови екипи – приложението трябва гарантирано след тестване да попада в продуктивна среда, настроена аналогично на тестовата.
- Простота и прозрачност на измененията в управлението на конфигурацията.
Остана да добавим няколко инструмента.
Като хранилище на кода избрахме GitLab CE, не на последно място заради наличието на вградени модули CI/CD.
Хранилище на секрети – Hashicorp Vault, включително за прекрасното API.
Тестване на конфигурации и Ansible роли – Molecule + Testinfra. Тестовете протичат значително по-бързо, ако свържете mitogen към Ansible. Паралелно започнахме да пишем собствена CMDB и оркестратор за автоматизирано разгръщане (на снимката над Cobbler), но това е съвсем друга история, за която в бъдеще ще ни разкаже колегата ми и главен разработчик на тези системи.
Нашият избор:
Molecule + Testinfra
Ansible + Tower + AWX
World of Servers + DITNET (Собствена разработка)
Cobbler
GitLab + GitLab runner
Hashicorp Vault
И между другото за Ansible ролите. Първоначално имаше една, след няколко рефакторинга станаха 17. Категорично препоръчвам да разделите монолита на идемпотентни роли, които после можете да стартирате поотделно, допълнително можете да добавите тагове. Ние разделихме ролите по функционалност – мрежа, логиране, пакети, хардуер, Molecule и др. Всъщност следвахме стратегията по-долу. Не настоявам, че това е единствената истина, но при нас сработи.
- Копирането на сървъри от „златен образ“ – зло!Основните недостатъци – не знаете в какво състояние са образите в момента и че всички промени ще стигнат до всички образи в всички ферми за виртуализация.
- Използвайте стандартни конфигурационни файлове по минимум и се споразумейте с други подразделения, че основните системни файлове ще са под ваш контрол., например:
- Оставете /etc/sysctl.conf празен, настройките трябва да са само в /etc/sysctl.d/. Вашият дефолт в един файл, кастом за приложението в друг.
- Използвайте override файлове за редактиране на systemd юнити.
- Шаблонизирайте всички конфигурации и подавайте ги изцяло, по възможност без sed и неговите аналози в плейбуците.
- При рефакториране на кода на системата за управление на конфигурации:
- Разделете задачите на логически единици и пренапишете монолита като роли.
- Използвайте линтери! Ansible-lint, yaml-lint и др.
- Променете подхода! Никакъв bashsible. Трябва да опишете състоянието на системата.
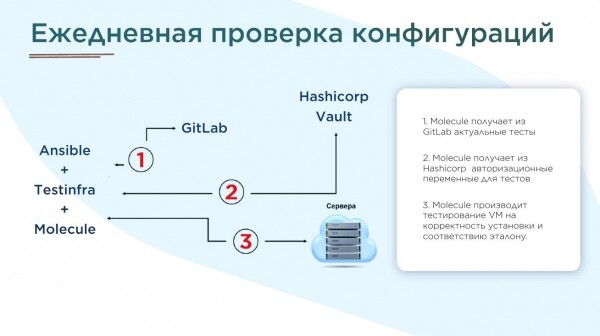
- За всички Ansible роли трябва да напишете тестове в Molecule и веднъж на ден да генерирате отчети.
- В нашия случай, след подготовката на тестовете (которите са повече от 100), открихме около 70000 грешки. Коригирахме ги в продължение на няколко месеца.

Нашата реализация
Така, Ansible ролите бяха готови, шаблонизирани и проверени с линтери. И дори git-овете са настроени навсякъде. Но въпросът за надеждната доставка на кода към различни сегменти остава отворен. Решихме да синхронизираме със скриптове. Изглежда така:
След като настъпи промяната, стартира CI, създава се тестов сървър, прилагат се роли и се тестват с молекулата. Ако всичко е ок, кодът преминава в продуктивния клон. Но не прилагаме новия код автоматично на съществуващите сървъри. Това е своеобразен спирачка, необходима за висока наличност на нашите системи. А когато инфраструктурата стане огромна, влиза в сила и законът на големите числа – дори ако сте сигурни, че промяната е безобидна, тя може да доведе до тъжни последствия.
Има много опции за създаване на сървъри. В крайна сметка избрахме персонализирани скриптове на Python. А за CI използваме Ansible:
- name: create1.yml - Създаване на ВМ от шаблон
  vmware_guest:
    hostname: "{{datacenter}}".domain.bg
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.bg
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Ето до какво стигнахме, системата продължава да живее и да се развива.
- 17 Ansible роли за настройка на сървъра. Всяка от ролите е предназначена да решава отделна логическа задача (логване, одит, авторизация на потребители, мониторинг и т.н.).
- Тестване на ролите. Molecule + TestInfra.
- Собствена разработка: CMDB + Оркестратор.
- Времето за създаване на сървър е около 30 минути, автоматизирано е и практически не зависи от опашката на задачите.
- Едно и също състояние/именуване на инфраструктурата във всички сегменти – плейбуци, хранилища, елементи на виртуализация.
- Ежедневна проверка на състоянието на сървърите с генериране на отчети за разминавания с еталона.
Надявам се моят разказ да бъде полезен на тези, които са в началото на пътя. А каква система за автоматизация използвате вие?
Източник: habr.com
