

В статията ще разкажа как подходихме към въпроса за отказоустойчивостта на PostgreSQL, защо това стана важно за нас и какво в крайна сметка постигнахме.
Имаме високо натоварен сервис: 2,5 милиона потребители по целия свят, над 50 000 активни потребители всеки ден. Сървърите се намират в Amazon в един регион в Ирландия: постоянно работят над 100 различни сървъра, от които почти 50 — с бази данни.
Целият бекенд е голямо монолитно stateful приложение на Java, което поддържа постоянно websocket връзка с клиента. При едновременна работа на няколко потребители на една дъска, всички те виждат промени в реално време, защото всяка промяна записваме в база данни. Имаме около 10 000 заявки в секунда към нашите бази. При пикова натовареност в Redis записваме по 80-100 000 заявки в секунда.
Защо преминахме от Redis на PostgreSQL
Първоначално нашият сервис работеше с Redis, хранилище с ключ-стойност, което съхранява всички данни в оперативната памет. сървър.
Плюсове на Redis:
- Висока скорост на отговор, тъй като всичко се съхранява в паметта;
- Удобство за архивиране и репликация.
Минуси на Redis за нас:
- Няма истински транзакции. Опитвахме се да имитираме тях на ниво нашето приложение. За съжаление, това не винаги работеше добре и изискваше написването на много сложен код.
- Обемът на данните е ограничен от количеството оперативна памет. При увеличаване на количеството данни паметта ще нараства, и в крайна сметка, ще достигнем характеристиките на избрания инстанс, което в AWS изисква спиране на нашия сервис, за да променим типа инстанс.
- Необходимо е постоянно да поддържаме ниво на ниска латентност, тъй като имаме много заявки. Оптималното за нас ниво на забавяне е 17-20 ms. При ниво от 30-40 ms получаваме дълги отговори на заявките на нашето приложение и деградация на услугата. За съжаление, това се случи през септември 2018 година, когато един от инстансите с Redis получи латентност два пъти по-голяма от обичайното. За да решим проблема, спряхме сервиса в средата на работния ден за планирано поддържане и заменихме проблемния инстанс Redis.
- Лесно се получава неконсистентност на данните дори при незначителни грешки в кода и после се налага да се прекара много време в написването на код за коригиране на тези данни.
Считали недостатки и поняли, что нам нужно перейти на что-то более удобное с нормальными транзакциями и меньшей зависимостью от задержек. Провели исследование, проанализировали множество вариантов и выбрали PostgreSQL.
На новую базу данных мы переезжаем уже 1,5 года и перенесли только небольшую часть данных, поэтому сейчас работаем одновременно с Redis и PostgreSQL. Подробнее об этапах переезда и переключении данных между базами написано в статье моего коллеги.
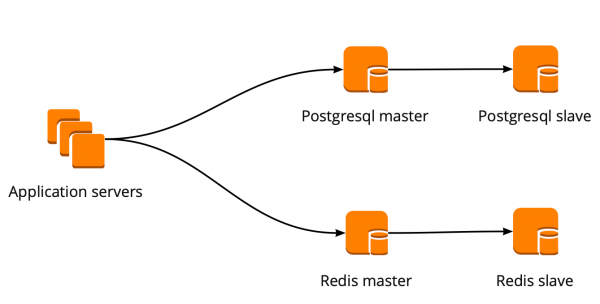
Когда мы только начинали переезд, наше приложение работало напрямую с базами данных и обращалось к мастеру Redis и PostgreSQL. Кластер PostgreSQL состоял из мастера и реплики с асинхронной репликацией. Так выглядела схема работы с базами:
Внедрение PgBouncer
Пока мы переезжали, продукт тоже развивался: увеличивалось количество пользователей и серверов, работающих с PostgreSQL, и нам стало не хватать соединений. PostgreSQL на каждое соединение создает отдельный процесс и потребляет ресурсы. Увеличивать количество подключений можно до определенного момента, иначе есть шанс получить неоптимальную работу базы данных. Идеальным вариантом в такой ситуации является выбор менеджера соединений, который будет стоять перед базой.
У нас было два варианта для менеджера соединений: Pgpool и PgBouncer. Но первый не поддерживает транзакционный режим работы с базой, поэтому мы выбрали PgBouncer.
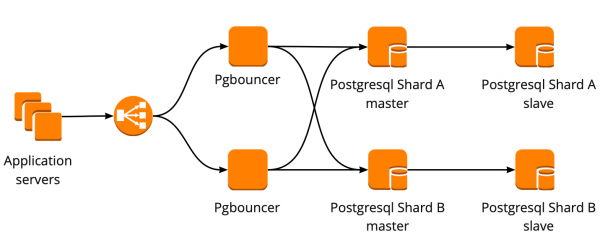
Мы настроили следующую схему работы: наше приложение обращается к одному PgBouncer, за которым находятся мастера PostgreSQL, а за каждым мастером — одна реплика с асинхронной репликацией.
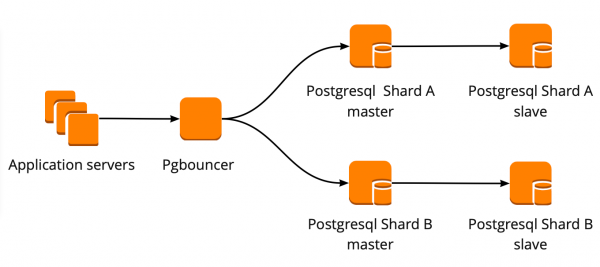
При этом мы не могли хранить весь объем данных в PostgreSQL, и для нас была важна скорость работы с базой, поэтому мы начали шардировать PostgreSQL на прикладном уровне. Описанная выше схема является относительно удобной для этого: при добавлении нового шарда в PostgreSQL достаточно обновить конфигурацию PgBouncer, и приложение сразу может работать с новым шардом.
Отказоустойчивость PgBouncer
Тази схема работеше до момента, в който единственият инстанс PgBouncer не излезе от строя. Намираме се в AWS, където всички инстанси работят на хардур, който периодично умира. В такива случаи инстансът просто преминава на ново хардур и отново работи. Така се случи и с PgBouncer, но той стана недостъпен. Резултатът от този срив беше недостъпност на нашия сервис за 25 минути. AWS препоръчва за такива ситуации да се използва излишък от страна на потребителя, което по това време не беше реализирано при нас.
След това сериозно се замислихме за отказоустойчивостта на PgBouncer и кластерите PostgreSQL, тъй като подобна ситуация можеше да се повтори с всеки инстанс в нашия AWS акаунт.
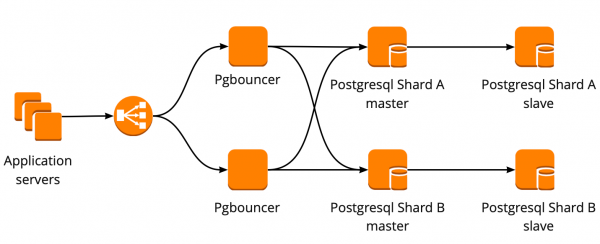
Схемата за отказоустойчивост на PgBouncer построихме по следния начин: всички сървъри на приложението се свързват към Network Load Balancer, зад който стоят два PgBouncer. Всеки от PgBouncer наблюдава същите master PostgreSQL на всеки шард. В случай на повторение на ситуацията със срив на инстанс AWS, целият трафик се пренасочва през друг PgBouncer. Отказоустойчивостта на Network Load Balancer се осигурява от AWS.
Тази схема позволява безпроблемно добавяне на нови PgBouncer сървъри.
Създаване на отказоустойчив кластер PostgreSQL
При решаването на тази задача разгледахме различни възможности: самостоятелен failover, repmgr, AWS RDS, Patroni.
Самописни скриптове
Могат да наблюдават работата на мастера и, в случай на неговия срив, да повишат репликата до мастер и да актуализират конфигурацията на PgBouncer.
Плюсовете на този подход са максимална простота, тъй като сами пишете скриптите и точно разбирате как те работят.
Недостатъци:
- Мастерът не е задължително да е умрял, вместо това може да е възникнала мрежова неизправност. Failover, без да знае за това, ще повиши репликата до мастер, а старият мастер ще продължи да работи. В резултат получаваме два сървъра в роля на мастер и няма да знаем на кой от тях са последните актуални данни. Такава ситуация се нарича още split-brain;
- Останахме без реплика. В нашата конфигурация имаме мастер и една реплика, след превключване репликата се повишава до мастер и вече нямаме реплики, затова трябва ръчно да добавим нова реплика;
- Необходим е допълнителен мониторинг на работата на failover, при това имаме 12 шарда PostgreSQL, а значи трябва да наблюдаваме 12 клъстера. При увеличаване на броя на шардовете не трябва да забравяме да актуализираме и failover.
Собственоръчно написаният failover изглежда много сложен и изисква нетривиална поддръжка. С един PostgreSQL клъстер ще бъде най-простият вариант, но той не се мащабира, така че не е подходящ за нас.
Repmgr
Replication Manager за PostgreSQL клъстери, който управлява работата на PostgreSQL клъстера. В него обаче няма автоматичен failover “извън кутията”, така че ще е необходимо да напишете собствена “обвивка” върху готовото решение. Така че всичко може да се окаже дори по-сложно, отколкото със собствени скриптове, поради което Repmgr дори не опитахме.
AWS RDS
Поддържа всичко необходимо за нас, може да прави резервни копия и поддържа пул от връзки. Има автоматично превключване: при смърт на мастера репликата става нов майстор, а AWS променя DNS записа на новия майстор, при това репликите могат да се намират в различни AZ.
Недостатъците включват липса на фини настройки. Пример за фини настройки: на нашите инстанции има ограничения за TCP връзки, които за съжаление не могат да бъдат направени в RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Освен това цената на AWS RDS е почти два пъти по-висока от обичайната цена на инстанцията, което и послужи за основна причина да откажем това решение.
Patroni
Това е шаблон на Python за управление на PostgreSQL с добра документация, автоматичен failover и изходен код на GitHub.
Плюсове на Patroni:
- Всеки параметър на конфигурацията е описан, ясно е какво работи;
- Автоматичният failover работи извън кутията;
- Написан е на Python и тъй като ние също пишем много на Python, ще ни бъде по-лесно да се справяме с проблемите и, възможно, даже да помогнем за развитието на проекта;
- Пълно управление на PostgreSQL, позволява промени на конфигурацията веднага на всички ноди на клъстера, а ако за прилагането на нова конфигурация е нужно рестартиране на клъстера, то това може да стане отново с помощта на Patroni.
Недостатъци:
- От документацията не става ясно как да работим правилно с PgBouncer. Въпреки че трудно може да се нарече недостатък, защото задачата на Patroni е да управлява PostgreSQL, а как ще се извършват връзките към Patroni — вече е наш проблем;
- Има малко примери за внедряване на Patroni при големи обеми, но много примери за внедряване от нулата.
В крайна сметка, за създаването на отказоустойчив клъстер избрахме именно Patroni.
Процесът на внедряване на Patroni
Преди да внедрим Patroni, разполагахме с 12 шарда PostgreSQL в конфигурация с един мастер и една реплика с асинхронна репликация. Приложените сървъри се свързваха с базите данни чрез Network Load Balancer, зад който стояха два инстанса с PgBouncer, а след тях бяха всички PostgreSQL сървъри.
За внедряването на Patroni трябваше да изберем разпределено хранилище на конфигурацията на клъстера. Patroni работи с разпределени системи за съхранение на конфигурации, такива като etcd, Zookeeper и Consul. Имаме работещ клъстер Consul в продукция, който функционира в комплекса с Vault и не го използваме по друг начин. Отлична възможност да започнем да използваме Consul по предназначение.
Как работи Patroni с Consul
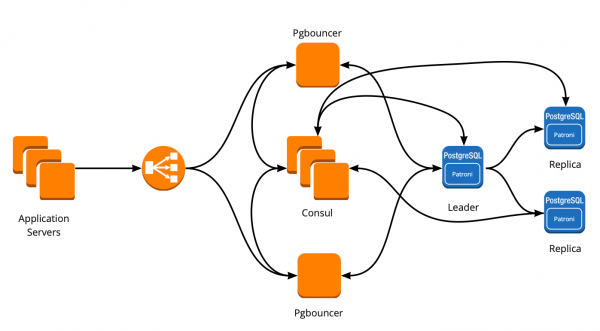
Имаме клъстер Consul, който се състои от три ноди и клъстер Patroni, който включва лидер и реплика (в Patroni, майсторът се нарича лидер на клъстера, а слейвовете — реплика). Всеки инстанс на клъстера Patroni постоянно изпраща информация за състоянието на клъстера в Consul. Следователно винаги можем да разберем текущата конфигурация на клъстера Patroni и кой е лидер в момента.
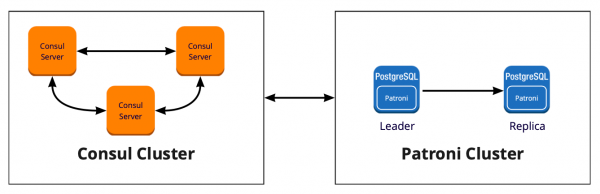
За свързването на Patroni с Consul е достатъчно да се проучи официалната документация, в която е описано, че е необходимо да се посочи хост в формат http или https, в зависимост от начина, по който работим с Consul, и схема на свързване, опционално:
host: хост:порт за крайна точка на Consul, в формат: http(s)://host:порт
scheme: (опционално) http или https, по подразбиране http
Изглежда просто, но тук започват подводните камъни. С Consul работастваме по защитена връзка чрез https и нашата свързваща конфигурация ще изглежда по следния начин:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Но така не работи. При стартиране Patroni не може да се свърже с Consul, защото все още се опитва да използва http.
Разбирането на проблема помогна оригиналният код на Patroni. Добре, че е написан на Python. Оказва се, че параметърът host не се парсира, а протоколът трябва да се укаже в scheme. Ето как изглежда работещият блок за конфигурация за работа с Consul при нас:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
И така, хранилището за конфигурация вече е избрано. Сега трябва да разберем как PgBouncer ще превключва конфигурацията си при смяна на лидера в кластера Patroni. В документацията няма отговор на този въпрос, тъй като принципно не е описана работата с PgBouncer.
В търсене на решение намерихме статия (за съжаление не помня заглавието), в която беше написано, че Consul-template много помага в свързването на PgBouncer и Patroni. Това ни подтикна да проучим работата на Consul-template.
Вече знаехме, че Consul-template постояннo следи конфигурацията на кластера PostgreSQL в Consul. При смяна на лидера той обновява конфигурацията на PgBouncer и изпраща команда за презареждане.
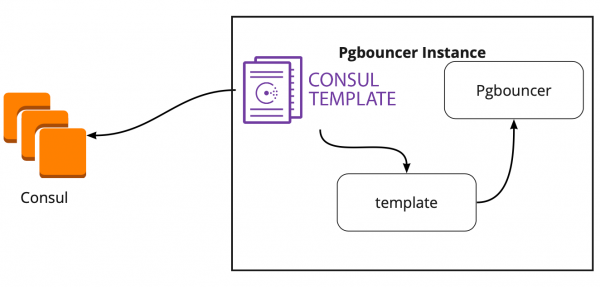
Голямото предимство на шаблона е, че той се съхранява под формата на код, така че при добавяне на нов шард, е достатъчно да направим нов комит и да обновим шаблона автоматично, като поддържаме принципа 'Инфраструктура като код'.
Нова архитектура с Patroni
В резултат получихме следната схема на работа:
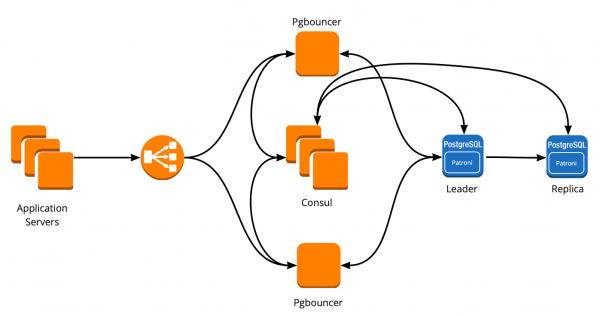
Всички приложения се свързват с балансировчика → зад него стоят два инстанса PgBouncer → на всеки инстанс работи Consul-template, който следи състоянието на всеки кластер Patroni и следи актуалността на конфигурацията на PgBouncer, която насочва заявките към текущия лидер на всеки кластер.
Ръчно тестване
Тази схема преди да я пуснем в продукция, стартирахме в малка тестова среда и проверихме работата на автоматичното превключване. Отворихме дъската, преместихме стикера и в този момент 'убихме' лидера на клъстера. В AWS за това е достатъчно да изключите инстанса чрез консолата.
Стикерът в продължение на 10-20 секунди се връщаше назад, а след това отново започваше да се премества нормално. Това означава, че кластерът Patroni е сработил правилно: смени лидера, изпрати информация в Consul, а Consul-template веднага подхвана тази информация, замени конфигурацията на PgBouncer и изпрати команда за reload.
Как да оцелее под високо натоварване и да запази минимален даунтайм?
Всичко работи отлично! Но се появяват нови въпроси: Как ще работи под високо натоварване? Как бързо и безопасно да разпространим всичко на продукция?
Отговорът на първия въпрос се намира в тестова среда, на която провеждаме натоварвателни тестове. Тя е напълно идентична на production по архитектура и има генерирани тестови данни, които по обем са приблизително равни на production. Решаваме просто да "убием" един от майсторите на PostgreSQL по време на теста и да видим какво ще се случи. Но преди това е важно да проверим автоматичното разгръщане, тъй като в тази среда имаме няколко шарда PostgreSQL, за да можем да направим отлични тестове на конфигурационните скриптове преди продукцията.
И двете задачи изглеждат амбициозно, но ние имаме PostgreSQL 9.6. Може би да се обновим направо до 11.2?
Решаваме да направим това на два етапа: първо да обновим версията до 11.2, след това да стартираме Patroni.
Обновление на PostgreSQL
За бързо обновление на версията на PostgreSQL е необходимо да се използва опцията -k, при която се създават хард линкове на диска и не е необходимо копиране на вашите данни. На бази от 300-400 ГБ обновлението отнема 1 секунда.
Имаме много шардове, така че обновлението трябва да се извърши автоматично. За тази цел написахме Ansible playbook, който изпълнява целия процес на обновление вместо нас:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--линк </b>
--стар-дата-дир='' --нова-дата-дир=''
 --стар-бин-дир=''  --нова-бин-дир=''
 --стар-опции=' -c конфигурационен_файл='
 --нови-опции=' -c конфигурационен_файл='
Тук е важно да се отбележи, че преди стартиране на обновлението е необходимо да го изпълните с параметъра —check, за да сте сигурни, че обновлението е възможно. Сценарият ни също заменя конфигурациите по време на обновлението. Нашият сценарий се изпълни за 30 секунди, това е отличен резултат.
Стартиране на Patroni
За решаване на втория проблем е достатъчно да потърсите в конфигурацията на Patroni. В официалния репозиторий има примерна конфигурация с initdb, която отговаря за инициализацията на нова база при първото стартиране на Patroni. Но тъй като имаме готова база, просто изтрихме този раздел от конфигурацията.
Когато започнахме да инсталираме Patroni на готов клъстер PostgreSQL и да го стартиране, се сблъскахме с нов проблем: и двата сървъра се стартираха като лидер. Patroni не знае нищо за предишното състояние на клъстера и опитва да стартира двата сървъра като два отделни клъстера с едно и също име. За решаване на този проблем е необходимо да се изтрие директорията с данните на slave:
rm -rf /var/lib/postgresql/Това трябва да се направи само на slave!
При свързване на чиста реплика Patroni прави basebackup на лидера и го възстановява на репликата, след което настъпва актуалното състояние чрез wal-логовете.
Още една трудност, с която се сблъскахме, е, че всички PostgreSQL клъстери по подразбиране се наричат main. Когато всеки клъстер не знае нищо за другите, това е нормално. Но когато искате да използвате Patroni, всичките клъстери трябва да имат уникално име. Решението е да промените името на клъстера в конфигурацията на PostgreSQL.
Натоварващ тест
Стартирахме тест, който имитира работата на потребителите в дъските. Когато натоварването достигна нашата средна дневна стойност, повторихме точно такъв тест, като изключихме един инстанс с лидер PostgreSQL. Автоматичният failover сработи както очаквахме: Patroni смени лидера, Consul-template обнови конфигурацията на PgBouncer и изпрати команда за reload. По нашите графики в Grafana се виждаха забавяния от 20-30 секунди и малко количество грешки от сървъри, свързани с връзката към базата. Това е нормална ситуация, такива стойности са допустими за нашия failover и определено са по-добри от времето на недостъпност на услугата.
Изводи от Patroni на продукция
В крайна сметка получихме следния план:
- Деплой на Consul-template на сървърите с PgBouncer и стартиране;
- Актуализация на PostgreSQL до версия 11.2;
- Смяна на името на клъстера;
- Стартиране на клъстера Patroni.
При това нашата схема позволява да изпълним първата точка практически по всяко време, можем последователно да изключим всеки PgBouncer от работа и да извършим деплой и стартиране на consul-template. Така и направихме.
За бърза разгръщане използвахме Ansible, тъй като всички playbook вече бяха тествани в тестовата среда, а времето за изпълнение на целия сценарий беше от 1,5 до 2 минути за всеки шард. Можехме да разгръщаме последователно на всеки шард без спиране на нашата услуга, но трябваше да изключим всеки PostgreSQL за няколко минути. В този случай потребителите, чиито данни са на този шард, нямаше да могат да работят нормално по това време, а това за нас е неприемливо.
Изход от тази ситуация беше планираното поддържане, което провеждаме на всеки 3 месеца. Това е прозорец за планирани работи, когато напълно изключваме нашия сервиз и обновяваме инстанцията на базите данни. Оставаше една седмица до следващия прозорец и решихме просто да чакаме и да се подготвим допълнително. В периода на чакане допълнително се застраховахме: за всеки шард PostgreSQL изградихме запасна реплика в случай на неуспех, за да запазим най-новите данни, и добавихме по нова инстанция за всеки шард, която трябва да стане нова реплика в кластера Patroni, за да не изпълняваме командата за изтриване на данни. Всичко това помогна да се минимизира рискът от грешки.
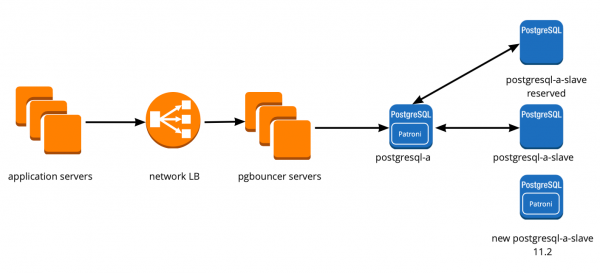
Рестартирахме нашия сервиз, всичко проработи както трябва, потребителите продължиха да работят, но на графиките забелязахме аномално висока натовареност на сървърите Consul.
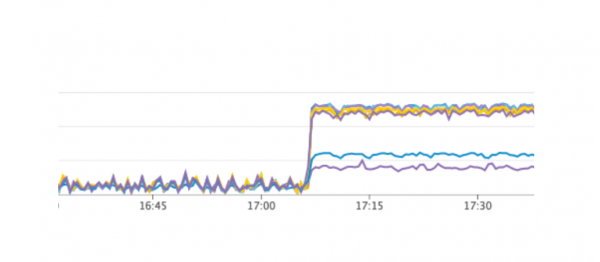
Защо не видяхме това в тестовата среда? Този проблем много добре илюстрира, че е необходимо да се спазва принципа 'Инфраструктура като код' и да се доработва цялата инфраструктура, започвайки от тестовите среди и завършвайки с продукцията. В противен случай е много лесно да се получи такава ситуация, каквато получихме ние. Какво стана? Consul първо се появи в продукцията, а след това в тестовите среди, в крайна сметка в тестовите среди версията на Consul беше по-висока, отколкото в продукцията. Точно в един от релизите беше решен проблем с теч на CPU при работа с consul-template. Затова просто обновихме Consul, решавайки по този начин проблема.
Рестартиране на клъстера Patroni
Но получихме нов проблем, за който дори не подозирахме. При актуализиране на Consul просто премахваме нодата на Consul от клъстера с командата consul leave → Patroni се свързва с друг Consul сървър → всичко работи. Но когато стигнахме до последната инстанция на клъстера Consul и й изпратихме командата consul leave, всички клъстери Patroni просто се рестартираха, а в логовете видяхме следната грешка:
ГРЕШКА: get_cluster
Обратна следа (последен извикан: последен):
...
RetryFailedError: 'Превишен срок за опити'
ГРЕШКА: Грешка при комуникация с DCS
<b>ЛОГ: системата на базата данни е спряна</b>
Клъстерът Patroni не можа да получи информация за своя клъстер и се рестартира.
За да намерим решение, се обърнахме към авторите на Patroni чрез issue в GitHub. Те предложиха подобрения на нашите конфигурационни файлове:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Успяхме да повторим проблема в тестовата среда и да тестваме тези параметри там, но за съжаление те не сработиха.
Проблемата все още остава нерешена. Планираме да опитаме следните варианти за решение:
- Да използваме Сonsul-agent на всеки инстанс от кластера Patroni;
- Да поправим проблема в кода.
Разбираме мястото на възникване на грешката: вероятно проблемът е в използването на default timeout, който не се пренастройва чрез конфигурационния файл. При изтриването на последния Consul сървър от кластера, целият Consul-кластер зависва за повече от секунда, в резултат на което Patroni не може да получи състоянието на кластера и изцяло перезапуска целия кластер.
За щастие, не сме срещнали повече грешки.
Резюме на използването на Patroni
След успешен старт на Patroni добавихме по една допълнителна реплика във всеки кластер. Сега във всеки кластер има подобие на кворум: един лидер и две реплики, — за да се предпазим от split-brain при превключване.
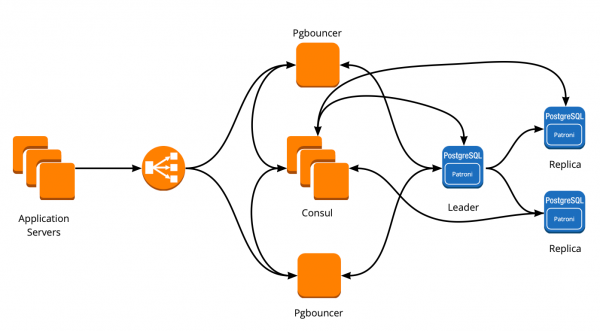
На продукция Patroni работи повече от три месеца. През това време той вече успя да ни спаси. Наскоро в AWS умря лидерът на един от кластерите, автоматичният failover сработи и потребителите продължиха да работят. Patroni изпълни основната си задача.
Небольшо резюме на използването на Patroni:
- Удобство при промяна на конфигурацията. Достатъчно е да промените конфигурацията на един инстанс и тя ще се синхронизира в целия кластер. Ако е необходимо перезареждане за прилагане на новата конфигурация, Patroni ще ви уведоми. Patroni може да перезапусне целия кластер с една команда, което също е много удобно.
- Автоматичният failover работи и ни е спасил.
- Актуализация на PostgreSQL без даунтайм на приложението. Необходимо е първо да се актуализират репликите на новата версия, след това да се смени лидерът в клъстера Patroni и да се обнови старият лидер. При това се провежда необходимото тестване на автоматичния failover.
Източник: habr.com
